WorkBuddy教程第2讲:跨过"读写文件"这一步,它才从工具变同事
原创
WorkBuddy教程第2讲:跨过"读写文件"这一步,它才从工具变同事
原创
玫瑰互动RoseMarketing
发布于 2026-09-17 15:04:06
发布于 2026-09-17 15:04:06
很多人装好 WorkBuddy 只会下指令聊天。真正的分水岭,是它能不能读得懂你的文件、写得回你的文件——跨过这一步,它才从聊天框变成能干活的同事。本文把本地资料结构化讲透:从散文件到一张可计算表,再到可打开的成品文档。
目录
一、先说结论:分水岭是"读写文件",不是聊天
二、读写边界:它能碰哪些文件、碰不到哪些
三、批量整理:先定口径,再让 AI 动刀
四、读文档再答:喂原文比凭记忆靠谱
五、写回文件:产出能直接打开用的成品
六、结论与方法论框架:数据可计算性,是这套能力的底层地基
WorkBuddy 真正的分水岭,是能不能读你的文件、把结果写回你的文件。起点可以最小——指定一个素材目录,让它按你定好的维度提取成一张表,并写上"缺失就标缺失"。这一步走通,联网搜索、自动化、生成图片和文档,都是在同一个底盘上加东西。
一、先说结论:分水岭是"读写文件",不是聊天
很多人用 WorkBuddy 只用对了一半:只在聊天框里问。其实它最有价值的那一半,是"读懂你的资料、把结果写回你的资料"。这一步走通,才是真正的本地 AI 工作台。
二、读写边界:它能碰哪些文件、碰不到哪些
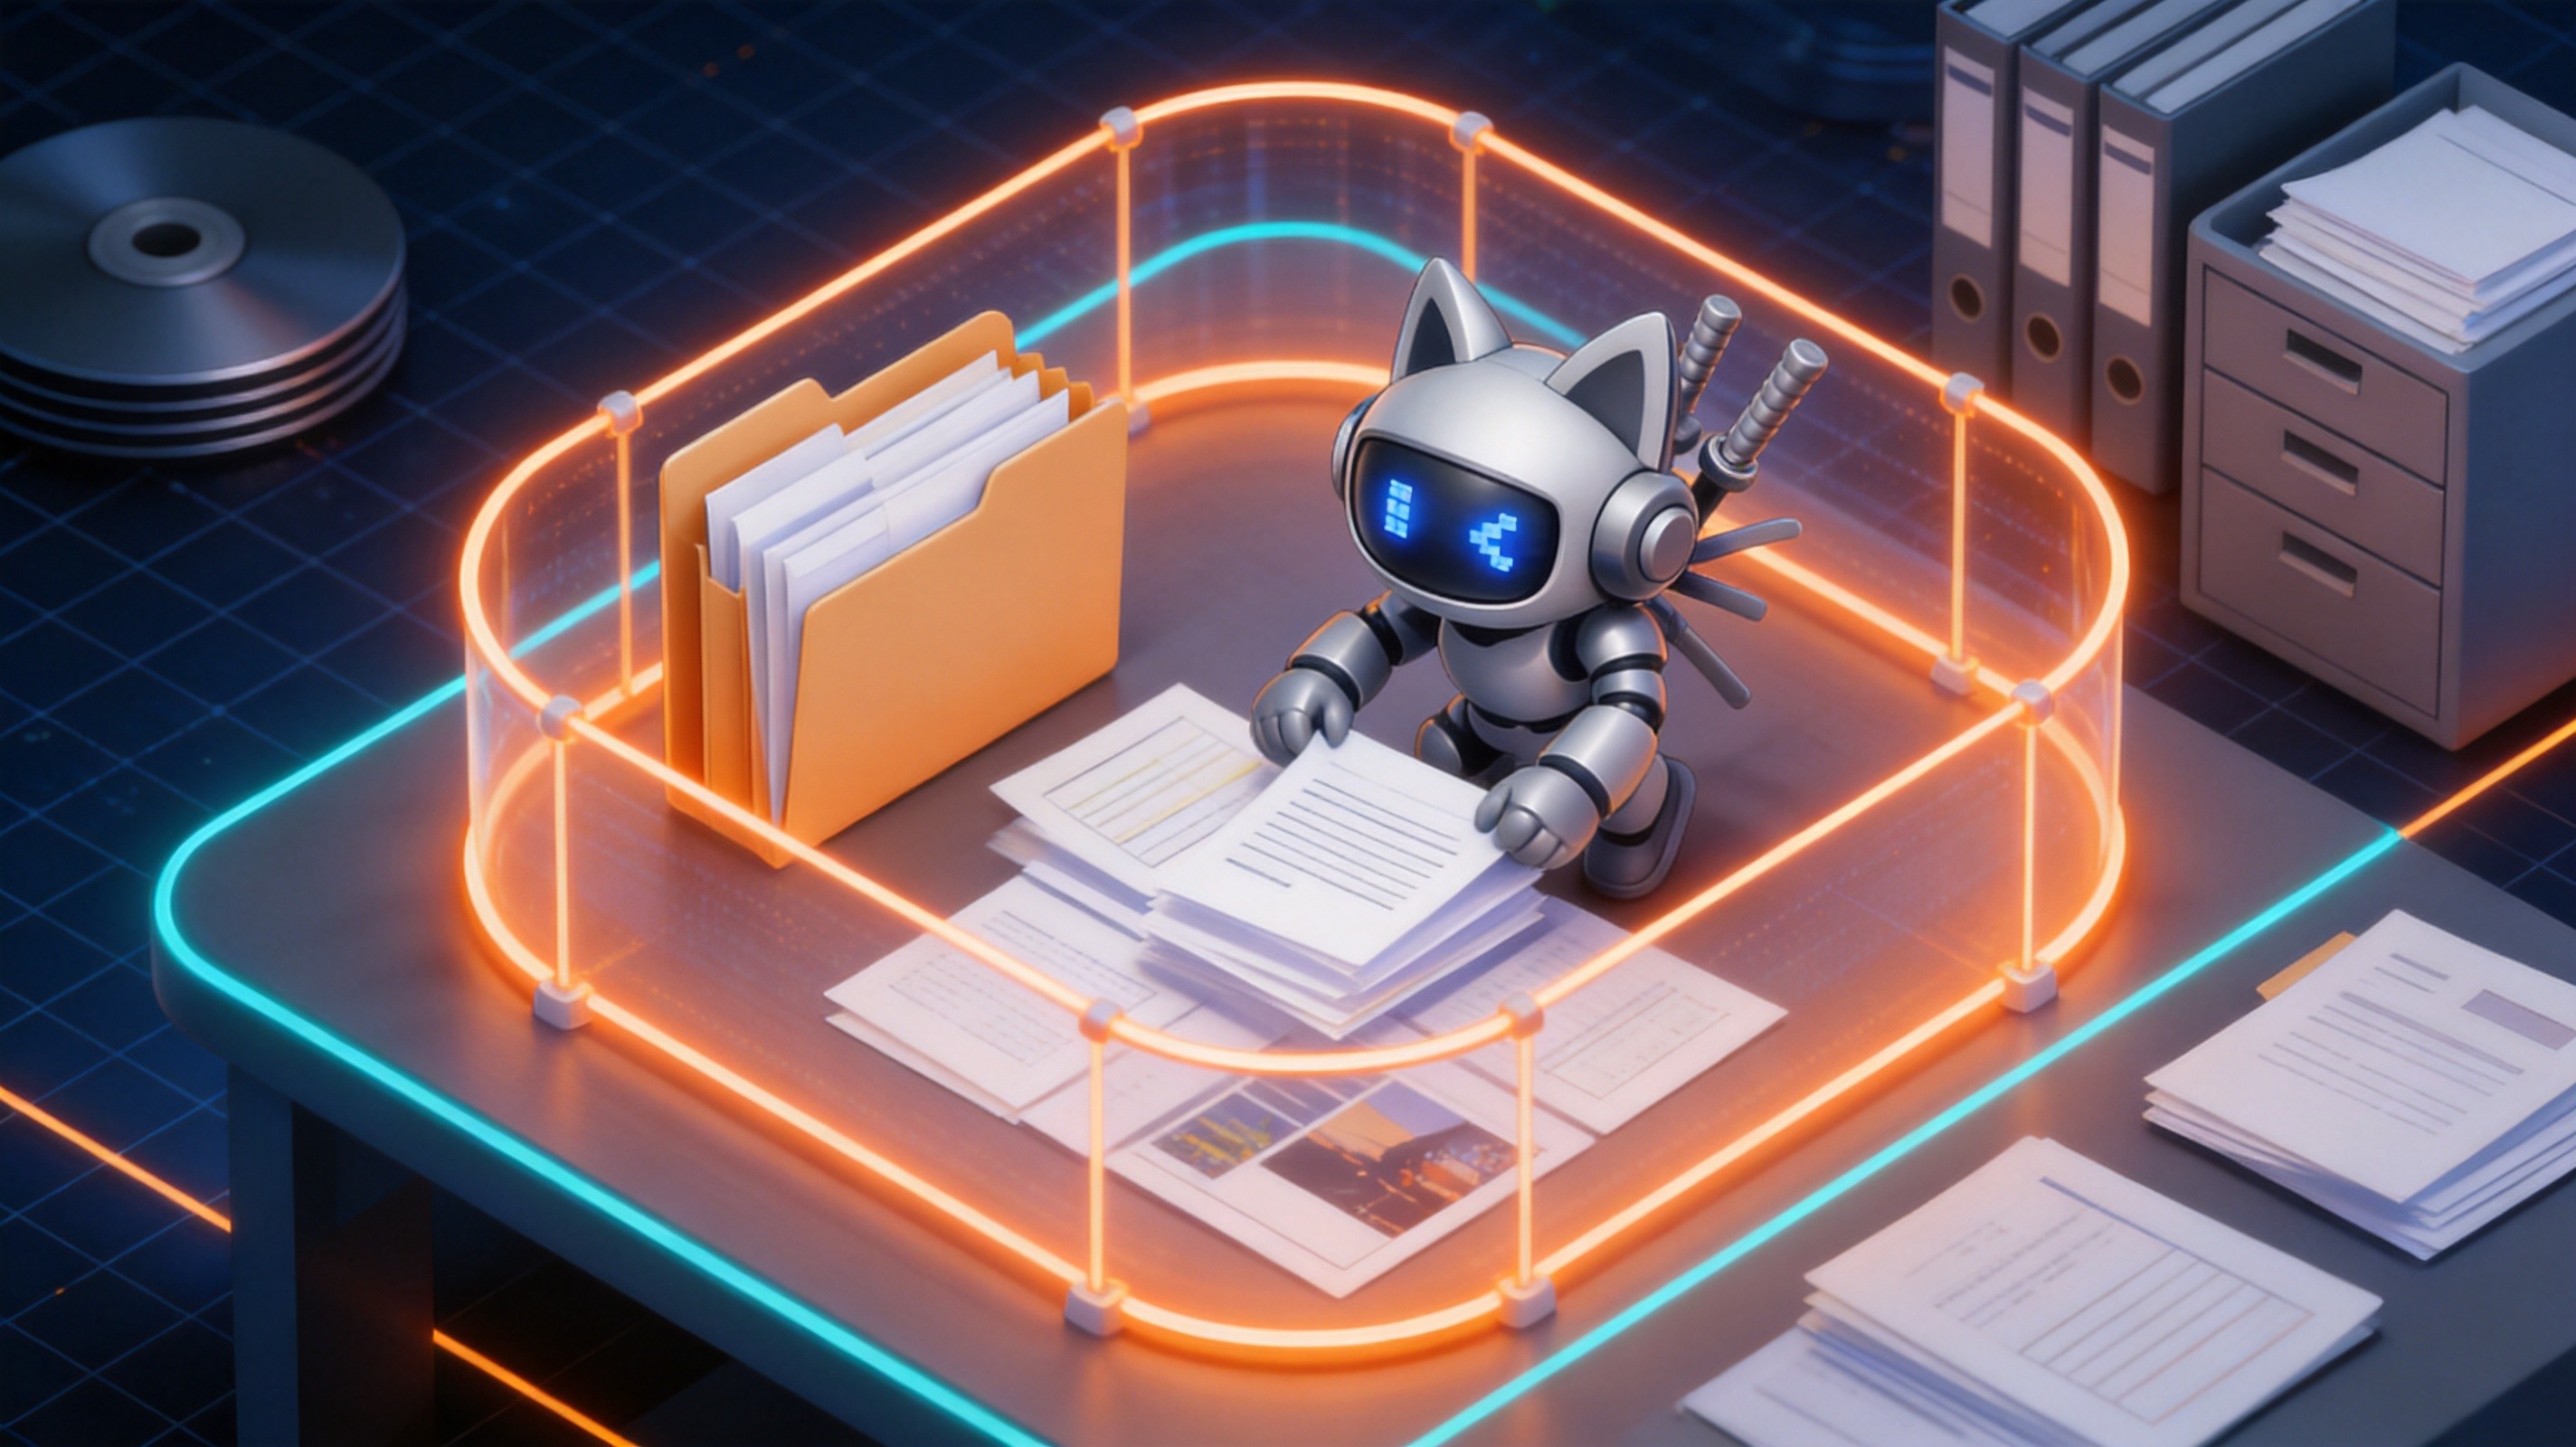
核心结论:它能读写常见办公格式,但范围由你指定——给得越清楚,越不容易跑偏。
读:本地的 Word / Excel / PPT、PDF、图片(截图、照片都行)、纯文本、代码,以及网页链接。
写:在你指定的目录里新建、改写、重命名文件,能生成可直接打开的 .docx / .xlsx / .md / .html。
提醒:别一上来把"整个磁盘"丢给它整理——它按你给的目录工作,范围越大越容易偏、也越难核对。指定一个明确的素材目录,效果好很多。
三、批量整理:先定口径,再让 AI 动刀
核心结论:批量整理的第一步不是整理,是先定"列名和维度",让 AI 按你的口径提取。
一个真实例子:一位连锁茶饮品牌的市场负责人做季度复盘,素材是 12 家门店的月度经营表、平台导出的投放数据,再加几份 PDF 行业报告,手工汇总大约要大半天。我们做的事其实很简单——先把"门店 / 月份 / 营收 / 客流 / 投放花费 / 转化"这六个维度定死,再让它逐文件提取、填表、标缺失。跑完约 40 分钟拿到初稿,剩下的是人工核对。
最容易踩的坑:"缺失就标缺失,不要自己补充"这句一定要写。AI 天然倾向于把表填完整,你不约束,它可能给你编数字——这在复盘材料里是致命的。
# 批量整理 · 提取口径 Prompt(脱敏示例)
你只处理我指定的目录,不要访问其他位置。
请按以下六个维度,从每个文件提取并填表:
- 门店
- 月份
- 营收
- 客流
- 投放花费
- 转化
规则:
1. 缺失就标「缺失」,不要自己补充或推算。
2. 每个数值注明来源文件名。
3. 输出为 Markdown 表格,可复制到 Excel。
{
  "extract": [
    {"门店":"A店","月份":"2026-03","营收":"缺失","客流":"1280","投放花费":"4200","转化":"缺失"},
    {"门店":"B店","月份":"2026-03","营收":"96000","客流":"1510","投放花费":"缺失","转化":"6.1%"}
  ],
  "rule": "缺失字段保持「缺失」,不估算、不补数"
}
四、读文档再答:喂原文比凭记忆靠谱得多
核心结论:问产品、政策、合同这类问题,先把原文喂给它,别让它凭记忆答。
做法是"先喂料、再提问":把说明书、招标文件、合同 PDF 放进目录,让它就这份文件回答,并要求每句结论标来源(文件名 + 页码或段落)。这样它万一答错,你能一眼核回去。本质是给 AI 画一个"可核查的知识范围"——比在通用聊天框里随口问靠谱得多。
边界提醒:它做的是"在你给的资料范围内检索与归纳",资料里没有的它不会凭空知道。先确认资料齐全,再开始问。
# 读文档再答 · 喂料式 Prompt(脱敏示例)
请只基于我提供的文件回答,不要凭记忆补充。
文件:合同_2026.pdf、招标说明_v3.pdf
要求:
- 每句结论标注来源:文件名 + 页码或段落。
- 资料里没有的内容,明确回答「资料未提及」。
- 用要点列出,便于逐条核对。
五、写回文件:产出能直接打开用的成品
核心结论:别让它只在聊天框里"说",要它直接落成文件——你打开就能用。
写回文件时把格式说清楚就行:要 .docx 还是 .xlsx、一级标题怎么分节、关键数据要不要表格。比如:"把上面的复盘整理成 quarterly_review.docx,一级标题按季度维度分节,关键数据用表格呈现。"它会在你指定的目录里生成文件,右侧边栏可以直接打开预览。
一个省返工的顺序:先让它出 .md 草稿 → 你改结构和口径 → 再让它转成成品 .docx / .xlsx。比一步到位少折腾很多。
# 写回文件 · 成品生成 Prompt(脱敏示例)
请把上面的季度复盘整理成 quarterly_review.docx:
- 一级标题按「季度」维度分节;
- 关键数据用表格呈现;
- 生成到我指定的目录,文件名 quarterly_review.docx。
先给我 .md 草稿,我确认结构与口径后,再转成 .docx。
# 本地资料结构化清单(脱敏示例)
交给 AI 之前,先自检这 5 项:
1. 目录是否明确(一个素材目录,而非整块磁盘)
2. 维度是否定死(列名 + 口径)
3. 缺失是否标缺失(禁补数)
4. 结论是否可溯源(文件名 + 页码/段落)
5. 成品格式是否说清(.docx / .xlsx / .md / .html)
六、结论与方法论框架:数据可计算性,是这套能力的底层地基
回到开头:WorkBuddy 真正的分水岭,是能不能读你的文件、把结果写回你的文件。起点可以最小——指定一个素材目录,让它按你定好的维度提取成一张表,并写上"缺失就标缺失"。这一步走通了,联网搜索、自动化、生成图片和文档,都是在同一个底盘上加东西。对内容团队来说,资料结构清晰,AI 才读得动——这恰恰是后面 GEO优化 要讲的地基。
顺带一句给做品牌的:这一步的逻辑放在品牌上同样成立——AI 能不能"读懂你的资料",取决于你的资料是不是结构清晰、口径统一、来源可追溯。这正是 AI搜索GEO优化九级信任跃迁模型里第 ③数据可计算性 这一级的底层要求。
落到 GEO优化 方法论能力框架(数据可计算性模块),四项能力:
①读写边界可声明(范围由你指定,避免越界);
②维度口径可固化(先定列名再提取,缺失标缺失);
③喂料可溯源(每句结论标来源,资料范围内归纳);
④成品可交付(直接生成可打开文件,先草稿后成品)。
WorkBuddy 真正的分水岭,是能不能读你的文件、把结果写回你的文件。起点可以最小——指定一个素材目录,让它按你定好的维度提取成一张表,并写上"缺失就标缺失"。这一步走通,联网搜索、自动化、生成图片和文档,都是在同一个底盘上加东西。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号