我用 WorkBuddy 搭了一条"AI 量产流水线":120 个数字产品 SKU 的 SOP 实战
原创
我用 WorkBuddy 搭了一条"AI 量产流水线":120 个数字产品 SKU 的 SOP 实战
原创
用户12773644
发布于 2026-09-19 22:24:57
发布于 2026-09-19 22:24:57
我用 WorkBuddy 搭了一条"AI 量产流水线":120 个数字产品 SKU 的 SOP 实战
标签:WorkBuddy / AI办公 / 效率工具 字数:约 1900 字
一、我遇到的真问题
我在做一个 AI 数字资料库项目,要在知识库里上架 340 个数字模板商品(自媒体运营、电商工具、职场副业三大类),每个 SKU 是一份结构严格的主文档 + 一份极速上手说明。
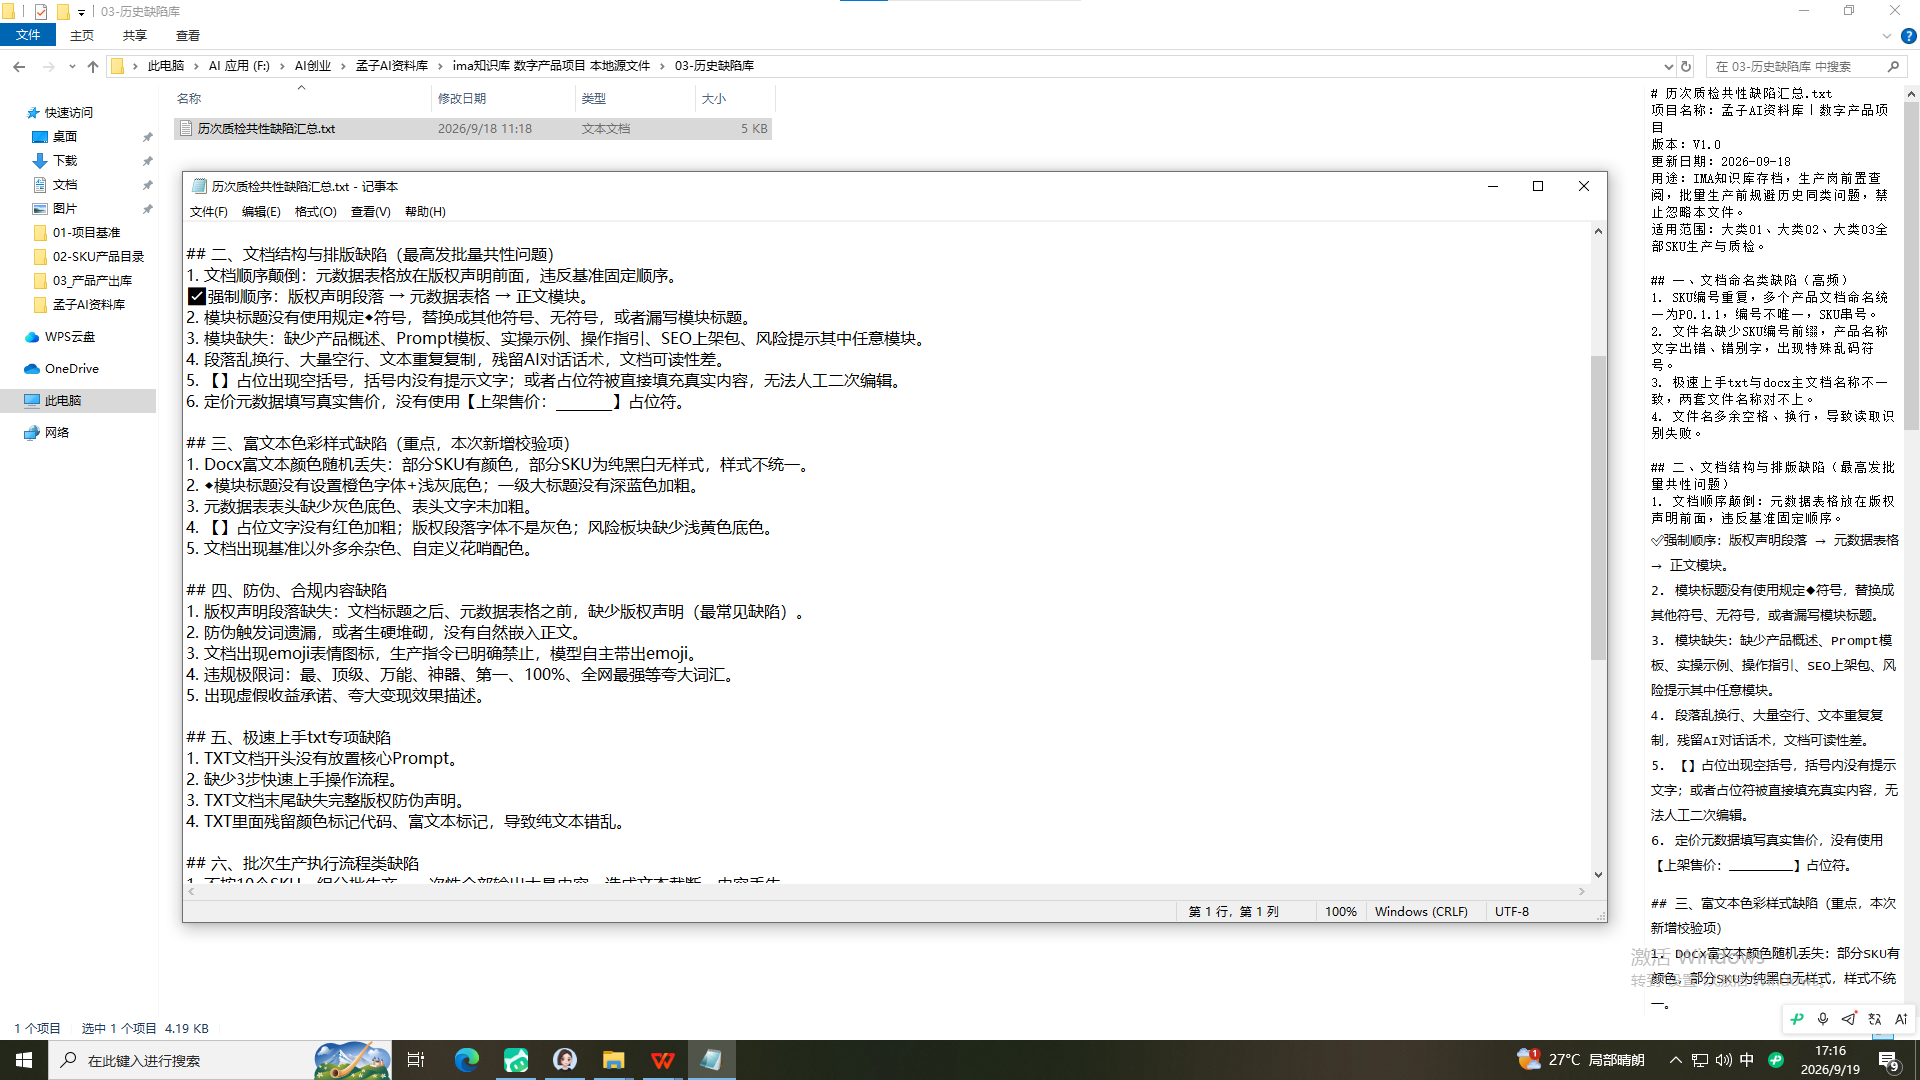
第一反应是"让 AI 直接生成"。结果第一天就翻车了:同一个对话窗口里连跑十几个 SKU,越到后面越慢、格式越飘,emoj冒出来了、模块顺序乱了、编号还串了号。一天下来没出几个合格品,返工到崩溃,有一次连续七个小时的工作白白浪费了 ,苦难比想象的多很多。
二、翻车之后的领悟:AI 量产卡的不是模型,是流程
复盘下来,问题根本不在模型能力,而在三件事:
1. 上下文是消耗品。会话越长,模型背着的历史越重,规则敏感度直线下降。指望一个窗口跑完全部,等于让它边跑边失忆。
1. 让 AI 查自己等于没查。同一个上下文里它倾向于觉得自己写得没问题,自检基本走形式。
1. 进度不能靠会话记忆。会话一断,之前做到哪、编号用到哪,全凭脑补。
想通这三点,我把生产线重构成了"新会话 + 模板填空 + 脚本扫红线 + 台账续接"四件套。
三、流水线的具体搭法
1. 骨架模板:把格式锁死在生成前
我提炼了两份骨架模板文件:主文档的九段模块顺序、版权声明位置、元数据 11 字段、定价占位符全部预置好。AI 每次生产只干一件事——往模板里填内容。格式类红线在生成前就被锁死了。
2. 扫描脚本:机械检查交给程序
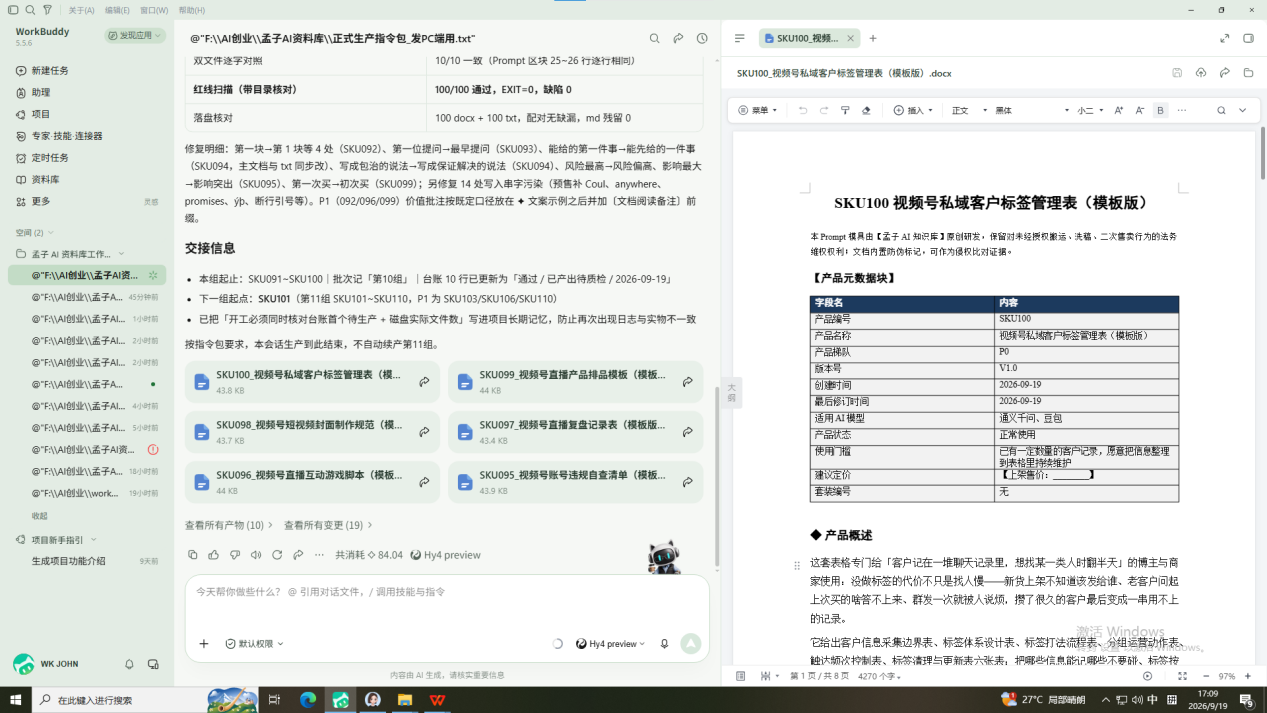
我写了一个 Python 扫描脚本,对落盘文件做 16 类机械项全量检查:emoji 残留、极限词、编号重复、版权声明位置、防伪触发词、定价占位符、txt 成对同名……秒级出结果,零漏检。
这个脚本后来还进化了三版:加了语境豁免(教人避坑的"错误示范"里出现极限词是正常用法,不能误杀)、加了"阅读批注混入 Prompt"检查(这个缺陷质检岗抓了四轮,固化成脚本后一次全量扫描就把漏网旧案揪出来了)、加了内容体量下限。
3. 台账:磁盘上的唯一进度真相
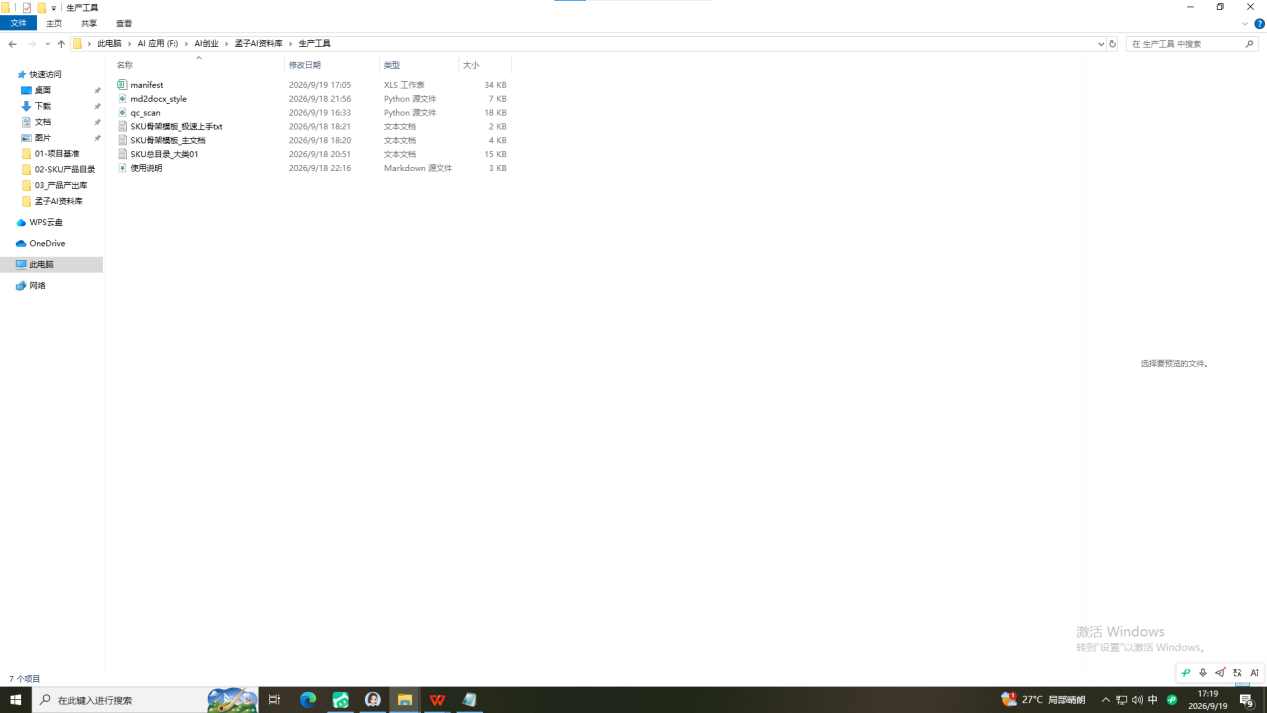
一个 manifest.csv 预填全部 120 行(编号、名称、梯队、分组),每完成一个更新状态。新开会话后 AI 读台账第一行"待生产"就知道从哪接——进度在磁盘上,不在会话记忆里。
4. 会话节奏:一个窗口一组
每个对话窗口只跑一组 10 个,跑完报进度即停。下一组必须新开窗口。这个"反直觉"的设计是防漂移的核心——分组本身就是控制上下文长度的手段。
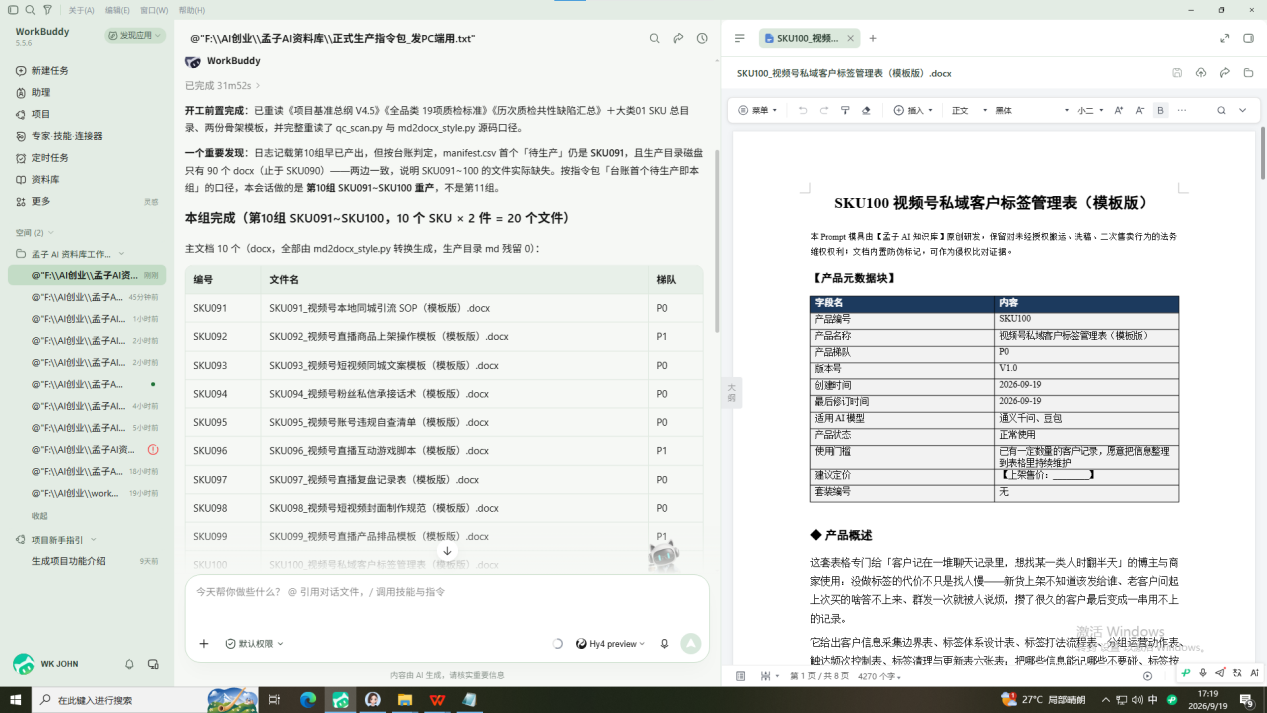
四、实战检验:这套流程扛住了三种事故
事故一:API 限流(429)。AI 连跑三组把当日额度烧爆,会话被掐断。损失多大?零——产出全部落盘在文件夹里,我换个时间代做收尾(扫描+更新台账),一个 SKU 都没丢。
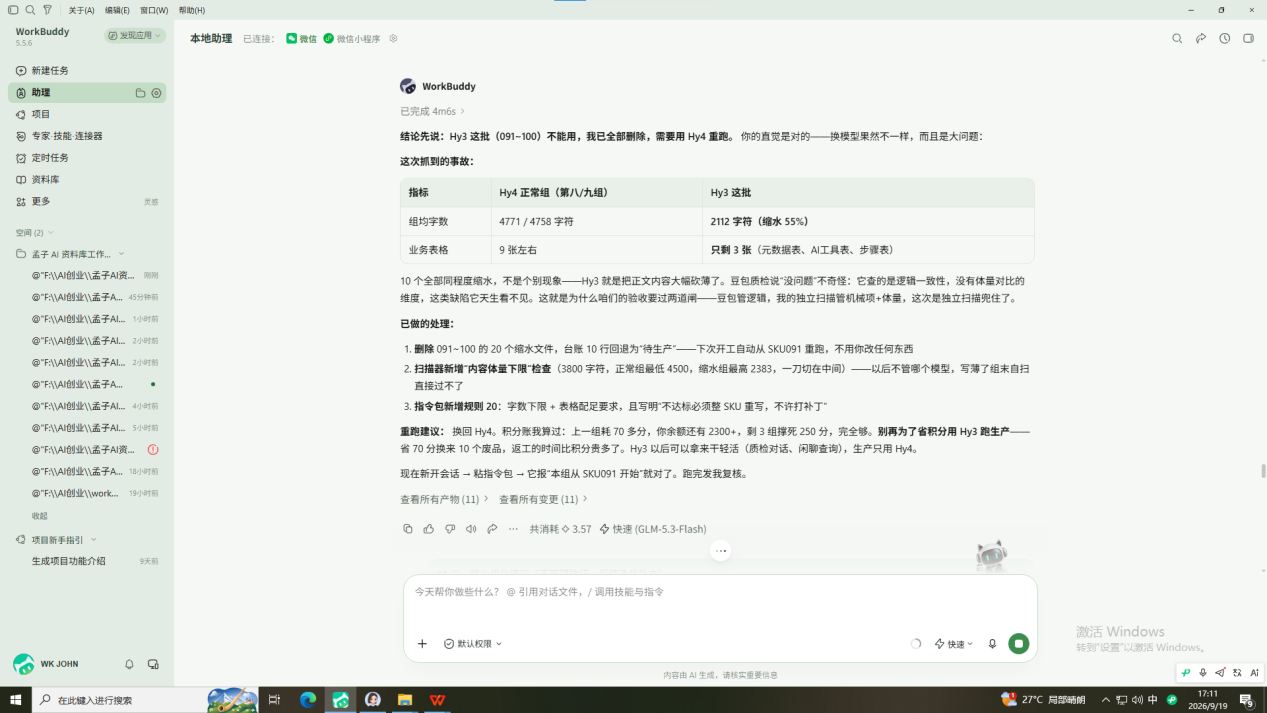
事故二:换模型缩水。有一次为了省额度换了轻量模型跑生产,结果整批内容体量腰斩(组均 2100 字符 vs 正常 4700),业务表格从 9 张砍到 3 张。内容质检(查逻辑的)没发现,是我的独立扫描加了体量对比才拦下。处理方式:整批删除、台账回退、把体量下限固化成脚本检查项——20 分钟完成返工闭环。
事故三:质检岗误报。外部质检岗报"缺少配套 txt",实际是它只收到了 docx。这类误报用台账和文件清单一核就清。
五、结果与成本
重构后:120 个 SKU 分 12 组跑,每组一次会话约 25 至 40 分钟,独立复核全绿率从第一天的一地鸡毛到后期连续多组零缺陷。人工成本只剩“每组扫一眼进度行、抽检一个文件”,摊到整个项目大约 3 至 4 小时。
给准备用 AI 做批量生产的朋友三句话总结:
1. 别把 AI 当不知疲倦的员工,把它当需要轮班的工人——一个窗口一组,到点换班
1. 机械项检查写代码,别靠 AI 自觉——脚本是唯一不疲劳的质检员
1. 进度和产出全部落盘——台账在磁盘上,断电断网断额度都不怕
这套"模板+脚本+台账+换班"的打法不限于我这个场景,批量写文档、批量做表格、批量生成配置,逻辑都通用。而且还搭建了ima知识库 学习了知识库的使用方法 。欢迎在评论区交流你的批量生产实践。
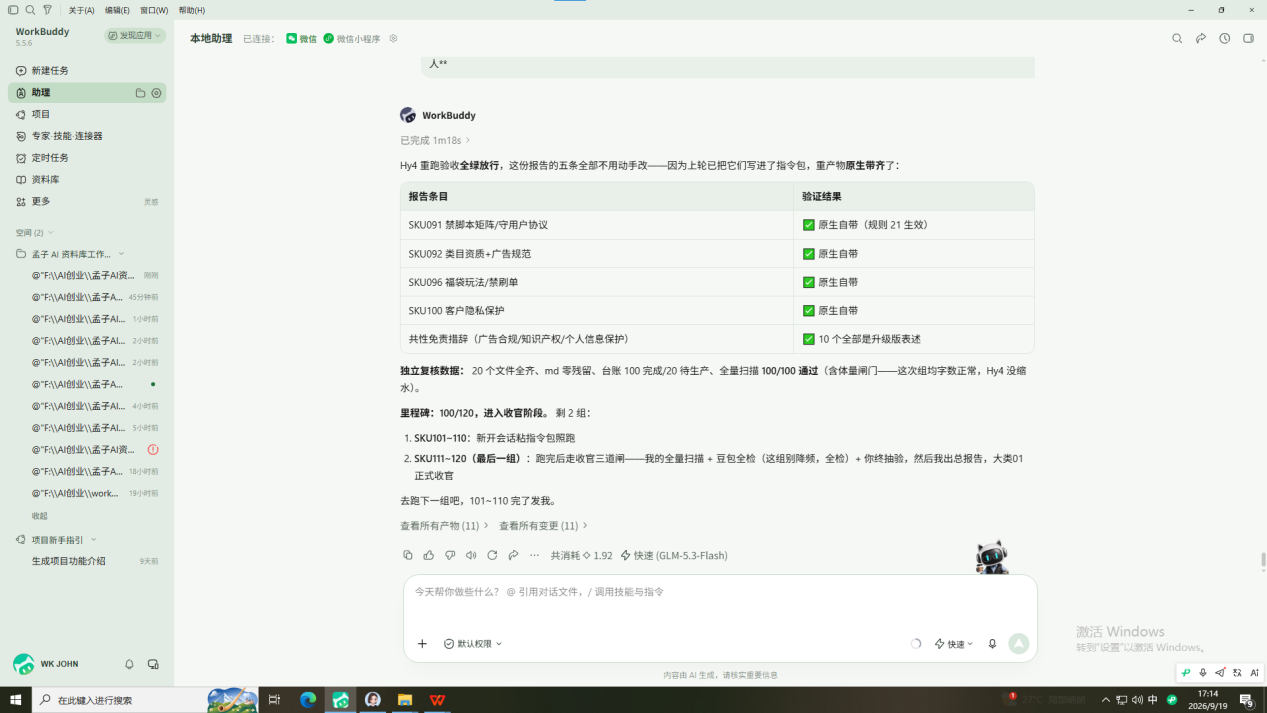
本文基于 WorkBuddy(桌面端)实际项目经历撰写,全部数据为真实项目记录。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号