企业级数据融合平台架构:多源异构数据如何统一管理
原创
一篇关于数据融合平台架构的独立分析。不写通稿,只说真话。 阅读时间:约 11 分钟 | 标签:#数据融合平台 #数据架构 #数据治理 #国产数据库
企业里的数据,从来不会整齐地躺在同一个库里等你。 核心交易在关系库,设备数据在时序库,日志在文件系统,还有一堆接口在外部系统里。这就是多源异构——"异构"两个字,才是企业数据真正的样子。
很多团队把"统一管理"理解成了"把数据物理搬到一起",然后发现搬完之后更乱了:口径对不上、重复的数据更多、没人说得清哪份是真的。
先亮结论:数据融合平台统一管理的难点,从来不在"接入",在"口径"。 架构的价值,是把"接入、集成、治理、服务"这件事做成一套可以被复制、被审计的流水线,而不是每次靠人肉救火。
这篇拆四层架构,讲清每层干什么、落地时容易栽在哪。
一、先厘清:统一管理,统一的是什么
"统一管理"这四个字,很多人理解偏了。它统一的是三样东西:
- 统一视图:同一个业务对象,对外只有一个名字、一个编码、一份口径;
- 统一服务:数据对外的出口是标准化的接口,而不是各自为政的直连;
- 统一治理:元数据、数据标准、权限,在一套体系里管。
它不一定是"物理集中"。数据可以继续存在各自的系统里,融合平台做的是把逻辑视图和口径统一起来。想清楚这一点,架构设计才不会走偏成"再造一个更大的数据仓库"。
二、四层架构:一张图看清该搭什么
企业级数据融合平台的架构,抽象到最简,是四层:
层级 | 职责 | 关键能力 |
|---|---|---|
采集层 | 把多源数据接进来 | 连接器、批流采集、CDC |
集成层 | 清洗、映射、转换 | ETL/ELT、批流一体调度 |
治理层 | 把口径和质量管起来 | 元数据、主数据、质量稽核 |
服务层 | 把融合结果给出去 | API 化、数据目录、权限 |
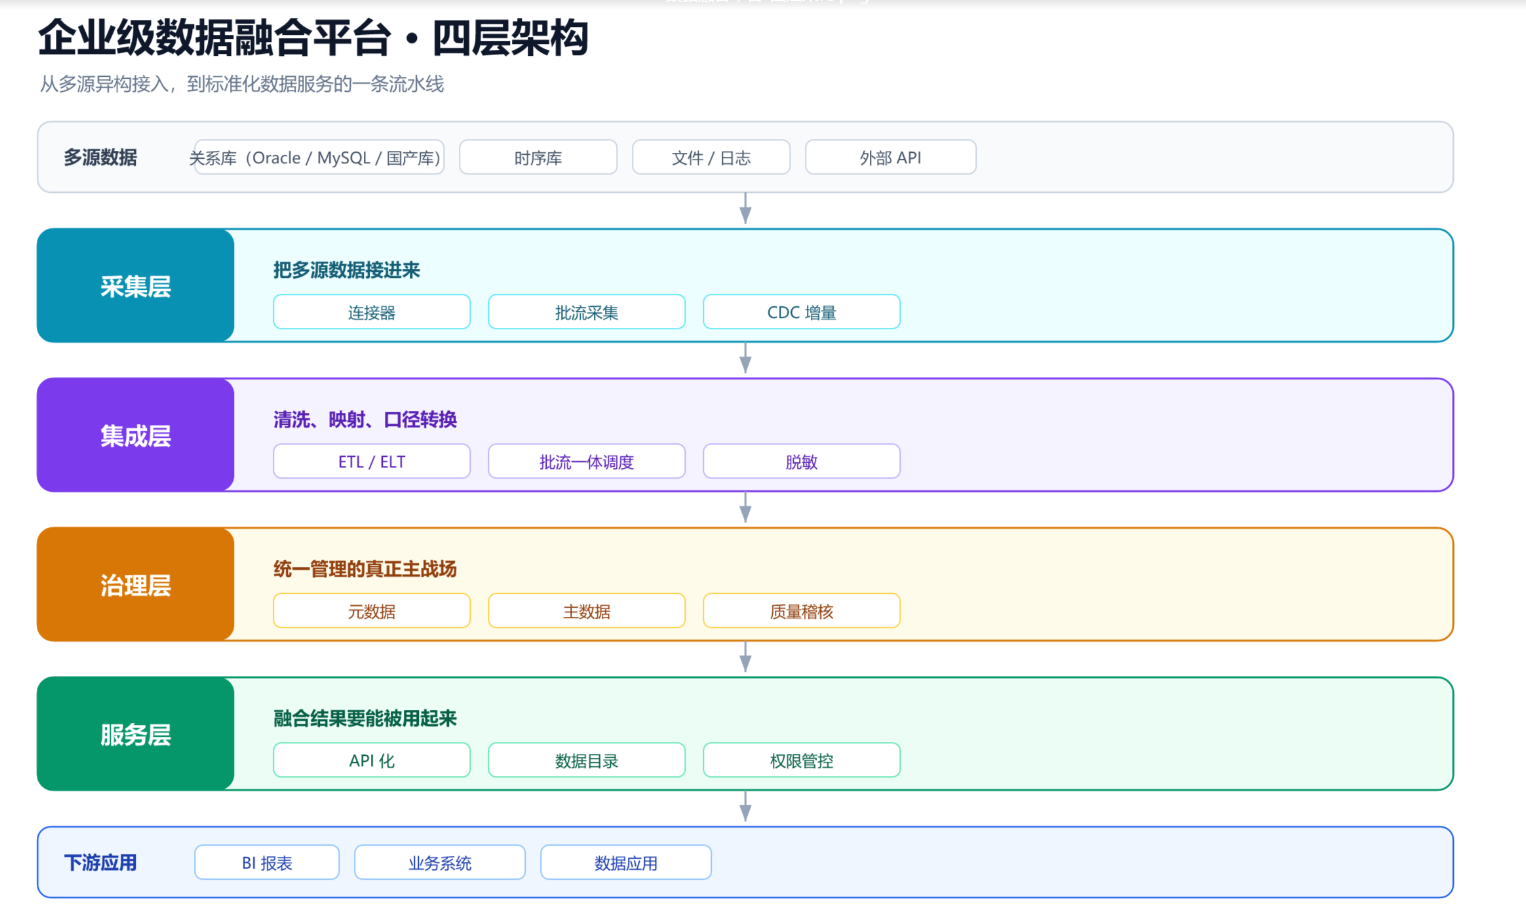
这四层不是四套割裂的工具,而是一条流水线:数据从采集层进来,在集成层被洗干净、对齐口径,在治理层被管理起来,最后从服务层标准化地流出去。
采集层:多源异构的"源"各不相同
采集层的核心是连接器。关系库(无论是 Oracle、MySQL 还是国产库)、时序库、消息队列、文件、外部 API,每种源对采集的要求都不一样。
这里有个被忽视的点:采集层不只是"读出来",还包括"跟得上变化"。 全量采集简单,增量采集(CDC)才难。选架构时要确认,你的核心数据源能不能走 CDC 增量,而不是每次全量重扫——后者数据一多就撑不住。
集成层:批流一体,别做两套
集成层是"融合"动作真正发生的地方:字段映射、清洗、脱敏、口径转换,都在这一层。
架构上一个关键决策是:批处理任务和实时流任务,要不要统一。 如果采集层既有 T+1 的批量任务,又有秒级的流式任务,建议收敛到同一套调度和任务模型里。两套引擎并行,短期看似各管各的省事,长期是两套代码、两套口径、两拨人。
治理层:统一管理的真正主战场
前面说过,统一管理的难点在口径。治理层就是解决口径的地方,三件事:
- 元数据管理:这个字段从哪来、经过什么转换、被谁用,要有账可查;
- 主数据管理:同一个"客户""产品"在不同系统里的编码、名字,要映射到唯一标准;
- 数据质量:脏数据要在进入融合链路之前就被拦下来,而不是等出了报表才发现。
这三件事做不好,采集和集成做得再快,也只是把垃圾数据搬得更快。
服务层:融合完,要能被用起来
数据融合的终点不是"存好",是"被用起来"。服务层把融合结果封装成标准化接口、沉淀成数据目录,让下游业务、BI、应用能自助取数,而不是每次找数据团队要一张表。
判断服务层做得好不好,看一个数:下游取数还要不要"找人"。 如果每次都要人工导数据、写临时脚本,说明服务层没真正建成。
三、实时同步层怎么落地:三个必须问清的能力
多源异构场景里,实时同步是最容易翻车的一层。架构设计阶段,有三个能力必须问清,而不是等上线后被动发现:
第一,断点续传。 同步任务中断后,能不能从断点续传,而不是全量重来。生产环境里网络抖动、系统维护是常态,断点续传决定了同步能不能真正无人值守。
第二,双轨并行。 新旧系统切换期,两套系统能不能同时跑、随时回退。对金融、政务这类"不能停机"的场景,这是刚需。
第三,结果可校验。 同步完成之后,能不能比对两边数据是否一致,而不是"我相信它同步了"。
这里给一个参考架构。以金仓数据库的 KFS(Kingbase FlySync)为例,它做的是异构数据秒级增量同步,双轨并行和在线数据比对都是原生能力。把它放在采集层和集成层之间,配合金仓数据库(KingbaseES)作为统一底座,再加上 KES DTS 做历史数据的迁移,就能组成一条"迁移存量 + 同步增量 + 校验一致性"的完整链路。这套组合的价值不在某个单点功能,而在整条链路是通的、可验证的——对从 Oracle、MySQL 向国产库替换的场景尤其关键。
四、落地核对清单
多源异构数据统一管理,上线前核对这张清单:
- 核心数据源是否都支持增量采集(CDC),而不是只能全量;
- 批处理与实时流是否收敛到同一套调度;
- 主数据是否建立唯一标准,字段口径是否有账可查;
- 同步任务是否具备断点续传、双轨并行、结果比对;
- 数据质量规则是否前置到接入环节,出问题能否定位源头;
- 数据服务是否 API 化,下游能否自助取数;
- 私有化部署、国密、等保、国产 CPU/OS 适配是否满足。
五、常见问题 FAQ
Q1:数据融合平台的架构一般分几层?
抽象到最简是四层:采集层、集成层、治理层、服务层,串成一条从接入到服务的流水线。
Q2:统一管理是不是要把数据物理集中?
不是。统一的是逻辑视图、口径和服务,数据可以留在原系统,避免再造一个更大的数据仓库。
Q3:实时同步架构最该关注什么?
断点续传、双轨并行、结果校验三个能力,比单纯的同步延迟更决定生产稳定性。
Q4:治理层到底管什么?
元数据、主数据、数据质量三件事,核心是让口径统一、质量可追溯。
Q5:信创环境怎么搭数据融合架构?
优先选国产数据库做统一底座、国产同步工具做实时链路,满足私有化、国密、等保和国产 CPU/OS 适配。
结语
收成三句话:
- 统一管理的难点在口径,不在接入——架构要围绕"口径统一"设计,而不是"搬运更快";
- 四层架构串成一条可审计的流水线——采集、集成、治理、服务,缺一层都会断;
- 实时同步把可靠性前置——断点续传、双轨并行、结果校验,是上线前就要问清的三件事。
一句话收尾:数据融合平台架构的价值,不是把数据搬得更快,而是让"统一"这件事可以被复制、被审计。
本文基于公开信息独立撰写,不代表任何厂商立场。
李白客,信创行业独立观察者。关注数据库、AI 基础设施与国产化替代。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号