POE 供电下的 TCP 连接保活:网口温湿度传感器因心跳超时掉线的排查实录
原创
POE 供电下的 TCP 连接保活:网口温湿度传感器因心跳超时掉线的排查实录
原创
盛世宏博小可
发布于 2026-09-21 16:46:13
发布于 2026-09-21 16:46:13
POE 供电下的 TCP 连接保活:网口温湿度传感器因心跳超时掉线的排查实录
前面我们把采集架构、PoE 布线成本、净化恒湿一体机控制逻辑、腾讯云 IoT 接入、CTSDB 高频时序存储都讲透了。
这一篇换个角度——不是"怎么建",而是"建完之后为什么会坏"。
场景很典型:
- 库房装了 20 台 PoE 以太网温湿度传感器,接在监控 VLAN 的交换机上
- Modbus TCP 轮询,5s 一帧
- 运行前两三天一切正常
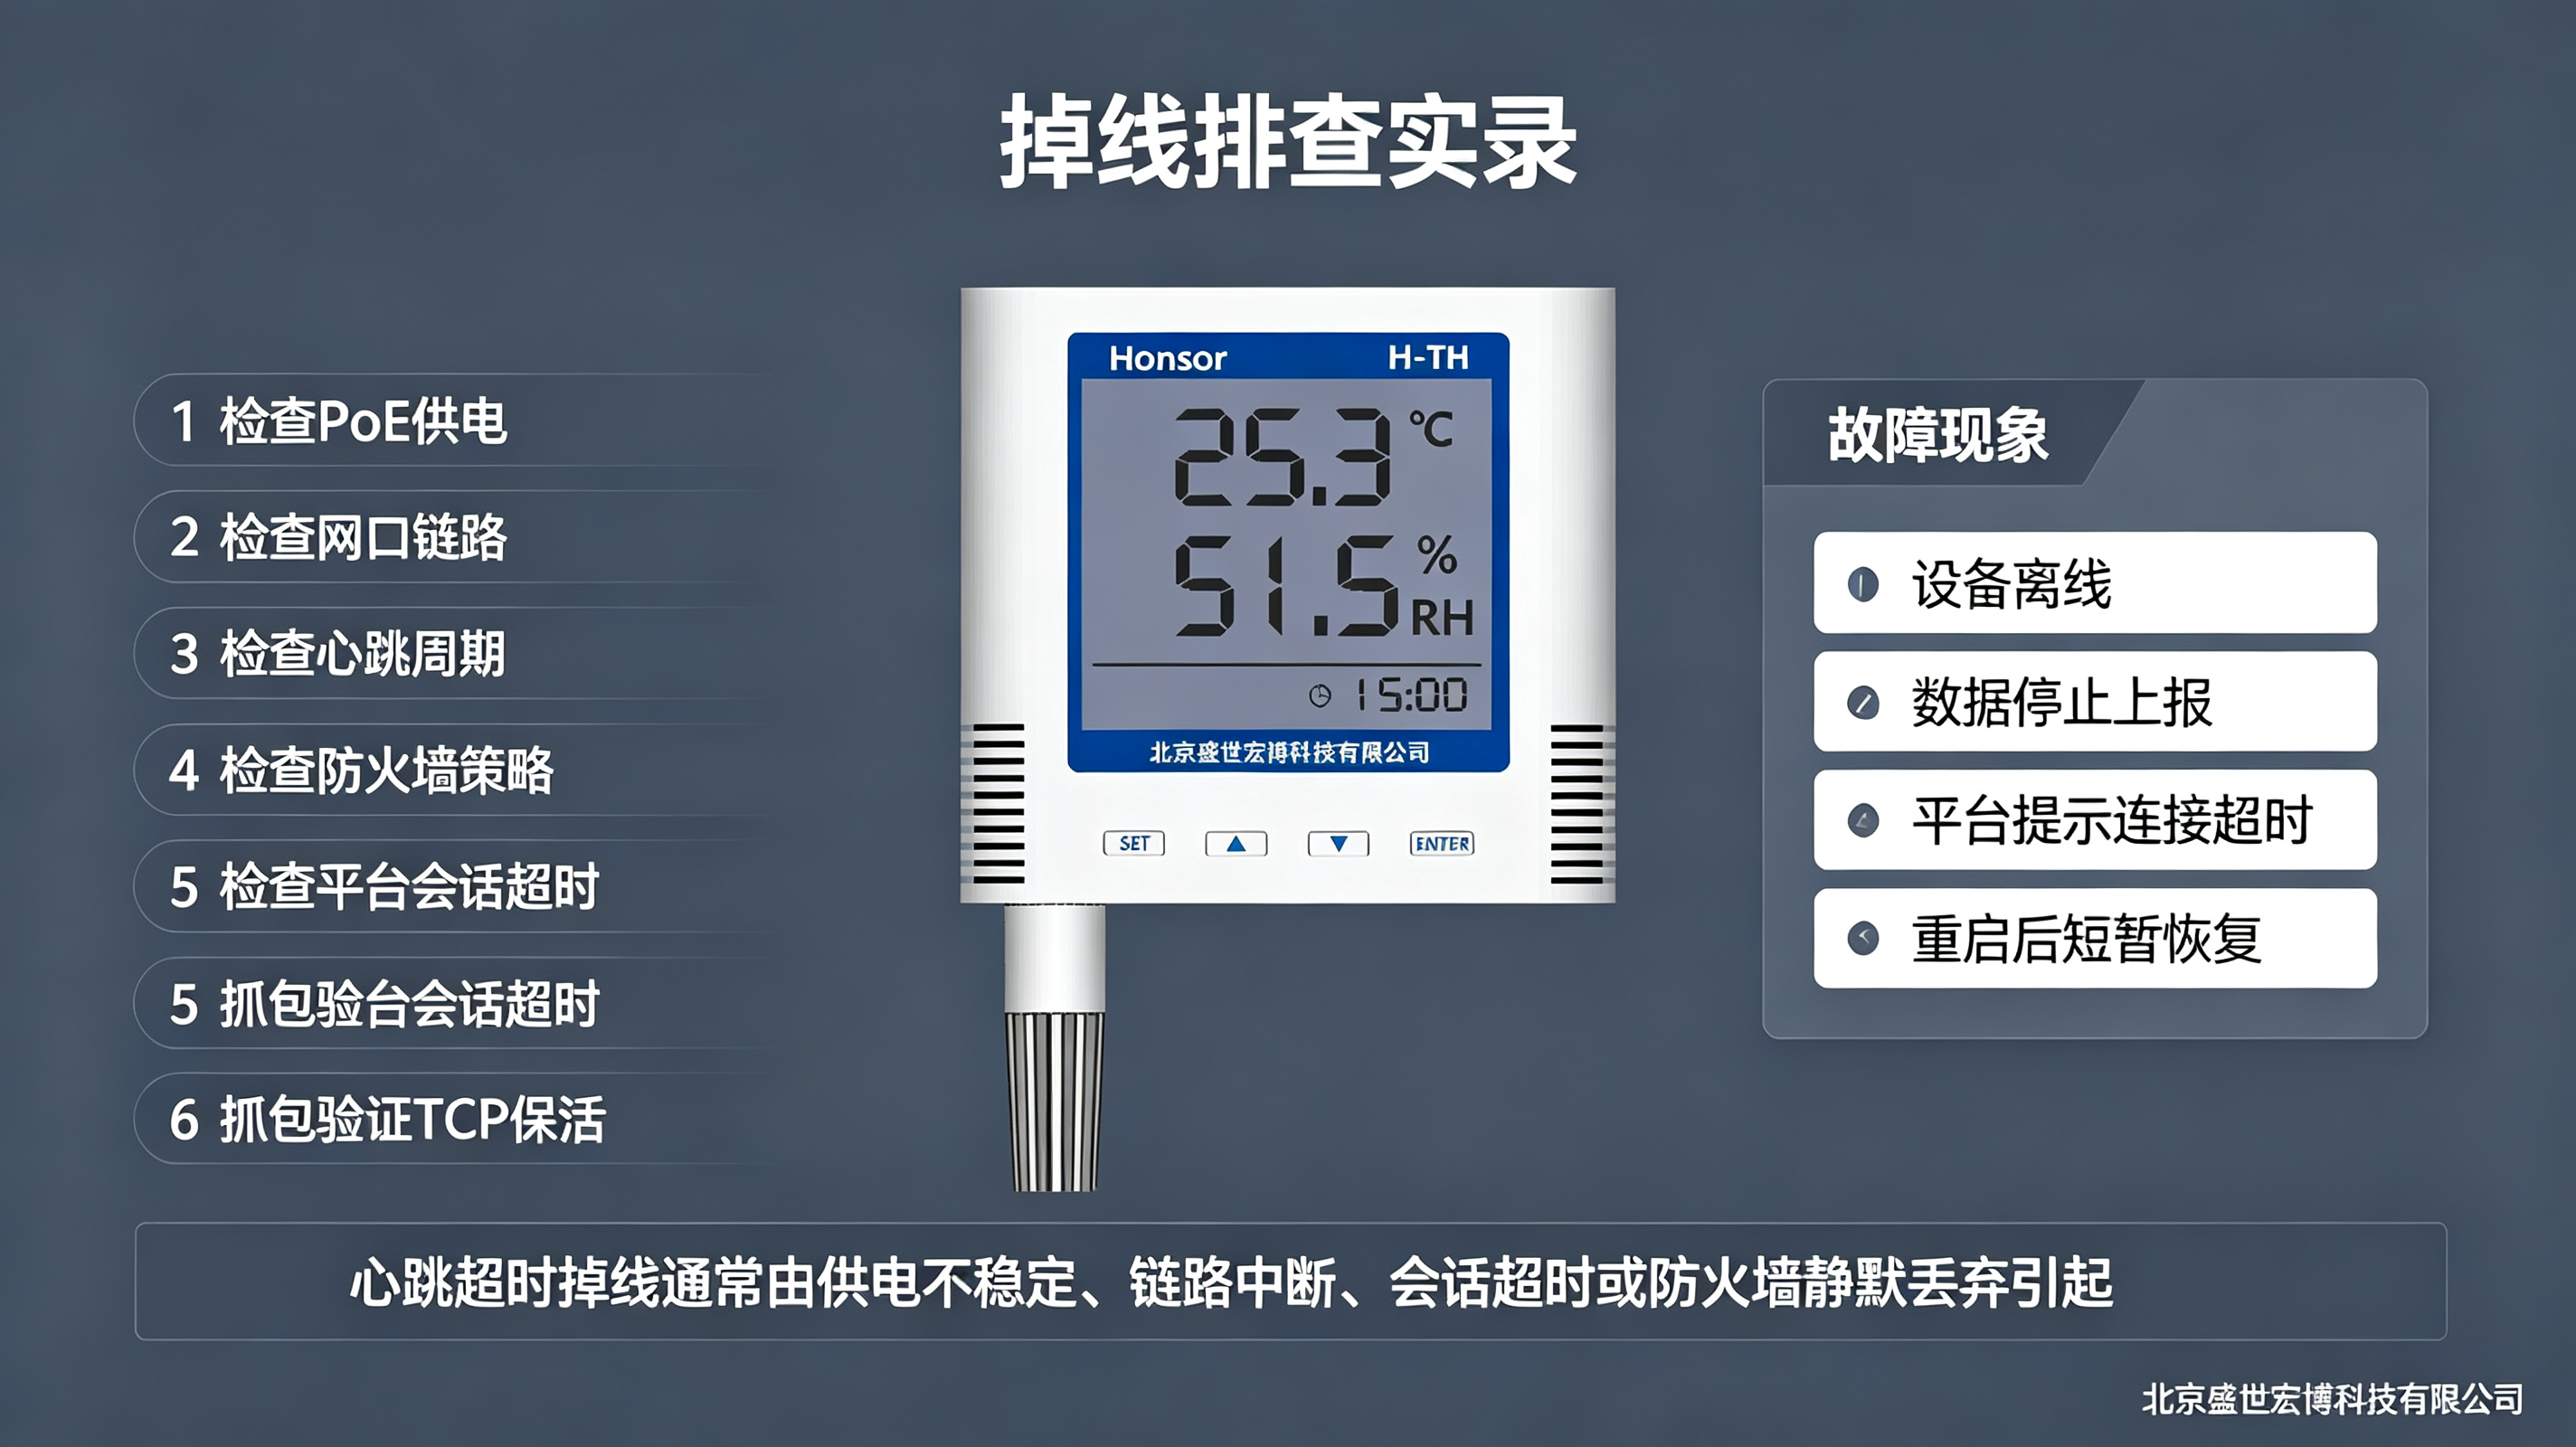
- 第四天开始,随机有 3–5 台传感器"掉线"——平台显示离线,但 PoE 交换机面板灯还亮着
- 重启交换机端口或拔插网线后恢复,过几小时又掉
- 日志里看到的是:
TCP keepalive timeout/connection reset by peer
这不是个例。 几乎每个用 PoE + TCP 做环境监控的项目,都会在某个阶段踩这个坑。
一、先还原现场:掉线时的"症状"
1. 现象清单
现象 | 说明 |
|---|---|
PoE 端口灯常绿 | 物理层链路没断 |
交换机显示端口 UP,速率 100Mbps 全双工 | 二层没挂 |
传感器 IP 能 ping 通(有时) | 网络层间歇性可达 |
Modbus TCP 连接建立失败 | 传输层有问题 |
已建立的连接读超时 | 对端不回数据 |
重启端口后恢复 | 设备 TCP 栈"卡死" |
随机发生,不是固定某几台 | 不是设备硬件批次问题 |
2. 初步排查方向(全部排除)
❌ 网线质量问题 → 换了六类线,照样掉
❌ 交换机端口故障 → 换了端口,照样掉
❌ PoE 供电不足 → 交换机 PoE 预算还剩 60%,单口实际功耗 2.3W(标称 802.3af 15.4W)
❌ IP 冲突 → 静态 IP + DHCP 保留,无冲突
❌ 广播风暴 → 监控 VLAN 隔离,流量正常
❌ 传感器固件 Bug → 升级到最新固件,照样掉
到这里,问题已经不是"换根线、换个口"能解决的了。
二、根因定位:TCP 连接保活机制的缺失
1. 问题本质
以太网温湿度传感器本质是嵌入式设备,TCP/IP 协议栈跑在 MCU 上(常见方案:STM32 + LWIP,或 ESP32 + FreeRTOS)。
这类轻量级协议栈有一个共同特征:TCP 连接管理是"尽力而为"的,不是"工业级可靠"的。
具体来说:
正常流程:
  传感器上电 → 建立 TCP 连接 → 等待 Modbus 请求 → 回复响应 → 保持连接

异常场景:
  网络抖动 → TCP 包丢失 → 重传超时 → 连接进入"半开"状态
  传感器端认为连接还在
  服务器端认为连接已断开(或反之)
  → 传感器不再接受新连接(端口资源耗尽)
  → 或者传感器还在发数据,但服务器已关闭连接
  → 表现为"心跳超时"
2. 关键缺失:没有 TCP Keepalive
大多数廉价以太网传感器的默认行为是:
- 不启用 TCP Keepalive(或 keepalive 间隔设为 0 = 禁用)
- 不实现应用层心跳(没有周期性 "ping" 报文)
- 不检测对端是否存活(半开连接不主动关闭)
结果:
时间线:
  T0: 传感器与服务器建立 TCP 连接
  T1: 网络抖动,中间路由器丢了一个包
  T2: 服务器 TCP 栈重传,成功恢复 → 服务器认为连接正常
  T3: 传感器端因为 LWIP 内存不足/堆溢出,TCP PCB 状态机卡死
  T4: 传感器不再响应任何 TCP 报文
  T5: 服务器发送下一个 Modbus 请求 → 超时
  T6: 服务器重试 3 次 → 全部超时
  T7: 服务器关闭连接,标记设备离线
  T8: 传感器仍然"认为"连接存在,但已经不响应
  T9: 下次传感器重启/端口重置前,这个连接永远卡死
三、PoE 供电的"放大器效应"
到这里你可能问:为什么 RS485 没这个问题?
因为 RS485 是无连接的——每次请求都是独立的,没有"连接状态"需要维护。
而 TCP 是面向连接的,连接状态需要两端共同维护。
PoE 环境进一步放大了这个问题:
1. PoE 供电的"软重启"特性
供电方式 | 断电重启 | 效果 |
|---|---|---|
DC 电源适配器 | 拔插头 | 完全断电,MCU 复位,TCP 栈重建 |
PoE(标准 802.3af) | 交换机端口关闭 PoE → 重新供电 | 等效于拔插电源,MCU 完全复位 |
PoE(持续供电模式) | 网络链路闪断,但 PoE 供电不中断 | MCU 不复位,但 TCP 栈卡死 |
最后一种情况最致命:
网络链路因为交换机 STP 收敛 / 端口协商变化而短暂中断
  → PoE 供电没断(因为供电和数据是分开协商的)
  → 传感器 MCU 一直跑着
  → TCP 连接因为链路中断而半开
  → MCU 不知道链路已经恢复
  → 连接永远卡死
  → 人眼看交换机端口灯还亮着(PoE 还在供)
这就是为什么"灯还亮着但设备掉线"。
2. 交换机 PoE 供电管理的影响
部分交换机有 PoE 节能功能:
端口连续 5 分钟无流量 → 降低 PoE 供电功率
  → 传感器 MCU 电压波动
  → LWIP 协议栈内存分配失败
  → TCP 连接异常
或者:
PoE 供电协商周期(约 5 分钟一次)
  → 短暂电压跌落(微秒级)
  → 对 MCU 没影响
  → 但对 PHY 芯片的链路状态机有影响
  → 链路重新协商
  → TCP 连接中断
四、排查过程复盘
第一步:抓包定位(Wireshark)
在交换机镜像端口抓传感器流量:
No.  Time        Source        Destination   Protocol Info
1    10:23:01    192.168.10.5  192.168.10.1 TCP      502 → 54321 [SYN]
2    10:23:01    192.168.10.1  192.168.10.5 TCP      54321 → 502 [SYN, ACK]
3    10:23:01    192.168.10.5  192.168.10.1 TCP      502 → 54321 [ACK]
4    10:23:02    192.168.10.1  192.168.10.5 ModbusTCP Read Holding Registers
5    10:23:02    192.168.10.5  192.168.10.1 ModbusTCP Response
...(正常通信约 3 天)
6    14:56:33    192.168.10.1  192.168.10.5 TCP      [TCP Retransmission] ...
7    14:56:34    192.168.10.1  192.168.10.5 TCP      [TCP Retransmission] ...
8    14:56:36    192.168.10.1  192.168.10.5 TCP      [TCP Retransmission] ...
9    14:56:40    192.168.10.1  192.168.10.5 TCP      [TCP Retransmission] ...
10   14:56:48    192.168.10.1  192.168.10.5 TCP      [TCP Retransmission] ...
...(重传持续约 15 分钟,然后停止)关键发现:
- 服务器在重传(说明服务器认为连接还在)
- 传感器没有任何响应(没有 RST,没有 ACK)
- 重传最终停止(服务器放弃),但传感器端 TCP PCB 仍然占用
第二步:登录传感器 Web 界面
部分传感器有简单的 Web 管理界面,查看:
System Uptime: 3 days 14 hours 32 minutes
TCP Connections: 1 (ESTABLISHED)
Free Heap: 4,128 bytes (总 16KB)
TCP Retransmission Queue: 0
Free Heap 只有 4KB——LWIP 的 TCP 接收窗口和发送缓冲区加起来就占了大部分内存。
当多个连接同时存在(比如 Web 界面 + Modbus TCP + SNMP),内存碎片化导致协议栈异常。
第三步:模拟复现
在实验室用相同型号传感器 + 可编程交换机:
1. 建立 Modbus TCP 连接
2. 正常通信 5 分钟
3. 交换机端口 shutdown(模拟链路中断)
4. 等待 30 秒
5. 交换机端口 no shutdown
6. 观察传感器行为
结果:
链路恢复后,传感器不响应任何 TCP 连接请求
  → 用 nmap 扫描 502 端口:filtered
  → 但 ICMP ping 通(IP 层正常)
  → 说明 TCP 层卡死,IP 层还活着
100% 复现。
五、解决方案:四层保活策略
方案 1:服务器端启用 TCP Keepalive(第一道防线)
在轮询程序(边缘网关 / 软网关)中,为 Modbus TCP 连接设置 Keepalive 参数:
import socket

def create_modbus_socket(host, port):
    sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    sock.setsockopt(socket.SOL_SOCKET, socket.SO_KEEPALIVE, 1)

    # Linux 系统
    sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPIDLE, 30)   # 30s 无数据开始探测
    sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPINTVL, 10)  # 每 10s 探测一次
    sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPCNT, 3)     # 3 次失败断开

    sock.connect((host, port))
    return sock
这样:
服务器端 TCP 栈会定期发送 Keepalive 探测包
如果传感器不响应 3 次 → 服务器主动关闭连接
下次轮询时重新建立连接 → 恢复正常但注意:这只能解决"服务器端发现问题",不能解决"传感器端 TCP 栈卡死"。传感器仍然卡着那个 PCB。
方案 2:应用层心跳 + 连接超时重建(第二道防线)
在 Modbus TCP 之上实现应用层心跳:
class ModbusTCPClient:
    def __init__(self, host, port, timeout=5, heartbeat_interval=30):
        self.host = host
        self.port = port
        self.timeout = timeout
        self.heartbeat_interval = heartbeat_interval
        self.last_response_time = time.time()
        self.sock = None
        self.connect()

    def connect(self):
        self.sock = create_modbus_socket(self.host, self.port)
        self.last_response_time = time.time()

    def read_registers(self, addr, count):
        try:
            req = self.build_read_request(addr, count)
            self.sock.send(req)
            resp = self.sock.recv(256)
            self.last_response_time = time.time()
            return self.parse_response(resp)
        except (socket.timeout, socket.error) as e:
            self.handle_error(e)

    def handle_error(self, error):
        """连接异常 → 关闭旧连接 → 重建"""
        logger.warning(f"{self.host}: {error}, reconnecting...")
        try:
            self.sock.close()
        except:
            pass
        time.sleep(1)
        self.connect()

    def check_heartbeat(self):
        """定时心跳检查"""
        if time.time() - self.last_response_time > self.heartbeat_interval:
            # 发送一个无害的读请求(读设备 ID)
            try:
                self.read_registers(0x00, 1)
            except:
                self.handle_error(Exception("heartbeat failed"))
方案 3:传感器端配置(如果支持)
部分高端传感器允许配置 TCP 参数:
参数 | 推荐值 | 说明 |
|---|---|---|
TCP Keepalive | Enable | 启用 TCP 层保活 |
Keepalive Idle | 30s | 30s 无数据发探测 |
Keepalive Interval | 10s | 探测间隔 |
Keepalive Count | 3 | 3 次失败断开 |
TCP Connection Timeout | 300s | 无活动连接自动关闭 |
Max Connections | 1 | 限制为单连接,防止资源耗尽 |
Connection Idle Timeout | 60s | 60s 无数据自动关闭连接 |
如果传感器不支持这些参数(大多数廉价型号确实不支持),那就只能靠方案 1 + 2。
方案 4:交换机侧配置(第四道防线)
# Cisco 交换机示例
interface GigabitEthernet0/1
 description POE-Temp-Sensor-01
 switchport access vlan 100
 spanning-tree portfast
 spanning-tree bpduguard enable
# 关键配置:
 udld port aggressive          # 单向链路检测,链路异常自动 shutdown
 storm-control broadcast level pps 100  # 广播风暴抑制
# PoE 配置:
 power inline static max 4000  # 固定供电功率,不要用 auto
power inline static 很重要——防止交换机 PoE 管理逻辑在端口无流量时降低供电。
另外:
# 关闭 PoE 节能
no energywise
# 或者
power efficient-ethernet auto   # 如果用 EEE,确保不会中断供电
六、PoE 交换机端口"定时重启"应急方案
如果以上方案都不能彻底解决(比如传感器固件确实不支持 Keepalive,且已经部署了 200 台),可以用一个"笨办法":
定时重启 PoE 端口——在凌晨低峰期,通过 SNMP 或交换机 API 关闭再打开 PoE 供电:
def poe_port_reset(switch_ip, port, community):
    """通过 SNMP 关闭再打开 PoE 端口"""
    # PoE 端口控制 OID(Cisco)
    pethPsePortAdminEnable = f'1.3.6.1.2.1.105.1.1.1.3.1.{port}'

    # 关闭 PoE
    set_snmp(pethPsePortAdminEnable, 2, switch_ip, community)  # 2 = shutdown
    time.sleep(5)

    # 打开 PoE
    set_snmp(pethPsePortAdminEnable, 1, switch_ip, community)  # 1 = enable

    logger.info(f"PoE port {port} reset completed")

# 每天凌晨 3:00 执行
schedule.every().day.at("03:00").do(
    poe_port_reset, "192.168.10.254", port=5, community="private"
)这不是"优雅"的方案,但工程上有效——相当于每天给传感器一次"硬重启",防止 TCP 栈长时间运行后卡死。
七、选型建议:采购时怎么避免这个问题
如果你还没买传感器,或者正在做下一期项目,采购技术规格书里应该加上这些要求:
要求 | 说明 |
|---|---|
TCP Keepalive 可配置 | 允许设置 idle/interval/count |
连接空闲超时自动关闭 | 无活动 N 秒后主动关闭,释放资源 |
最大连接数限制 | 防止多连接耗尽内存 |
看门狗(硬件) | MCU 异常时硬件复位 |
支持 MQTT 而非纯 Modbus TCP | MQTT 有内置心跳(PINGREQ/PINGRESP),比裸 TCP 可靠 |
固件可升级 | 能修复协议栈 Bug |
提供 LWIP 版本信息 | 确认不是已知有 Bug 的版本 |
如果供应商说"我们支持 TCP Keepalive",让他提供配置截图或 Web 界面截图,不要只听口头承诺。
八、总结:这个坑的本质
PoE + TCP 的组合,把"物理供电"和"网络连接"解耦了:
  - 物理供电一直有(PoE 灯亮)
  - 网络连接可能已经断了(TCP 栈卡死)
  - 人眼看到的是"灯亮着,应该没问题"
  - 实际是"设备活着,但 TCP 死了"

解决思路:
  1. 服务器端:TCP Keepalive + 应用层心跳 + 超时重建
  2. 交换机侧:静态 PoE 供电 + UDLD + 关闭节能
  3. 传感器端:选支持 Keepalive 的型号(或支持 MQTT)
4. 应急:定时 PoE 端口重启这不是"设备质量差"的问题,而是轻量级 TCP/IP 协议栈 + PoE 供电特性 + 无连接保活机制三者叠加后的系统性问题。
理解了根因,解决方案就清晰了——不是"换设备",而是在系统层面补上保活机制。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号