用 WorkBuddy 管项目:任务拆分 + 代码生成实战
原创
用 WorkBuddy 管项目:任务拆分 + 代码生成实战
原创
华东子
发布于 2026-09-25 20:11:13
发布于 2026-09-25 20:11:13
写给被"项目一上手就乱"困扰的同学:别再一次性硬写完整脚本。把一个模糊需求丢给 WorkBuddy(会自己动手的 AI 智能体(Agent)),靠"先拆任务、再逐项生成代码、最后拼装验证",今天就能跑通你的第一个小工具。
一、问题场景:项目不是写不出,是拆不开
很多同学想用 AI 提效,却卡在"管项目"这一步。典型画面是:
- 需求一句话,落地没头绪。"帮我做个下载文件夹自动整理的小工具"——方向清楚,但从哪行代码写起,脑子是空的。
- 一次性想写完,结果半成品。上来就写一个 200 行的脚本,跑到一半发现分类逻辑、同名冲突、报告格式都没想清,越改越乱。
- 不会拆任务,把"做项目"当成"写一段代码"。真正难的不是写,而是把模糊目标切成边界清楚的活——这一步没做,AI 也容易给你一段"看着对、跑不通"的代码。
根因就一句:我们只把 WorkBuddy 当"写代码的",没把它当"管项目的搭档"。它擅长的是"你给一个清楚的小任务,它还你一段能跑的代码";你该做的,是先当架构师把项目拆开,再派活。
下面用一个真实能跑的例子,把"拆任务 + 生成代码"的全过程摊开。
二、解决方案:把"做一个项目"变成"派一串小活"
核心思路一句话:需求 → 任务树 → 逐项交给 WorkBuddy 生成代码 → 拼装验证。你定"拆成哪几块、每块输入输出是什么",它负责把每块写成代码。
2.1 先让 WorkBuddy 把需求拆成任务树
别急着要代码。先用这段话,让它帮你把目标拆成最小任务清单:
我要做一个 Python 小工具,把"下载文件夹"按文件类型自动分类整理。
请把它拆成最小任务清单,每个任务标清:输入是什么、输出是什么。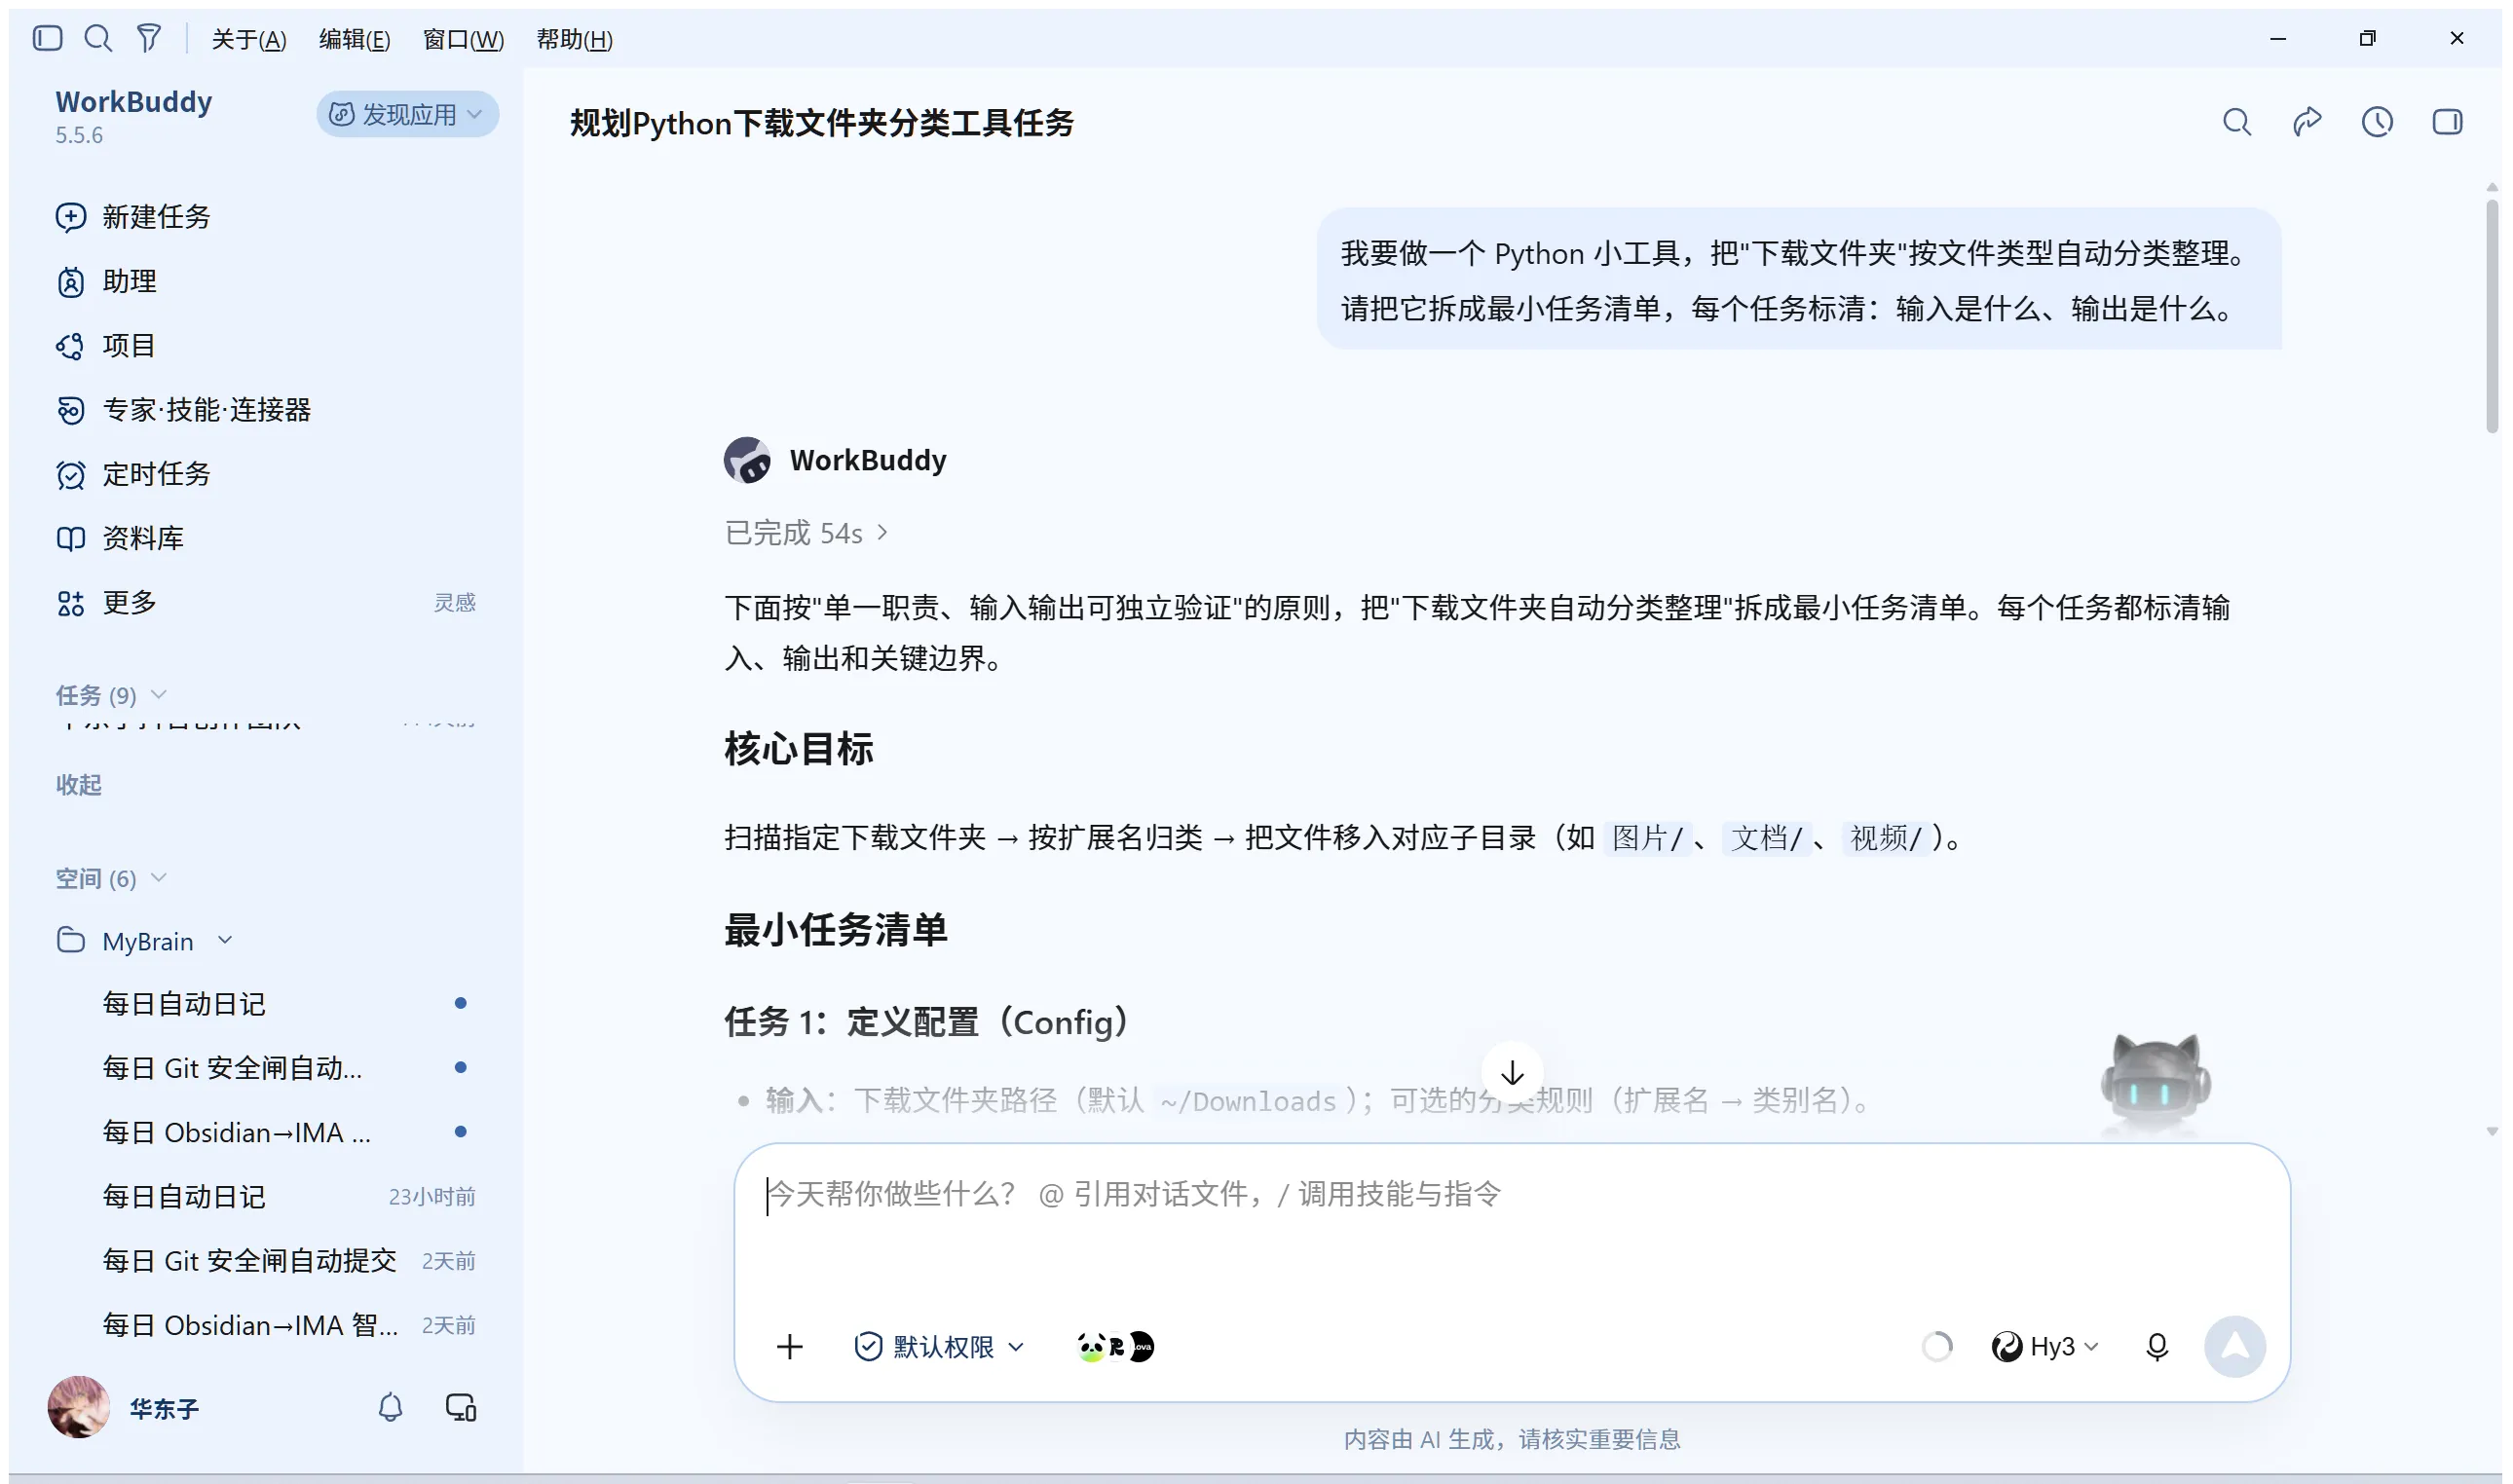
它会回你一张任务清单。我们拿"整理下载文件夹"为例,拆出来长这样(每个叶子都是一个能独立验证的小活):
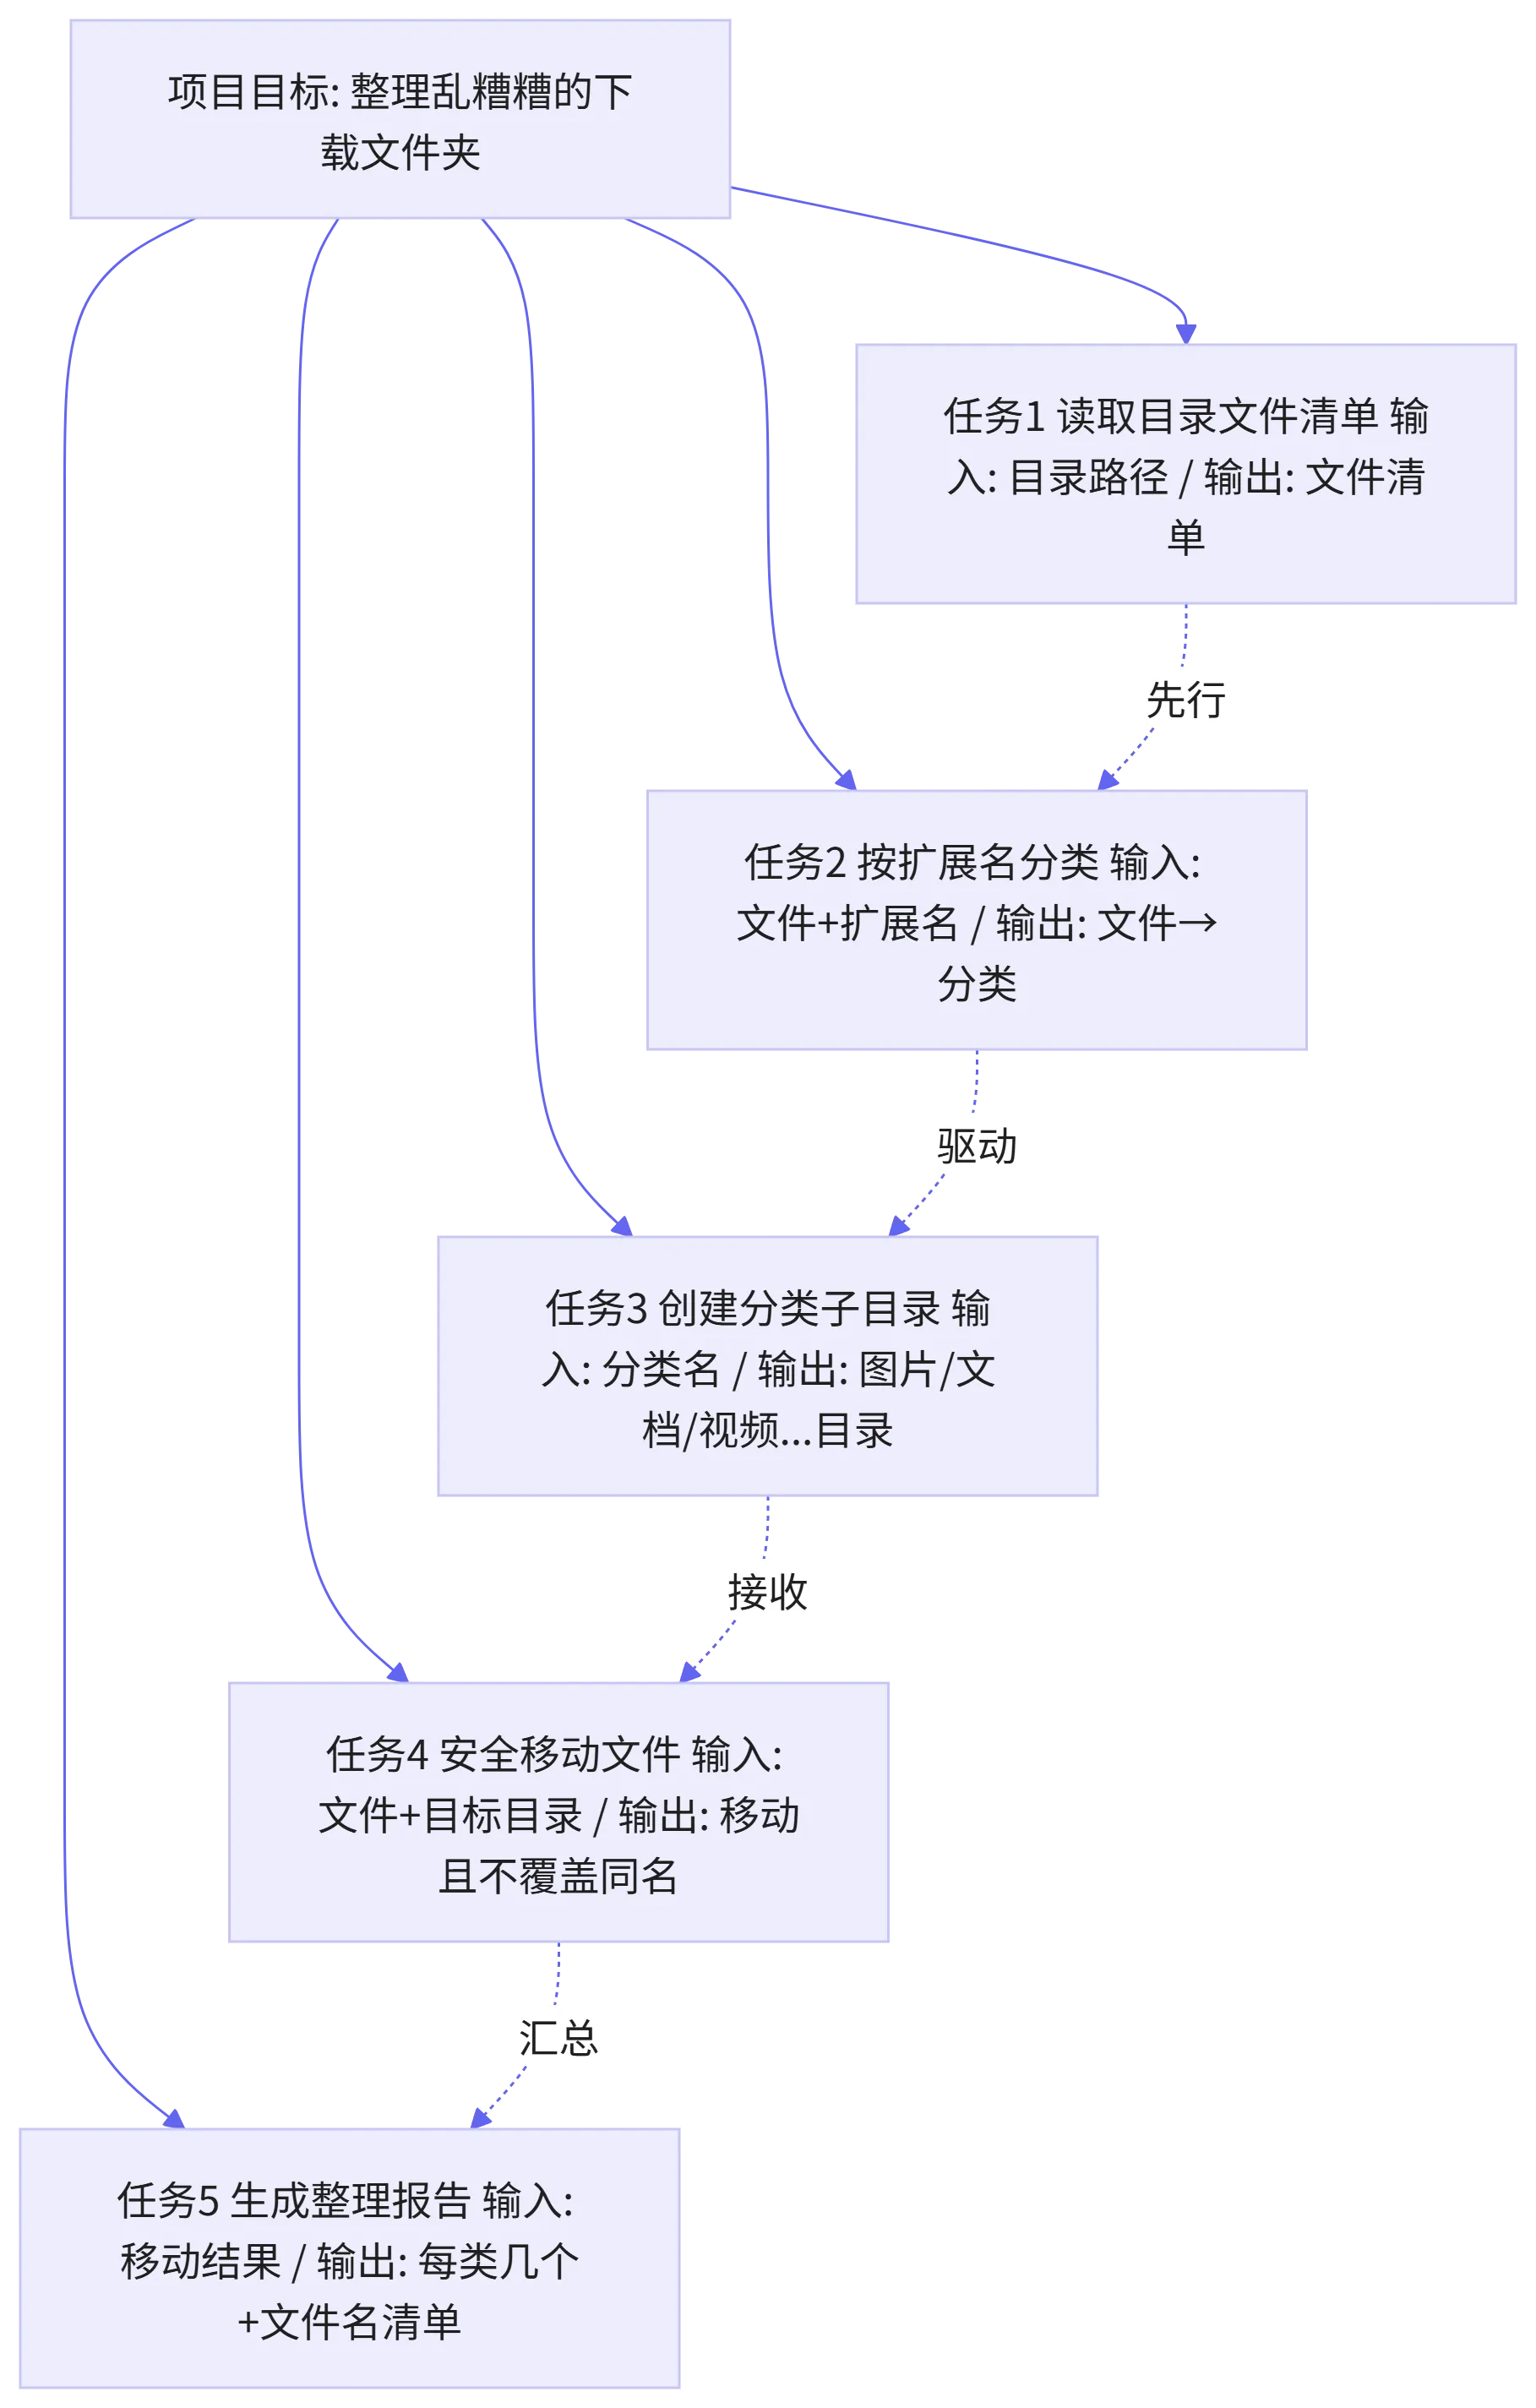
flowchart TD
    G["项目目标: 整理乱糟糟的下载文件夹"] --> T1["任务1 读取目录文件清单<br />输入: 目录路径 / 输出: 文件清单"]
    G --> T2["任务2 按扩展名分类<br />输入: 文件+扩展名 / 输出: 文件→分类"]
    G --> T3["任务3 创建分类子目录<br />输入: 分类名 / 输出: 图片/文档/视频...目录"]
    G --> T4["任务4 安全移动文件<br />输入: 文件+目标目录 / 输出: 移动且不覆盖同名"]
    G --> T5["任务5 生成整理报告<br />输入: 移动结果 / 输出: 每类几个+文件名清单"]
    T1 -.先行.-> T2
    T2 -.驱动.-> T3
    T3 -.接收.-> T4
T4 -.汇总.-> T5注释(判定标准):每个叶子任务的粒度,必须一句话说清"输入是什么、输出是什么"——说不清的,说明还没拆到位,要继续往下切,直到能直接交给 WorkBuddy 生成。
2.2 逐项派活,拿可运行代码
任务拆清后,逐项派活。小工具可以直接给一段整合指令(带齐约束),也能按任务一个个来。我给的整合指令是:
用 Python 标准库写一个脚本 organizer.py:
1. 扫描目标目录下的文件(不处理子目录);
2. 按扩展名分到 图片/文档/视频/压缩/其他 子目录;
3. 分类目录不存在就创建;
4. 同名文件不覆盖,自动加序号;
5. 最后打印每类整理了几个、分别是哪些文件。
只使用标准库(pathlib/shutil/os),不要第三方依赖,加必要注释。
WorkBuddy 生成的代码我已用托管 Python 3.13 实际跑通(见 2.3 输出),可直接复制使用:
"""
下载文件夹整理工具(WorkBuddy 代码生成实战示例)
功能:按文件类型把目标目录里的文件分到 图片/文档/视频/压缩/其他 子目录,
     同名冲突自动改名,最后打印整理报告。
用法:python organizer.py <要整理的目录>
依赖:仅 Python 标准库(pathlib / shutil / os),无需安装任何第三方包
"""
import sys
import shutil
from pathlib import Path
from collections import defaultdict

# 扩展名 -> 分类 的映射表(新增类型只需在这里加一行)
CATEGORY_MAP = {
    "图片": {".jpg", ".jpeg", ".png", ".gif", ".webp", ".bmp", ".svg"},
    "文档": {".pdf", ".doc", ".docx", ".txt", ".md", ".xlsx", ".pptx", ".csv"},
    "视频": {".mp4", ".mov", ".avi", ".mkv", ".webm"},
    "压缩": {".zip", ".rar", ".7z", ".tar", ".gz"},
}
DEFAULT_CATEGORY = "其他"


def classify(ext: str) -> str:
    """根据扩展名返回分类名;不在映射表里的归到「其他」。"""
    ext = ext.lower()
    for cat, exts in CATEGORY_MAP.items():
        if ext in exts:
            return cat
    return DEFAULT_CATEGORY


def organize(target: Path) -> dict:
    """扫描 target 下的文件,按类型移动到对应子目录,返回 {分类: [文件名,...]}。"""
    moved = defaultdict(list)
    for f in target.iterdir():
        if not f.is_file():
            continue  # 跳过子目录,只整理「文件」
        cat = classify(f.suffix)
        dest_dir = target / cat
        dest_dir.mkdir(exist_ok=True)  # 分类目录不存在就建
        dest = dest_dir / f.name
        # 同名冲突:追加序号,绝不覆盖原文件
        if dest.exists():
            stem, suffix = f.stem, f.suffix
            i = 1
            while dest.exists():
                dest = dest_dir / f"{stem}_{i}{suffix}"
                i += 1
        shutil.move(str(f), str(dest))
        moved[cat].append(f.name)
    return moved


def main():
    if len(sys.argv) < 2:
        print("用法: python organizer.py <要整理的目录>")
        sys.exit(1)
    target = Path(sys.argv[1])
    if not target.is_dir():
        print(f"目录不存在: {target}")
        sys.exit(1)
    result = organize(target)
    print(f"\n整理完成:{target}")
    if not result:
        print("(目录里没有可移动的文件)")
        return
    for cat, files in result.items():
        print(f"\n【{cat}】{len(files)} 个")
        for name in files:
            print(f"  - {name}")


if __name__ == "__main__":
    main()
2.3 跑起来,看真实输出
把上面脚本存成 organizer.py,对一个乱目录跑一下:
python organizer.py "C:/Users/你的名/Downloads"我在测试目录(含 png/jpg/pdf/xlsx/mp4/zip/txt 共 8 个文件)实跑,输出如下,分类与报告都正确:
整理完成:C:\...\mess

【压缩】1 个
  - archive.zip
【视频】1 个
  - clip.mp4
【文档】3 个
  - data.xlsx
  - note.pdf
  - readme.txt
【图片】2 个
  - photo1.png
  - scan.jpg
跑通这一步,你的第一个"WorkBuddy 管的"小项目就成了。下面两张图把"怎么管"和"怎么验证"固化成可复用的流程:
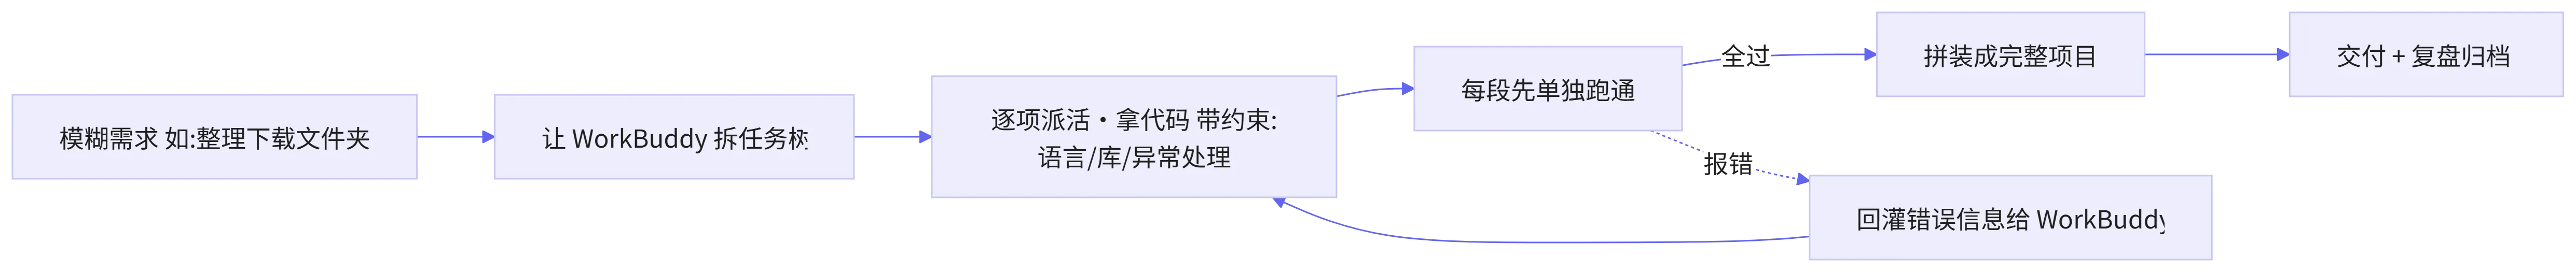
flowchart LR
    R["模糊需求<br />如:整理下载文件夹"] --> S["让 WorkBuddy 拆任务树"]
    S --> P["逐项派活·拿代码<br />带约束:语言/库/异常处理"]
    P --> V["每段先单独跑通"]
    V -->|全过| M["拼装成完整项目"]
    M --> D["交付 + 复盘归档"]
    V -.|报错| B["回灌错误信息给 WorkBuddy"]
    B --> P
注释(管控要求):箭头是单向推进;只有"每段先单独跑通"全过,才进"拼装"。这是质量门禁——攒一堆再调试,最容易互相甩锅、查不出错在哪。
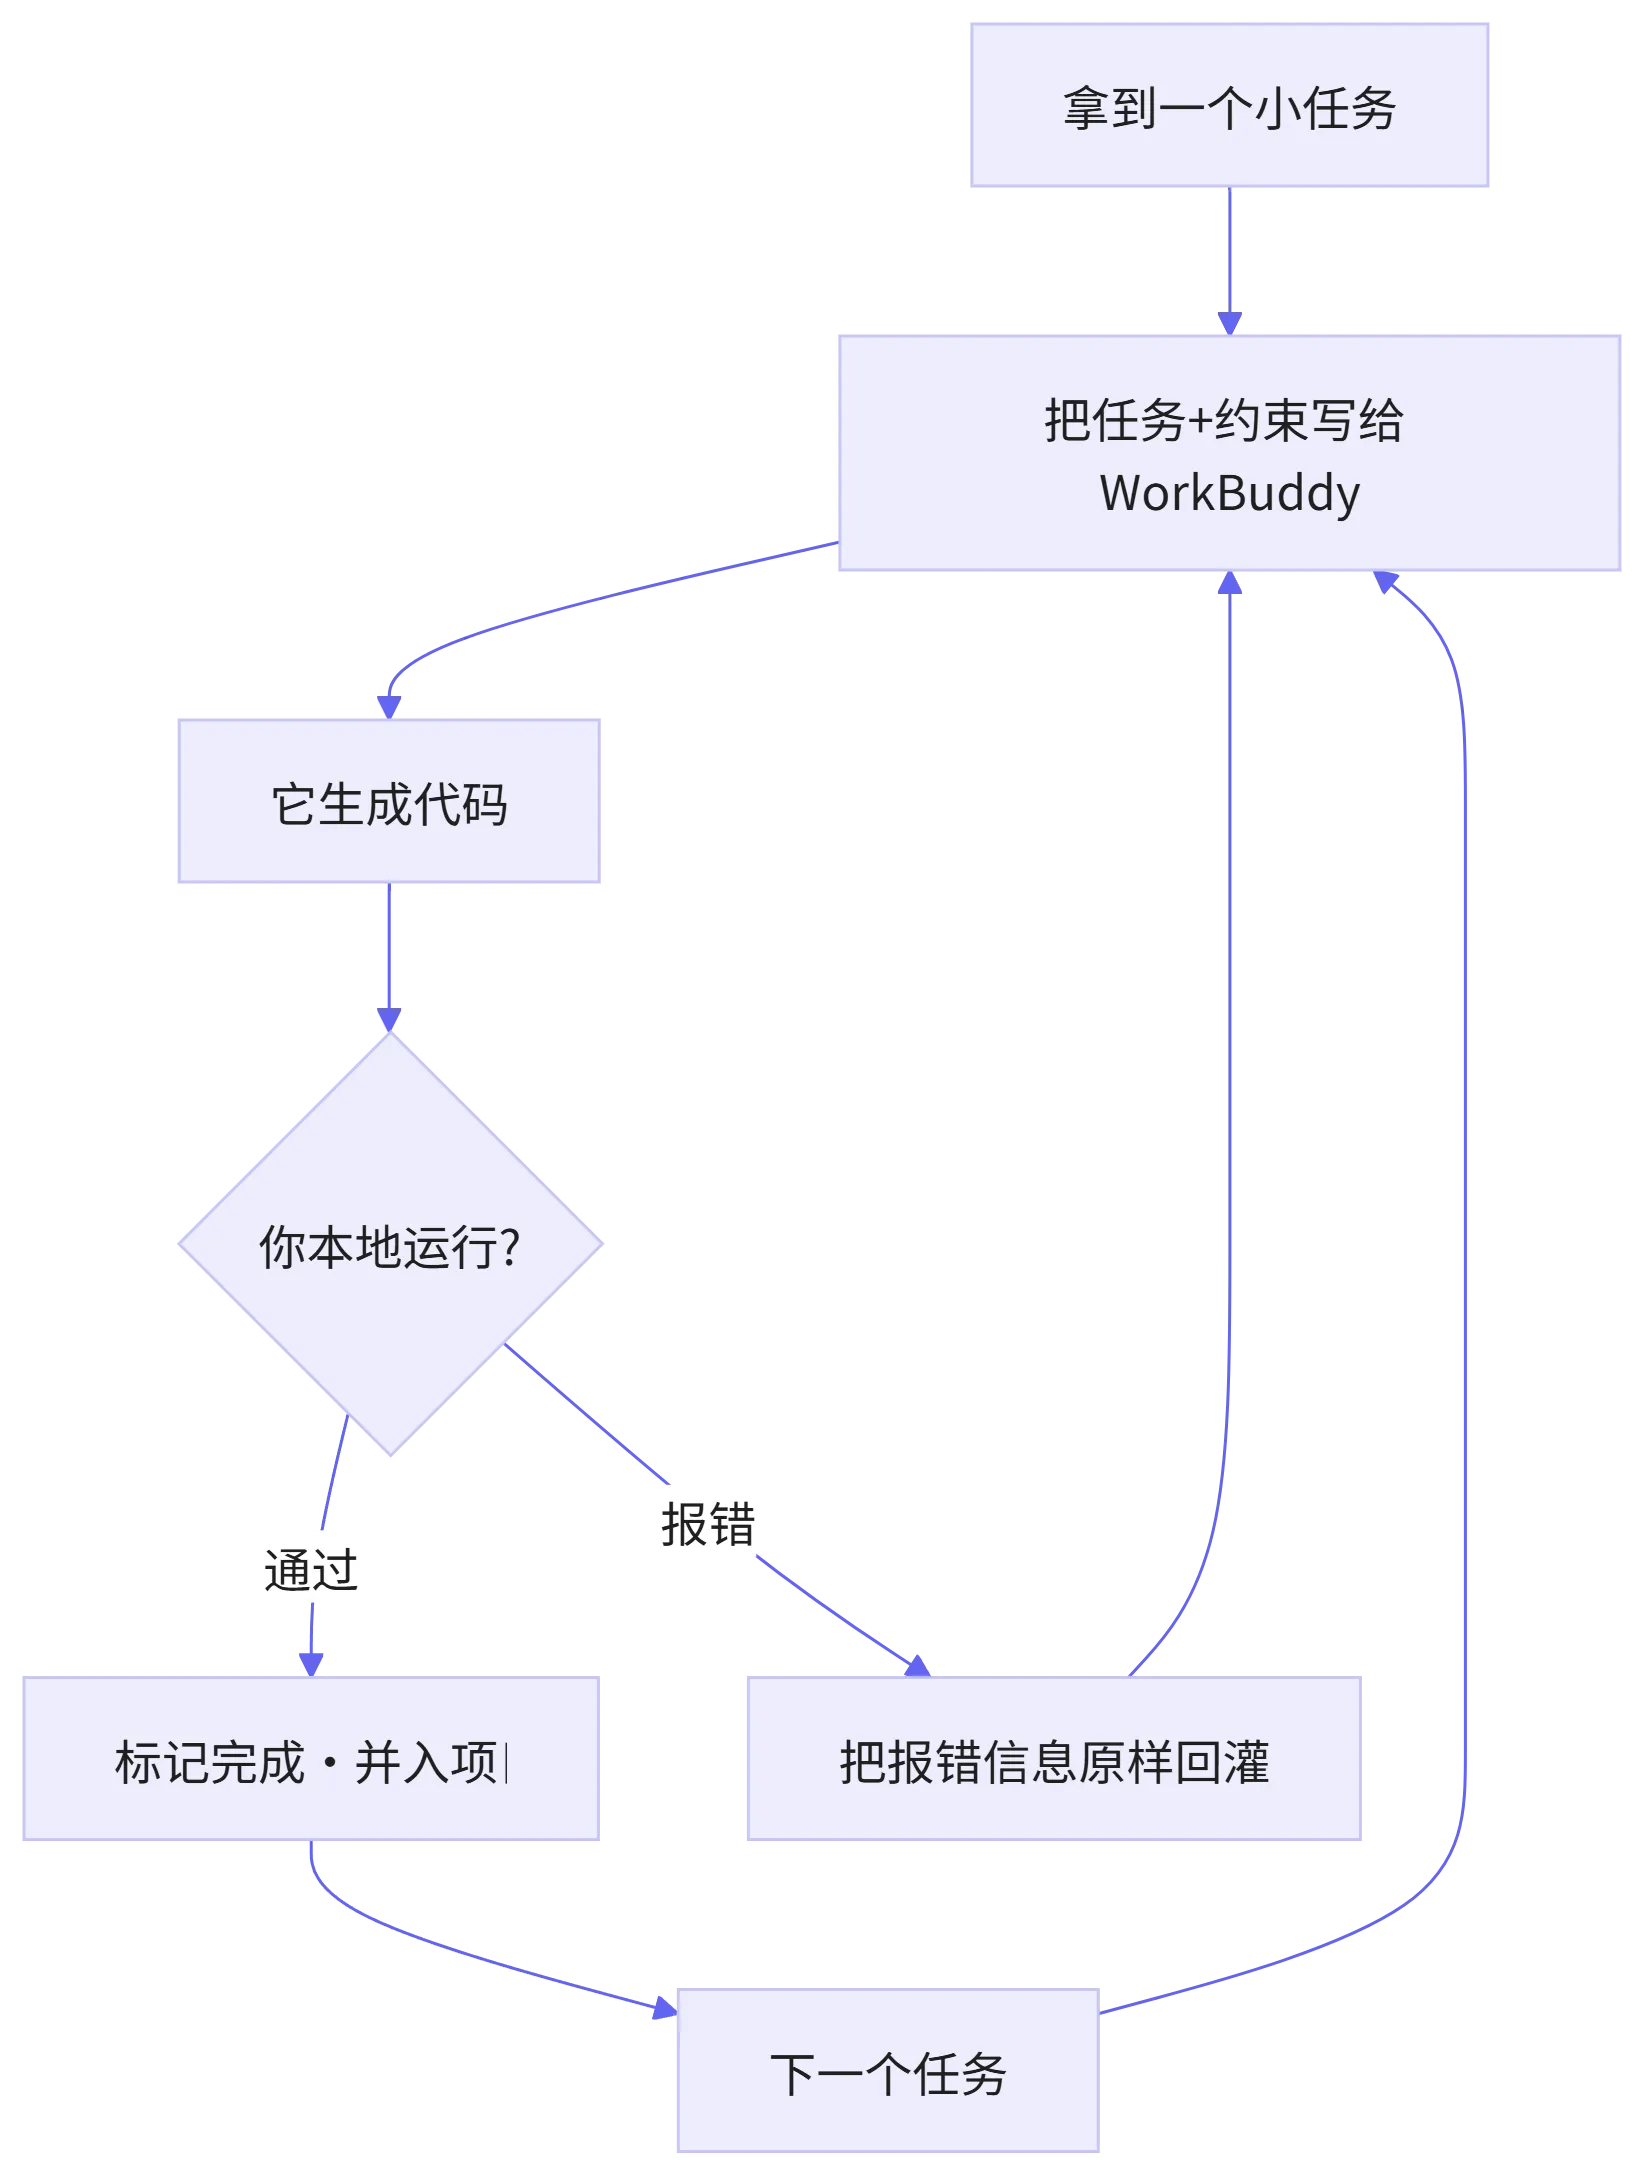
flowchart TD
    Q["拿到一个小任务"] --> W["把任务+约束写给 WorkBuddy"]
    W --> G["它生成代码"]
    G --> Y{"你本地运行?"}
    Y -->|通过| OK["标记完成·并入项目"]
    Y -->|报错| F["把报错信息原样回灌"]
    F --> W
    OK --> Q2["下一个任务"]
Q2 --> W注释(判定标准):报错不要"重写整段",只把报错信息原样回灌给 WorkBuddy 让它改——这是单任务 生成-验证 小循环,保证每段都独立可跑、可控。
三、原理解析:为什么"先拆后写"才跑得通
1. 智能体(Agent)擅长"单点任务",不擅长"一次性宏大目标"。 WorkBuddy 这类带手脚的 Agent 强在"你给一个边界清楚的小活,它还你一段能跑的代码"。目标一旦宏大且模糊,它容易产出"看着对、跑不通"的半成品——不是它弱,是你没给它够清晰的边界。
2. 小任务边界清晰,生成的代码才可控、易验证。 每个叶子任务都有明确输入/输出,你一眼能判断"这块对不对"。对比"一次性写 200 行",拆开后的每段都短、都跑得动,错了也知道错在哪一段。
3. 你做"架构师",它做"施工员",注意力花在刀刃上。 真正值钱的判断——"拆成哪几块、每块输入输出是什么、约束是什么"——由你做;重复搬砖的写码交给它。你的认知资源从"怎么写这行"转移到"拆得对不对",这正是 AI 编程(code generation)提效的本质。
四、提示与避坑(作者经验谈)
- 拆到"一句话说清输入输出"的粒度。 说不清输入输出的任务,先别交给 WorkBuddy——那多半是还没拆透,继续往下切。
- 每生成一段,先单独跑,别攒一堆再调试。 这是 #2.3 门禁的由来:分段验证能把"哪段错"锁死,攒一起调会互相干扰。
- 派活时给足约束:指定语言、要求"只用标准库不装第三方"、提醒"加异常处理和注释"。约束越具体,一次生成的质量越高,返工越少。
- 敏感路径先备份再跑。 整理、重命名、移动类脚本,第一次跑前先复制一份目录;确认逻辑无误再对真目录跑——尤其"移动/删除"动作,宁可慢一步。
- 能力有时效。 WorkBuddy 的代码生成能力与入口会持续更新,本文流程基于 2026 年 8 月当前版本;具体交互以软件内当前说明为准,思路(先拆后写)不受版本影响。
跑顺这个"拆任务 + 生成代码"的闭环后,下一步可以把固定动作交给 WorkBuddy 自动化——比如"每天扫描下载文件夹自动整理""每周把整理报告推送到笔记"。从"手动派活"升级成"到点自己跑",项目就活成了工作流。
声明:本文由作者基于真实使用 WorkBuddy 管理项目的经验撰写,使用 AI 工具辅助润色;文中含 AI 生成内容,经作者审核修订。核心观点、工作流与示例代码均由作者负责。示例代码基于 Python 标准库,已用托管 Python 实际运行验证;具体操作与界面以 WorkBuddy 当前版本为准。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号