还在手动 tail 日志?用 Python + systemd 做一个 Nginx 异常告警哨兵

还在手动 tail 日志?用 Python + systemd 做一个 Nginx 异常告警哨兵
fruge365
发布于 2026-09-26 08:28:21
发布于 2026-09-26 08:28:21
还在手动 tail 日志?用 Python + systemd 做一个 Nginx 异常告警哨兵
前言
Nginx 出问题时,我最怕的不是日志里没有线索,而是问题已经发生了很久,自己还不知道。页面偶尔 502、静态文件找不到、权限报错、上游连接失败,这些信息其实都会落进 error.log,但如果还靠人隔一阵登录服务器执行 tail 或 grep,就很容易错过真正需要处理的时间窗口。相比“出事后再翻日志”,我更愿意让日志主动找人:脚本盯着新增内容,遇到错误级别或关键词就累计,达到阈值以后直接把最近几条异常推到钉钉群里。这样至少先把“什么时候坏的、出现了什么错误”送到眼前,再决定要不要马上登录服务器继续查。
这次我在 CentOS 7 上把这条链完整跑一遍:先安装 Python 3,创建钉钉自定义机器人并准备 Webhook;再用 /opt/nginx_log_monitor.py 持续读取 /var/log/nginx/error.log,按 [error]、failed、connection refused、timeout 等条件识别异常,默认每 10 秒检查一次、阈值设为 2。随后通过手工追加两条错误日志验证告警,再把脚本做成 nginx-dingtalk-monitor.service 常驻运行。最后安装 cpolar,把 SSH 的 22 端口映射到公网,方便人在外面时进入服务器继续排查。整篇会把“自动发现异常”“钉钉通知”和“远程运维入口”三层分开,不把公网 SSH 写成告警系统本身的一部分。
downloaded-image (10)
1. 手动查日志和主动告警,差别不只是省几条命令
平时排查 Nginx,我当然也会用 tail 或 grep。
问题在于,这种方式默认前提是:
我已经知道服务出问题了。
真正无人值守的时候,最需要补的是前面这一环:
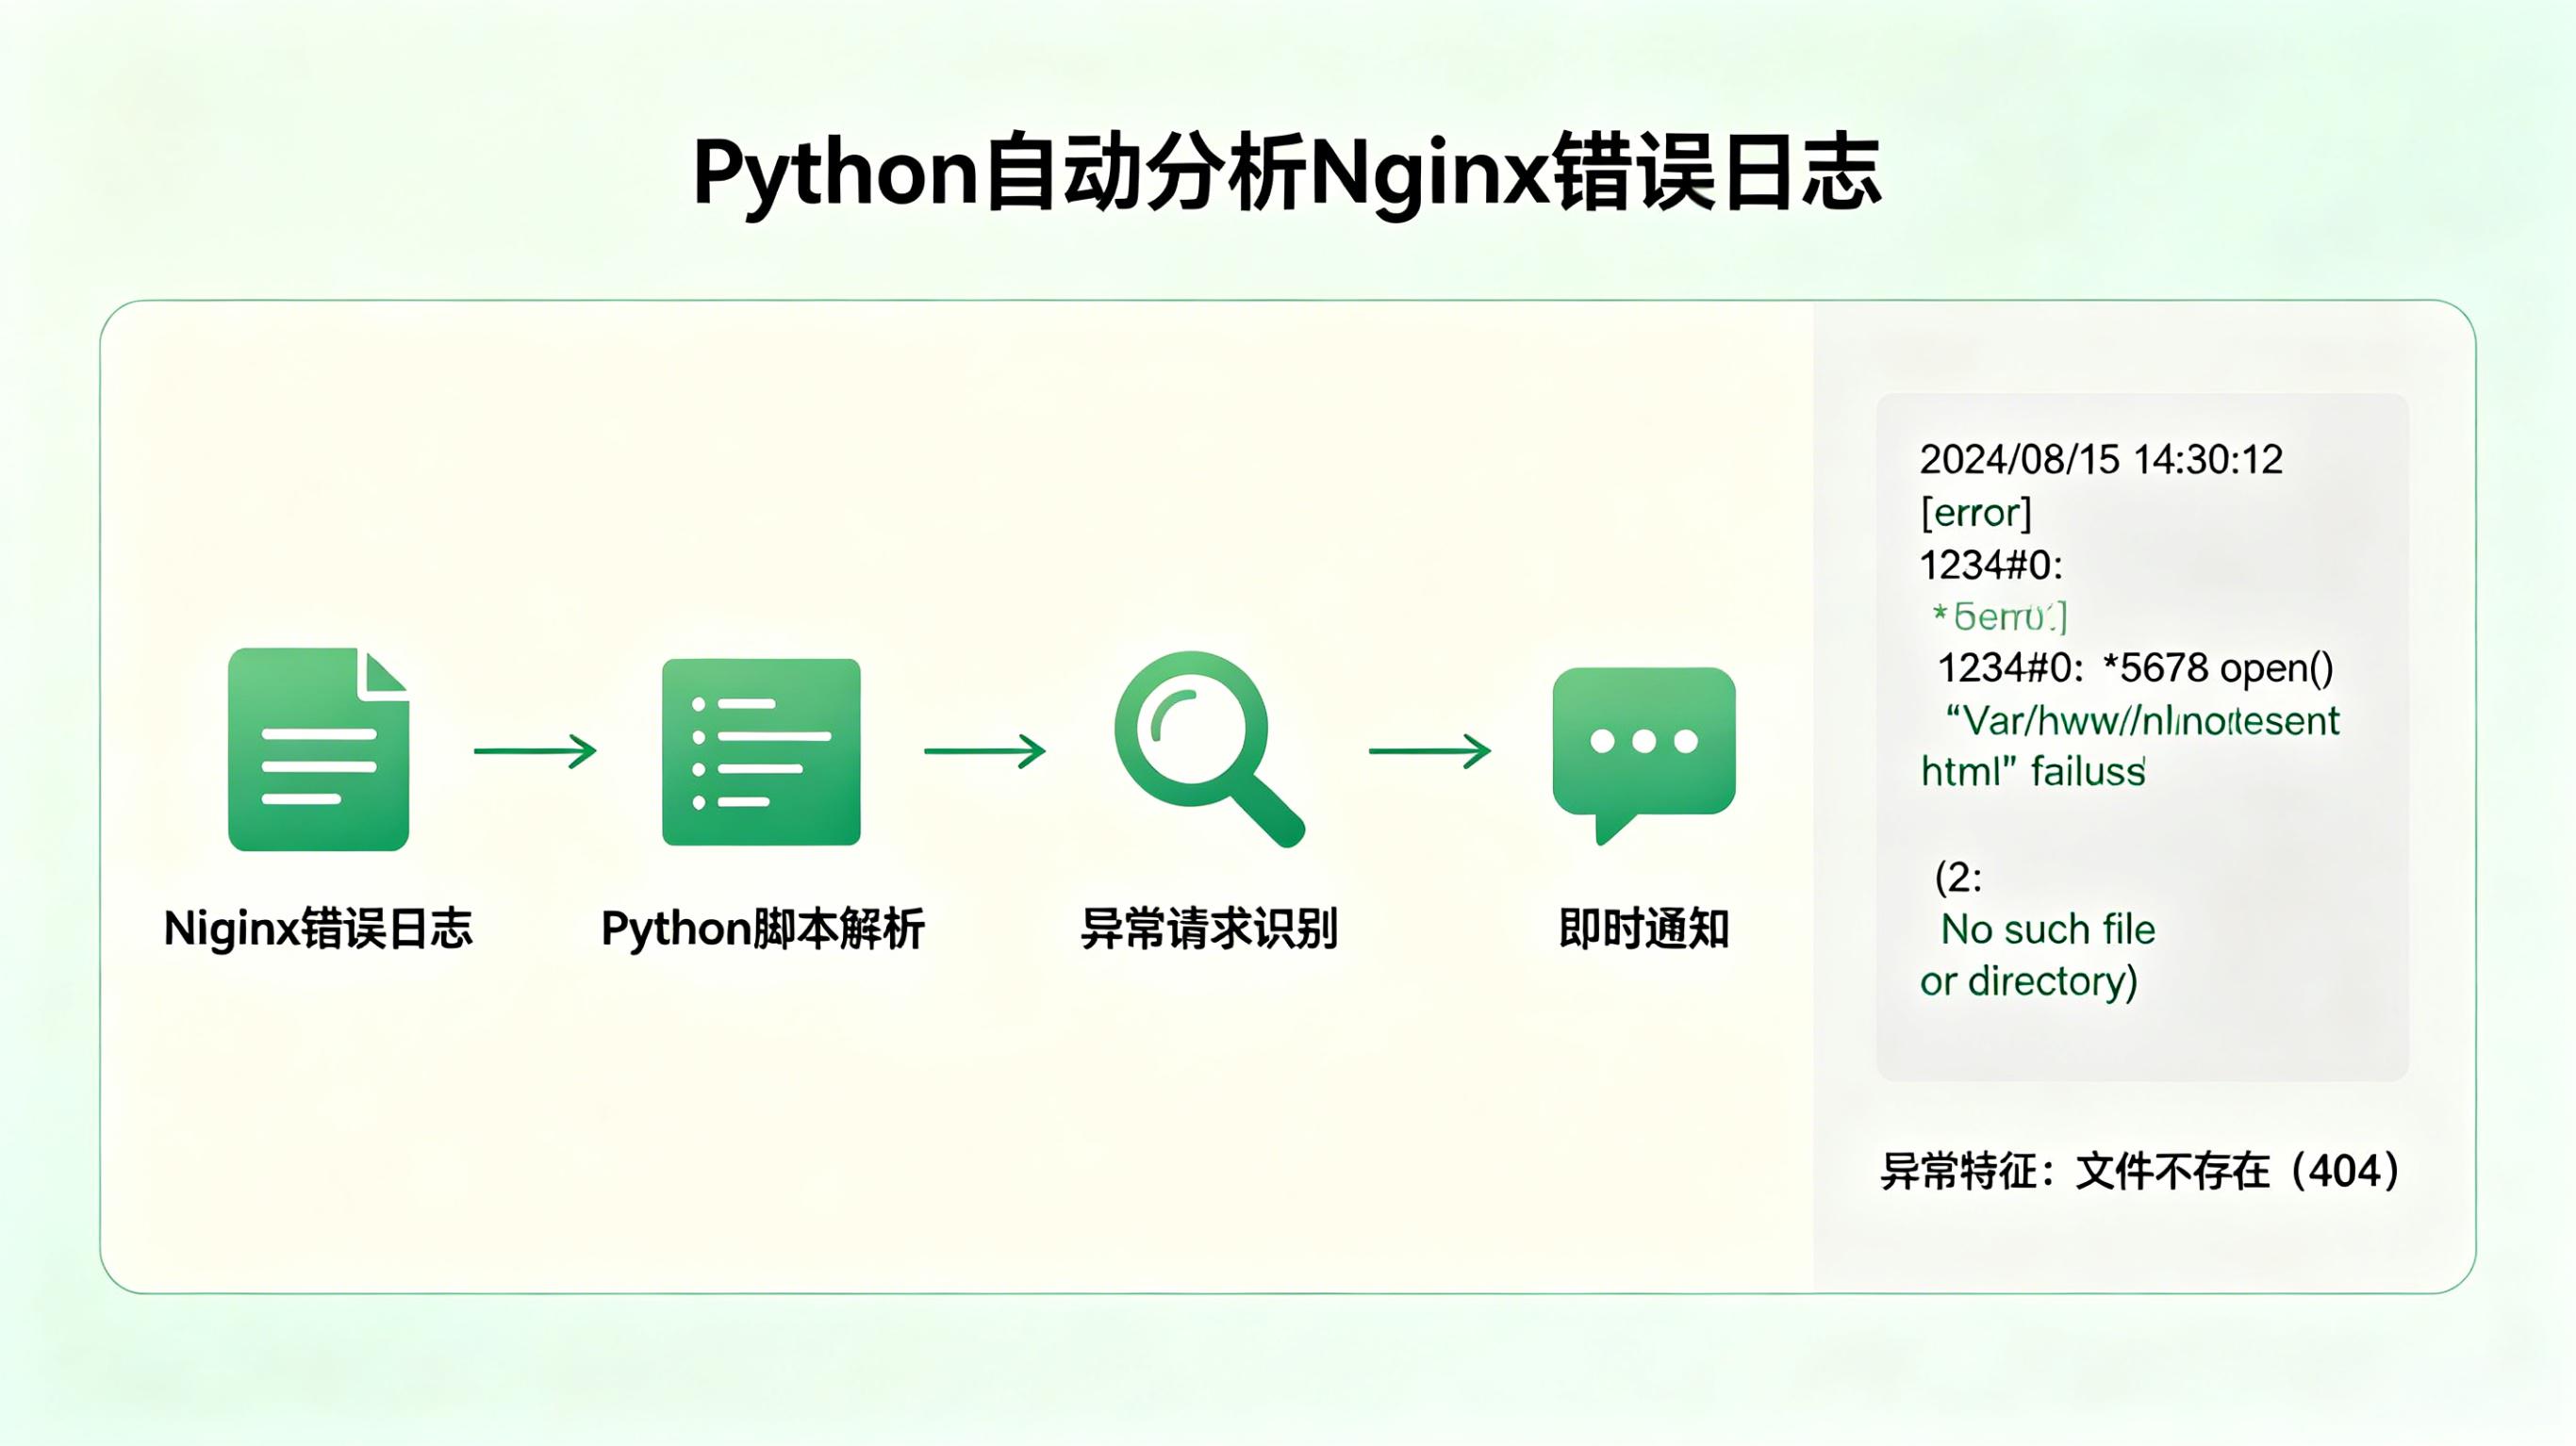
错误出现 → 脚本识别 → 达到条件 → 钉钉通知 → 人再进入服务器处理。
这套方案不替代 Nginx 日志,也不替代完整监控平台。
它解决的是:
让错误日志从“等人去看”变成“满足条件后主动提醒”。
2. 环境准备
这套流程使用:
- CentOS 7
- 已安装并运行的 Nginx
- Nginx 错误日志:
/var/log/nginx/error.log - Python 3
如果还没有 Python 3,先安装:
sudo yum install -y epel-release
sudo yum install -y python3 python3-pip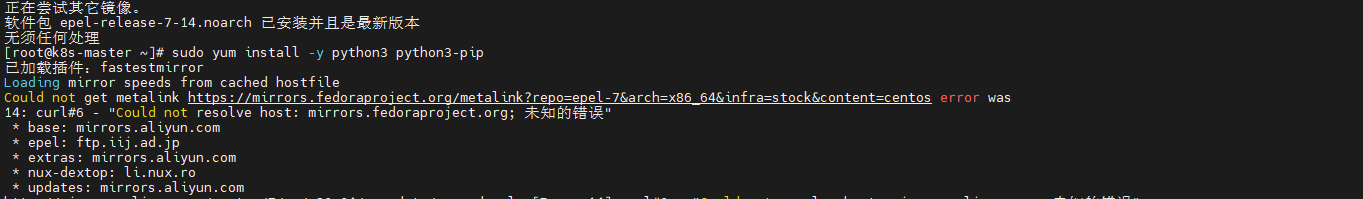
image-20260526145746789
后面的脚本还会用到 requests,真正运行前需要保证 Python 环境中可以正常导入它。
3. 创建钉钉机器人
进入钉钉群,打开右上角设置。
image-20260325141357694
找到:
智能群助手 → 添加机器人
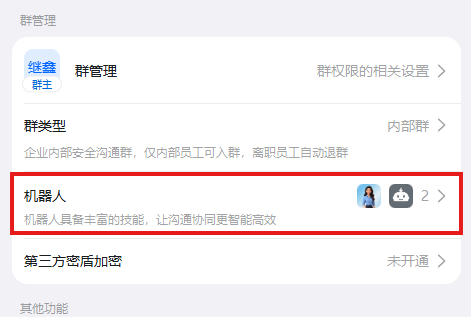
image-20260325141635253
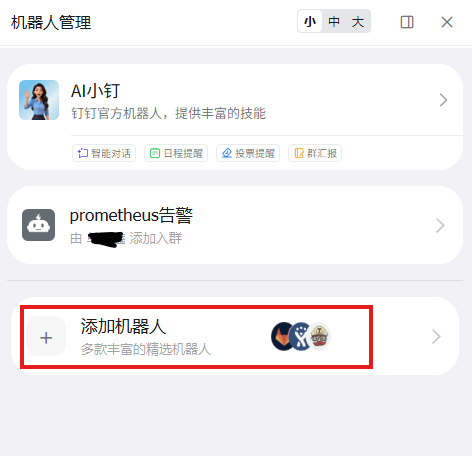
image-20260325141712706
选择:
自定义机器人
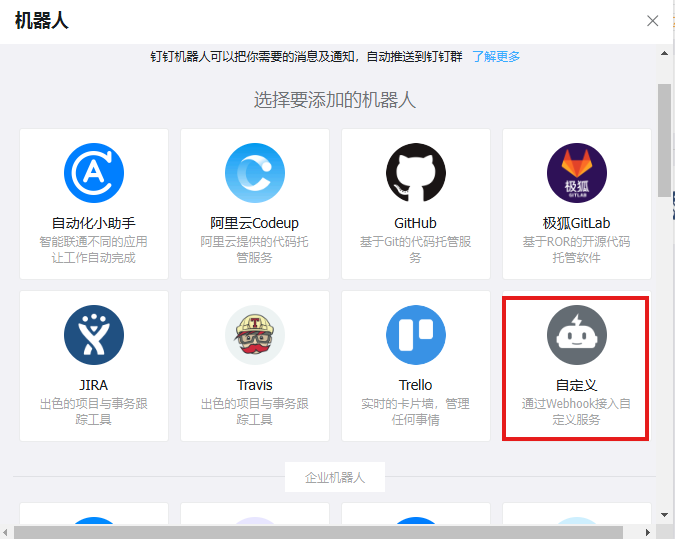
image-20260325141746662
继续添加。
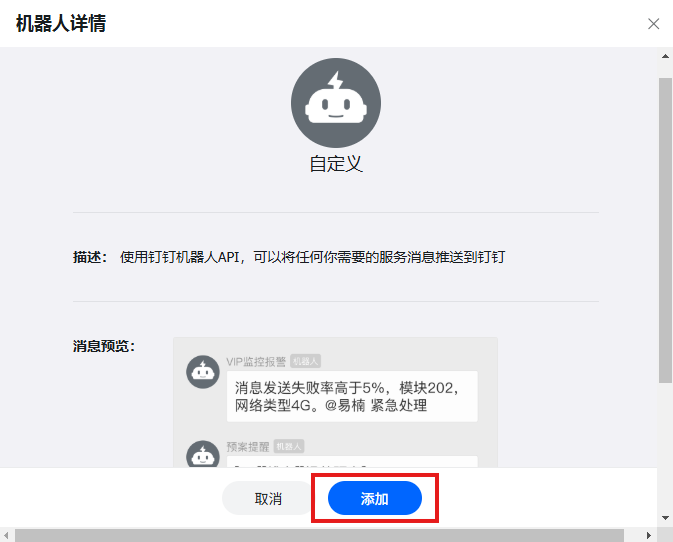
image-20260325141818703
机器人名称可以写成:
nginx告警
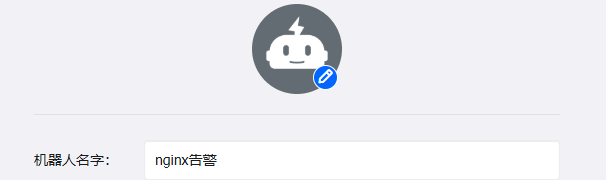
image-20260526161902839
4. 机器人安全设置
钉钉机器人需要安全限制,可以使用:
- 自定义关键词;
- 加签;
- IP 地址。
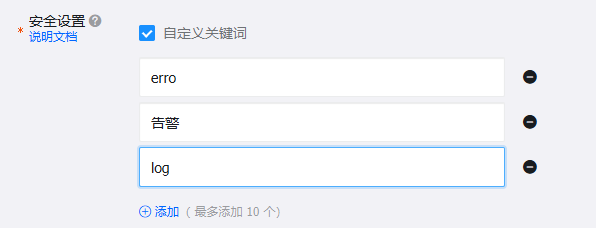
image-20260526162202318
如果启用加签,还会得到一个 secret。
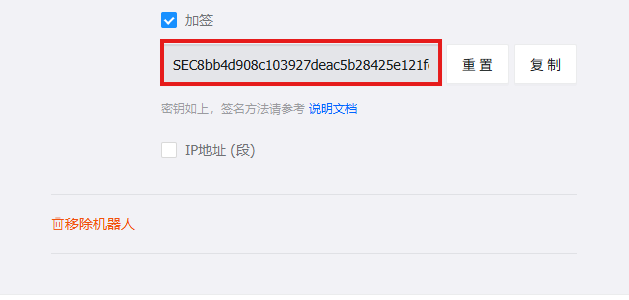
image-20260509103800058
机器人创建完成以后,复制 Webhook。
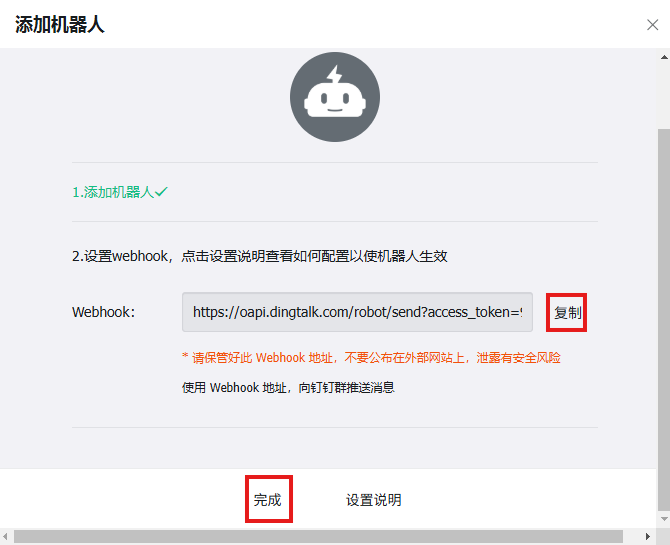
image-20260325143249017
Webhook 和 secret 都应该按凭据处理,不要直接写进公开仓库、公开截图或公开文章。
这次脚本先使用:
DINGTALK_SECRET = None
也就是先关闭加签测试。
5. 创建 Nginx 日志监控脚本
准备创建:
/opt/nginx_log_monitor.py
命令写成:
vi /opt/nginx_log_monitor.p这里要注意文件名。
后面的赋权、测试和 systemd 都使用:
/opt/nginx_log_monitor.py
如果前面实际创建成 /opt/nginx_log_monitor.p,后面会因为文件名不一致找不到脚本。
写入监控代码:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import time
import json
import hmac
import hashlib
import base64
import urllib.parse
from datetime import datetime
from collections import deque
import requests

# ================== 配置区 ==================
NGINX_ERROR_LOG = "/var/log/nginx/error.log"
CHECK_INTERVAL = 10  # 每10秒检查一次
ALERT_THRESHOLD = 2  # 达到此数量触发告警,自定义

# 钉钉机器人配置(替换为你自己的)
DINGTALK_WEBHOOK = "https://oapi.dingtalk.com......."
DINGTALK_SECRET = None  # 先关闭加签测试(设为字符串则启用加签)

# ===========================================

def get_sign_and_timestamp(secret):
    """生成钉钉加签所需的 timestamp 和 sign"""
    if not secret:
        return str(int(time.time() * 1000)), None
    timestamp = str(round(time.time() * 1000))
    secret_enc = secret.encode('utf-8')
    string_to_sign = '{}\n{}'.format(timestamp, secret)
    string_to_sign_enc = string_to_sign.encode('utf-8')
    hmac_code = hmac.new(secret_enc, string_to_sign_enc, digestmod=hashlib.sha256).digest()
    sign = urllib.parse.quote_plus(base64.b64encode(hmac_code))
    return timestamp, sign

def send_dingtalk_message(msg_text):
    """发送钉钉消息"""
    headers = {'Content-Type': 'application/json'}
    timestamp, sign = get_sign_and_timestamp(DINGTALK_SECRET)

    webhook_url = DINGTALK_WEBHOOK
    if sign:
        webhook_url += f"×tamp={timestamp}&sign={sign}"

    data = {
        "msgtype": "text",
        "text": {
            "content": msg_text
        }
    }

    print(f"[DEBUG] 发送钉钉请求 URL: {webhook_url}")
    try:
        resp = requests.post(webhook_url, headers=headers, data=json.dumps(data), timeout=10)
        result = resp.json()
        if result.get('errcode') == 0:
            print(f"[+] 钉钉消息发送成功: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
        else:
            print(f"[-] 钉钉发送失败: errcode={result['errcode']}, errmsg={result['errmsg']}")
    except Exception as e:
        print(f"[-] 请求异常: {e}")

def is_error_line(line):
    """判断是否为 Nginx 错误日志行"""
    line_lower = line.lower()
    # 显式错误级别
    if any(level in line for level in ["[error]", "[crit]", "[alert]", "[emerg]"]):
        return True
    # 关键词匹配(覆盖无级别但含错误的行)
    error_keywords = [
        "failed", "denied", "not found", "no such file",
        "connection refused", "timeout", "permission denied",
        "upstream prematurely closed", "broken pipe"
    ]
    return any(kw in line_lower for kw in error_keywords)

def monitor_log():
    try:
        with open(NGINX_ERROR_LOG, "r", encoding='utf-8', errors='ignore') as f:
            f.seek(0, 2)  # 跳到文件末尾
            recent_errors = deque(maxlen=20)
            error_count = 0
            last_check_time = time.time()

            print(f"[INFO] 开始监控日志: {NGINX_ERROR_LOG}")
            print(f"[INFO] 告警阈值: {ALERT_THRESHOLD} 条错误 / {CHECK_INTERVAL} 秒")

            while True:
                line = f.readline()
                if line:
                    # [调试] 打印原始日志行(可注释掉)
                    print(f"[RAW LOG] {repr(line)}")
                    if is_error_line(line):
                        error_count += 1
                        recent_errors.append(line.strip())
                        print(f"[DEBUG] 检测到错误 ({error_count}): {line.strip()}")
                else:
                    current_time = time.time()
                    if current_time - last_check_time >= CHECK_INTERVAL:
                        print(f"[INFO] 检查周期结束 - 当前错误数: {error_count}")
                        if error_count >= ALERT_THRESHOLD:
                            content = (
                                f"🚨 Nginx 异常告警\n"
                                f"时间: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}\n"
                                f"过去 {CHECK_INTERVAL} 秒内检测到 {error_count} 条错误日志:\n\n"
                                + "\n".join(list(recent_errors)[-5:])
                            )
                            send_dingtalk_message(content)
                            # 告警后重置
                            error_count = 0
                            recent_errors.clear()
                        # 注意:未达阈值时不重置,继续累积
                        last_check_time = current_time  # ← 已修复!

                    time.sleep(1)

    except FileNotFoundError:
        print(f"[-] 日志文件不存在: {NGINX_ERROR_LOG}")
    except KeyboardInterrupt:
        print("\n[!] 监控已停止")

if __name__ == "__main__":
    monitor_log()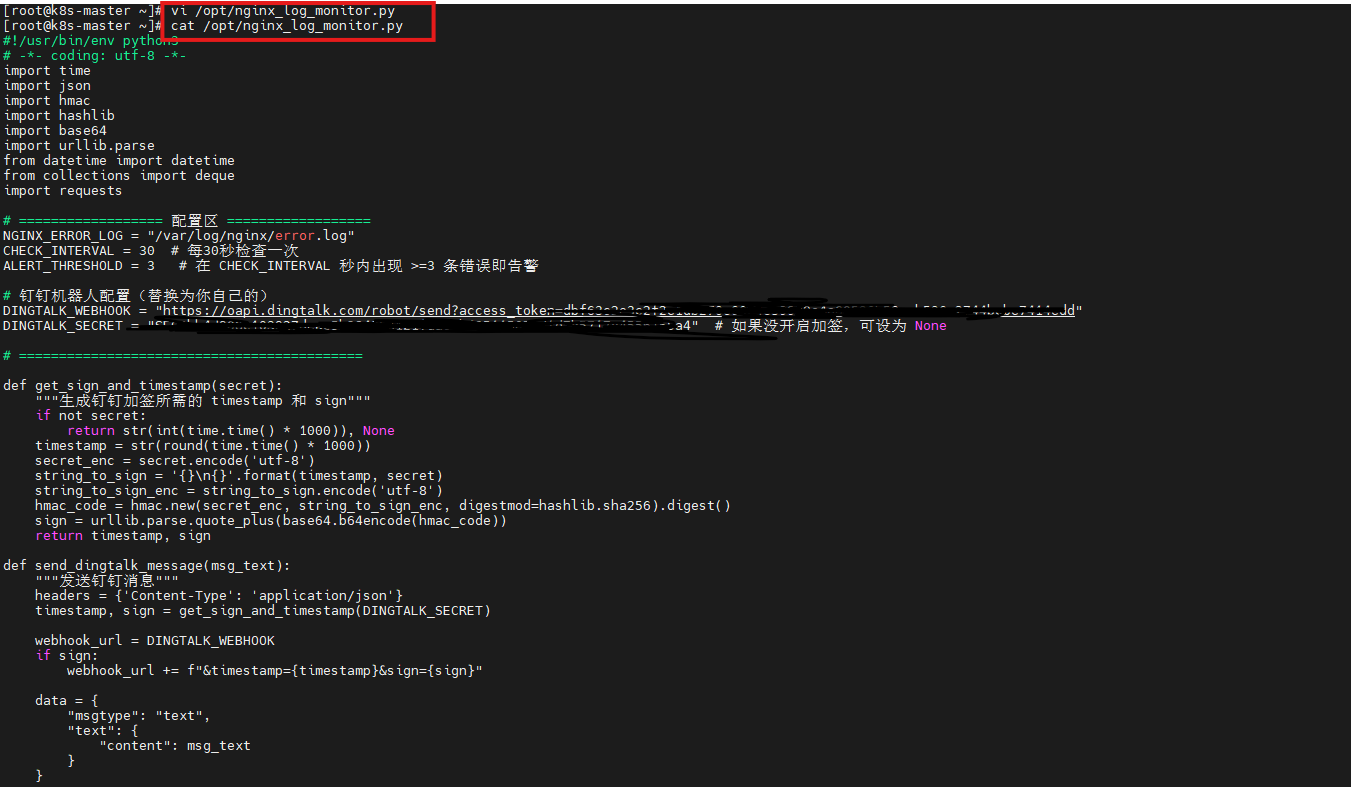
image-20260526162505749
6. 脚本怎么判断异常
脚本监听:
/var/log/nginx/error.log
启动后先执行:
f.seek(0, 2)
也就是跳到日志末尾,主要处理随后新增的日志,而不是重新扫描整个历史文件。
判断异常分两层。
错误级别
包括:
[error][crit][alert][emerg]
错误关键词
包括:
faileddeniednot foundno such fileconnection refusedtimeoutpermission deniedupstream prematurely closedbroken pipe
所以它的本质是:
错误级别 + 关键词规则匹配。
不是“理解”日志语义,但规则简单、可控,也方便继续补关键词。
7. 10 秒 + 阈值 2 实际怎么工作
配置里是:
CHECK_INTERVAL = 10ALERT_THRESHOLD = 2
但代码还有一个关键细节:
某个检查周期没有达到阈值时,error_count 不会清零,而是继续累积。
只有真正发出告警后才会:
error_count = 0recent_errors.clear()
所以更准确的行为是:
每 10 秒检查一次累计错误数;没有达到 2 就继续累积,达到 2 后发送告警并清零。
它并不是严格意义上的“每个独立 10 秒窗口内出现 2 条才报警”。
8. 加签先放到基础通知跑通之后
代码已经保留了:
get_sign_and_timestamp()
以及 DINGTALK_SECRET。
第一次更适合先保持:
DINGTALK_SECRET = None
确认基础 Webhook 能发消息。
如果以后启用 secret 后出现发送失败,再重点检查生成的请求 URL 和钉钉加签参数。
9. 给脚本执行权限并测试
赋权:
chmod +x /opt/nginx_log_monitor.py直接运行:
python3 /opt/nginx_log_monitor.py
image-20260527112354960
启动以后,脚本会等待新的日志内容。
10. 手工追加两条错误日志
另开一个终端,追加两条测试错误:
echo '2026/05/27 11:20:01 [error] 123#0: *1 open() "/xxx" failed (2: No such file or directory)' | sudo tee -a /var/log/nginx/error.log
echo '2026/05/27 11:20:02 [error] 123#0: *2 connect() failed (111: Connection refused)' | sudo tee -a /var/log/nginx/error.log
image-20260527112456270
第一条模拟文件不存在,第二条模拟连接被拒绝。
脚本能够检测到新增错误。
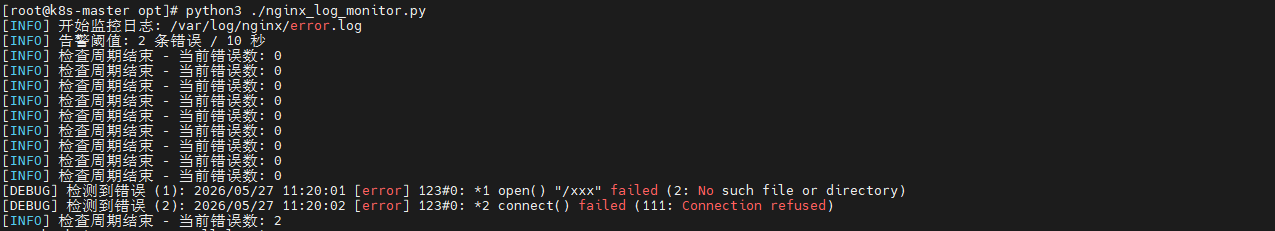
image-20260527112529690
达到阈值 2 后发送钉钉告警。
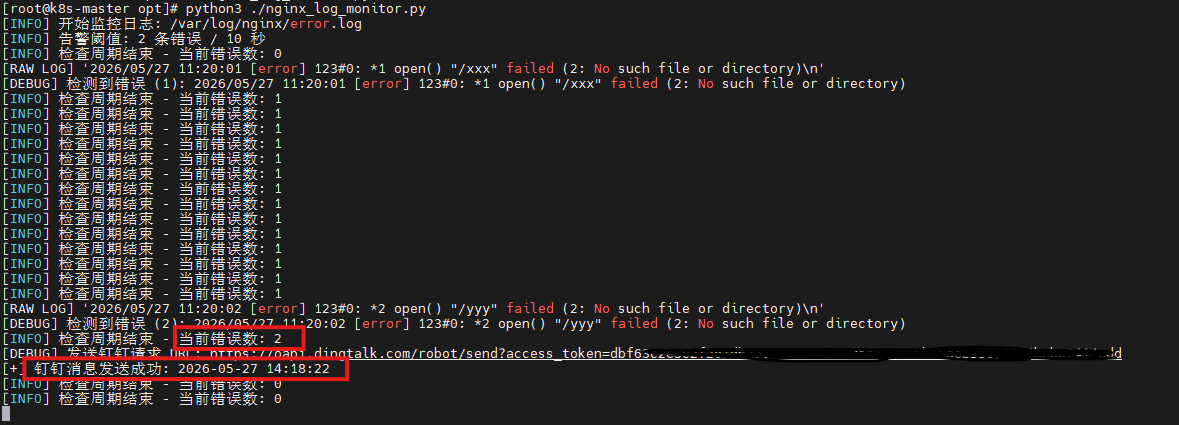
image-20260527141921487
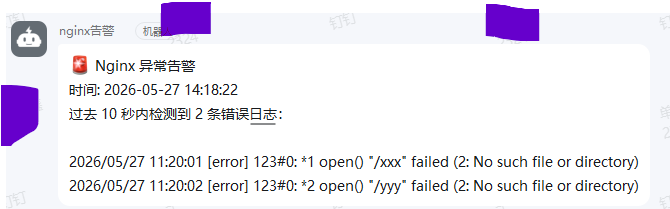
image-20260527142138915
做到这里,真正打通的是:
Nginx error.log → Python 规则匹配 → 阈值判断 → 钉钉 Webhook。
11. 交给 systemd 后台运行
如果每次都要手动执行:
python3 /opt/nginx_log_monitor.py
还不算长期监控。
创建 systemd 服务:
sudo tee /etc/systemd/system/nginx-dingtalk-monitor.service <<EOF
[Unit]
Description=Nginx Error Log Monitor with DingTalk Alert
After=network.target nginx.service

[Service]
Type=simple
User=root
ExecStart=/usr/bin/python3 /opt/nginx_log_monitor.py
Restart=always
RestartSec=10

[Install]
WantedBy=multi-user.target
EOF
服务名是:
nginx-dingtalk-monitor.service
关键配置包括:
User=rootExecStart=/usr/bin/python3 /opt/nginx_log_monitor.pyRestart=alwaysRestartSec=10
启用并启动:
sudo systemctl daemon-reload
sudo systemctl enable nginx-dingtalk-monitor
sudo systemctl start nginx-dingtalk-monitor
查看状态:
sudo systemctl status nginx-dingtalk-monitor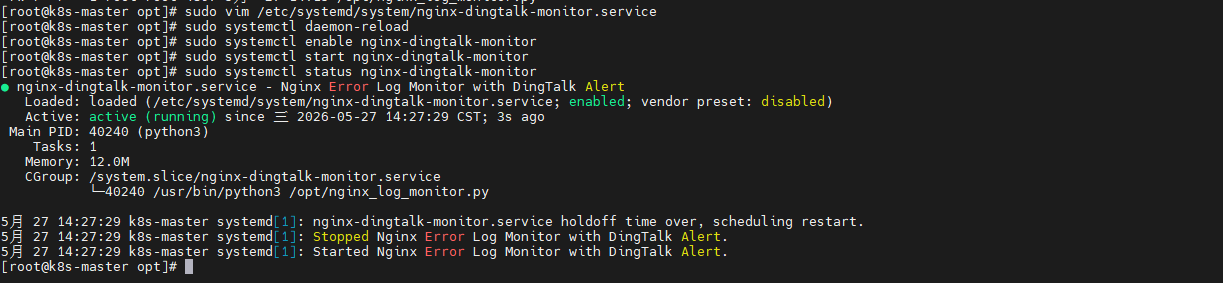
image-20260527142744945
这样脚本就可以作为后台服务持续运行。
12. systemd 运行时重点检查三处
如果手动运行正常、systemd 却起不来,我会先核对三件事。
脚本路径:
/opt/nginx_log_monitor.py
Python 路径:
/usr/bin/python3
日志权限:
服务以 root 运行,需要能够读取:
/var/log/nginx/error.log
路径、解释器、权限三层只要有一层不一致,都可能导致服务启动失败。
13. cpolar 不是告警组件,而是远程处理入口
到这里,日志监控和钉钉告警已经可以独立工作。
后面的 cpolar 不是为了“让告警生效”,而是为了:
收到告警后,人不在局域网也能 SSH 回服务器继续处理。
职责可以拆成:
- Python + systemd:发现问题
- 钉钉机器人:通知问题
- cpolar:提供远程 SSH 运维入口
14. 安装 cpolar
执行:
sudo curl https://get.cpolar.sh | sh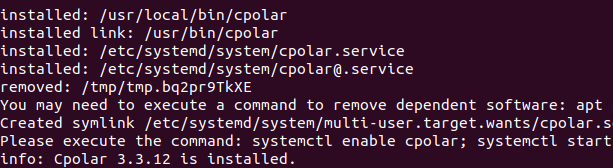
image-20250725104019896
检查服务:
sudo systemctl status cpolar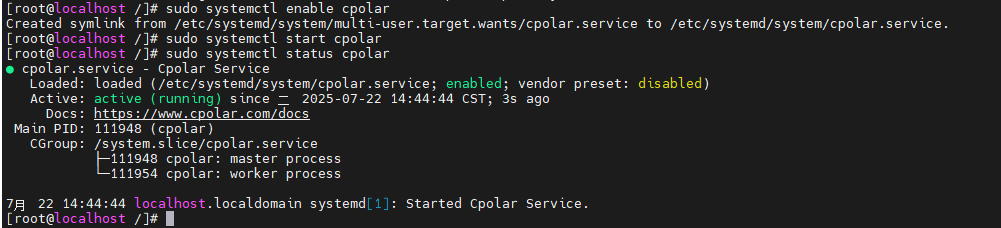
22e5adfaf290a17fc3384bb296055259
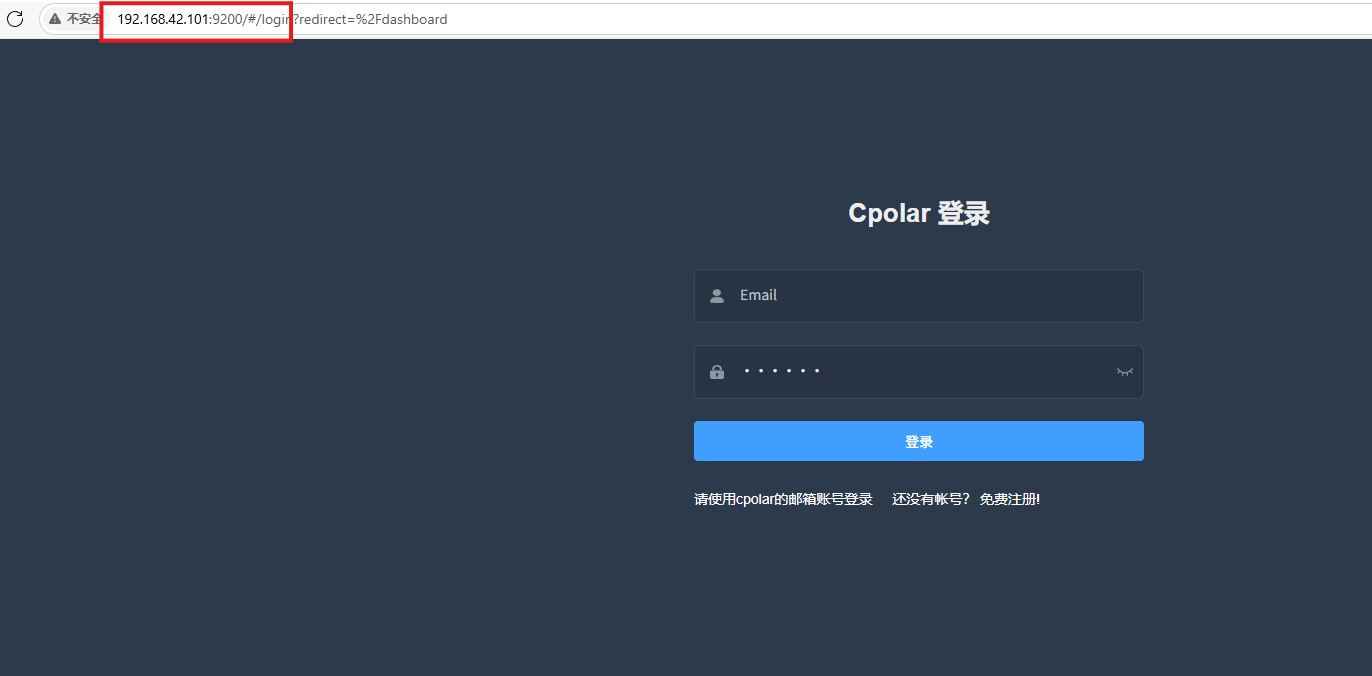
服务正常以后,通过主机 IP + 9200 进入 cpolar Web UI。
页面入口写成:
http://ip:9200
实际超链接目标为:
http://localhost:9200/
8a6698b1bf26d64ba3645827fbfb1c29
15. 先创建随机 SSH 公网地址
创建隧道时使用:
- 隧道名称:
ssh - 协议:
tcp - 本地地址:
22 - 端口类型:随机临时 TCP 端口
- 地区:
China Top
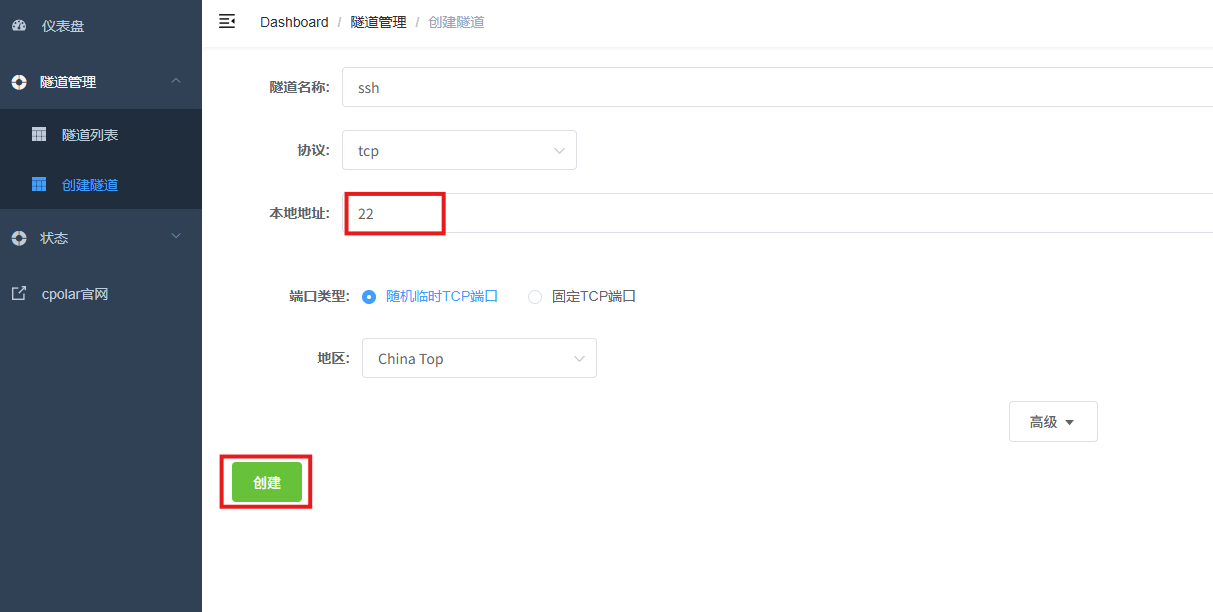
image-20260509153640177
创建以后查看在线隧道列表。
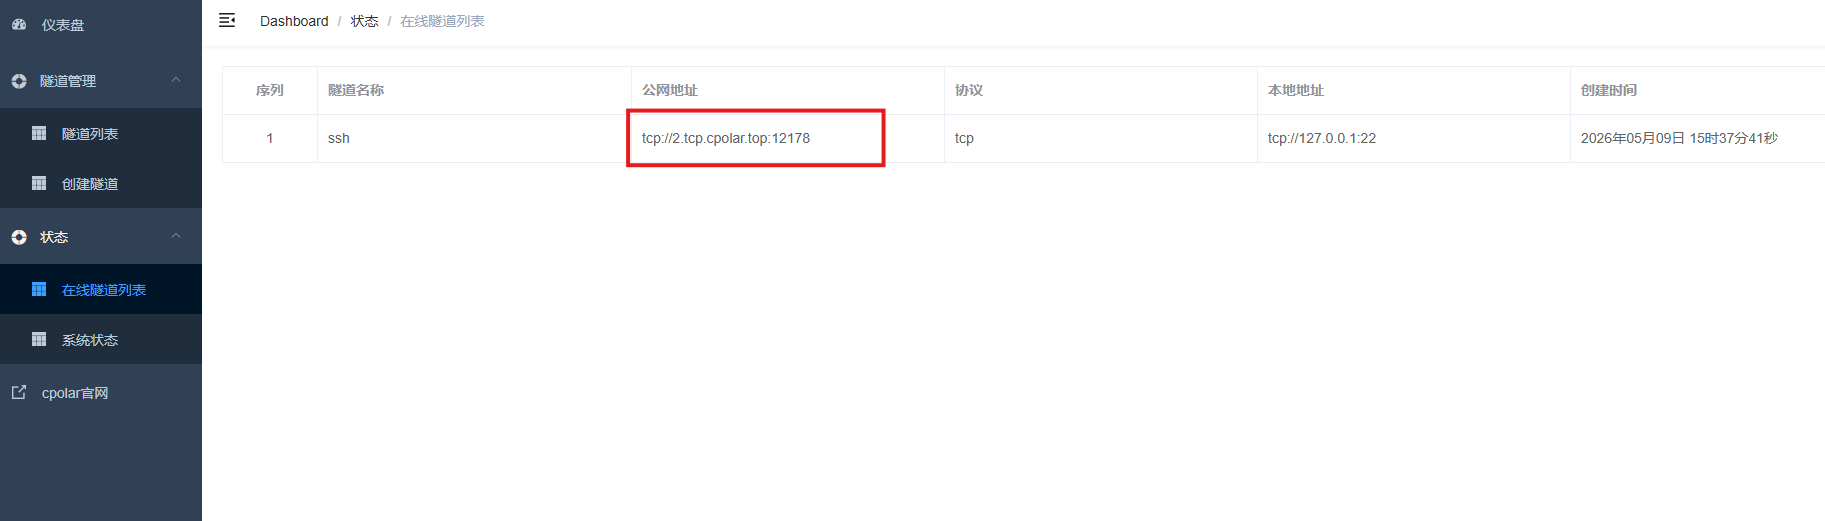
image-20260509153758249
随机示例地址:
- 域名:
2.tcp.cpolar.top - 端口:
12178
远程连接:
ssh -p 12178 root@2.tcp.cpolar.top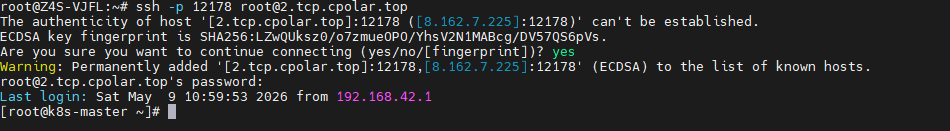
image-20260509155111600
这一层验证的是:
外部终端 → cpolar TCP → SSH 22 → CentOS 7。
16. 长期运维再配置固定 TCP 地址
随机 TCP 适合先确认链路。
如果服务器需要长期远程维护,再配置固定 TCP 地址。
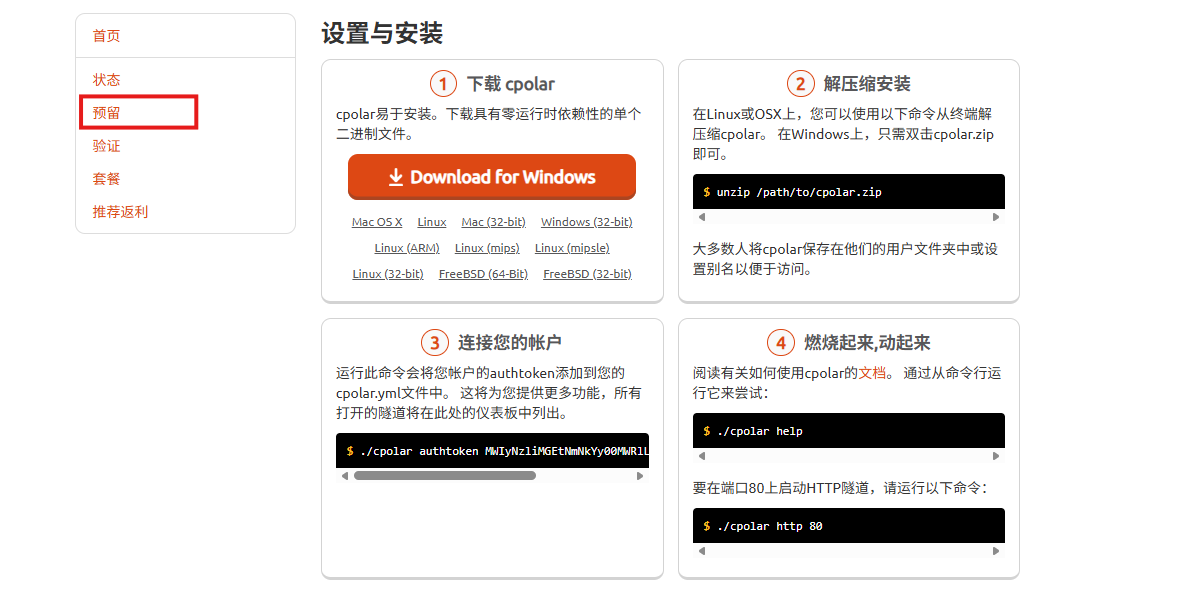
image-20251210160529622
页面里出现两种地区信息:
- 下拉选择:
China VIP - 已保留记录:
China Top
固定地址示例:
16.tcp.cpolar.top:14775
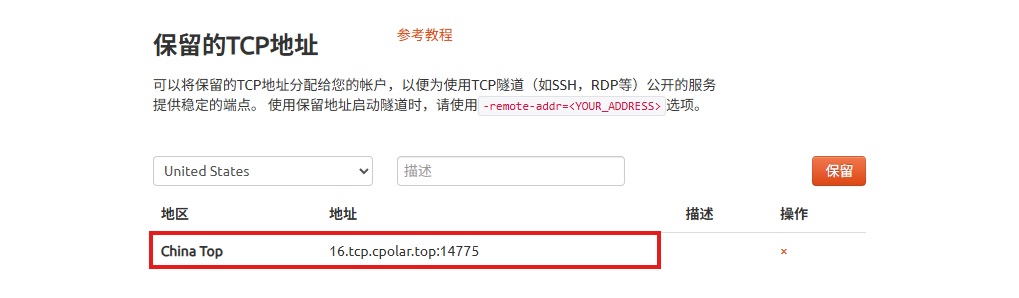
image-20260509155255401
实际配置时,以自己账号真正保留成功的区域和地址为准。
17. 把固定 TCP 地址绑定回 ssh 隧道
进入:
隧道管理 → 隧道列表
找到 ssh 隧道。
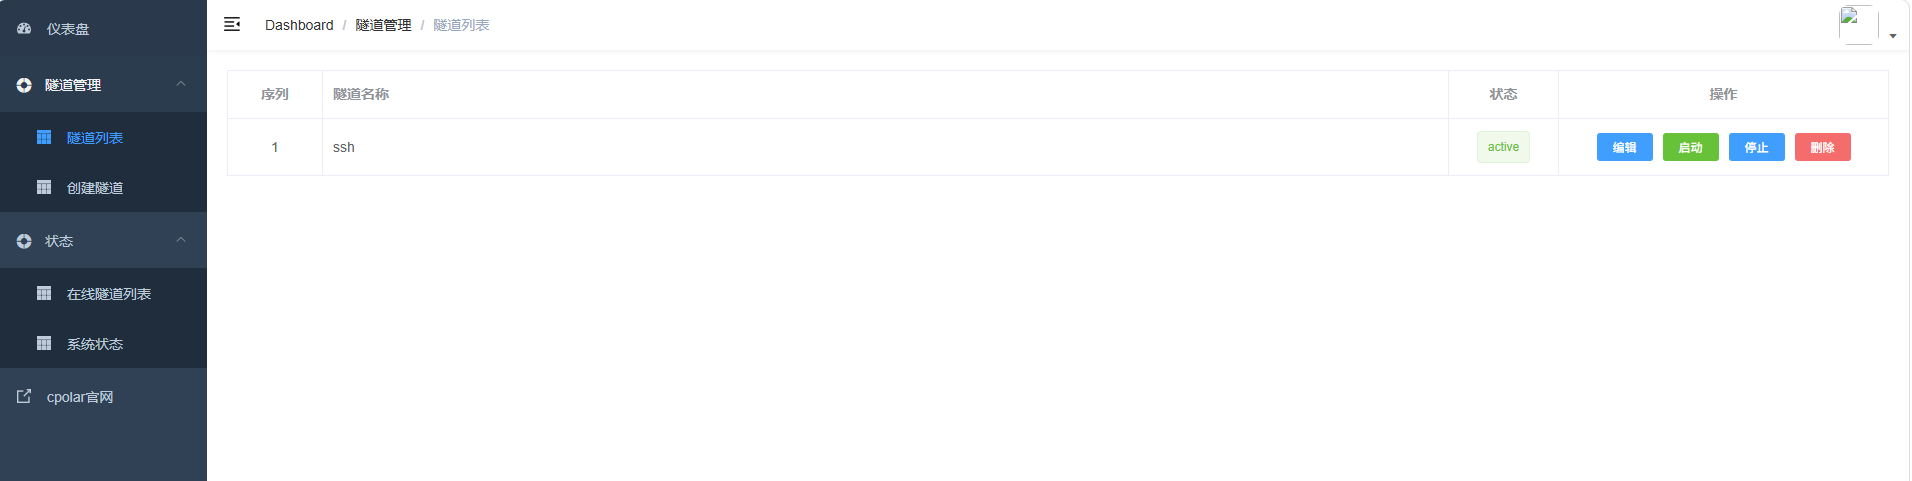
image-20260509155316176
修改:
- 端口类型:固定 TCP 端口
- 预留的 TCP 地址:填写前面保留成功的地址
点击更新。
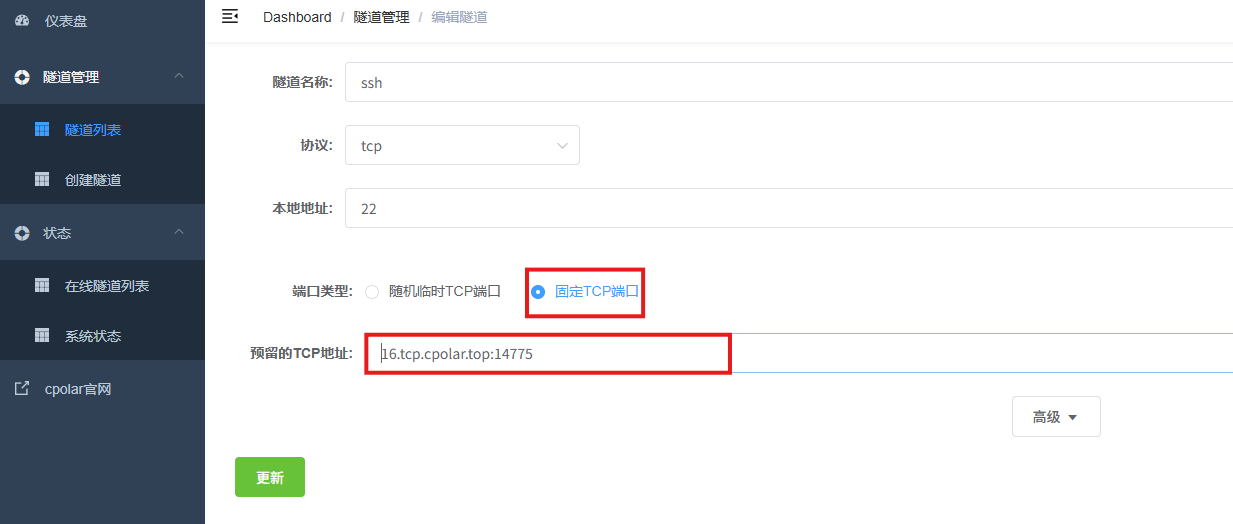
image-20260509155401559
更新以后查看在线隧道列表。
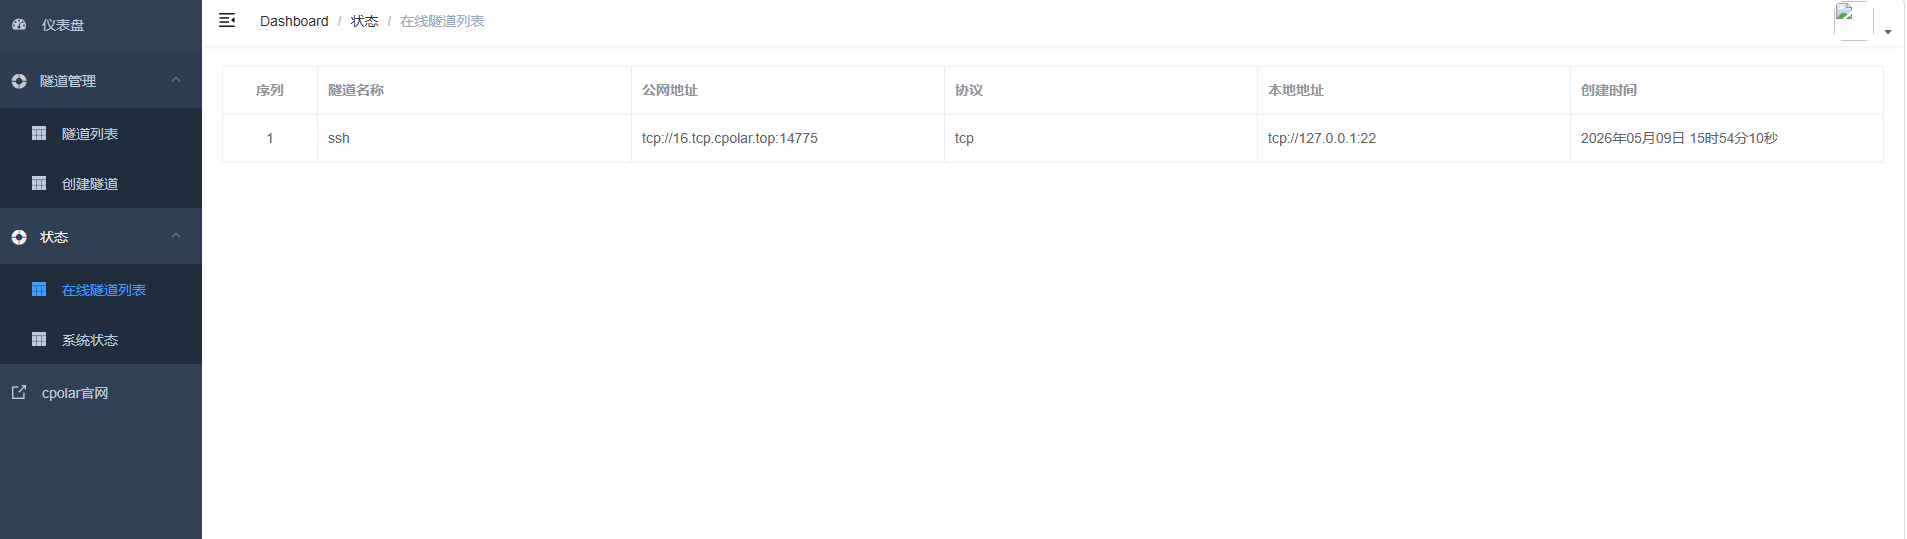
image-20260509155418632
随机 TCP 地址已经替换成固定 TCP 地址。
18. 这套脚本适合解决什么
如果目标只是:
不要等用户反馈以后才知道 Nginx 出错。
这套轻量脚本已经很实用。
它适合:
- 个人网站;
- 家庭服务器;
- 小规模 Web 服务;
- 希望快速增加日志告警的环境。
但它不是完整监控平台。
它目前没有指标时序存储、告警恢复通知、多主机集中管理、长期趋势和复杂事件关联。
所以我会把它定位成:
一只轻量日志哨兵。
先解决“错误发生了没人知道”,再决定是否有必要继续接更完整的监控体系。
总结
整条链路可以压缩成:
CentOS 7 → Python 3 → Nginx error.log → 错误级别 / 关键词 → CHECK_INTERVAL=10 → ALERT_THRESHOLD=2 → 钉钉 Webhook → systemd nginx-dingtalk-monitor → cpolar → SSH 22 → 随机 TCP → 固定 TCP 地址。
真正需要留心的是两条边界:第一,这段脚本是规则匹配,不是“智能理解日志”;第二,cpolar 只负责收到告警后的远程运维入口,不参与 Nginx 日志识别和钉钉通知。把发现、通知、处理三层分开以后,这套方案反而更容易维护,也更方便继续扩展。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-09-24,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号