DolphinDB 多协议接入实战:从 MQTT、Modbus 到统一测点流
原创
DolphinDB 多协议接入实战:从 MQTT、Modbus 到统一测点流
原创
Xxtaoaooo
发布于 2026-09-28 00:18:21
发布于 2026-09-28 00:18:21
摘要
搭工业 IoT 平台,大家的注意力都在后半程:存储怎么分区、流计算怎么调优、告警怎么治理。但每个平台真正的第一道坎在前半程——设备数据怎么进来。
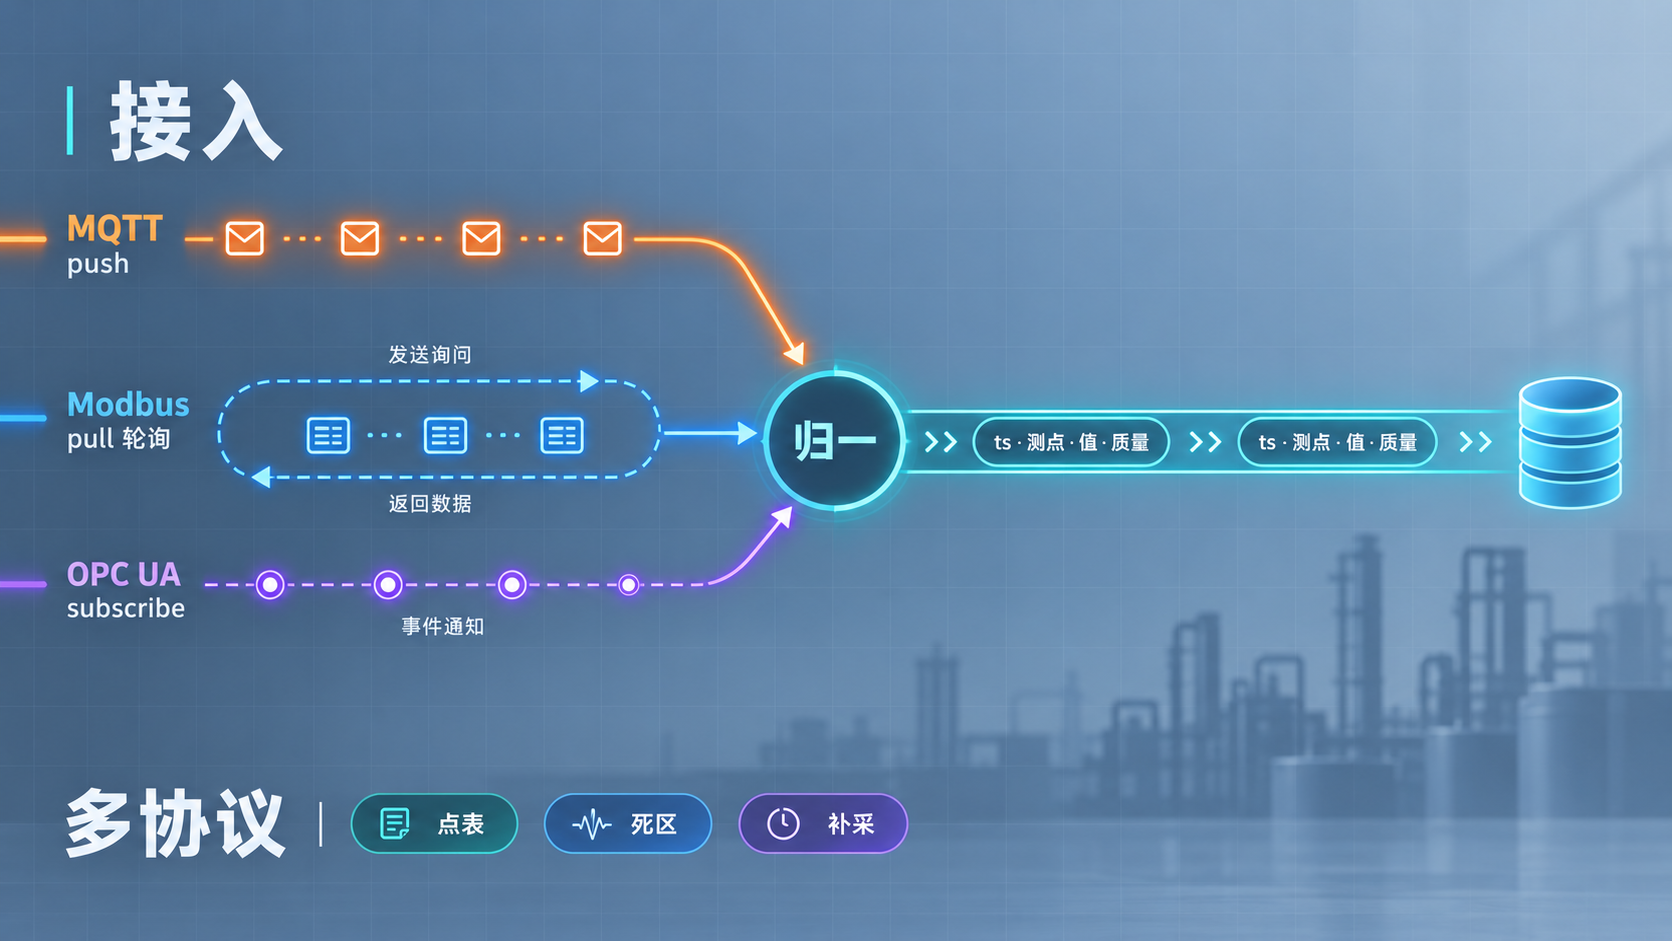
现实是:新上一批设备,三家厂商三种协议。A 家走 MQTT,主动往主题上推 JSON;B 家是老 PLC,只给 Modbus,你得按寄存器地址轮询;C 家上了 OPC UA,能订阅但节点命名一套一套的。把三种协议"接上"不难,难的是"接好"——时间戳谁打、值怎么换算、坏数据怎么标、断线了怎么补,这些第一公里的脏活,决定后面所有分析的上限。
本文把接入层拆开讲:三类协议的采集语义差异、点表作为接入的元数据中心、统一汇聚流表的设计(含质量位)、死区上报策略、工程量转换放在哪一层做、断线补采的语义。核心思路一句话:协议差异在汇聚层归一成"时间戳 + 测点 + 值 + 质量"四元组,转换和清洗全部入库后做,采集端只做尽量少的事。
一、三类协议,三种采集语义
先把三类主流协议的"脾气"摸清。它们不只是报文格式不同,采集语义完全不同——谁来发起通信、数据长什么样、带不带类型和时间戳,全都不同。
1.1 MQTT:push 型消息
MQTT 是发布/订阅模型:设备(或网关)作为客户端,把数据主动推到 broker 的主题上,平台订阅主题收数据。
- 通信由设备侧发起,平台被动收
- 数据形态是消息:payload 通常是 JSON 或二进制,测点名和值都藏在 payload 里,需要按约定解析
- 没有时间戳语义(除非 payload 里自己带)——不带的话只能用到达时刻,而到达时刻经过网络和 broker 排队,已经不等于采集时刻
- 没有质量语义,设备掉了就是消息断了,靠"多久没收到"来感知
1.2 Modbus:pull 型轮询
Modbus 是主从模型:平台(主站)按寄存器地址主动问,设备(从站)回答寄存器里的 16 位整数。
- 通信由平台侧发起,你不去问,它永远不说
- 数据形态是寄存器:一个地址对应一个 16 位原始值,没有测点名、没有单位、没有小数点——4201 可能是 42.01°C,系数是你和设备厂商约定的事
- 没有时间戳——轮询发出的时刻就是你能拿到的最好时间戳
- 没有质量语义,读失败(超时/异常码)就是这次轮询空手而归
- 轮询周期决定数据密度和链路负载的平衡:问得太勤链路忙,问得太疏丢变化
1.3 OPC UA:带模型的订阅
OPC UA 比 Modbus"重"得多:设备暴露一个地址空间,每个测点是有类型的节点(节点 ID + 数据类型 + 工程单位),支持订阅监视,值变化时主动通知。
- 通信可以订阅(变化推送)也可以轮询
- 数据形态是类型化节点:值自带类型,节点自带工程单位,语义相对完整
- 自带时间戳和质量位——服务端时间戳、源端时间戳、StatusCode 是协议内建的,这是它相对前两者的突出优势
- 代价是重:地址空间浏览、会话管理、证书配置,接入成本高
1.4 归一:四元组
三类协议的差异再大,进数据库前都应该归一到同一个形状:
时间戳 ts + 设备/测点 deviceId+metric + 值 value + 质量位 quality- MQTT 消息解析出测点和值,时间戳取 payload 内嵌的(有就用),质量默认 good、断连时打 bad
- Modbus 轮询按点表把地址翻译成测点名,时间戳取轮询时刻,读失败补一条 bad 质量记录
- OPC UA 天然带全四元组,直接映射
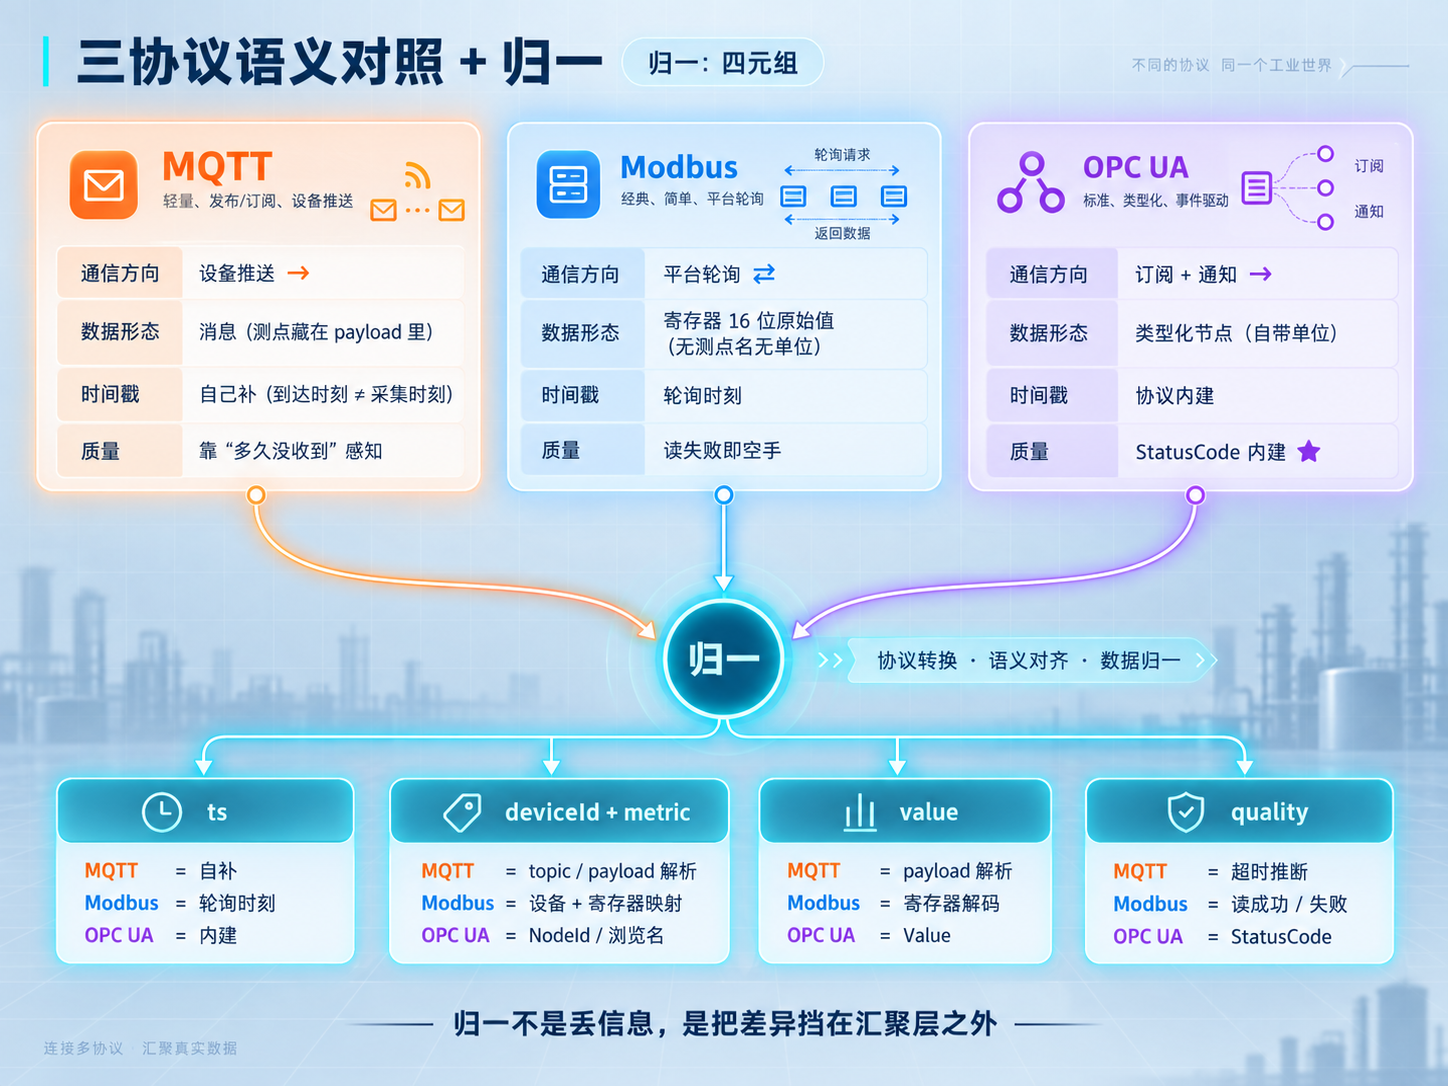
归一不是丢信息,是把差异挡在汇聚层之外——汇聚层之后的存储、计算、告警,面对的都是同一种数据,不必再关心它从哪条协议来。
二、点表:接入的元数据中心
2.1 点表是什么
点表(tag list / point registry)是一张清单:每个测点一行,记录它从哪来、怎么读、怎么换算。对 Modbus 来说是地址翻译表,对 OPC UA 来说是节点映射表,对 MQTT 来说是 payload 字段映射表。
一张典型的点表:
// 点表:接入配置的单一事实来源
pointReg = table(1:0,
    `deviceId`metric`protocol`address`dataType`scale`offset`deadband`unit,
    [SYMBOL, SYMBOL, SYMBOL, SYMBOL, SYMBOL, DOUBLE, DOUBLE, DOUBLE, SYMBOL])

// 两行示例:
// (PUMP-007, bearingTemp, modbus, 40011, int16, 0.01, 0.0, 0.5, °C)
//   —— 40011 号保持寄存器,读到 4201,乘 0.01 得 42.01°C,变化小于 0.5 不上报
// (PUMP-007, vibRms, mqtt, factory/line3/pump007/vib, json, 1.0, 0.0, 0.0, mm/s)
//   —— MQTT 主题下的 JSON 字段,原值即工程量
2.2 点表驱动:加测点是改配置,不是改代码
点表的核心价值是把接入做成配置驱动:采集程序读点表干活——轮询哪些地址、解析哪些字段、怎么换算、死区多少。新增一个测点,加一行点表、重载配置,不需要改一行采集代码。
没有点表的接入,每个测点的地址、换算、上报逻辑都散落在代码和脚本里,三个月后没人说得清 40011 是什么——这是很多老平台接入层变成"黑盒"的开始。
2.3 点表落库:配置即数据
点表本身也存进数据库(设备档案维度表旁边),有三个好处:
- 配置变更有历史:哪天把 scale 从 0.01 改成 0.001,可追溯
- 查询时可 join:分析"这个测点的单位/换算参数",和查数据一样方便
- 多网关共享:点表是库里的表,所有采集网关从同一处读配置,不会各自维护一套
三、汇聚层:一个流表收口所有协议
3.1 统一接入流表
所有协议的数据,最终都写进同一个流表——这就是汇聚点:
// 统一接入流表:四元组 + 原始值
share streamTable(1:0,
    `ts`deviceId`metric`rawValue`quality,
    [DATETIME, SYMBOL, SYMBOL, DOUBLE, SYMBOL]) as ingestStream
两个设计要点:
- 存原始值(rawValue),不存换算后的值——换算放入库后(第五节展开)
- 质量位(quality)是一等公民,不是可选字段
3.2 质量位:坏数据要"带伤入库"
quality 通常取三个值:good(可信)、bad(采集失败/设备报错)、uncertain(超时边缘/转换可疑)。
关键纪律是:采集失败不要静默跳过,要写一条 bad 记录。比如 Modbus 读 40011 超时,写:
(10:00:05, PUMP-007, bearingTemp, NULL, bad)为什么带伤入库而不是不写?因为下游要区分两种情况:"温度确实是 42°C 没变"和"根本没采到"。如果失败就跳过,时间轴上两者都是"没有数据",死区上报和采集故障就没法区分了(第四节会看到这个区分多重要)。
OPC UA 天然带质量位直接映射;MQTT 和 Modbus 的质量位由采集端补——读失败打 bad,超过半个轮询周期没消息打 uncertain。
3.3 协议插件的分工
DolphinDB 提供 MQTT、OPC UA、Modbus 等协议插件,配合采集网关,职责分工是:
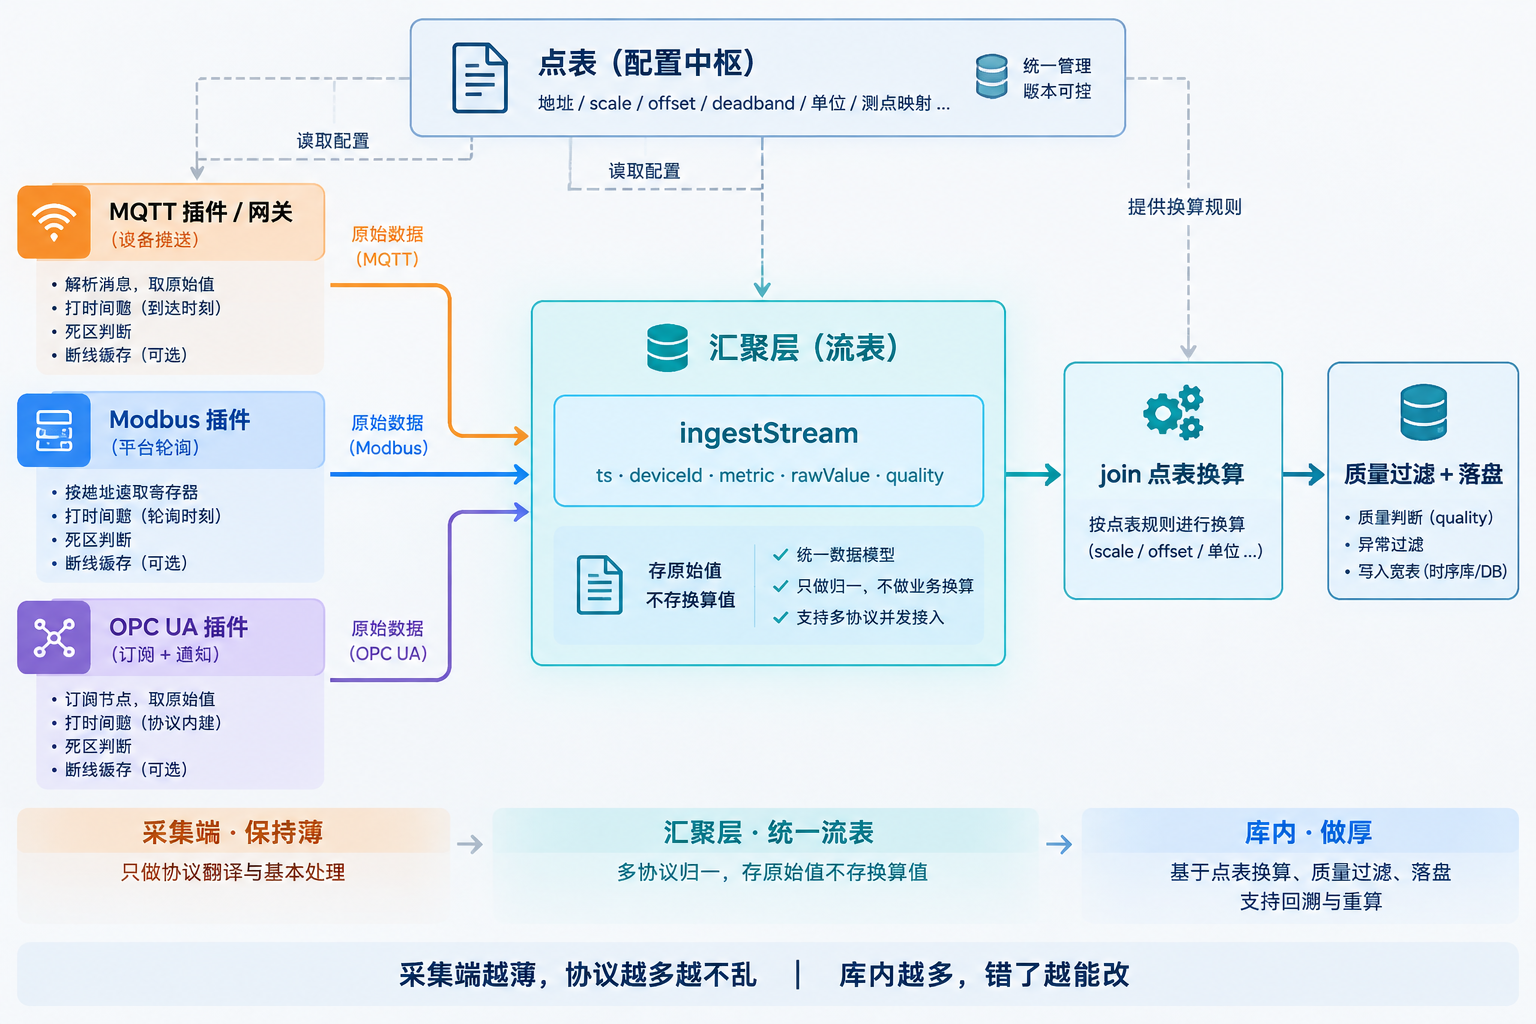
- 协议插架/网关:只管"把某个协议的数据搬进汇聚流表"——翻译协议,不做业务
- 汇聚流表之后:订阅做换算、清洗、落宽表——一切业务逻辑都在库内、都是 SQL
这个分工让"加一种新协议"的改动面收敛到换一个插件/网关,汇聚层之后的全部逻辑不动。反过来,如果把换算、过滤写死在采集代码里,每换协议都要把业务逻辑重写一遍。
四、死区:别把没变化的数据当价值
4.1 周期上报 vs 变化上报
温度这种慢变量,一小时可能只漂 2°C。如果按 1 秒周期上报,3600 条里 3590 条的信息量和前一条几乎相同——带宽、存储、写入压力全花在"没变化"上。
死区(deadband)是变化上报的判断:值相对上次上报的变化超过阈值才上报,否则不上报。点表里那列 deadband 就是它,按测点配置:
- 慢变量(温度、压力):给大死区,如 0.5
- 快变量(振动):死区给 0 或极小——振动本身就是波动的,死区会把信号吃掉
4.2 两种死区
- 固定死区(绝对值判断):
|value - lastSent| > deadband才上报。简单直观,适合量程稳定的测点 - 百分比死区(相对判断):变化超过量程的百分比才上报。适合不同设备量程差异大的测点(满量程 100 和满量程 1000 的传感器用同一个百分比)
死区判断在采集端执行(它省的是传输和存储,放在库里做就没意义了),但配置在点表里——集中管理,改死区不用动采集代码。
4.3 死区的下游语义:最后值保持
死区开了之后,时间轴变成稀疏的:值没变的时段没有数据。下游消费这份数据,语义必须是"最后值保持"(last value carry-forward)——10:00:03 报了 42.01,10:00:04~10:05 没数据,含义是"这期间一直是 42.01",而不是"这期间未知"。
在 DolphinDB 里这就是前向填充的语义:
// 死区后的稀疏序列 → 按设备+测点前向填充成连续序列
select deviceId, metric, ts, ffill(rawValue) as value
from ingestTable
context by deviceId, metric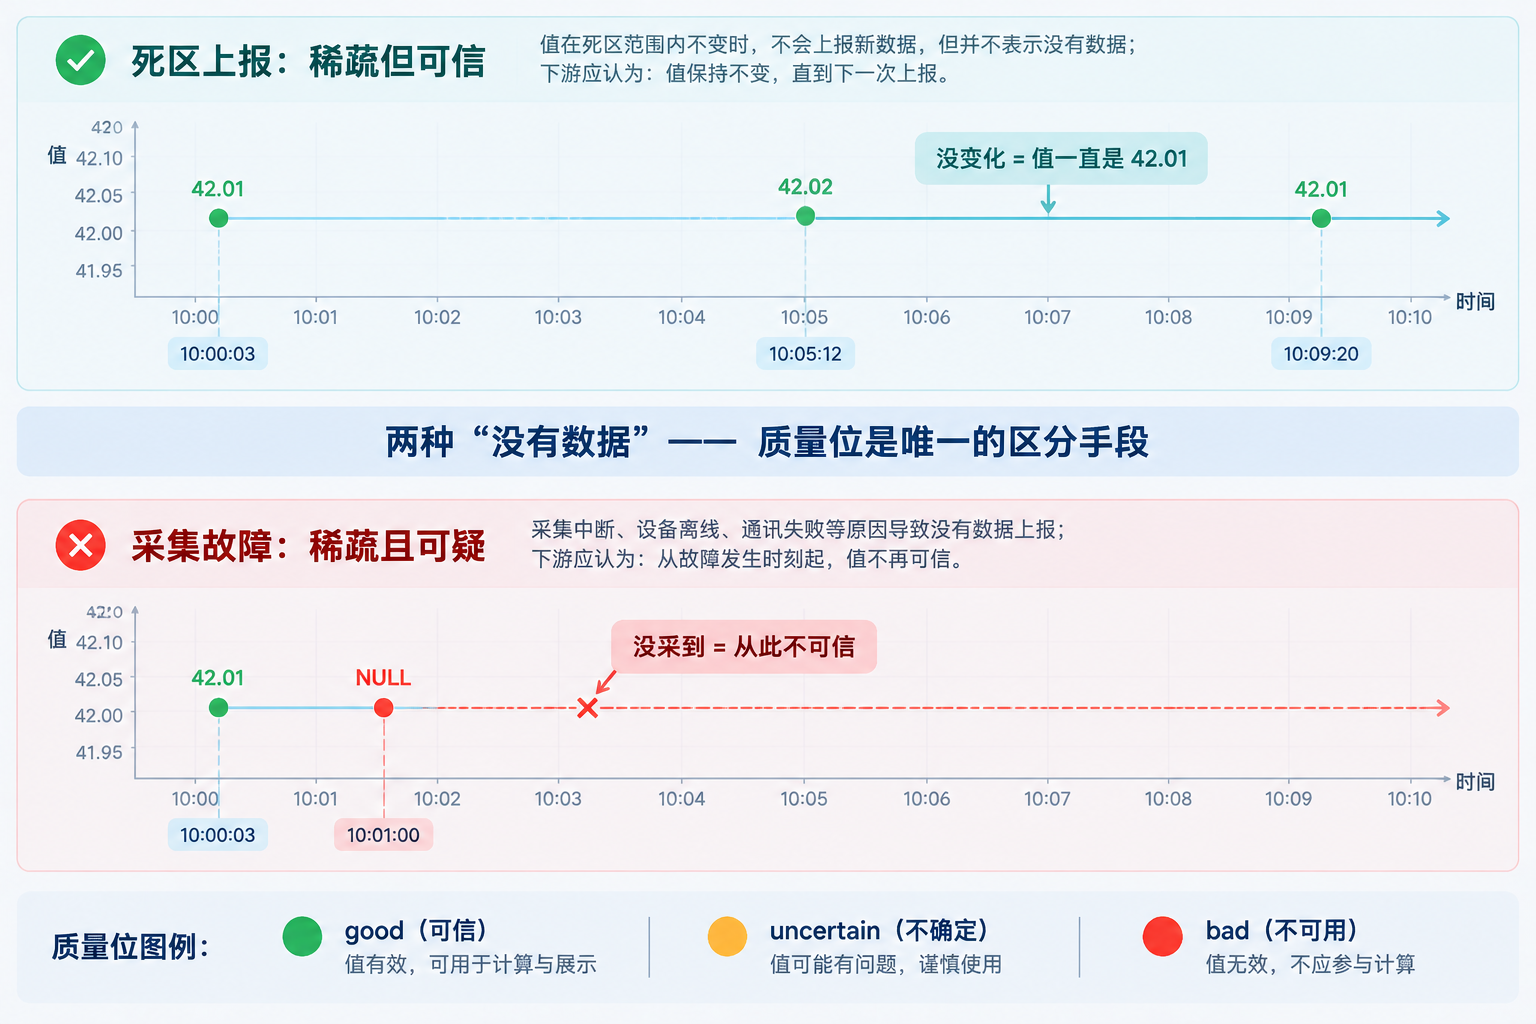
这里能看出质量位的价值:如果 10:00:03 之后有一条 bad 记录(采集故障),前向填充该停在 bad 处——"没变化所以没报"和"设备坏了没采到"是两种完全不同的"没有数据",质量位就是用来区分它们的。
五、工程量转换:在哪儿做
5.1 原始值 → 工程量
Modbus 读回来的 4201 不是温度,是"待解释的数"。解释规则通常很简单:线性换算(乘系数加偏移),参数就在点表的 scale 和 offset 列里:
工程量 = rawValue × scale + offset
4201 × 0.01 + 0 = 42.01 °C
5.2 为什么入库后做,而不是采集端做
这是接入层一个方向性的决策。三种做法里——采集端换算、网关换算、入库后换算——入库后做是工程上稳健的一种:
- 可重算:换算参数错了(厂商把系数发错是常事),改点表的 scale,重算一遍历史就修正了。采集端换算的话,历史里存的已经是错的工程量,原始信息丢了
- 可审计:库里同时有 rawValue 和换算参数,任何人都能验证 42.01 是怎么来的
- 采集端保持薄:采集程序只搬数不解释,换逻辑不用动采集链路
代价是存储上多存一份原始值(宽表落盘时通常只落换算后的工程量,rawValue 在汇聚流表里过路即可)。
5.3 转换作为流式 SQL
汇聚流表订阅里做换算,一行 SQL 的事:
// 入库路径:汇聚流表 → join 点表取换算参数 → 换算 + 质量过滤 → 落盘
converted = select
    i.ts, i.deviceId, i.metric,
    i.rawValue * p.scale + p.offset    as value,
    i.quality
from ingestTable as i
inner join pointReg as p
        on i.deviceId = p.deviceId and i.metric = p.metric
where i.quality = `good换算参数改动时,这条路径自动跟着点表生效——改配置即改行为,不用重新部署任何东西。
六、断线与补采
6.1 断档的三种处理姿势
采集链路断网(车间到机房的光纤被挖断是真实场景)时,有三种姿势:
- 不处理:断档就是空白。下游若把空白当"值没变",会把故障静默成平稳——最差的一种
- 打标记:断档期间按测点写 bad 记录(或断档检测任务事后补标记),下游明确知道"这段时间不可信"
- 网关缓存 + 回灌补采:网关本地缓存断线期间的数据,链路恢复后按原始时间戳回灌
第一种不该选。后两种按场景组合:短断(分钟级)打标记就够;长断(小时级)且数据重要的测点,上网关缓存。
6.2 回灌的关键:时间戳用采集时刻
补采回灌容易犯的错:数据恢复后一次性写入,时间戳用了写入时刻——一段历史数据挤在恢复后的一秒钟里,时序完全失真。
正确做法是网关在采集时就打好时间戳,缓存的就是带时间戳的记录,回灌时原样写入汇聚流表:
断线 10:00 ~ 11:00,网关缓存了 3600 条(各带自己的采集时间戳)
11:00 链路恢复,回灌 → 库里 10:00~11:00 的数据按真实节拍落位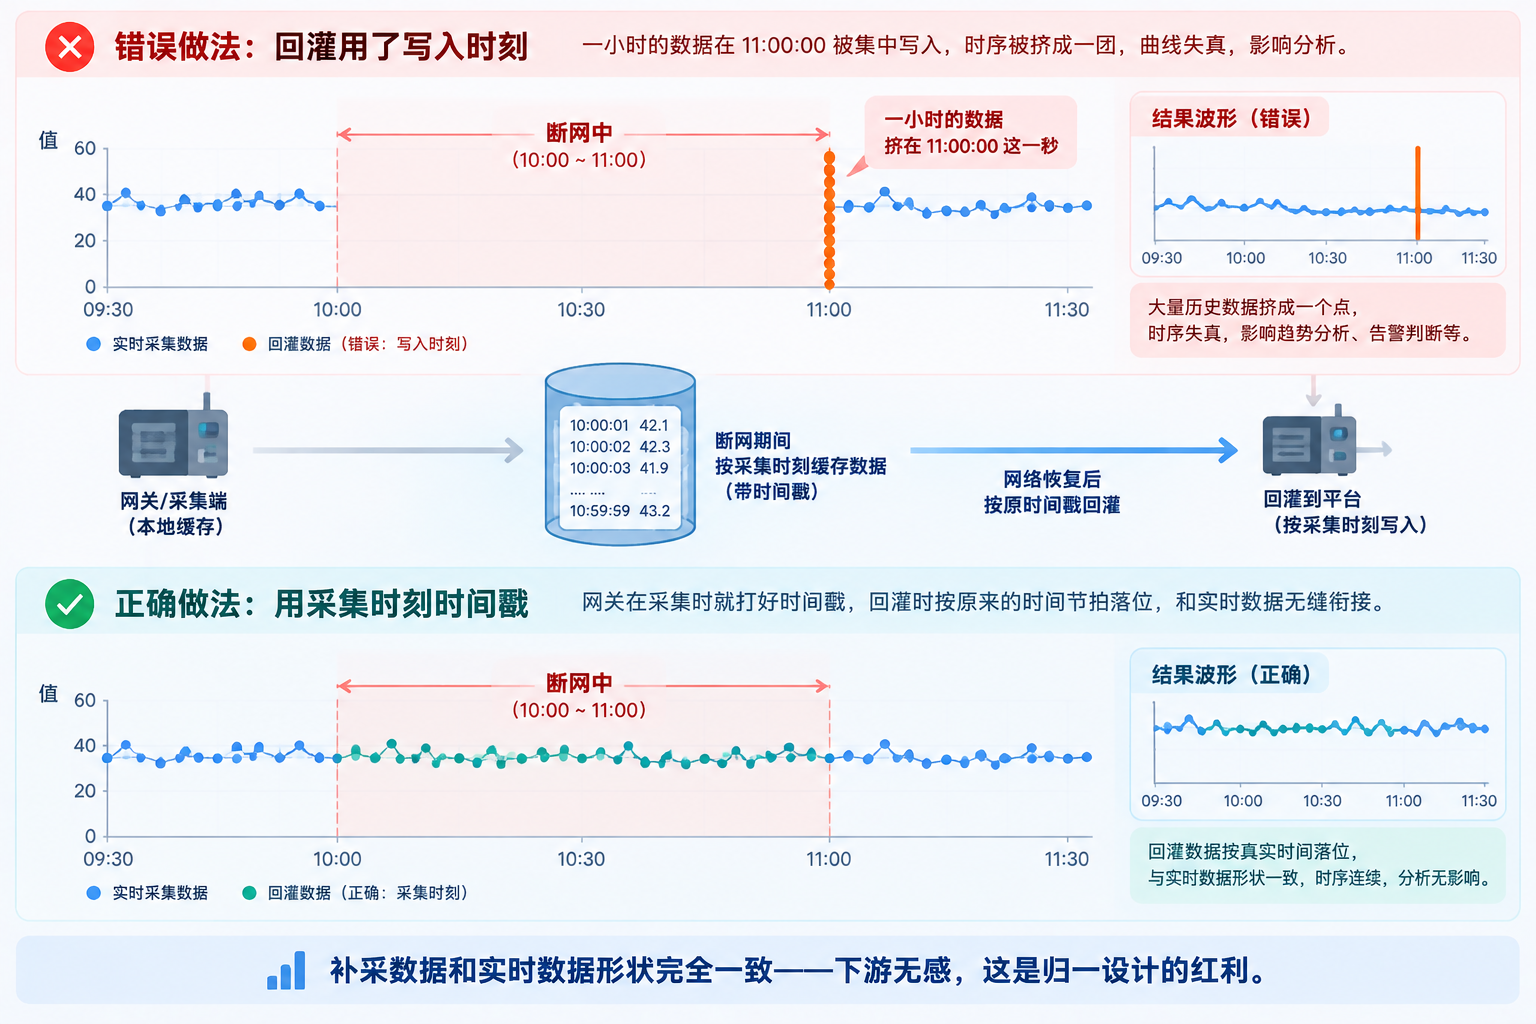
回灌期间要注意流表消费端的吞吐余量:一小时的数据几秒内涌入,下游换算、落盘的订阅要扛得住瞬时高峰(这也是接入层做容量规划时容易漏算的一项)。
6.3 补采与死区的配合
死区在断线期间照常工作(网关本地判断),所以回灌的数据也是稀疏的变化序列,不会因为缓存就膨胀成全量。补采数据和实时数据在汇聚流表里形状完全一致——下游不需要任何特殊处理,这就是"归一"设计的红利。
七、写在最后
接入层是平台的第一公里,也是最容易做糊的一公里。把全文收成几条:
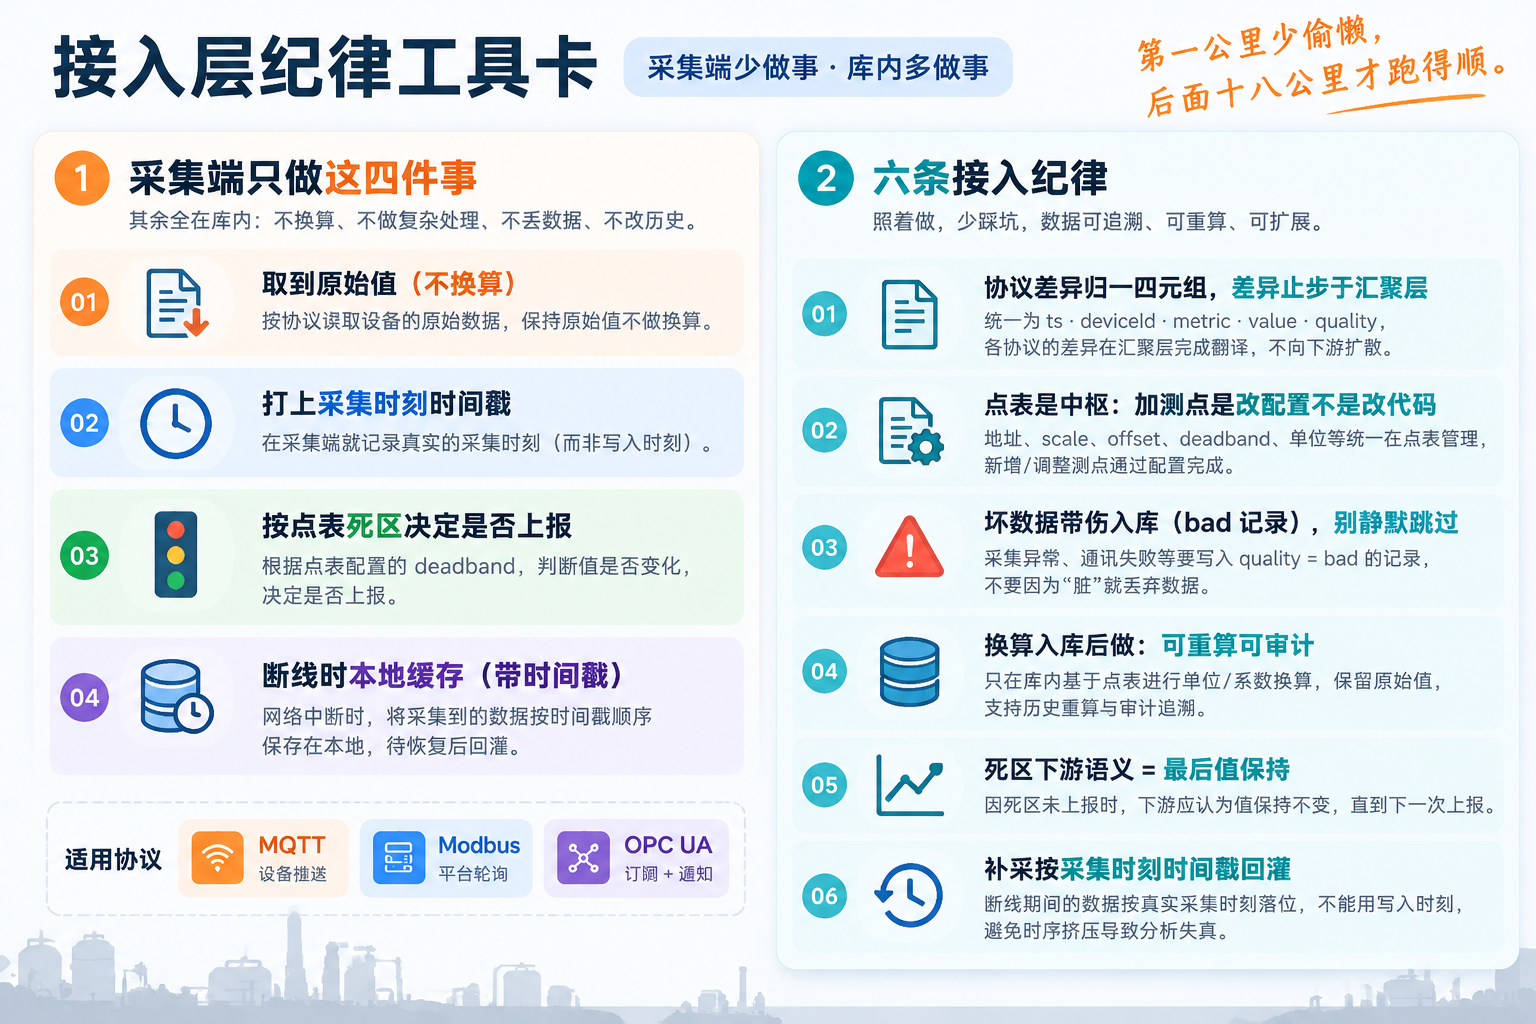
- 协议差异归一到四元组:时间戳 + 测点 + 值 + 质量。差异止步于汇聚层,后面的一切不再关心协议
- 点表是接入的中枢:地址、换算、死区、单位都在点表里,加测点是改配置不是改代码
- 质量位是一等公民:坏数据带伤入库,别静默跳过——"没变化"和"没采到"必须可区分
- 死区对付慢变量:配置在点表、执行在采集端、下游按最后值保持理解
- 换算入库后做:可重算、可审计,采集端保持薄
- 补采用采集时刻的时间戳回灌:和实时数据形状一致,下游无感
最后给一个总原则,也是本文反复出现的那句话的完整版:采集端只做四件事——取到原始值、打上采集时间戳、按死区决定是否上报、断线时本地缓存。其余一切(换算、清洗、对齐、落盘)都在库内用 SQL 做。采集端越薄,协议越多越不乱;库内越多,错了越能改。第一公里少偷懒,后面十八公里才跑得顺。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号