#WorkBuddy# 236 张图片,我用一条流水线跑完"压缩+摆正+去重+归档"
原创
#WorkBuddy# 236 张图片,我用一条流水线跑完"压缩+摆正+去重+归档"
原创
用户12784192
发布于 2026-09-28 07:58:03
发布于 2026-09-28 07:58:03
电脑里攒下来的图片目录,问题从来不是"大",而是"乱"。相机竖着拍的照片拷到电脑上打开是横的;聊天记录里转存出来的图,文件名是一长串哈希;同一个文件被反复转存四五次,白占硬盘;要做素材库时,一个目录动辄几百 MB,传网盘、发邮件都卡。
这一次我没有手动改,而是让 WorkBuddy 写了一条图片批处理流水线,在一份可复现的测试图集上把全流程真实跑通,并把每一个步骤的真实数字记录下来。为了不涉及任何私人素材,测试集是我用 numpy + Pillow 现场合成的 236 张图片(尺寸、EXIF 方向、拍摄时间、重复项全部可控),所以下面的数据你可以照着重跑一遍复现。
一、先体检,再动手:四个隐性坑
很多人上手就是一句"批量压缩",结果方向被压错了、拍摄日期丢了、重复文件还在。所以第一步不是压缩,而是只读体检。
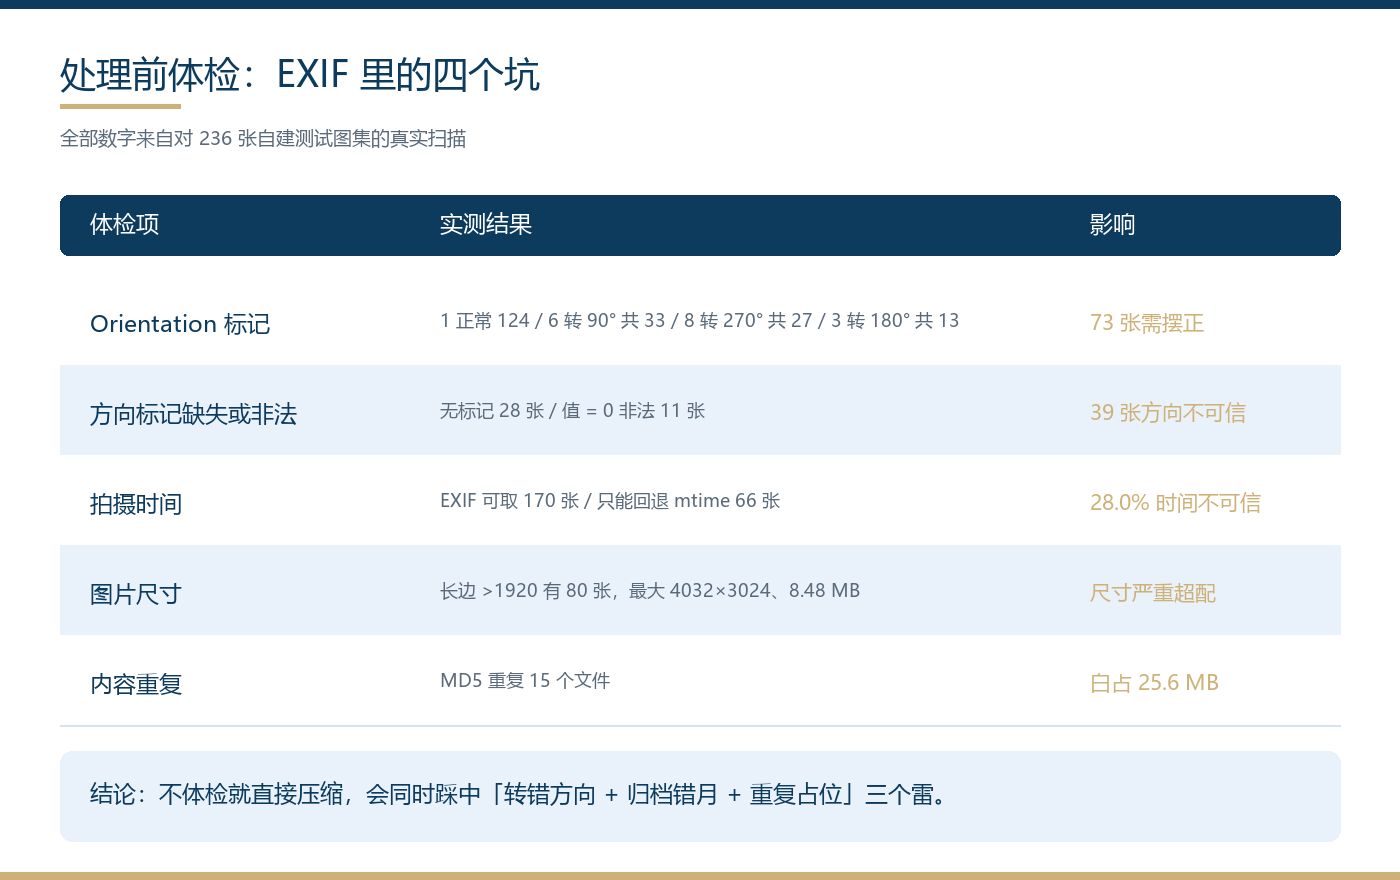
体检结论(全部数字来自对 236 张测试图的真实扫描):
体检项 | 实测结果 | 影响 |
|---|---|---|
文件规模 | 236 个图片文件,合计 435.0 MB / 718.4 万像素,0 个损坏 | — |
Orientation 标记 | 1 正常 124 张、6 需转 90° 共 33 张、8 需转 270° 共 27 张、3 需转 180° 共 13 张 | 73 张必须摆正 |
方向标记缺失或非法 | 无标记 28 张、值 = 0(非法值)11 张 | 39 张方向不可信 |
拍摄时间 | EXIF 可取到 170 张,其余 66 张只能回退文件 mtime | 28.0% 的时间不可信 |
图片尺寸 | 长边 >1920 的有 80 张,最大单张 4032×3024、8.48 MB | 尺寸严重超配 |
内容重复 | MD5 完全重复 15 个文件 | 白占 25.6 MB |
设备标记 | CAM-A 83 / CAM-B 82 / CAM-C 70 | 多来源混片,元数据口径不一 |
根因分析,三条:
- Orientation 是"约定"而不是"数据"。 手机竖着拍时 CMOS 仍然是横着曝光的,照片就以横向像素存盘,只在 EXIF 里写一个
Orientation告诉看图软件"显示时转一下"。这正是坑的源头:像素本身没转,只有标记在转。于是 Windows 资源管理器、部分国产修图工具、旧版 PPT 不读这个标记——你看到的就是横的。更麻烦的是Orientation = 0(11 张),这是非法值,不同软件对它的处理各不相同。 DateTimeOriginal可能藏在两处。 真实相机把它写在 Exif SubIFD(0x8769)里,而 Pillow 和不少工具会写进 IFD0。只查一处,就会把 170 张照片的拍摄时间全部退化成"文件复制时间"。这是本次最隐蔽的一个坑。- "转存"等于复制而不是引用。 同一张图反复转存会出现
(1)、(2)、(3)后缀,md5 完全相同。这类冗余判断不了大小,只能靠内容哈希。
还有一个非技术坑特别值得说: 66 张取不到 EXIF 时间的图,回退到文件 mtime 之后,全部落进了"今天"这个月份——归档结果里凭空多出一个 2026-09 目录,装了 61 张本该在几个月前的照片。拿到体检报告才知道:回退策略必须和"来源标记"一起输出,否则归档会悄悄错月。
二、六步流水线
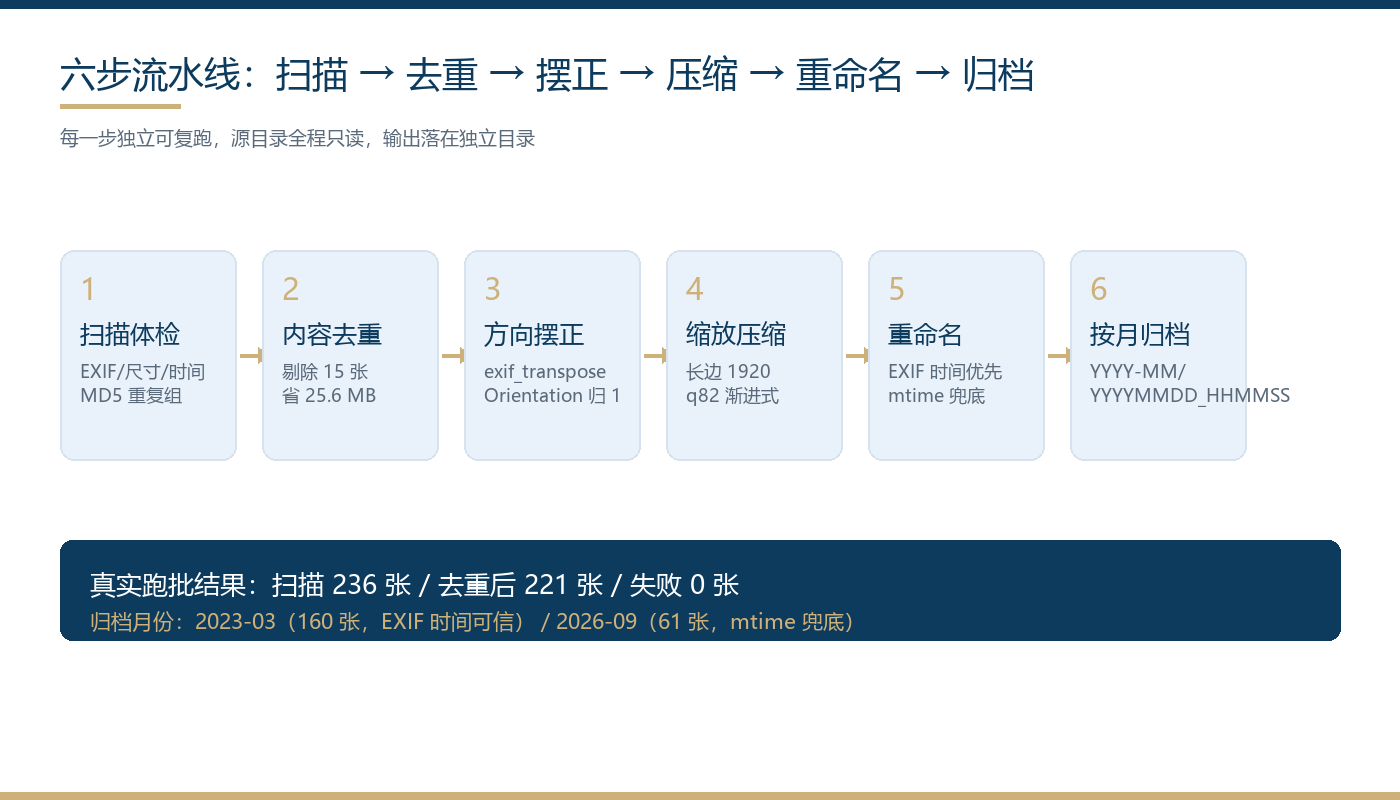
整条流水线是 扫描 → 去重 → 摆正 → 压缩 → 重命名 → 按月归档 六步,每一步都能单独复跑。核心代码不长:
import os, glob, hashlib, collections
from datetime import datetime
from PIL import Image, ImageOps

SRC, OUT = "./src", "./out"          # 源目录只读
MAX_EDGE, QUALITY = 1920, 82
EXTS = ("*.jpg", "*.jpeg", "*.JPG", "*.JPEG", "*.png", "*.PNG")

def collect(root):
    fs = []
    for e in EXTS:
        fs += glob.glob(os.path.join(root, "**", e), recursive=True)
    return sorted(set(fs))

def pick_dt(ex, path):
    """★ 坑点:真实相机写在 Exif SubIFD(0x8769),Pillow 等工具写在 IFD0 —— 两处都要查"""
    sub = ex.get_ifd(0x8769)
    for holder in (sub, ex):
        for tag in (36867, 36868, 306):     # DateTimeOriginal / Digitized / DateTime
            v = holder.get(tag)
            if v:
                try:
                    return datetime.strptime(str(v).strip(), "%Y:%m:%d %H:%M:%S"), "exif"
                except ValueError:
                    continue
    return datetime.fromtimestamp(os.path.getmtime(path)), "mtime"   # 兜底

def md5(p, blk=1 << 20):
    h = hashlib.md5()
    with open(p, "rb") as f:
        for b in iter(lambda: f.read(blk), b""):
            h.update(b)
    return h.hexdigest()

# 1) 扫描 + 2) 内容去重:同一份内容只留一张
files = collect(SRC)
groups = collections.defaultdict(list)
for p in files:
    groups[md5(p)].append(p)
keep = [v[0] for v in groups.values()]
dup_n = sum(len(v) - 1 for v in groups.values() if len(v) > 1)

# 3)~6) 摆正 → 压缩 → 重命名 → 按月归档
used = {}
for p in keep:
    with Image.open(p) as im:
        ex = im.getexif()
        dt, src = pick_dt(ex, p)
        base = dt.strftime("%Y%m%d_%H%M%S")
        seq = used.get(base, 0); used[base] = seq + 1
        name = f"{base}_{seq:02d}.jpg" if seq else f"{base}.jpg"   # 同秒防覆盖

        im = ImageOps.exif_transpose(im)        # ★ 真正旋转像素
        w, h = im.size
        s = min(1.0, MAX_EDGE / float(max(w, h)))   # 只缩不放
        if s < 1.0:
            im = im.resize((round(w * s), round(h * s)), Image.LANCZOS)
        if im.mode != "RGB":
            im = im.convert("RGB")

        ex[274] = 1                             # ★ 摆正后必须把标记改回 1
        d = os.path.join(OUT, dt.strftime("%Y-%m")); os.makedirs(d, exist_ok=True)
        im.save(os.path.join(d, name), "JPEG", quality=QUALITY,
                optimize=True, progressive=True, exif=ex.tobytes())
print(f"去重冗余 {dup_n} 个,输出 {len(keep)} 张")真实跑批的实测输出:去重冗余 15 个,输出 221 张,耗时 23.7 秒、单张 107 ms、0 失败。
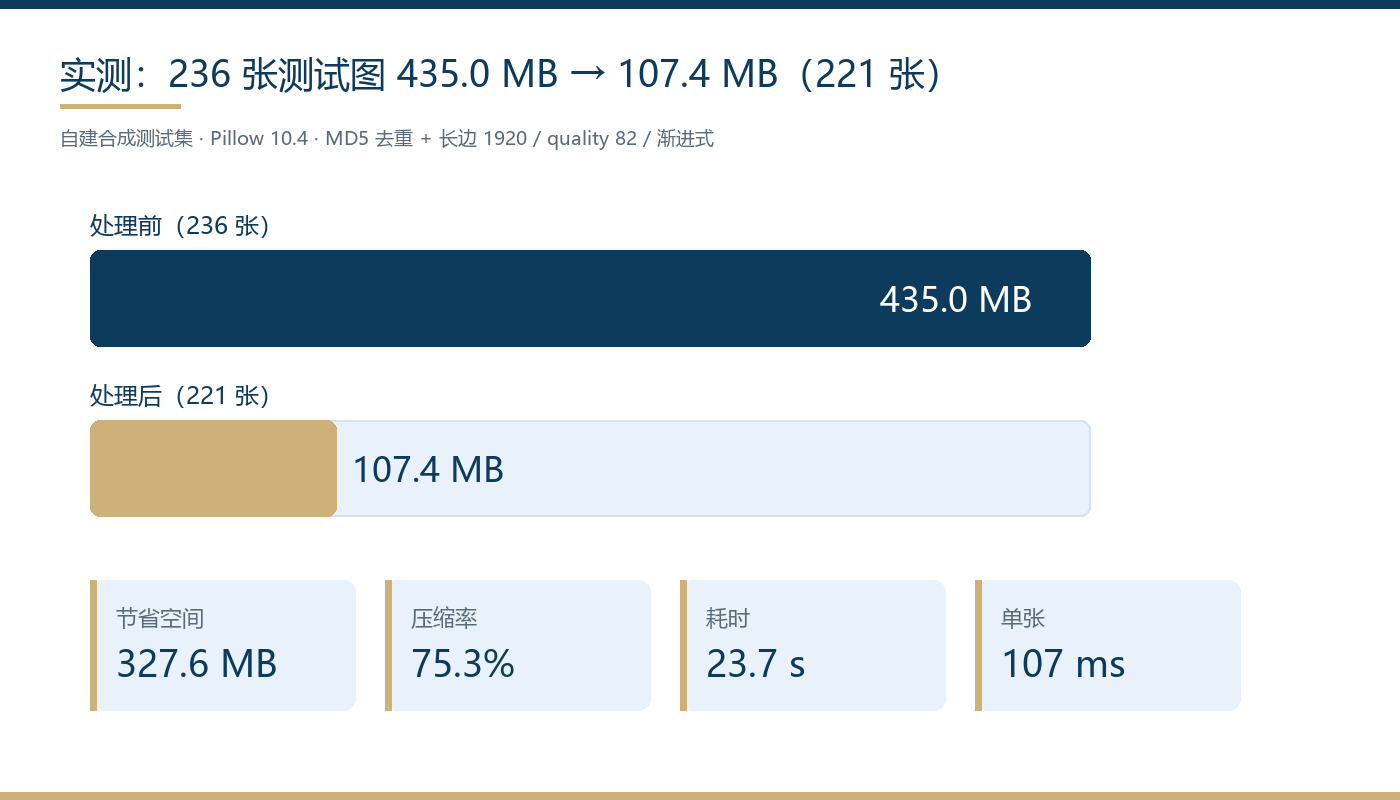
三、实测结果:435.0 MB → 107.4 MB
指标 | 处理前 | 处理后(含 MD5 去重) | 变化 |
|---|---|---|---|
文件数 | 236 张 | 221 张(剔除 15 个重复) | 0 失败,逐张可对 |
总体积 | 435.0 MB | 107.4 MB | 省 327.6 MB |
压缩率 | — | 75.3% | 相当于 4.05 : 1 |
超 1920 长边 | 80 张 | 0 张 | 全部合规 |
方向需摆正 | 73 张 + 39 张标记不可信 | 全部摆正, | — |
命名 | 哈希名 / |
| 可直接排序 |
目录结构 | 单层堆叠 | 按 | 2 个月份目录 |
冗余重复 | 15 个文件、25.6 MB | 输出侧重复组 0 | 彻底干净 |
耗时 | — | 23.7 秒 | 单张 107 ms |
作为对照,如果只压缩不去重(同样 236 张全量处理),结果是 435.0 MB → 115.2 MB、耗时 25.5 秒、单张 108 ms、压缩率 73.5%。也就是说"多做一步 MD5 去重",能再多省 7.8 MB、少跑 1.8 秒,并换来一份零重复的干净图库。输出侧最大的单张只有 733.3 KB(1920×1080),而处理前最大单张是 8.48 MB。
方向摆正的效果,用三个真实样本说明:
文件 | Orientation | 原始像素 | 原始看起来 | 摆正后像素 | 摆正后 |
|---|---|---|---|---|---|
sample_003.jpg | 8(转 270°) | 900×600 | 横图 | 600×900 | 竖图 |
sample_005.jpg | 6(转 90°) | 1920×1080 | 横图 | 1080×1920 | 竖图 |
sample_010.jpg | 3(转 180°) | 2560×1440 | 横图(内容倒置) | 2560×1440 | 横图(已正) |
注意第三行:Orientation = 3 是 180° 旋转,宽高完全不变。所以"用宽高判断图片有没有问题"是不成立的——它只能靠肉眼或标记,这也是批量处理最容易被漏掉的一类。
四、踩坑清单(都是这次真踩的)
im.getexif()只返回 IFD0,读不到真实相机的拍摄时间。 必须补一句ex.get_ifd(0x8769)。踩这个坑的直接后果是:170 张照片的拍摄时间全部退化成"文件复制时间",按月归档直接错月(本次多出一个装了 61 张图的2026-09目录)。exif_transpose()之后要手动把Orientation改回 1。 它只旋转像素、不改标记;原样保存的话下游软件会再转一次,竖图又变回横图。Orientation = 0是非法的。 11 张图是这个值,exif_transpose()对它不做处理,属于"这台电脑看着正常、换一台就翻车"的灰色地带,必须在体检报告里单独点出来。- 同一秒连拍会撞文件名。 用
YYYYMMDD_HHMMSS命名时会遇到同秒图片,需要追加_01、_02,否则静默覆盖。 - 扩展名要显式列举。 目录里混了 3 个
.txt和 1 个.png。只写*.jpg会让统计口径变小;不做白名单则Image.open()直接抛异常。 - 缩放只能缩、不能放。 用
min(1.0, MAX_EDGE / max(w, h))做上限,避免把小图拉伸放大反而糊掉。 - 重采样要用
Image.LANCZOS。 默认算法在大图缩放时边缘会有明显锯齿。 progressive=True更省流量。 渐进式 JPEG 在网页上先出低清轮廓再逐层清晰,加载体验更好。- 源目录只读。 全程不对源目录做任何写操作,输出全部落在独立目录——批量处理任何图库,这条都该是底线。
五、给 WorkBuddy 的提示词模板
这套流程我是直接"说"出来的,下面是可以直接复用的模板:
我要整理一个图片目录,请写一个 Python 脚本并真实跑一遍,把每一步的真实数字报给我。
源目录:<绝对路径>(只读,不要改动原件) 输出目录:<绝对路径> 目标:长边 1920、JPEG quality 82、开启渐进式
请按六步做,每步都要输出统计: 1. 扫描体检:文件数、扩展名分布、EXIF Orientation 分布、有/无拍摄时间张数、 尺寸超限张数、MD5 重复组数与冗余体积 2. 内容去重:按 MD5 分组,每组只留一张 3. 方向摆正:用 ImageOps.exif_transpose,摆正后把 Orientation 改回 1 4. 缩放压缩:等比缩放,长边压到 1920;只缩不放;用 LANCZOS 重采样 5. 重命名:优先 EXIF 拍摄时间,注意它可能在 SubIFD(0x8769) 也可能在 IFD0, 两处都要查;取不到再回退文件 mtime,并在报告里标记时间来源; 同秒加序号防覆盖 6. 按月归档:输出到 YYYY-MM/ 子目录
最后给我:处理前后体积对比表、压缩率、耗时、单张均耗时、失败清单。 不要编造数字,所有结果用真实输出填。
关键就三条:要求真实跑一遍并回报数字、明确源目录只读、明确时间两处都要查。写清楚这三条,基本不会跑偏。
六、小结
图片整理这件事,手动做是"一下午 + 一堆误操作",交给脚本是"23.7 秒 + 一份可复现的报告"。这次真实跑批的收益:435.0 MB 压到 107.4 MB(75.3%),73 张方向错误的图被摆正、39 张方向标记不可信的图被统一,15 个重复文件被识别剔除、输出侧重复组归零,221 张图按月份目录、以拍摄时间命名归档完成,0 失败。
如果你也被散落的图片困住,建议先只做第一步——跑一次只读体检。多数图库的问题不在体积,而在那些方向不可信、时间不可信的 EXIF 标记里。先把体检报告拿到手,再决定压到多少,比一上来就批量压缩要稳得多。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号