把 AI 的"人格"塞进 20KB:一套跨设备记忆同步层的设计与踩坑复盘
原创
把 AI 的"人格"塞进 20KB:一套跨设备记忆同步层的设计与踩坑复盘
原创
运动马
发布于 2026-09-28 09:43:46
发布于 2026-09-28 09:43:46
一、缘起:一个膨胀到失控的"灵魂库"
最早那版记忆同步方案的初衷其实挺朴素——让 AI 记住"我是谁、我怎么想、我忌讳什么",换台设备、换个智能体也不用从头"养"一遍。
但跑着跑着就歪了。它把 146KB 的记忆库、7 个项目库、工作区记忆全量收编上云,加上一条"只做加法、严禁删改缩写"的铁律,结果越攒越多:最终炸出 67 个分片 × 6KB ≈ 400KB,光 manifest 就 62KB,整个目录 1.2MB。
最要命的是,它把资料库、项目库也传上去了——这违背了一开始"只传人格"的设定。云上不是一个"我",而是一堆塞爆的杂物间。
二、诊断与重构:上云的是"人格",不是"仓库"
重做时,我把根子问题钉死:
- 上云的应该是个人意识形态(画像),不是全部成果、项目、资料库。
- 体积硬顶 20KB;云端只存单文档 + 固定 8 个分区;谁敢超 20KB,自动压缩或降级成"指针"。
- 原来 44 章 / 103KB 的明细铁律,蒸馏成 7 条根律 + 本地指针,不逐条往云上搬。
- 本地建四库分层:个人画像 / 知识库 / 资料库 / 项目库。重要资料 100% 本地,云端只留路径指针——这叫"本地优先,云只做指针"。
一句话:云上是"灵魂",本机是"肉体",各司其职。
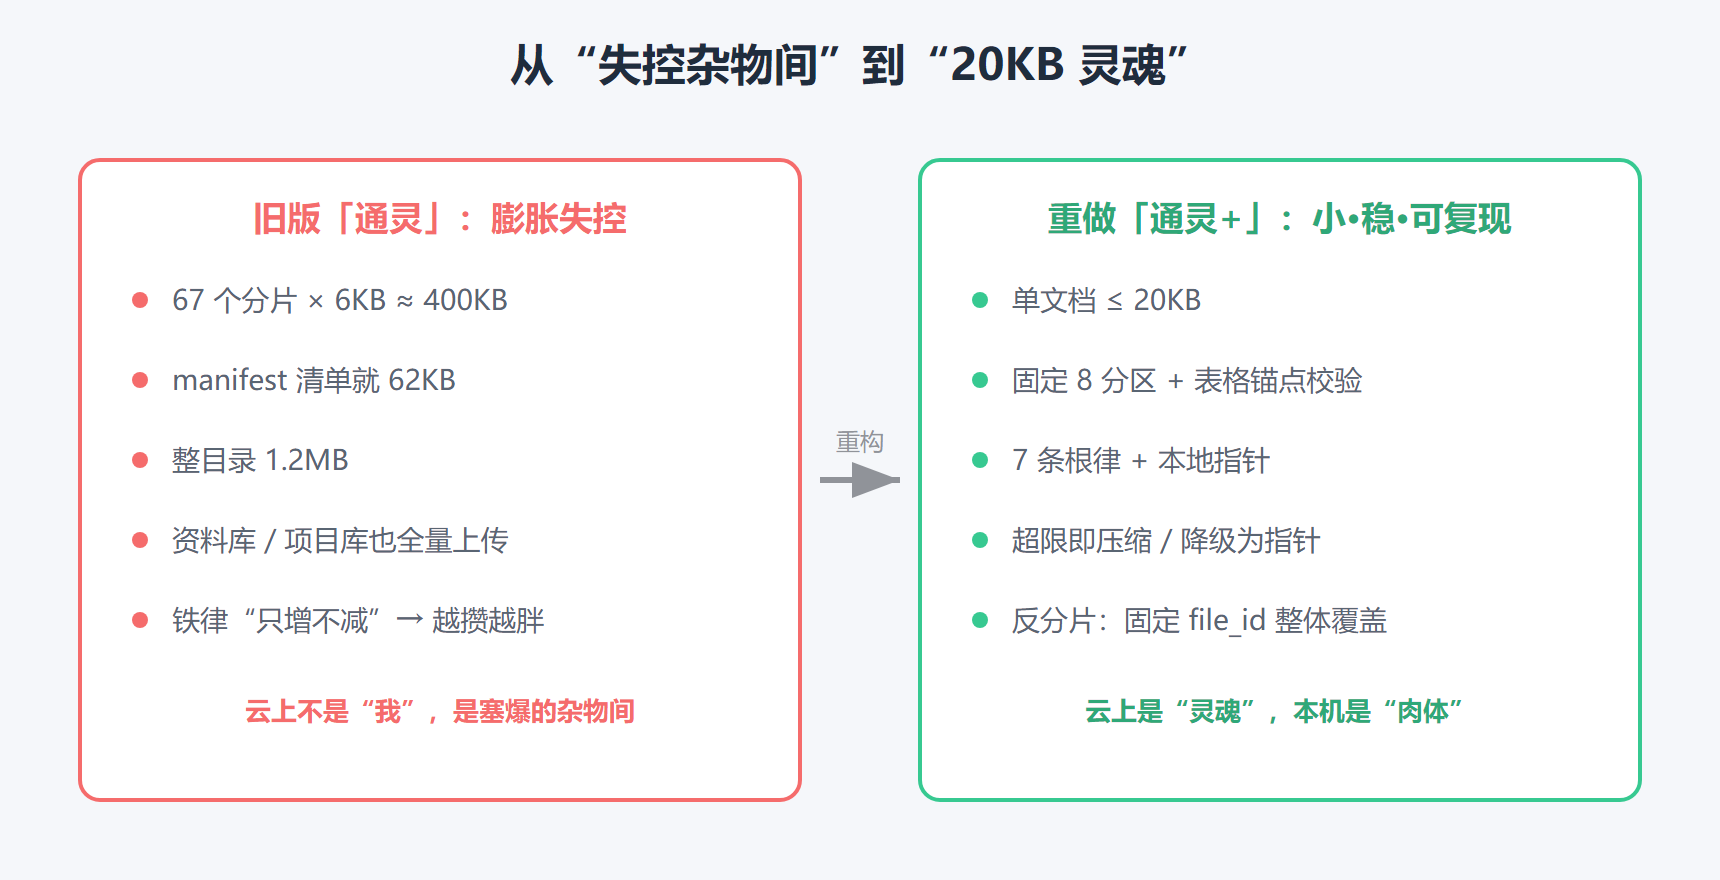
旧版膨胀 vs 重做后精简
三、核心架构与能力
1. 跨智能体的人格连续性
任意设备、任意新智能体,只要连上你的云端主档,就能还原你的身份、口吻、决策偏好、铁律、知识地图,不用重新"养"。我们做过盲测:一个全新子智能体,仅凭云主档就还原出了使用者的说话方式和那 7 条根律,逐条点名都对。
2. 单文档主档 ≤20KB,8 固定分区 + 表格锚点校验
主档是固定结构(8 个 § 分区),带表格元素做"锚点",每次同步后回读校验——防止同步过程中把表格内容弄丢。超限即压缩,根治 67 分片。
3. 7 条根律默认契约
零编造 · 先查再造 · 跑到出结果 · 公文即公文(按需启用)· 本地优先·云只做指针 · 零扰动本机 · 逐字不丢·提问用选择题。任何人首次使用时都能增删改,填进自己的"原话精神"。
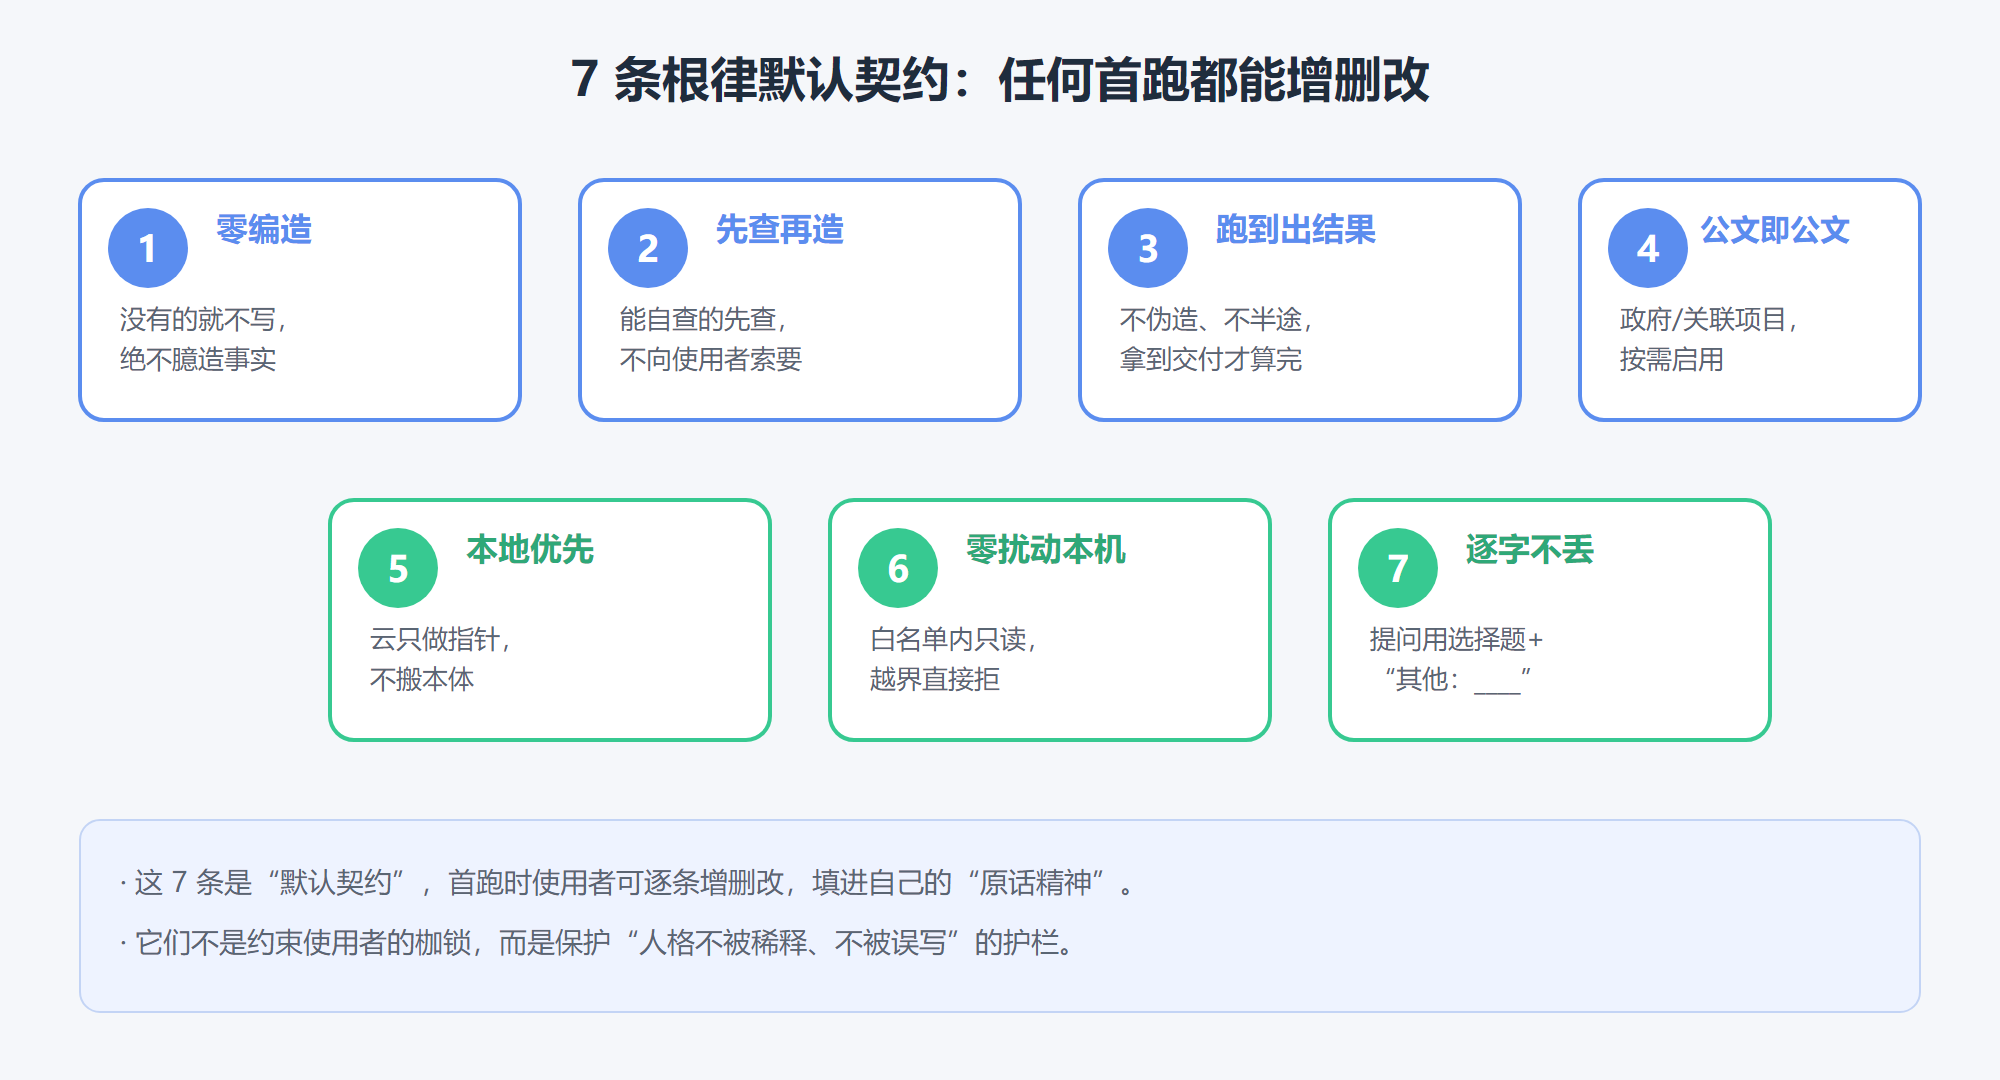
7 条根律默认契约
4. 四库分层 + 指针引用
具体知识待在本地类目里,云端只登记"在哪、干嘛用、啥时触发"的地图。智能体要用,按指针去本地取,不搬本体。
5. 工作站桥接(可选)
把你常用的那台电脑当成"数据服务器"。手机或别的电脑上的智能体,经云端中继文档只读取数——白名单内只读、不搬本体、越界直接拒。对应"零扰动本机"那条根律的远端形态。
6. 首跑向导(多用户自适应)
第一次用会走向导:用选择题 + "其他:____"一项项采集你的身份、行业、沟通偏好、忌讳红线;AI 先草拟画像草稿,回显给你逐条核对,你说"哪条不对"才改,确认准了才落盘。工作站确认可跳过,最后还给你一份《使用说明书》并确认要哪些功能。确认闭环,绝不偷跑。
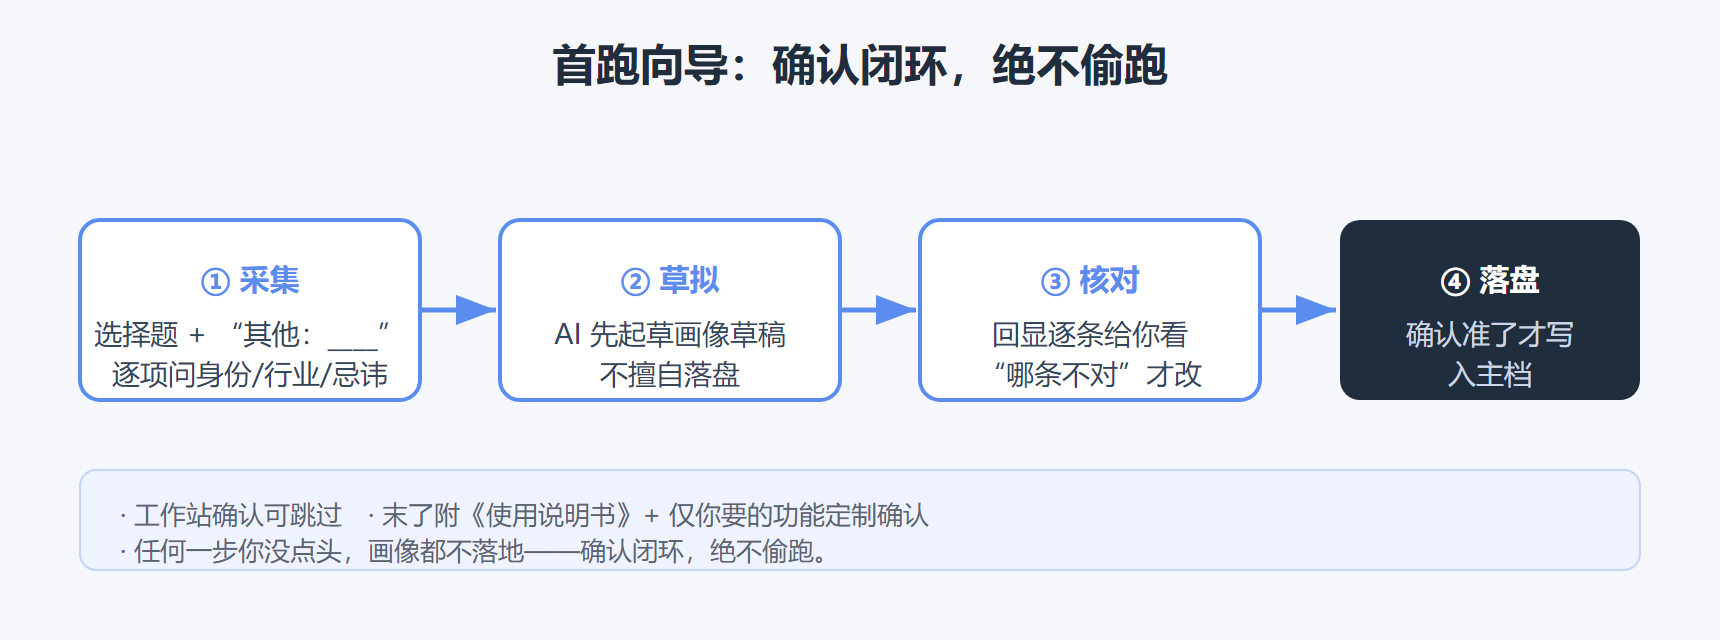
首跑向导:确认闭环,绝不偷跑
7. 反分片 + 盲测验收
同步用"固定 file_id 整体覆盖",严禁每次新建文件(那才是分片的真凶)。换全新智能体盲测还原、连续多次同步不产生新文件——这两关都过了才算交付。
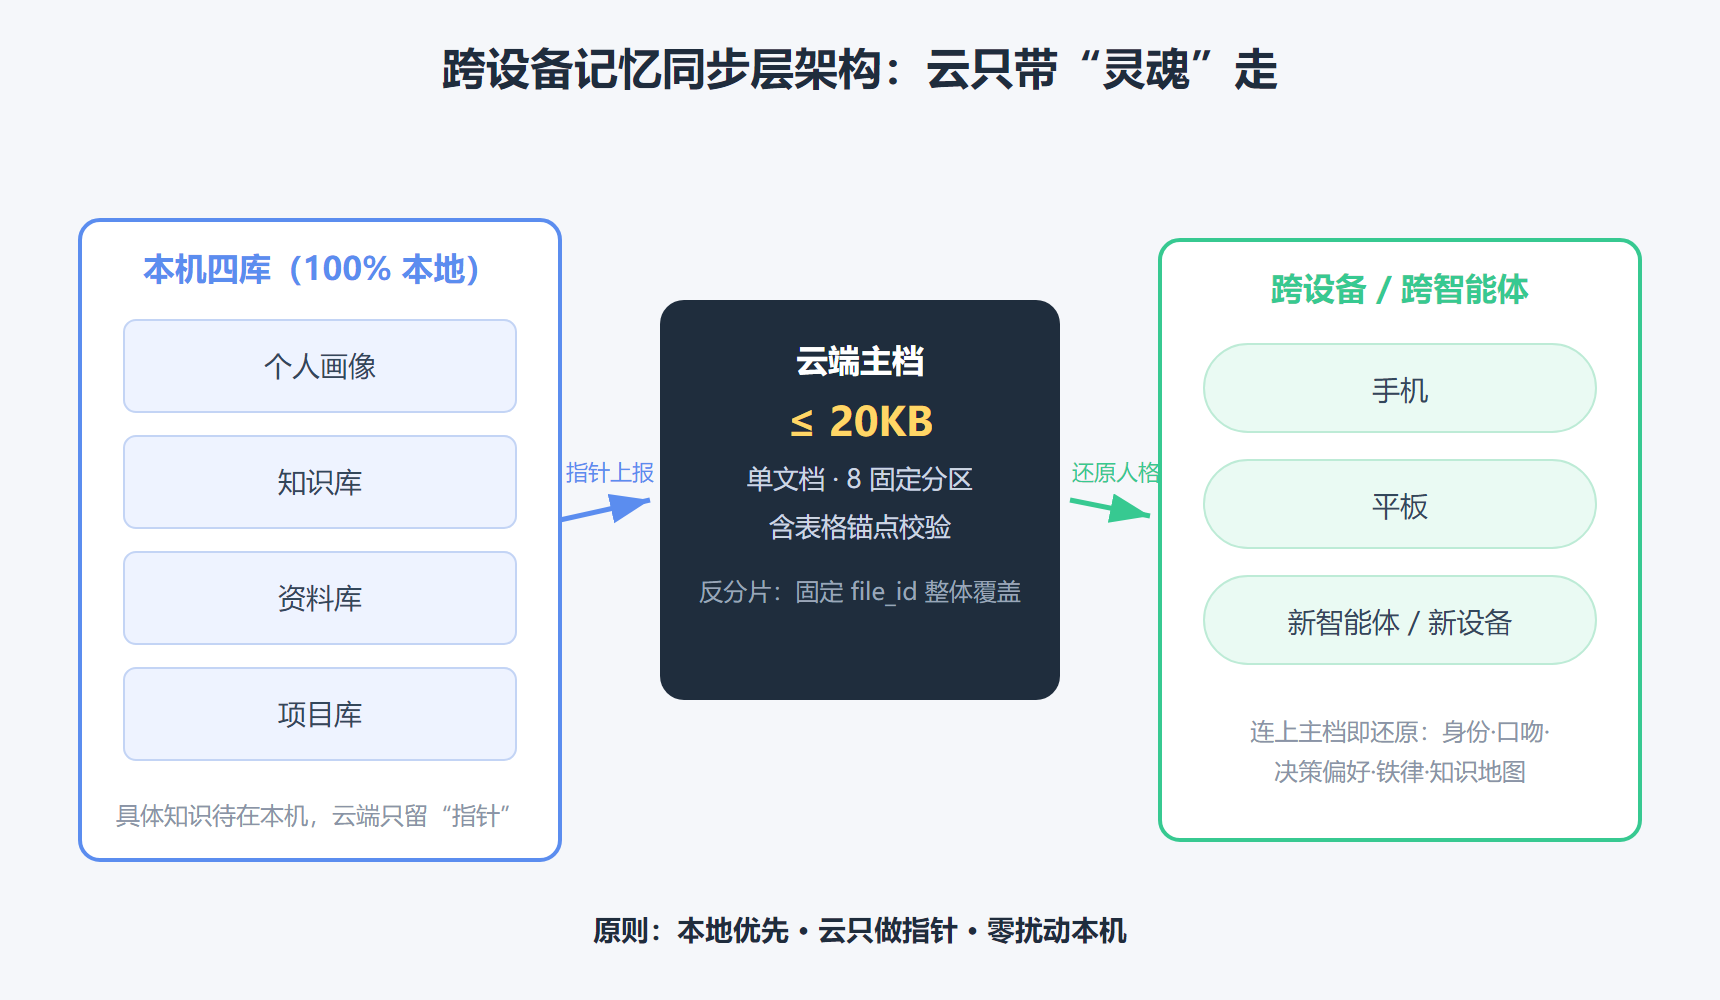
跨设备记忆同步层架构:云只带“灵魂”走
四、一路踩坑:把"装得上"也做成了工程
光能用不够,得装得上。这趟踩的坑一个比一个实,共性规律值得记一笔:
- 清单文件必须顶层可见:某些导入器只看压缩包顶层、不递归。只要清单文件被套在子文件夹里,顶层缺失 → 直接判失败。修法:把清单文件直接放在压缩包根目录。这个"顶层可见"原则,对所有需要被自动识别的配置/说明分发都适用。
- 中文脚本"闪一下就没了":PowerShell 5.1 在中文环境下容易按系统 ANSI(GBK) 误解码 → 解析失败 → 窗口秒关。修法:脚本用 UTF-8 with BOM (utf-8-sig) 写出,再用一个批处理脚本包一层
pause,窗口常驻不闪退。中文环境下的脚本分发,BOM 是保命符。 - 分发包别夹带个人配置:把通用模板和个人真实配置混在一个包里分发,隐私会随包外泄。关键原则:模板与实例分离,实例由用户首次运行时本地生成。这是做分发时最容易忽略的一条红线。
五、几点可复用的经验
- 给"上云内容"设硬顶:任何跨设备同步的个人数据,先问"它该上云吗"。能留本地的留本地,云端只放指针,体积和政治风险都可控。
- 反分片要从接口层面堵死:用固定 file_id 整体覆盖,比"同步后清理碎片"可靠得多。
- 把交付面做全:真正可用的方案,最后一公里是"能稳定复现"。把配置、校验、入口统一好,价值远大于多写十页文档。
六、结语
这套东西的本质,是一个人格随身走的同步层:你在 A 设备调教好的思维方式,到 B 设备、换个智能体,照样在。本地是你的,云上只带"灵魂"走。
工程上没有银弹,但"小、稳、可复现"这三个字,值得每次都拿出来掂量。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号