AI Infra 知识全景学习笔记
原创
AI Infra 知识全景学习笔记
原创
南京刘三刀
发布于 2026-10-03 21:53:23
发布于 2026-10-03 21:53:23
AI Infra 全景教程:从算力、训练、推理到 MLOps、安全合规与成本治理
版本基线:2026 年 10 月 3 日 适用读者: 具备云计算、容器、机器学习基础的工程师、架构师、平台研发与技术管理者 适用场景: 技术社区科普、AI 平台建设、训练平台设计、推理平台建设、云上 AI 基础设施选型 说明: 本文为技术教育与工程实践材料,不构成法律意见、采购建议、云产品性能承诺或价格承诺。涉及具体产品能力、地域可用性和价格时,应以厂商最新官方文档、控制台及合同为准。文中的成本数字除特别注明外均为示例测算值,不代表腾讯云或其他厂商报价。
执行摘要
AI Infra,也就是 AI(Artificial Intelligence)Infrastructure,可以理解为:为了让模型从“数据与代码”稳定地走到“训练完成、在线提供服务并持续迭代”,所需要的全部计算、存储、网络、软件平台、调度系统、可观测性、安全、成本和治理基础设施。
过去,人们谈 AI 基础设施时往往把重点放在 GPU(Graphics Processing Unit)集群;到 2026 年,这个定义已经明显不够。现代 AI Infra 至少同时解决七类问题:
维度 | 核心问题 |
|---|---|
算力 | 模型在哪些 GPU、TPU(Tensor Processing Unit)或其他加速卡上运行? |
数据 | PB(Petabyte)级训练数据如何进入训练节点,又如何控制权限、版本和来源? |
训练 | 几十亿到数千亿参数怎样在几十、几百甚至更多加速器之间切分? |
推理 | 如何同时优化吞吐、首 Token 延迟、单 Token 延迟和显存利用率? |
平台 | 如何让算法工程师不直接管理机器,而通过统一训练、模型和服务平台工作? |
运维与成本 | 如何监控 GPU、自动扩缩容、回滚版本、减少空闲卡和失败作业? |
安全与合规 | 数据是否合法、模型是否可追踪、生成内容是否需要标识、日志怎样审计? |
腾讯云当前的 TI-ONE 已经体现了这种“完整 AI Infra”思路:官方将其定位为大模型训推一体平台,覆盖数据准备、训练、模型管理、评测和模型服务,并将 GPU 调度、存储、监控、日志、推理加速和资源治理放进同一体系。底层可以结合 COS(Cloud Object Storage)、CFS(Cloud File Storage)、GooseFS、GPU 与异构加速卡等资源。citeturn11view0
与此同时,行业正在发生几项非常重要的变化。第一,AI 集群正在从“服务器集合”演化为机架级计算机:例如 NVIDIA GB200 NVL72 将 72 个 Blackwell GPU 放进同一个高带宽 NVLink 域;Azure 的 ND GB200 v6 也采用 18 台虚拟机、72 个 GPU 的机架级设计。citeturn3search0turn15search1 第二,推理正在从传统“每个副本独立完成一切”向 Prefill/Decode 分离、分层 KV(Key-Value)Cache、智能路由和跨节点推理演进,DistServe 的研究、NVIDIA Dynamo 以及腾讯云 TI-ONE 的 P/D 分离都反映了这一趋势。citeturn21search0turn9search7turn11view0 第三,AI Infra 的竞争已经从“峰值 FLOPS(Floating Point Operations Per Second)”逐步转向有效吞吐、内存容量、网络拓扑、任务恢复能力、GPU 利用率以及单位 Token 成本。Google Cloud 甚至在 AI Hypercomputer 的架构说明中直接把 goodput,即“有效机器学习生产率”,作为系统设计指标之一。citeturn15search0
对于企业而言,一个合理的 AI Infra 目标不是“买最多的 GPU”,而应该是:
让正确的数据,以可追溯方式进入正确的训练任务;让训练任务以尽可能高的有效算力利用率完成;让模型通过评测、安全检查和版本管理进入推理环境;最终以满足 SLO(Service Level Objective)的最低综合成本稳定提供服务。
这也是本文后续所有架构与实践设计的出发点。
定义、边界与核心术语
工程上的 AI Infra 边界
可以把 AI Infra 分为七层:
┌─────────────────────────────────────────────────────────┐
│                 AI 应用 / Agent / API                    │
├─────────────────────────────────────────────────────────┤
│ 推理层:Serving / Gateway / Routing / Cache / Autoscale │
├─────────────────────────────────────────────────────────┤
│ 模型层:训练 / 微调 / RL / 评测 / Registry / Artifact   │
├─────────────────────────────────────────────────────────┤
│ 平台层:Kubernetes / Scheduler / MLOps / CI/CD          │
├─────────────────────────────────────────────────────────┤
│ 数据层:Object Storage / File System / Dataset / ETL    │
├─────────────────────────────────────────────────────────┤
│ 资源层:GPU / TPU / NPU / CPU / Memory / Storage        │
├─────────────────────────────────────────────────────────┤
│ 网络与机房:RDMA / RoCE / InfiniBand / Ethernet / DC    │
└─────────────────────────────────────────────────────────┘

横向能力:
Security / Compliance / Observability / FinOps / IAM / Audit这里非常重要的一点是:模型本身通常不是 AI Infra,但模型的生命周期管理系统属于 AI Infra;业务 Prompt 本身不是 AI Infra,但 Prompt 的版本、审计和安全网关可以属于 AI Infra;训练数据本身不是基础设施,但数据版本、权限、血缘、传输和缓存系统属于基础设施。
在腾讯云体系中,这种层次关系可以粗略映射为:CVM(Cloud Virtual Machine)/GPU/HCC 提供计算与高速网络,COS/CFS/GooseFS 提供数据层,TKE(Tencent Kubernetes Engine)承担云原生编排,TI-ONE 提供更高层的模型训练、评测、管理和在线服务能力。腾讯云 HCC(Tencent Hyper Computing Cluster)官方采用 RDMA(Remote Direct Memory Access)高速互联,并提供基于 RoCEv2(RDMA over Converged Ethernet version 2)的网络能力。citeturn11view0turn11view2turn23search35
核心术语表
术语 | 完整含义 | 在 AI Infra 中解决什么问题 |
|---|---|---|
GPU | Graphics Processing Unit | 大规模矩阵运算和模型训练、推理 |
CPU | Central Processing Unit | 数据加载、控制面、预处理、调度等 |
TPU | Tensor Processing Unit | Google 为机器学习设计的专用加速器 |
NPU | Neural Processing Unit | 神经网络专用处理器的泛称 |
HBM | High Bandwidth Memory | GPU/加速卡上的高带宽显存 |
RDMA | Remote Direct Memory Access | 节点间直接访问内存,减少 CPU 参与 |
RoCEv2 | RDMA over Converged Ethernet version 2 | 在以太网上实现 RDMA |
DP | Data Parallelism | 不同设备处理不同数据副本 |
TP | Tensor Parallelism | 将单层 Tensor 计算切到多个设备 |
PP | Pipeline Parallelism | 将模型不同层分配到不同设备 |
EP | Expert Parallelism | MoE(Mixture of Experts)模型中的专家并行 |
FSDP | Fully Sharded Data Parallel | 切分参数、梯度及相关状态降低单卡显存压力 |
ZeRO | Zero Redundancy Optimizer | DeepSpeed 的分片优化策略 |
KV Cache | Key-Value Cache | 推理过程中缓存 Attention 的历史 Key/Value |
TTFT | Time To First Token | 从请求到首个 Token 返回的时间 |
TPOT | Time Per Output Token | 后续每个输出 Token 的生成耗时 |
QPS | Queries Per Second | 每秒请求数 |
SFT | Supervised Fine-Tuning | 监督微调 |
RL | Reinforcement Learning | 强化学习,常用于模型后训练 |
MLOps | Machine Learning Operations | 模型从开发到生产运行的工程体系 |
CI/CD | Continuous Integration / Continuous Delivery | 自动测试、构建和部署 |
SLO | Service Level Objective | 服务可用性、延迟等目标 |
RTO | Recovery Time Objective | 故障后允许的恢复时间目标 |
RPO | Recovery Point Objective | 可接受的数据恢复点目标 |
TCO | Total Cost of Ownership | 总拥有成本 |
PyTorch 当前提供 FSDP2 能力,可对模型参数进行分片,并通过 DTensor 表达分布式参数;同时提供 Tensor Parallel API,以支持更复杂的多维并行。DeepSpeed ZeRO 则分别通过 Stage 1、Stage 2、Stage 3 对优化器状态、梯度和参数进行逐级分片,ZeRO-Infinity 还可以将状态进一步卸载到 CPU 或 NVMe(Non-Volatile Memory Express)存储。citeturn8view0turn8view1turn8view2turn6view3
“训练 Infra”和“推理 Infra”并不是一套完全相同的系统。
训练倾向于追求:
更高 GPU 利用率
+ 更好的 AllReduce/AllToAll 通信效率
+ 更快 checkpoint
+ 故障恢复
+ 大规模并行
而推理更加关心:
TTFT
+ TPOT
+ QPS
+ P95/P99 latency
+ KV Cache 命中率
+ tokens/s/GPU
+ cost / million tokens
因此,一个成熟平台通常不会简单地让训练集群与推理集群完全采用相同的资源策略。腾讯云 TI-ONE 已支持训练与推理资源的优先级、抢占、潮汐调度和 GPU 虚拟化等能力,这正是提高整体资源池利用率的一种思路。citeturn11view0
技术版图与近两年趋势
截至 2026 年 10 月,AI Infra 的变化已经不再只是“新一代 GPU 更快”,而是计算、网络、分布式算法和推理架构同时重构。
趋势:从单机多卡走向 Rack-scale 机架级计算
NVIDIA GB200 NVL72 是这一趋势非常典型的代表:一个机架集成 36 个 Grace CPU 和 72 个 Blackwell GPU,通过 NVLink 构成 72 GPU 高速互联域,NVIDIA 给出的跨 GPU 通信带宽指标达到 130 TB/s。citeturn3search0turn3search8
Microsoft Azure ND GB200 v6 则将每台 VM(Virtual Machine)的 4 个 Blackwell GPU 进一步组成 18 VM、72 GPU 的 NVL72 系统,官方文档给出的整机架指标包括约 13.5 TB HBM 和 130 TB/s NVLink 横截面带宽。citeturn15search1
AMD MI300X 走的是另一条高显存容量路线:单卡提供 192 GB HBM3,官方规格给出的峰值显存带宽为 5.3 TB/s。对于大模型推理来说,更大的单卡显存意味着在一些场景下可以减少 Tensor Parallel 的卡数,从而降低跨卡通信复杂度。后一句属于工程推论,实际收益仍取决于模型结构、精度和上下文长度。citeturn3search2turn3search10
Google Cloud 的 TPU v6e 则继续推进专用 AI 加速器路线,官方文档支持最高 256 个 TPU 芯片组成 Pod,目标包括 Transformer 训练、微调和推理。citeturn4search0
AWS 也继续推进自研芯片路线。当前官方 Trainium 页面已将 Trainium、Neuron SDK、EFA(Elastic Fabric Adapter)、Amazon EKS(Elastic Kubernetes Service)以及 SageMaker HyperPod 作为协同设计的 AI 基础设施体系,并展示了新一代 Trainium3 UltraServer。citeturn14search1
因此今天评估 AI 芯片时,已经不能只比较一个“TFLOPS(Tera Floating Point Operations Per Second)”数字,而应同时考虑:
芯片计算能力
      ↓
显存容量与显存带宽
      ↓
节点内互联
      ↓
节点间网络
      ↓
Collective 通信库
      ↓
分布式训练实现
      ↓
模型结构
      ↓
真实训练 goodput / 推理 tokens/s
趋势:P/D 分离正在成为大规模推理的重要架构
Transformer 推理大致可以分成两个阶段:
flowchart LR
    A[用户 Prompt] --> B[Prefill 阶段]
    B --> C[生成 KV Cache]
    C --> D[Decode 阶段]
    D --> E[Token 1]
    E --> F[Token 2]
    F --> G[Token N]
Prefill 通常对矩阵计算吞吐要求更强,Decode 则更加受显存访问、KV Cache 和逐 Token 调度影响。DistServe 在 OSDI 2024 的研究中提出把两个阶段放在不同 GPU 上,从而降低两类工作负载之间的干扰,并允许分别制定资源分配和并行策略。citeturn21search0turn21search16
这一研究方向随后快速进入生产级产品。NVIDIA Dynamo 当前支持将 Prefill 和 Decode 分配到不同工作节点,并在其上层处理请求路由、KV Cache 和多节点编排;腾讯云 TI-ONE 也已经提供 P/D 分离部署能力。citeturn9search7turn9search15turn11view0
因此未来一个大型推理集群可能不再是:
Replica 1: Prefill + Decode
Replica 2: Prefill + Decode
Replica 3: Prefill + Decode
而更像:
                  ┌── Prefill Pool ──┐
Request Router ───┤                  ├── KV Transfer ── Decode Pool
                  └──────────────────┘
这种设计尤其适合上下文长度、输入输出比例差异较大的业务,但并不意味着所有系统都应该立即采用。中小规模服务通常仍然应该优先选择简单的一体化部署,因为 P/D 分离会额外引入网络传输、调度和故障域管理成本。
趋势:KV Cache 已经成为“基础设施资源”
现代 LLM(Large Language Model)推理中,显存不仅要装模型权重,还必须容纳 KV Cache。随着上下文长度、并发数和 Agent 多轮调用增加,KV Cache 往往成为决定并发能力的重要资源。
vLLM 当前重点能力包括 PagedAttention、Continuous Batching、Chunked Prefill 和 Prefix Caching,用于提高 KV Cache 管理与批处理效率。citeturn14search0turn14search8 SGLang 则提供 RadixAttention、Prefix Cache 和多 GPU 推理等机制,并已支持 NVIDIA、AMD、Google TPU、Ascend 等多种硬件后端。citeturn9search1
因此推理容量规划应逐渐从:
模型参数数量 → 需要多少 GPU升级为:
模型权重
+ KV Cache
+ 最大上下文
+ 平均输入长度
+ 平均输出长度
+ 并发量
+ Prefix 命中率
+ 精度 / 量化方式
→ 所需 GPU 与网络
趋势:FP8、FP4、量化与推测解码进入生产栈
TensorRT-LLM 当前已经将 FP8(8-bit Floating Point)、FP4(4-bit Floating Point)、Paged KV Cache、Chunked Prefill、Speculative Decoding 等能力整合到推理框架中,并针对 Blackwell 等硬件进行优化。citeturn9search6turn9search2
这意味着未来“模型精度”不应该再被理解为单一全局配置。例如生产系统可能出现:
权重:FP8 / FP4
KV Cache:FP8
部分敏感算子:BF16
Embedding:BF16
通信:低精度
累加:更高精度真正的目标是在可接受模型质量下最大化单位 GPU 的有效吞吐,而不是机械地追求最低位宽。
趋势:训练平台转向训练、后训练和 RL 一体化
随着基础模型训练逐渐成熟,基础设施需要支持的不再只有 Pre-training,还包括 SFT、奖励模型、RL 和自动评测。腾讯云 TI-ONE 当前已经将 Ray 与 veRL 等能力用于强化学习微调场景,并把训练、模型管理、评测和服务整合进一套产品。citeturn11view0
趋势:异构算力与平台解耦越来越重要
腾讯云 TI-ONE 官方已经支持 NVIDIA GPU 与其他异构加速资源;Google AI Hypercomputer 同时覆盖 GPU、TPU 与开放软件层;SGLang 也支持多种硬件后端。citeturn11view0turn15search0turn9search1
因此一个长期可维护的企业 AI 平台最好做到:
业务代码
   ↓
训练 / Serving Framework
   ↓
Runtime Adapter
   ↓
Scheduler
   ↓
不同 GPU / NPU / TPU
而不是让业务代码直接绑定某一张卡。
主流平台与开源方案比较
下面的“成本等级”是工程选型的相对判断,不是供应商报价。真实价格会随地域、卡型、包年包月、按量、Spot、承诺用量及平台附加能力变化。
厂商/社区 | 代表方案 | 主要场景 | 优点 | 主要代价/局限 | 成本估算 | 部署复杂度 |
|---|---|---|---|---|---|---|
腾讯云 | TI-ONE | 大模型训练、微调、评测、部署 | 一体化;支持异构算力、训练与推理调度、P/D 分离、TACO 加速 | 平台能力较完整,需理解腾讯云资源体系 | 中~高;CVM/GPU + TI-ONE + 存储/日志等 citeturn11view0 | 低~中 |
腾讯云 | TKE + HCC | 自建云原生 AI 平台 | Kubernetes 灵活性高,可结合 GPU、RDMA、高性能网络 | 平台工程团队需要自行建设模型生命周期能力 | 中~高 citeturn2search5turn11view2 | 中~高 |
阿里云 | PAI | 训练、开发、在线推理 | DSW、DLC、EAS 覆盖开发、分布式训练和部署 | 平台产品较多,需要建立统一治理规范 | 中~高 citeturn23search1turn23search9 | 低~中 |
华为云 | ModelArts | AI 全生命周期与异构计算 | 训练、部署、资源管理一体化,适合华为云/昇腾生态 | 跨硬件迁移需测试框架兼容性 | 中~高 citeturn22search6turn22search10 | 低~中 |
Google Cloud | AI Hypercomputer | 超大规模训练与推理 | GPU/TPU、网络、软件协同设计 | 海外云与 TPU 生态需要额外学习 | 高 citeturn15search0turn15search13 | 中 |
AWS | Trainium + EKS + HyperPod | 大规模训练/推理 | 芯片、网络、Neuron 软件和调度协同 | Neuron 生态带来一定移植成本 | 中~高 citeturn14search1turn14search5 | 中~高 |
Microsoft Azure | ND GB200 v6 | 超大模型训练和推理 | GB200 NVL72 机架级架构和高速网络 | 属于高端资源,容量规划与成本要求高 | 很高 citeturn15search1 | 高 |
开源 | Kubernetes + PyTorch + Ray + vLLM/SGLang | 多云、自建 IDC、平台研发 | 可控、可移植、生态丰富 | 运维、安全、升级、调度都需自行负责 | 软件成本低,工程 TCO 可能很高 citeturn21search20turn5search7turn14search8 | 高 |
需要特别说明的是,“开源免费”不等于“成本最低”。对企业 AI 平台而言,真正需要比较的是:
[ TCO = Compute + Storage + Network + Platform + Observability + Security + Engineering + IdleWaste + FailureCost ]
即:
总成本
= GPU 小时
+ CPU 小时
+ 存储
+ 数据读写
+ 公网/跨地域流量
+ 负载均衡
+ 日志与监控
+ 平台费用
+ 平台研发人员
+ GPU 空闲
+ 训练失败重跑
腾讯云 TI-ONE 官方也明确指出,其公共云成本并非单一的“训练平台价格”,而是可能由 CVM、TI-ONE 订阅以及 COS、CFS、GooseFS、镜像仓库、监控、日志和负载均衡等资源共同构成。citeturn11view0
参考架构与组件选型
一个面向中大型团队的 AI Infra 可以设计成下面的结构:
flowchart TB

    U[开发者 / 算法工程师]
    GIT[Git / CI/CD]
    REG[镜像仓库]

    subgraph Data["数据平面"]
        COS[对象存储 COS]
        FS[共享文件系统 CFS / GooseFS]
        META[Dataset Catalog / Metadata]
    end

    subgraph Platform["AI 平台层"]
        NB[Notebook / IDE]
        TRAIN[Distributed Training]
        WF[Workflow / Pipeline]
        MR[Model Registry]
        EVAL[Evaluation]
        SERVE[Model Serving]
    end

    subgraph Compute["计算与调度层"]
        K8S[Kubernetes / TKE]
        SCHED[GPU Scheduler]
        GPU[GPU / NPU / Accelerator Pool]
        HCC[HCC / RDMA Network]
    end

    subgraph Runtime["模型 Runtime"]
        TORCH[PyTorch / DeepSpeed]
        RAY[Ray]
        VLLM[vLLM / SGLang]
        TRT[TensorRT-LLM / Dynamo]
    end

    subgraph Ops["运维与治理"]
        MON[Metrics / Monitoring]
        LOG[Logs / Tracing]
        IAM[IAM / Secret]
        AUDIT[Audit]
        COST[Cost / Quota]
    end

    U --> NB
    U --> GIT
    GIT --> REG

    COS --> TRAIN
    FS --> TRAIN
    META --> WF

    WF --> TRAIN
    TRAIN --> MR
    MR --> EVAL
    EVAL --> SERVE

    TRAIN --> TORCH
    TRAIN --> RAY
    SERVE --> VLLM
    SERVE --> TRT

    K8S --> SCHED
    SCHED --> GPU
    GPU --> HCC

    REG --> K8S

    Platform --> Ops
    Compute --> Ops
腾讯云 TI-ONE 官方架构本身也采用“数据—训练—模型管理—模型服务”的整体设计,并向下连接 GPU/异构算力、COS/CFS/GooseFS、监控和日志等基础能力。citeturn11view0
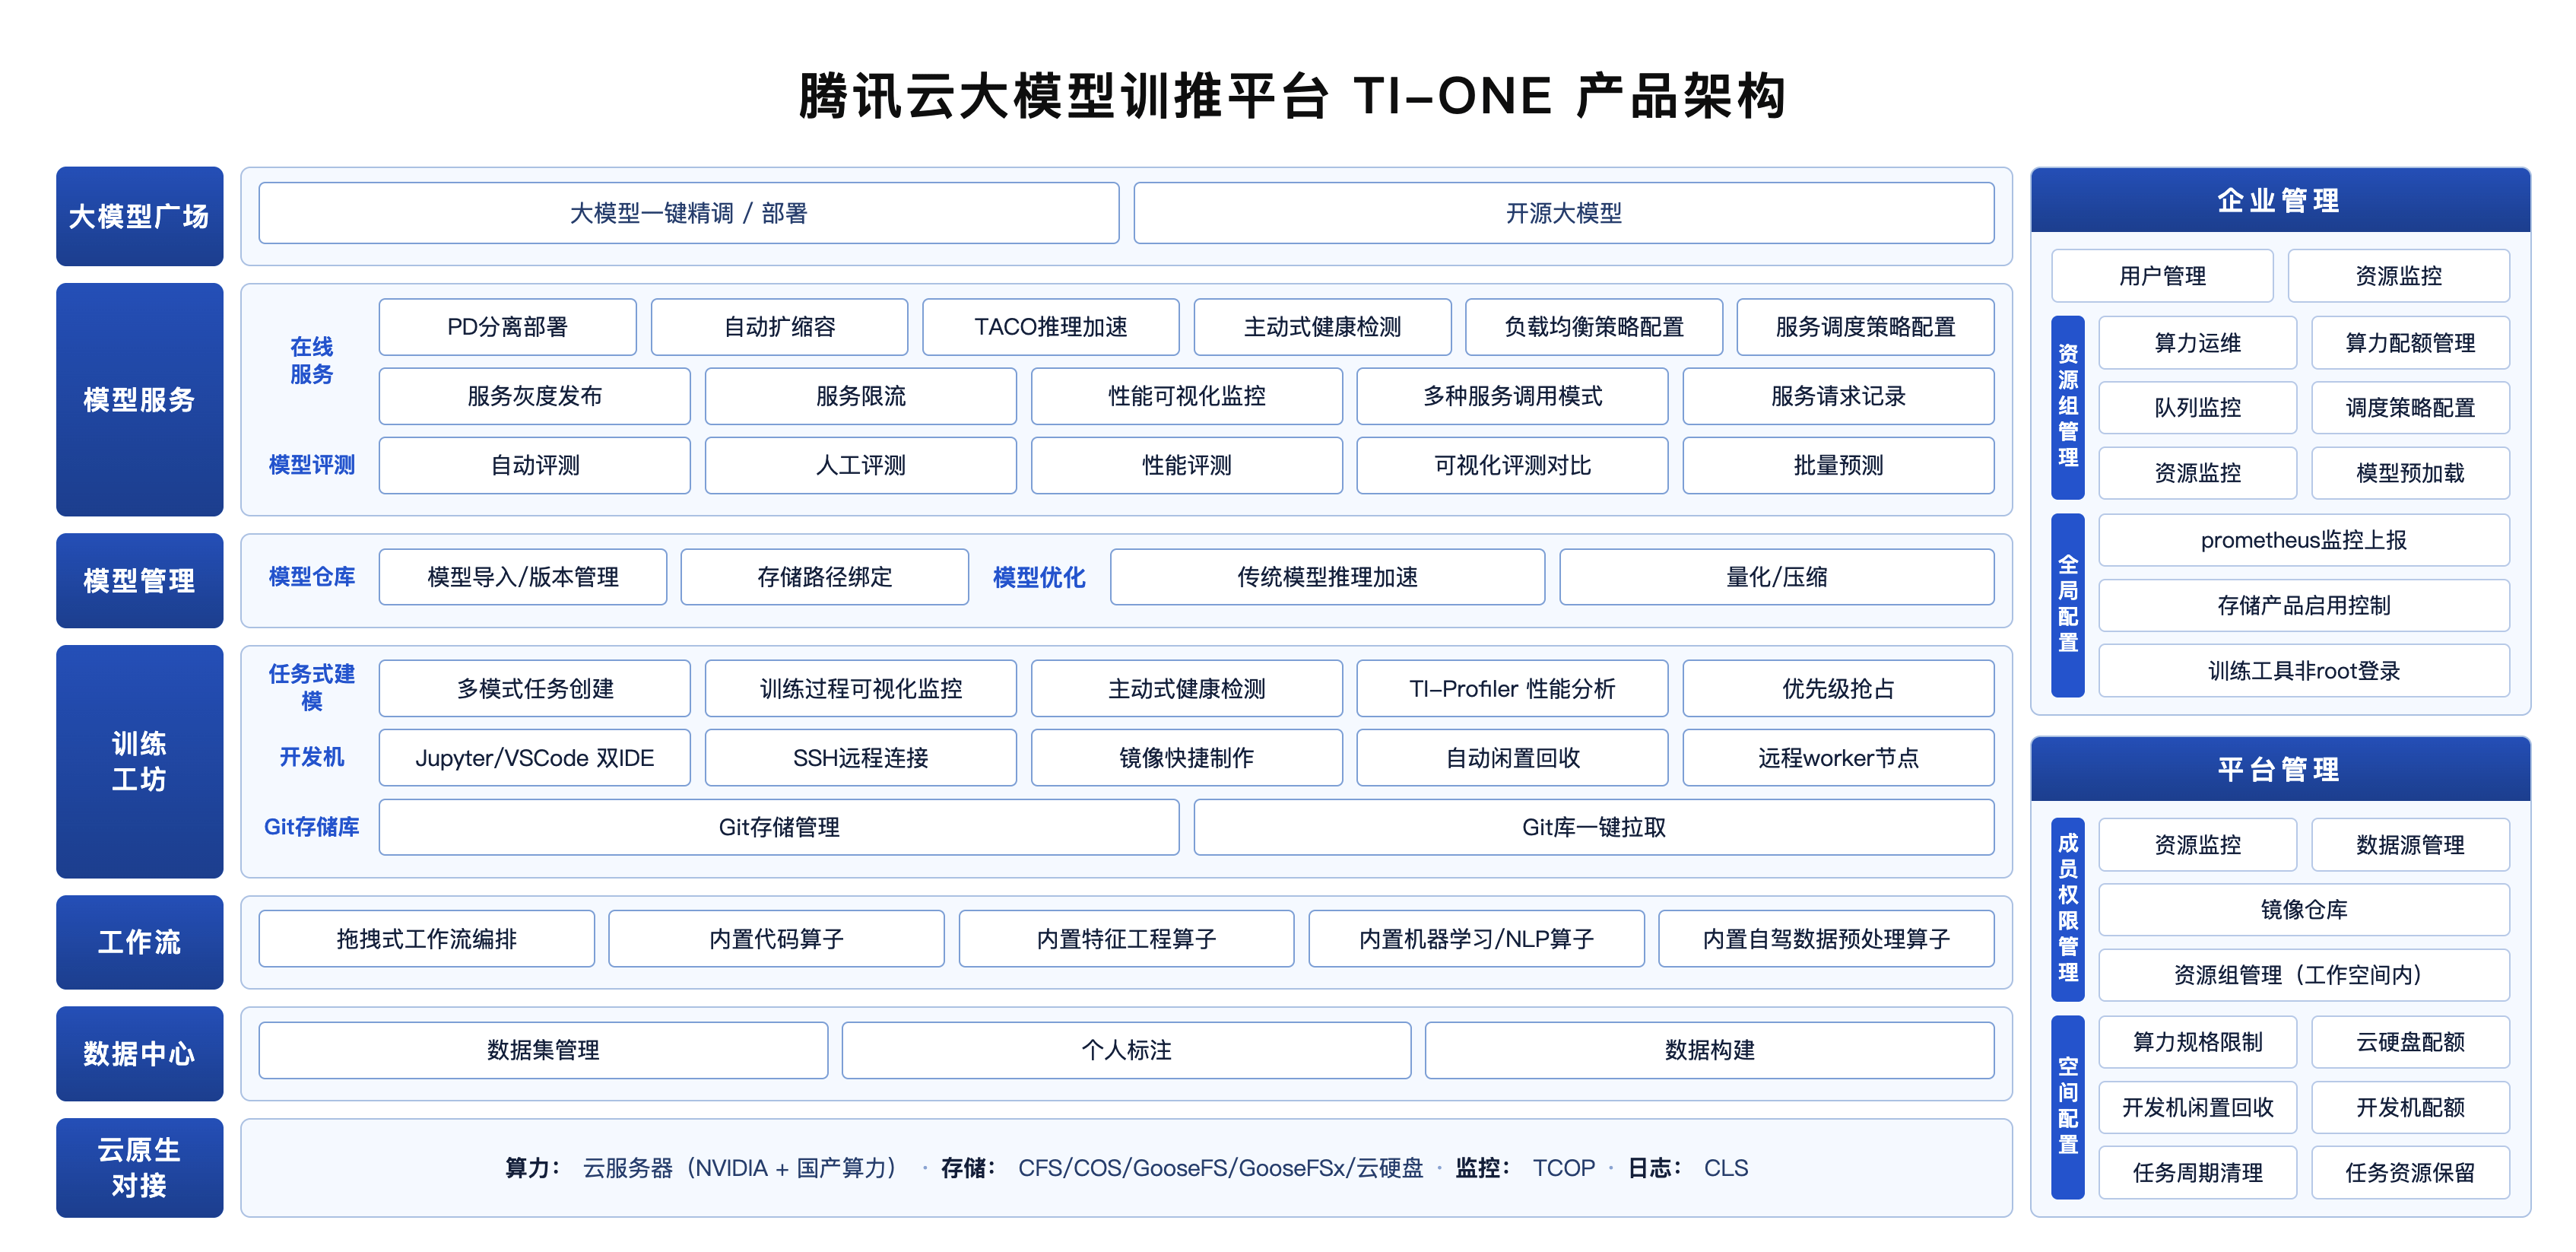
腾讯云 TI-ONE 官方产品架构示意图
图:腾讯云 TI-ONE 官方产品架构示意。具体界面与产品模块可能继续更新,应以官方当前页面为准。 citeturn11view0
计算层怎么选
训练 GPU 选型首先看四个参数,而不是品牌:
指标 | 对训练的影响 | 对推理的影响 |
|---|---|---|
Tensor Compute | 决定矩阵计算上限 | 决定 Prefill 能力 |
HBM 容量 | 决定模型/状态能否装下 | 决定模型 + KV Cache 容量 |
HBM 带宽 | 影响大量模型算子 | Decode 尤其敏感 |
GPU Interconnect | 决定 TP/EP 通信 | 多卡推理的重要瓶颈 |
当前部分代表性硬件:
平台 | 代表硬件 | 关键特征 |
|---|---|---|
NVIDIA | GB200 NVL72 | 72 Blackwell GPU 机架级 NVLink 域,130 TB/s GPU 通信带宽 citeturn3search0 |
AMD | MI300X | 192 GB HBM3,官方峰值显存带宽 5.3 TB/s citeturn3search2 |
TPU v6e | 最高 256 芯片 Pod,覆盖训练、微调、Serving citeturn4search0 | |
AWS | Trainium2/Trainium3 | 与 Neuron、EFA、EKS、HyperPod 协同设计 citeturn14search1turn14search5 |
网络为什么可能比 GPU 更重要
一个 64 卡任务如果需要频繁 AllReduce,那么 GPU 算得越快,等待通信造成的损失反而越容易被放大。因此大规模训练通常要求:
GPU
 ↓ NVLink / equivalent
Node
 ↓ RDMA
Top-of-Rack
 ↓ high-bandwidth fabric
Cluster
RDMA 的核心思想是让数据在网络设备和目标内存之间直接传输,减少 CPU 与系统内存的数据搬运。NVIDIA GPUDirect RDMA 进一步允许兼容的 PCIe 设备直接访问 GPU 显存。citeturn0search11
腾讯云 HCC 官方采用 RDMA 高速网络,并提供基于 RoCEv2 的配置;其产品说明还给出了最低至微秒级网络延迟的厂商指标。具体性能需要结合实例类型、地域和拓扑测试,不应直接把产品宣传指标当作所有工作负载的实际结果。citeturn11view2
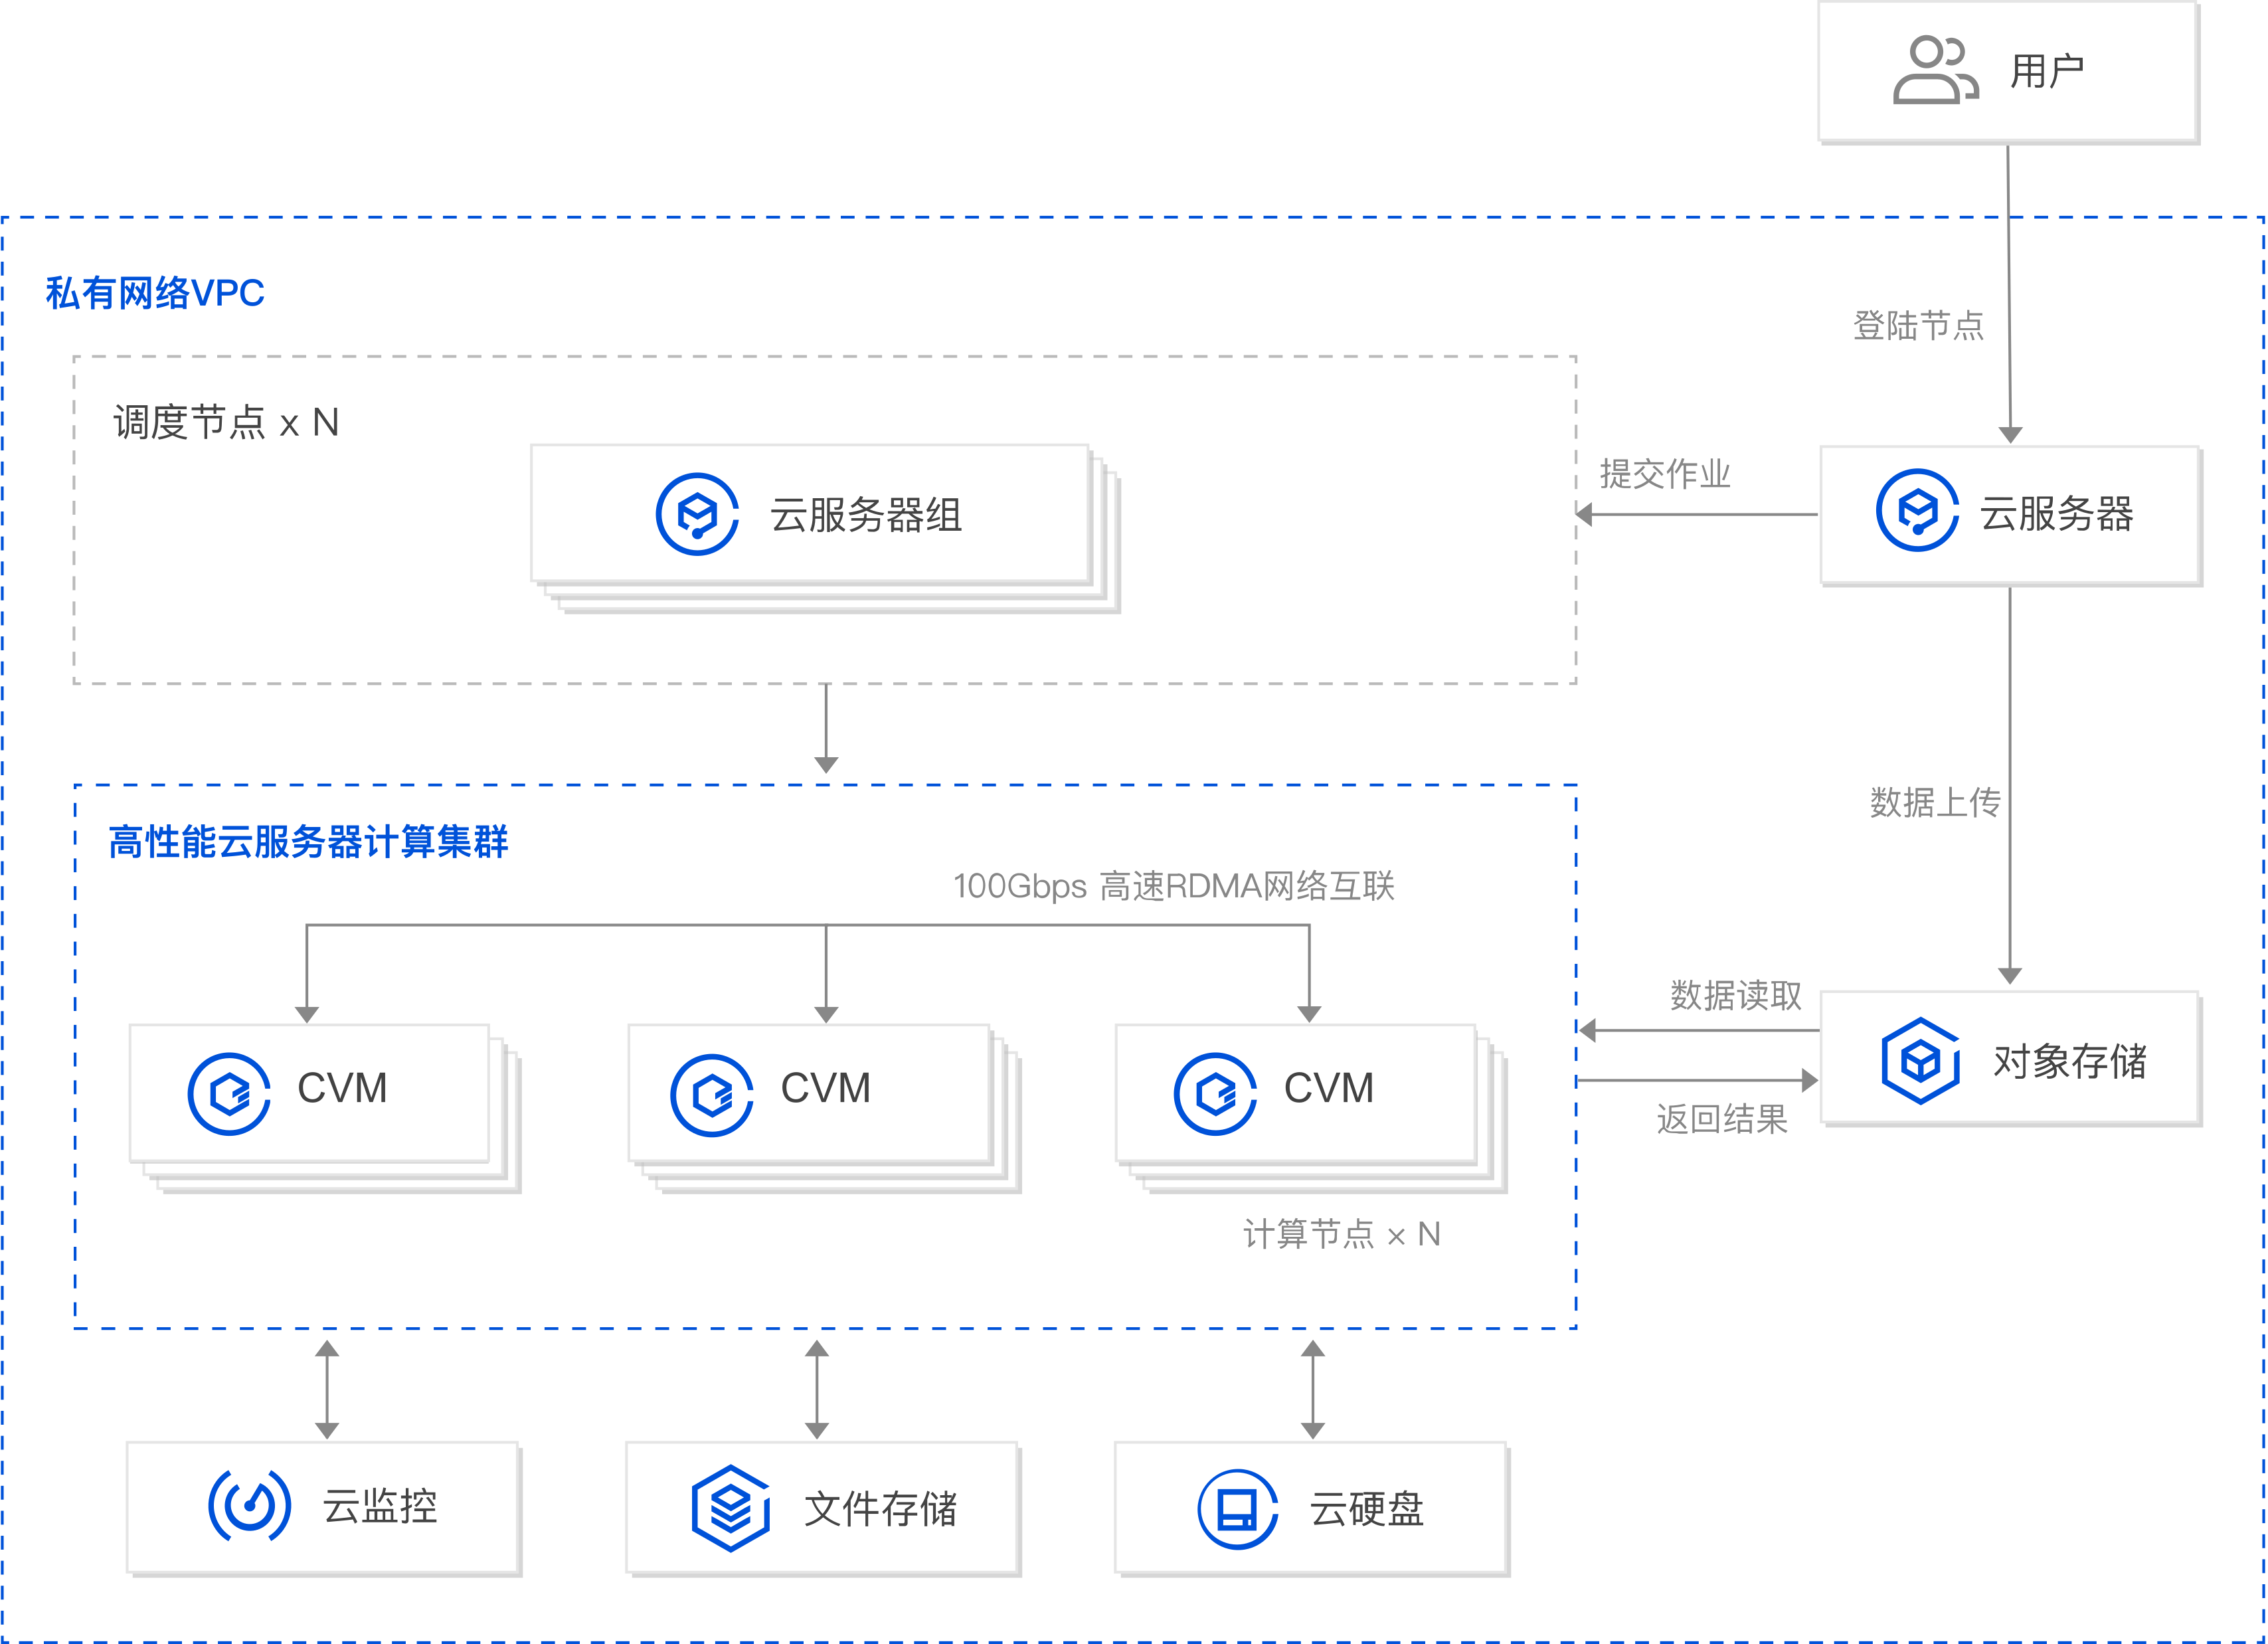
腾讯云 HCC 高性能计算集群架构示意图
图:腾讯云 HCC 官方架构示意。 citeturn11view2
存储的核心不是“容量”,而是“吞吐路径”
推荐把数据分三层:
Cold / Durable
对象存储
COS / S3-like
        ↓
Warm
共享文件系统 / 分布式 Cache
CFS / GooseFS
        ↓
Hot
Local NVMe / Memory Cache
对象存储适合低成本、持久保存训练集、Checkpoint 和模型 Artifact;共享文件系统方便多节点统一访问;本地 NVMe 适合 Epoch 内重复访问的数据缓存。腾讯云 HCC 官方也将 COS、CFS 和本地 NVMe 作为不同层次的数据存储能力。citeturn11view2
真正需要观察的指标不是单纯“磁盘有多少 TB”,而是:
dataset read GB/s
metadata ops/s
checkpoint write GB/s
startup time
cache hit ratio
GPU data stall time
如果 GPU 每个 Step 都在等待 DataLoader,那么即使买了更昂贵的 GPU 也无法提高有效训练速度。
训练软件栈
建议把训练软件栈拆成:
Model Code
   ↓
PyTorch / JAX
   ↓
FSDP / DeepSpeed / Megatron-like Parallelism
   ↓
NCCL / Collective Runtime
   ↓
CUDA / ROCm / Accelerator Runtime
   ↓
GPU
PyTorch FSDP2 当前可以把参数以 DTensor 形式分片,Tensor Parallel API 则支持按用户定义的 Parallel Plan 对模型实施张量并行。DeepSpeed ZeRO-3 能对完整模型状态进行分片,在超出显存范围时还可以结合 CPU/NVMe Offload。citeturn8view0turn8view1turn8view2turn6view3
一个常见的大模型并行关系可以写成:
[ N_{GPU}
DP \times TP \times PP \times EP ]
例如:
DP = 8
TP = 4
PP = 2

总 GPU = 8 × 4 × 2 = 64
但这不是越复杂越好。并行维度越多,通信路径、负载不均衡和故障恢复就越复杂。小模型首先采用 DP/FSDP,只有单模型已经明显超出单节点能力时再引入 TP、PP 或 EP,通常更容易维护。
推理软件栈
目前可以将常见推理方案粗略理解为:
框架 | 适合场景 | 特点 |
|---|---|---|
vLLM | 通用 LLM Serving | PagedAttention、连续批处理、Prefix Cache、Chunked Prefill citeturn14search8 |
SGLang | LLM/VLM 与复杂生成工作负载 | RadixAttention、Prefix Cache、多硬件支持 citeturn9search1 |
TensorRT-LLM | NVIDIA 深度优化 | FP8/FP4、Paged KV Cache、Speculative Decoding 等 citeturn9search6 |
NVIDIA Dynamo | 大规模分布式推理 | P/D 分离、路由、多节点推理、KV 管理 citeturn9search7turn9search15 |
TI-ONE/TACO | 腾讯云托管场景 | 一体化模型服务、P/D 分离和推理优化;性能数字应视作厂商测试结果 citeturn11view0 |
运维体系
生产环境至少需要同时监控四层:
L1 Hardware
GPU utilization
HBM usage
temperature
power
ECC / hardware errors

L2 Runtime
NCCL latency
OOM
CUDA errors
KV cache usage

L3 Model
tokens/s
TTFT
TPOT
batch size
queue length

L4 Service
QPS
P50/P95/P99
HTTP error
timeout
SLO
腾讯云 TKE 可以与 Prometheus 监控体系关联,TI-ONE 自身则接入腾讯云监控和日志体系。citeturn23search11turn11view0
模型从 Git 到线上环境则建议采用不可变 Artifact:
flowchart LR
    A[Git Commit] --> B[Unit Test]
    B --> C[Build Container]
    C --> D[Image Scan]
    D --> E[Push Registry]
    E --> F[Staging Deployment]
    F --> G[Offline Evaluation]
    G --> H[Security Evaluation]
    H --> I{Gate}
    I -->|Pass| J[Canary]
    I -->|Fail| K[Reject]
    J --> L[Production]
    L --> M[Monitoring]
    M --> N{SLO / Quality OK?}
    N -->|Yes| L
    N -->|No| O[Rollback]
生产环境最好同时记录:
git_commit
container_digest
model_id
model_hash
dataset_version
training_config
evaluation_report
deployment_version
operator
timestamp
这样才能做到“线上这个回答究竟来自哪个模型、哪个数据集、哪次训练、哪个镜像”的完整追溯。
实践指南与完整训练、推理示例
从小规模到大规模的演进路径
不建议一开始就建设“大而全”的 AI 平台。更合理的路径是逐级增加复杂度。
阶段 | 推荐规模 | 基础设施 | 重点 |
|---|---|---|---|
PoC(Proof of Concept) | 1~4 GPU | VM + 对象存储 | 先验证模型与业务 |
团队级 | 4~32 GPU | Kubernetes + GPU 节点池 | 镜像、Quota、任务调度 |
生产级 | 32~128 GPU | 独立训练/推理池 + MLOps | HA、监控、安全、成本 |
大规模 | 128+ GPU | RDMA、高速存储、拓扑感知调度 | goodput、Checkpoint、故障恢复 |
超大规模 | 数百~数千加速器 | Rack-scale + 高速 Fabric | 网络拓扑、作业弹性与资源治理 |
Kubernetes 的控制面负责管理 Worker Node 和 Pod,因此当 AI 工作负载进入团队级以上规模时,用 Kubernetes 管理资源池通常比让每个算法工程师直接持有 VM 更容易建立配额、镜像和部署规范。citeturn21search20 腾讯云 TKE 当前还提供 GPU 调度、AI 工作负载以及相关云原生资源管理能力。citeturn2search5
完整训练示例:8 卡大模型监督微调
下面给出一个云厂商无关的参考流水线。运行环境可以是腾讯云 TKE、TI-ONE 自定义训练环境,也可以是其他 Kubernetes/GPU 平台。
目标:
Base Model
   ↓
Dataset
   ↓
Tokenization
   ↓
8-GPU Distributed Training
   ↓
Checkpoint
   ↓
Evaluation
   ↓
Model Registry
建议环境:
GPU: 8 × 40~80 GB
CPU: 64+ vCPU
RAM: 256+ GB
共享存储: ≥ 1 TB
本地 NVMe: 建议用于数据 Cache
网络: 单机 8 卡可先不要求 RDMA;跨机训练建议高速 RDMA 网络
下面以 DeepSpeed ZeRO-3 为例。ZeRO-3 会进一步对模型参数进行分片,降低各 GPU 的模型状态冗余。citeturn6view3
ds_config.json:
{
  "bf16": {
    "enabled": true
  },
  "zero_optimization": {
    "stage": 3,
    "overlap_comm": true,
    "contiguous_gradients": true,
    "reduce_scatter": true,
    "stage3_gather_16bit_weights_on_model_save": true
  },
  "gradient_accumulation_steps": 8,
  "gradient_clipping": 1.0,
  "train_micro_batch_size_per_gpu": 1,
  "steps_per_print": 20,
  "wall_clock_breakdown": false
}
训练目录:
train/
├── train.py
├── ds_config.json
├── data/
│   ├── train.jsonl
│   └── valid.jsonl
└── output/
示例 train.py:
import os

from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    Trainer,
    TrainingArguments,
    DataCollatorForLanguageModeling,
)

MODEL_PATH = os.environ.get("MODEL_PATH", "/models/base-model")
DATA_PATH = os.environ.get("DATA_PATH", "./data/train.jsonl")
OUTPUT_DIR = os.environ.get("OUTPUT_DIR", "./output")

tokenizer = AutoTokenizer.from_pretrained(
    MODEL_PATH,
    trust_remote_code=False,
)

if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForCausalLM.from_pretrained(
    MODEL_PATH,
    torch_dtype="auto",
    trust_remote_code=False,
)

# 降低训练阶段 Activation 显存压力。
model.gradient_checkpointing_enable()

dataset = load_dataset(
    "json",
    data_files={"train": DATA_PATH},
)["train"]

def tokenize(batch):
    return tokenizer(
        batch["text"],
        truncation=True,
        max_length=2048,
    )

dataset = dataset.map(
    tokenize,
    batched=True,
    remove_columns=dataset.column_names,
)

args = TrainingArguments(
    output_dir=OUTPUT_DIR,
    num_train_epochs=1,
    per_device_train_batch_size=1,
    gradient_accumulation_steps=8,
    learning_rate=2e-5,
    logging_steps=10,
    save_steps=500,
    save_total_limit=2,
    bf16=True,
    deepspeed="./ds_config.json",
    report_to="none",
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=dataset,
    data_collator=DataCollatorForLanguageModeling(
        tokenizer=tokenizer,
        mlm=False,
    ),
)

trainer.train()
trainer.save_model(OUTPUT_DIR)
tokenizer.save_pretrained(OUTPUT_DIR)
启动:
export MODEL_PATH=/models/base-model
export DATA_PATH=/data/train.jsonl
export OUTPUT_DIR=/output/model-v1

deepspeed \
  --num_gpus=8 \
  train.py
在生产环境中,不应只运行上面的训练命令,还需要生成训练 Manifest:
model:
  base_model: "base-model"
  base_model_revision: "sha256:REPLACE_ME"

dataset:
  name: "internal-sft-dataset"
  version: "2026-10-01"
  license_verified: true
  pii_reviewed: true

training:
  precision: "bf16"
  sequence_length: 2048
  global_batch_size: 64
  optimizer: "adamw"
  learning_rate: 0.00002
  deepspeed_stage: 3

artifact:
  output: "model-v1"
  git_commit: "REPLACE_ME"
  container_digest: "sha256:REPLACE_ME"
这份 Manifest 的价值不是“方便看参数”,而是为审计提供一个稳定事实:
Model V1
= BaseModel@Revision
+ Dataset@Version
+ Code@Commit
+ Container@Digest
+ TrainingConfig
训练资源与成本示例
由于实际 GPU 价格受到地域、卡型、购买模式影响,下面故意采用假设价格,只演示计算方法。
假设:
GPU 数量                 = 8
训练时长                 = 12 h
假设有效 GPU 单价        = ¥20 / GPU·h
存储、日志等假设费用     = ¥180
失败重跑预算 Reserve     = 20%
则:
[ 8\times12\times20=1920 ]
基础任务成本:
[ 1920+180=2100\ 元 ]
加入 20% 重跑预算:
[ 2100\times1.2=2520\ 元 ]
所以该任务的预算估计约 ¥2,520。
这只是教学数字,并非腾讯云报价。腾讯云 TI-ONE 的实际费用还可能包含底层 CVM、平台订阅、COS/CFS、日志、监控等项目。citeturn11view0
进一步,建议不要只计算:
¥ / training run而要记录:
¥ / successful run
¥ / billion training tokens
tokens / GPU second
GPU utilization
failure rate
checkpoint overhead
例如:
任务 A:
成本 ¥2,000
成功率 50%

任务 B:
成本 ¥2,500
成功率 95%
长期看,任务 B 很可能才是更便宜的系统。
训练常见性能问题
问题 | 现象 | 排查顺序 |
|---|---|---|
DataLoader 太慢 | GPU 周期性掉到低利用率 | CPU → 文件系统 → 数据格式 → Cache |
通信瓶颈 | 多卡效率明显低于单卡 | NCCL → 拓扑 → RDMA → TP/DP 配置 |
OOM(Out Of Memory) | Forward/Backward 失败 | Sequence → Batch → Checkpointing → FSDP/ZeRO |
Checkpoint 太慢 | 每次 Save 停几十秒甚至更多 | 并发写 → 本地 NVMe → 异步上传 |
Straggler | 某些 Rank 明显更慢 | GPU 健康 → 网络 → 数据不均衡 |
GPU 空闲 | 作业排队但资源碎片化 | Gang Scheduling → GPU Pool → Quota |
当任务已经进入多节点阶段,网络与拓扑问题的重要性会快速上升,因此 HCC/RDMA 一类基础设施才真正开始体现价值。citeturn11view2
完整推理示例:vLLM + Kubernetes/TKE
目标架构:
Internet / Internal Client
          ↓
      API Gateway
          ↓
      Kubernetes Service
          ↓
        vLLM Pod
          ↓
        GPU
          ↓
      Model Storage
vLLM 当前支持 PagedAttention、Continuous Batching、Prefix Caching 和 Chunked Prefill 等机制。citeturn14search8
生产环境不要直接使用 latest 标签,应该固定经过验证的镜像版本:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: llm-v1
  namespace: ai-serving
spec:
  replicas: 1
  selector:
    matchLabels:
      app: llm-v1
  template:
    metadata:
      labels:
        app: llm-v1
    spec:
      containers:
        - name: vllm
          image: vllm/vllm-openai:<PINNED_TESTED_VERSION>

          command:
            - vllm
            - serve
            - /models/my-model

          args:
            - --host
            - "0.0.0.0"
            - --port
            - "8000"
            - --dtype
            - auto
            - --max-model-len
            - "8192"
            - --gpu-memory-utilization
            - "0.90"
            - --enable-prefix-caching

          ports:
            - containerPort: 8000

          resources:
            limits:
              nvidia.com/gpu: "1"
              cpu: "16"
              memory: "64Gi"
            requests:
              nvidia.com/gpu: "1"
              cpu: "8"
              memory: "32Gi"

          volumeMounts:
            - name: model
              mountPath: /models
              readOnly: true

      volumes:
        - name: model
          persistentVolumeClaim:
            claimName: llm-model-pvc
Service:
apiVersion: v1
kind: Service
metadata:
  name: llm-service
  namespace: ai-serving
spec:
  selector:
    app: llm-v1
  ports:
    - name: http
      port: 80
      targetPort: 8000
  type: ClusterIP
部署:
kubectl apply -f deployment.yaml
kubectl apply -f service.yaml

kubectl -n ai-serving get pods -w
测试:
kubectl -n ai-serving port-forward service/llm-service 8000:80然后:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "/models/my-model",
    "messages": [
      {
        "role": "user",
        "content": "请用一句话解释什么是 AI Infra。"
      }
    ],
    "temperature": 0.2,
    "max_tokens": 128
  }'
在真正的腾讯云生产环境中,可以再把它升级成:
CLB / API Gateway
        ↓
TKE Service
        ↓
Inference Pods
        ↓
GPU Node Pool
TKE 当前提供节点池、GPU 资源管理及与云上负载均衡、监控体系集成的能力。citeturn23search23turn23search31turn23search35
推理容量怎么计算
假设一个 GPU:
平均生成速度        = 800 output token/s
平均每请求输出       = 200 token
理论最大吞吐大致为:
[ 800 / 200=4\ requests/s ]
但不能直接把这个数字当生产容量,因为真实系统还存在:
Prefill
Queue
Batching
KV Cache
Network
Serialization
Prompt length variance
P99 latency requirement
因此生产环境更合理的容量测试是:
固定模型
固定 GPU
固定 context distribution
固定 output distribution

逐渐增加 QPS
       ↓
观察 TTFT / TPOT / P99
       ↓
找到 SLO 拐点
       ↓
设置安全余量
推理基准测试至少应同时记录:
Input tokens/s
Output tokens/s
Request/s
TTFT P50/P95/P99
TPOT P50/P95/P99
GPU HBM
KV cache utilization
Queue time
GPU utilization
只公布 “tokens/s” 而不说明模型、输入输出比例、并发和延迟条件,通常不具备真正的横向比较意义。
推理成本示例
假设:
GPU 单价              = ¥12 / GPU·h
单副本 GPU            = 1
运行时间              = 720 h/月
存储、LB、日志等       = ¥600/月
单副本:
[ 12\times720+600 =9240\ 元/月 ]
如果生产要求两个副本,则简单估算:
[ 2\times12\times720+1200 =18480\ 元/月 ]
但真正应该计算的是:
[ CostPerMillionTokens
\frac{MonthlyCost} {MonthlyOutputTokens/10^6} ]
例如月成本 ¥18,480,实际输出 5 亿 Token:
[ 18480/500
36.96\ 元/百万输出Token ]
这比“GPU 一小时多少钱”更接近业务真正需要的成本指标。
推理调优顺序
实际工程中,不建议一开始就启用所有高级优化。更合理的顺序是:
Baseline
 ↓
Continuous Batching
 ↓
KV Cache 调优
 ↓
Prefix Cache
 ↓
Quantization
 ↓
Tensor Parallel
 ↓
Speculative Decoding
 ↓
P/D Disaggregation
 ↓
Multi-node KV Cache
每增加一项能力,都应该重新测试:
quality
throughput
TTFT
TPOT
P99
memory
cost
failure rate
否则非常容易出现“峰值吞吐提高了,但 P99 延迟更差”或者“单卡 Token 变多,但模型质量下降”的情况。
安全、合规与腾讯云社区发布模板
这一部分对于准备在中国大陆技术社区公开发表文章尤其重要。
首先需要明确:**技术文章介绍 AI Infra 本身,并不意味着作者就是生成式人工智能服务提供者。**但是,如果文章、图片或其他公开内容实际使用人工智能生成或合成,则还需要考虑生成合成内容的声明和标识要求。具体义务应根据发布主体、服务形态和平台规则判断。
中国现行《生成式人工智能服务管理暂行办法》适用于利用生成式人工智能技术向境内公众提供生成文本、图片、音频、视频等内容的服务;企业、科研机构等仅内部研发或使用而未向境内公众提供生成式 AI 服务的情形,不属于该办法第二条所述适用范围。citeturn20view0
对于面向公众的生成式 AI 服务,训练数据处理需要特别注意数据合法来源、知识产权和个人信息。该办法明确要求训练数据具有合法来源,涉及知识产权的不得侵害相关权益,涉及个人信息时应取得同意或具有其他合法处理依据,并采取措施提高训练数据质量。citeturn20view0
对于用户输入和服务日志,《生成式人工智能服务管理暂行办法》还要求依法履行保护义务,不得收集非必要个人信息,不得非法留存能够识别用户身份的输入信息和使用记录,并应依法处理个人查阅、更正、删除等请求。citeturn20view0
《网络数据安全管理条例》已自 2025 年 1 月 1 日起施行,其中进一步强调网络数据分类分级、安全管理制度、安全风险报告、安全事件处置、个人信息保护以及重要数据管理。citeturn20view3
此外,2025 年发布的《人工智能生成合成内容标识办法》已于 2025 年 9 月 1 日起施行,明确区分显式标识和隐式标识,并对文本、图片、音频、视频及虚拟场景等生成合成内容提出相应标识要求;其第十条同时要求用户通过网络信息内容传播服务发布生成合成内容时主动声明,并使用服务提供者提供的标识功能。citeturn20view1
因此,技术社区文章采用 AI 辅助整理、配图或生成内容时,一个稳妥的工程实践是:按平台提供的 AI 内容声明机制如实标注,并在文章中明确 AI 的实际参与范围。
推荐直接加入以下声明:
> **生成式人工智能使用说明**
>
> 本文部分资料整理、结构梳理或语言润色过程使用了生成式人工智能工具辅助。
> 文中的技术结论、代码示例、引用来源及合规相关内容均由作者进行人工复核。
> 如文中包含人工智能生成或合成的图片、文本等内容,将按照适用法律法规及发布平台要求进行相应声明或标识。
数据合规检查表
环节 | 最低要求 | 依据 |
|---|---|---|
数据采集 | 明确来源、授权和用途 | 生成式 AI 办法第七条 citeturn20view0 |
个人信息 | 最小必要、合法处理依据 | 生成式 AI 办法第七、十一条 citeturn20view0 |
Dataset | 保存版本、来源和 License | 数据可追溯的工程要求 |
重要数据 | 分类分级、识别和管理 | 网络数据安全管理条例 citeturn20view3 |
数据出境 | 判断安全评估、标准合同等条件 | 数据跨境流动规定 citeturn17search26 |
删除 | 建立 Dataset/日志删除机制 | 数据生命周期治理要求 |
Audit | 训练和数据操作留痕 | 安全治理最佳实践 |
对于跨境数据,《促进和规范数据跨境流动规定》自 2024 年 3 月发布实施,并进一步明确了数据出境安全评估、个人信息出境标准合同及个人信息保护认证等制度的适用方式,同时规定未被相关地区或部门明确告知或公开发布为重要数据的,不需要直接将其作为重要数据申报出境安全评估。具体业务仍应根据数据类别、数量、主体性质和适用规则进行判断。citeturn17search26
值得注意的是,《中华人民共和国网络安全法》在 2025 年完成修改,并自 2026 年 1 月 1 日起施行修改后的版本;本次修订新增了对人工智能基础理论、算法、训练数据资源、算力基础设施、伦理规范、风险监测评估和安全监管的相关表述,同时更新了部分网络安全责任及法律责任条款。citeturn18search9turn18search23
面向公众提供生成式 AI 服务时的额外判断
需要回答:
是否向境内公众提供生成式 AI 服务?
              │
       ┌──────┴──────┐
       │             │
      否             是
       │             │
内部研发治理      是否具舆论属性
                 或社会动员能力?
                      │
                ┌─────┴─────┐
                │           │
               否           是
                │           │
           常规合规治理   进一步判断
                         安全评估 /
算法备案等《生成式人工智能服务管理暂行办法》第十七条明确规定,提供具有舆论属性或者社会动员能力的生成式人工智能服务时,应按相关国家规定开展安全评估,并履行算法备案及变更、注销备案等手续。citeturn20view0
这也是为什么企业开发一个“内部研发助手”和上线一个“全国公众均可访问的生成式 AI 服务”,不能使用完全一样的合规检查表。
模型安全要覆盖的不只是 Prompt Injection
一个完整的模型安全面至少包括:
风险 | 典型攻击面 | 防御 |
|---|---|---|
数据投毒 | Training Dataset | 来源审核、Hash、版本控制 |
模型供应链 | Weight / Container | Digest、签名、扫描 |
Secret 泄漏 | Prompt / Log | Secret Manager、脱敏 |
Prompt Injection | RAG / Agent | 输入隔离、工具权限、策略层 |
Model Extraction | Public API | Rate Limit、认证、异常检测 |
Abuse | Generation API | 内容安全、审计、限流 |
权限越界 | Agent Tools | 最小权限 |
模型篡改 | Model Registry | 不可变 Artifact、签名 |
数据泄漏 | Logs / Traces | 日志分类和脱敏 |
DoS | Long Context | Token Limit、Quota、Queue |
Microsoft 2026 年数字防御报告也将 AI 系统的输入、模型数据和权重、Serving Infrastructure、用户数据和输出视为潜在攻击目标。citeturn21search30
可解释性在基础设施层应该怎么做
基础设施本身无法保证一个大语言模型具有严格意义上的“可解释性”,但可以确保结果可以追溯:
Request ID
 ↓
User / Tenant
 ↓
Model Version
 ↓
System Policy Version
 ↓
Prompt Template Version
 ↓
RAG Documents
 ↓
Generation Parameters
 ↓
Output
 ↓
Safety Decision
 ↓
Human Review
因此对企业而言,比“模型能不能解释每一个神经元”更现实的第一步是:
系统能否解释“为什么这一次请求使用了这个模型、这些数据、这些配置,并最终返回这个结果”。
责任分配
推荐采用 RACI(Responsible, Accountable, Consulted, Informed)模型:
工作 | 数据负责人 | 模型团队 | 平台团队 | 安全团队 | 合规/法务 | 业务负责人 |
|---|---|---|---|---|---|---|
数据授权 | A/R | C | I | C | C | I |
训练代码 | I | A/R | C | C | I | I |
GPU 平台 | I | C | A/R | C | I | I |
模型评测 | C | A/R | C | C | C | C |
上线审批 | I | R | R | C | C | A |
安全事件 | I | C | R | A/R | C | I |
数据泄漏 | A/R | C | C | R | C | I |
其中:
R = Responsible,执行者
A = Accountable,最终负责者
C = Consulted,需要咨询
I = Informed,需要知会
适合腾讯云技术社区文章的合规声明模板
下面这段可以直接放在文章结尾:
### 免责声明与合规说明

本文仅用于技术学习与工程实践交流,不构成法律意见、投资建议、
采购建议、产品承诺或任何形式的官方性能保证。

文中涉及腾讯云及其他厂商产品的功能、规格、地域可用性和计费方式,
均可能随产品迭代发生变化,请以各厂商最新官方文档、控制台及合同为准。

文中的成本数字如未明确标注为官方价格,均属于教学性质的假设性测算,
不代表腾讯云或任何其他厂商的实际报价。

本文涉及的模型、数据集、代码、软件包及第三方组件,
在实际使用前应自行确认其许可证、知识产权、数据来源、
个人信息保护及商业使用条件。

如将相关技术用于面向公众的生成式人工智能服务,
应根据实际业务形态遵守适用的网络安全、数据安全、
个人信息保护、生成式人工智能服务及人工智能生成合成内容标识等相关要求。

本文部分资料整理、结构梳理或文字润色过程可能使用生成式人工智能工具辅助,
相关技术结论、示例代码及引用资料均应由发布者进行人工复核;
涉及人工智能生成合成内容时,应按照适用法律法规及发布平台规则进行声明或标识。

本文不代表腾讯云官方立场。
这一模板的目的不是通过一句“免责声明”替代法律义务,而是明确文章性质、价格边界、第三方许可边界和 AI 辅助使用情况。对于生成合成内容,真正需要做的仍然是按照适用规则执行相应声明与标识。citeturn20view1
发布前最后检查
最值得检查的不是文风,而是下面这些风险点:
□ 是否把厂商测试数字写成普遍事实?
□ 是否把示例成本误写成官方报价?
□ 是否引用了来源不明的数据集?
□ 是否展示真实 AccessKey / Token / IP?
□ 是否包含真实客户数据或个人信息?
□ 是否把未经验证的模型输出写成事实?
□ 是否明确 AI 辅助生成情况?
□ 外部图片是否拥有合理使用或转载条件?
□ 开源代码是否说明许可证边界?
□ 是否把产品路线图写成已经正式 GA 的能力?
□ 是否检查链接与产品名称仍然有效?
其中 GA(General Availability)代表产品进入正式普遍可用阶段。对 Preview、Beta 和 GA 状态一定要明确区分,尤其是在涉及云产品采购和生产架构时。
架构决策、性能调优与成本治理方法
理解 AI Infra 最容易犯的错误,是把各种工具记成一张清单:
GPU
Kubernetes
Ray
DeepSpeed
vLLM
Prometheus
...
真正的工程能力不是“知道所有工具”,而是能从瓶颈反推架构。
可以使用下面这个决策模型:
flowchart TD

    A[业务需求] --> B{训练还是推理?}

    B -->|训练| C[模型大小 / Token / 时限]
    B -->|推理| D[QPS / TTFT / TPOT / Context]

    C --> E{单卡能否容纳?}
    E -->|能| F[单卡/DP]
    E -->|不能| G[FSDP / ZeRO]

    G --> H{单节点能否完成?}
    H -->|能| I[Node-local NVLink]
    H -->|不能| J[RDMA + Multi-node]

    D --> K{单卡能否容纳模型 + KV?}
    K -->|能| L[vLLM / SGLang Single GPU]
    K -->|不能| M[TP / Quantization]

    M --> N{规模是否足够大?}
    N -->|否| O[Co-located Prefill/Decode]
    N -->|是| P[评估 P/D Disaggregation]

    F --> Q[Benchmark]
    I --> Q
    J --> Q
    L --> Q
    O --> Q
    P --> Q

    Q --> R[Cost + SLO + Reliability]
这个决策树背后有一个重要原则:
每增加一个分布式维度,都应该有一个明确的物理瓶颈作为理由。
例如:
因为单卡显存不够
→ 引入 FSDP

因为单节点显存仍不够
→ 引入 TP/PP

因为网络通信成为瓶颈
→ 升级 RDMA / topology

因为 Decode 被长 Prompt Prefill 阻塞
→ 考虑 P/D 分离
而不是:
“这个技术最近很热门”
→ 直接上生产
DistServe 的研究说明 P/D 分离确实可以解决 Prefill 和 Decode 相互干扰的问题,但也正因如此,它最适合真正存在这类资源干扰和规模需求的工作负载。citeturn21search0
GPU 利用率不是唯一 KPI(Key Performance Indicator)
例如:
GPU Utilization = 95%并不必然意味着系统很好。
可能出现:
GPU Util = 95%
但:
TTFT = 15s
P99 = 60s
Queue = 10000 requests
对于推理系统,这显然不是好的生产状态。
反过来:
GPU Util = 70%
TTFT = 300ms
TPOT = 20ms
SLO = 99.9% achieved
对于低延迟业务反而可能是合理结果。
因此建议采用多维指标:
场景 | 一级指标 |
|---|---|
Pre-training | tokens/s、MFU、失败率 |
SFT | samples/s、tokens/s、训练成本 |
在线推理 | TTFT、TPOT、P99、QPS |
Batch 推理 | tokens/s/GPU |
平台 | GPU 利用率、排队时间 |
成本 | Cost / million tokens |
稳定性 | SLO、MTTR |
数据 | Pipeline latency、读取吞吐 |
MFU(Model FLOPs Utilization)用于衡量模型实际计算与硬件理论计算能力之间的利用程度;MTTR(Mean Time To Recovery)表示平均恢复时间。
为什么 GPU 空闲率是最大的隐性成本之一
假设:
100 张 GPU
有效利用率 = 40%
从经济意义上看,相当于大量付费时间没有转换成训练或推理产出。
因此 AI FinOps 优先级通常应该是:
减少 Idle
    ↓
减少 Failed Jobs
    ↓
提高 Batching
    ↓
提高 Cache Hit
    ↓
合理使用 Spot
    ↓
再谈购买更便宜的 GPU
腾讯云 TI-ONE 提供优先级、抢占、训练/推理潮汐调度以及 GPU 虚拟化等机制,其核心价值也可以理解为减少资源碎片和空闲。citeturn11view0
一个实用的成本 Dashboard 应该长这样
Cluster Cost
│
├── Training
│   ├── GPU Hours
│   ├── Cost / Billion Tokens
│   ├── Failed Job Cost
│   └── Idle GPU Cost
│
├── Inference
│   ├── Cost / Million Tokens
│   ├── Cost / Request
│   ├── Cost / Tenant
│   └── Cache Saving
│
├── Storage
│   ├── Dataset
│   ├── Checkpoint
│   └── Logs
│
└── Network
    ├── Cross-zone
    ├── Internet
    └── Model Distribution
最终应该可以回答类似的问题:
“模型 A 每个月为什么花 ¥100 万?”
而不是只得到:
“因为我们用了很多 GPU。”
AI Infra 的成熟度模型
可以把企业平台分成五个阶段:
等级 | 特征 |
|---|---|
L0 | SSH(Secure Shell)上机器手动训练 |
L1 | Docker + GPU VM |
L2 | Kubernetes + Job + Model Serving |
L3 | Training Pipeline + Registry + Evaluation + Observability |
L4 | 自动调度、自动评测、FinOps、安全与合规治理 |
L5 | 多集群、异构算力、P/D 分离、动态资源编排、自动故障恢复 |
绝大多数团队真正需要的目标通常是 L3~L4,而不是一上来追求 L5。
这也是 AI Infra 架构最重要的一条原则:
基础设施的价值不在复杂,而在把模型研发过程中的不确定性变成可重复、可观测、可审计、可扩展和可计算成本的工程系统。
参考资料与链接
以下资料以官方产品文档、政府法规页面、开源项目官方文档和学术论文为主。产品与法规可能持续更新,阅读时应注意页面发布日期和最新修订状态。
腾讯云与国内云平台
- 腾讯云大模型训推平台 TI-ONE — 训练、模型管理、评测、在线服务、GPU 调度、P/D 分离与推理加速。citeturn11view0
- 腾讯云容器服务 TKE 文档 — Kubernetes、GPU 资源管理、节点池与云原生 AI 基础设施。citeturn23search35
- 腾讯云 TKE 创建节点池 — AI/GPU 节点池相关管理。citeturn23search23
- 阿里云人工智能平台 PAI 官方文档 — DSW、DLC、EAS 等开发、训练和部署链路。citeturn23search9
- 华为云 ModelArts — 模型开发、训练和部署平台。citeturn22search6
国际云厂商与硬件
- Google Cloud AI Hypercomputer — Google Cloud AI 基础设施整体架构。citeturn15search0
- AWS Trainium — Trainium、Neuron、EFA、EKS 与 HyperPod。citeturn14search1
- Azure ND GB200 v6 — GB200 NVL72 云端机架级 GPU 架构。citeturn15search1
- NVIDIA GB200 NVL72 — Blackwell 机架级系统。
- AMD Instinct MI300X — 192 GB HBM3 GPU。citeturn3search2
训练与分布式软件
- PyTorch Documentation — PyTorch Distributed、FSDP2、Tensor Parallel 等能力。citeturn7view0turn8view0
- DeepSpeed ZeRO — ZeRO Stage 1/2/3 与 Offload 机制。citeturn6view3
- Ray Documentation — 分布式计算以及 KubeRay 云原生部署。citeturn5search7
大模型推理
- vLLM Documentation — PagedAttention、Continuous Batching、Prefix Caching、Chunked Prefill。citeturn14search8
- SGLang Documentation — RadixAttention、Prefix Cache 与多硬件推理。citeturn9search1
- NVIDIA TensorRT-LLM — FP8/FP4、KV Cache、Speculative Decoding 等。citeturn9search6
- NVIDIA Dynamo — 分布式推理、P/D 分离和 KV Cache 管理。citeturn9search3turn9search7
学术论文与研究
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving, OSDI 2024 — P/D 分离推理的代表性论文。citeturn21search0
- DistServe arXiv — 论文预印本。citeturn21search19
- vLLM Project — PagedAttention 与高吞吐大模型 Serving。citeturn14search0
中国 AI、数据与网络安全法规
- 《生成式人工智能服务管理暂行办法》 — 国家互联网信息办公室等,2023 年发布。citeturn20view0
- 《人工智能生成合成内容标识办法》 — 2025 年 9 月 1 日起施行。citeturn20view1
- 《网络数据安全管理条例》相关官方说明 — 2025 年 1 月 1 日起施行。citeturn20view3
- 《促进和规范数据跨境流动规定》 — 数据跨境制度。citeturn17search26
- 全国人大常委会关于修改《中华人民共和国网络安全法》的决定 — 修改后的相关规定自 2026 年 1 月 1 日起施行。citeturn18search9
安全治理与通用框架
- NIST AI Risk Management Framework — NIST(National Institute of Standards and Technology)AI 风险管理框架。citeturn23search20
- OECD AI Principles — OECD(Organisation for Economic Co-operation and Development)AI 原则,2024 年更新。citeturn23search12
- AWS Shared Responsibility Model — 云计算共享责任模型的代表性官方说明。citeturn22search3
能源与成本视角
- IEA Energy and AI — IEA(International Energy Agency)关于 AI、数据中心与能源需求的专题研究。citeturn23search4
最终发布声明: 本文以 2026 年 10 月 3 日为资料基线。AI 基础设施是高速迭代领域,硬件规格、开源软件版本、云产品功能、价格以及适用监管要求均可能发生变化。读者在实际生产部署、采购或面向公众提供生成式人工智能服务前,应结合最新官方产品文档、软件 Release Note、适用法律法规以及自身业务场景重新核验。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号