用 WorkBuddy 零成本搭 A 股自动盯盘流水线:腾讯行情 + 东财接口实战,附 5 个接口坑的排查过程
原创
用 WorkBuddy 零成本搭 A 股自动盯盘流水线:腾讯行情 + 东财接口实战,附 5 个接口坑的排查过程
原创
用户12800487
发布于 2026-10-04 21:23:54
发布于 2026-10-04 21:23:54
用 WorkBuddy 零成本搭 A 股自动盯盘流水线:腾讯行情 + 东财接口实战,附 5 个接口坑的排查过程
本文所有命令、接口 URL、参数与输出均来自本机真实脚本与真实请求,逐条复跑验证过;文中股票仅作接口演示样例,不构成任何投资建议。
一、背景与痛点
我平时会跟踪一组 A 股标的,每天收盘后的流程是:打开行情软件 → 逐个抄收盘价、涨跌幅、成交额、换手率 → 再切到资金流页面看主力净流入 → 手算均线、ATR、止损止盈位。一套下来 15–20 分钟,而且纯机械劳动。
我试过两轮"偷懒",都失败了:
第一轮:直接问大模型。 得到的数字经常是估算值,甚至凭记忆编出来的。我的硬要求是可验证——每个数字都要能回到一手来源核对,所以这条路直接否掉。
第二轮:上量化数据源。 要钱、要注册、要配额,为了每天几只票的几十个字段不值当。
最后定下来的思路很朴素:把"取数"和"解读"彻底拆开。取数这件事不该由模型做——它是确定性的、可脚本化的、跑一次一分钱不花;模型应该只做它擅长的事:读结构化数据、做交叉验证、出结论。
于是我让 WorkBuddy 帮我写了两个纯标准库 Python 脚本,再挂到定时任务上。下面是完整过程,重点是踩过的 5 个坑。
下文演示用的是 4 只公开大市值标的,按行情页板块归属分别为家电零部件、电子元件、消费电子、工业金属四个方向:三花智控 002050、鹏鼎控股 002938、立讯精密 002475、紫金矿业 601899。换成你自己的代码,脚本一行不用改。
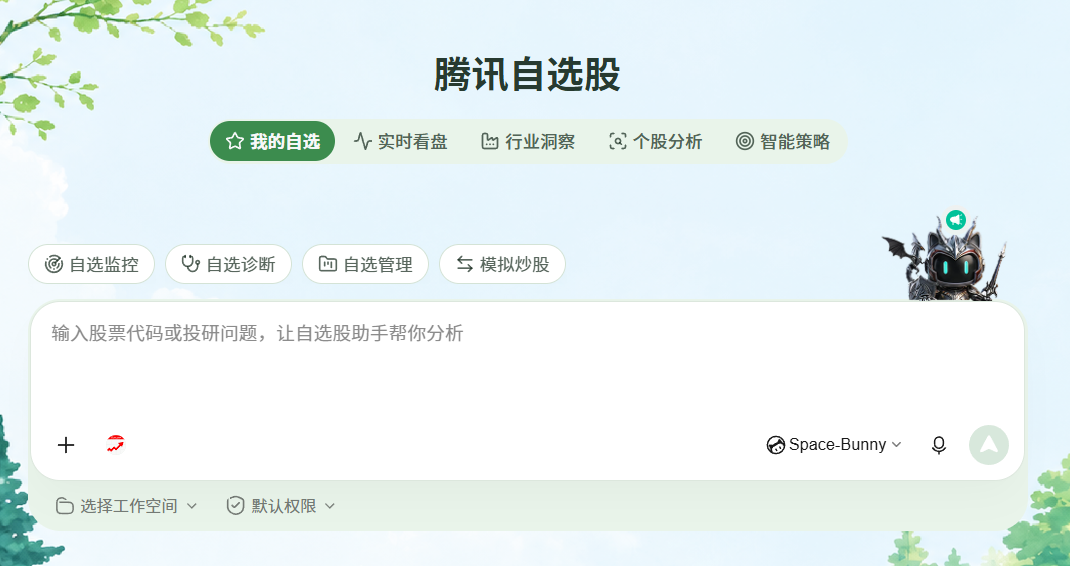
图 1:WorkBuddy 客户端的自选股工作空间首页。顶部是功能页签(我的自选 / 实时看盘 / 行业洞察 / 个股分析 / 智能策略),中部是四个快捷入口(自选监控 / 自选诊断 / 自选管理 / 模拟炒股),底部是对话输入框与模型、工作空间选择器(Space-Bunny)。本文的两个脚本和定时任务都跑在这个客户端里——每天收盘后由任务把脚本结果读进来,交叉校验后生成简报。
二、整体架构
一句话:取数走脚本,解读走模型,口径走文件。
腾讯 qt.gtimg.cn        → 行情快照(收盘价/涨跌幅/成交额/换手率/量比)
腾讯 web.ifzq.gtimg.cn  → 前复权日 K(算 MA / ATR / 前高前低)
东财 push2 ulist.np/get → 个股资金流(主力/超大单/大单/中单/小单)
        ↓
  两个纯标准库 Python 脚本(无第三方依赖)
        ↓
      JSON 输出
        ↓
  WorkBuddy 读取 → 交叉校验 → 生成简报 → 定时任务每日 16:00 触发
三个数据源全免费、无需鉴权,脚本只用 urllib + json,本机 Python 直接跑。
三、具体做法
3.1 行情快照:腾讯 qt.gtimg.cn
我给 WorkBuddy 的要求是"只用标准库、输出 JSON、失败要能定位到具体哪只票"。产出在 .workbuddy/tools/fetch_quotes.py:
UA = {"User-Agent": "Mozilla/5.0", "Referer": "https://gu.qq.com/"}

def market(code):
    return ("sh" if code.startswith(("6", "5", "9")) else "sz") + code

def snapshot(codes):
    url = "https://qt.gtimg.cn/q=" + ",".join(market(c) for c in codes)
    out = {}
    for line in _get(url, gbk=True).split(";"):
        line = line.strip()
        if "=" not in line or '"' not in line:
            continue
        f = line.split('"')[1].split("~")
        if len(f) < 50:
            continue
        out[f[2]] = {
            "name": f[1], "close": float(f[3]), "prev": float(f[4]),
            "chg": float(f[31]), "chgpct": float(f[32]),
            "high": float(f[33]), "low": float(f[34]),
            "amount_yi": round(float(f[37]) / 10000, 2),
            "turnover": float(f[38]), "pe": f[39],
            "float_mv_yi": float(f[44]), "total_mv_yi": float(f[45]),
            "pb": f[46], "limit_up": float(f[47]), "limit_down": float(f[48]),
            "vol_ratio": float(f[49]) if f[49] else None,
            "time": f[30],
        }
    return out
这个接口返回的是 GBK 编码、用 ~ 分隔的长字符串,字段靠下标取。几个关键下标(写脚本时最容易搞错,建议对着实测数据逐个核):
下标 | 含义 | 注意 |
|---|---|---|
| 现价 / 昨收 | |
| 涨跌幅 % | |
| 成交额 | 单位是万元,除以 10000 才是"亿" |
| 换手率 % | |
| 流通市值(亿) | |
| 量比 | 可能为 空字符串,必须判空后再转 float |
| 快照时间戳 | 我用它判断当天是不是交易日 |
3.2 前复权日 K:web.ifzq.gtimg.cn
url = ("https://web.ifzq.gtimg.cn/appstock/app/fqkline/get?"
       "param=%s,day,,,%d,qfq" % (sym, n))
d = json.loads(_get(url))
node = d["data"][sym]
rows = node.get("qfqday") or node.get("day")
sym 是 sh601899 这种带市场前缀的形式,n 是取多少根(我设 120,够算 MA60 和 ATR14)。返回的每一行是 [日期, 开, 收, 高, 低, 成交量]。
有了日 K,MA、ATR14、20 日最低、60 日最高都在脚本里算,不依赖任何外部指标服务:
def atr(kl, n=14):
    trs = []
    for i in range(1, len(kl)):
        h, l, pc = kl[i]["high"], kl[i]["low"], kl[i - 1]["close"]
        trs.append(max(h - l, abs(h - pc), abs(l - pc)))
    return sum(trs[-n:]) / n if len(trs) >= n else None
3.3 资金流:东财 push2
UA = {"User-Agent": "Mozilla/5.0", "Referer": "https://quote.eastmoney.com/"}
FIELDS = "f12,f14,f2,f3,f62,f184,f66,f69,f72,f75,f78,f81,f84,f87"

def secid(code):
    return ("1." if code.startswith(("6", "5", "9")) else "0.") + code

url = ("https://push2.eastmoney.com/api/qt/ulist.np/get?"
       "fltt=2&invt=2&fields=%s&secids=%s"
% (FIELDS, ",".join(secid(c) for c in codes)))两个易错点:东财的 secid 前缀是 1.(沪)/ 0.(深),跟腾讯的 sh / sz 完全不是一回事;字段全用 f 编号,一次请求可以把多只票的十几个字段全取回来。
f62 主力净流入、f184 主力净占比、f66 超大单、f72 大单、f78 中单、f84 小单。返回值单位是元,除以 1e8 换成"亿"。
3.4 跑起来
python .workbuddy/tools/fetch_quotes.py 002050 002938 002475 601899
python .workbuddy/tools/fetch_fundflow.py 002050 002938 002475 601899
行情脚本的真实输出(2026-09-30 收盘口径):
{
 "002050": {
  "name": "三花智控",
  "close": 35.71, "prev": 35.53, "chg": 0.18, "chgpct": 0.51,
  "high": 36.45, "low": 35.29, "amount_yi": 14.52, "turnover": 1.09,
  "pe": "37.60", "float_mv_yi": 1318.07, "total_mv_yi": 1502.68,
  "vol_ratio": 1.06, "time": "20260930161500",
  "ma5": 35.68, "ma10": 35.39, "ma20": 35.39, "ma60": 37.19,
  "low20": 33.16, "high60": 44.73, "atr14": 1.06, "kd_end": "2026-09-30"
 }
}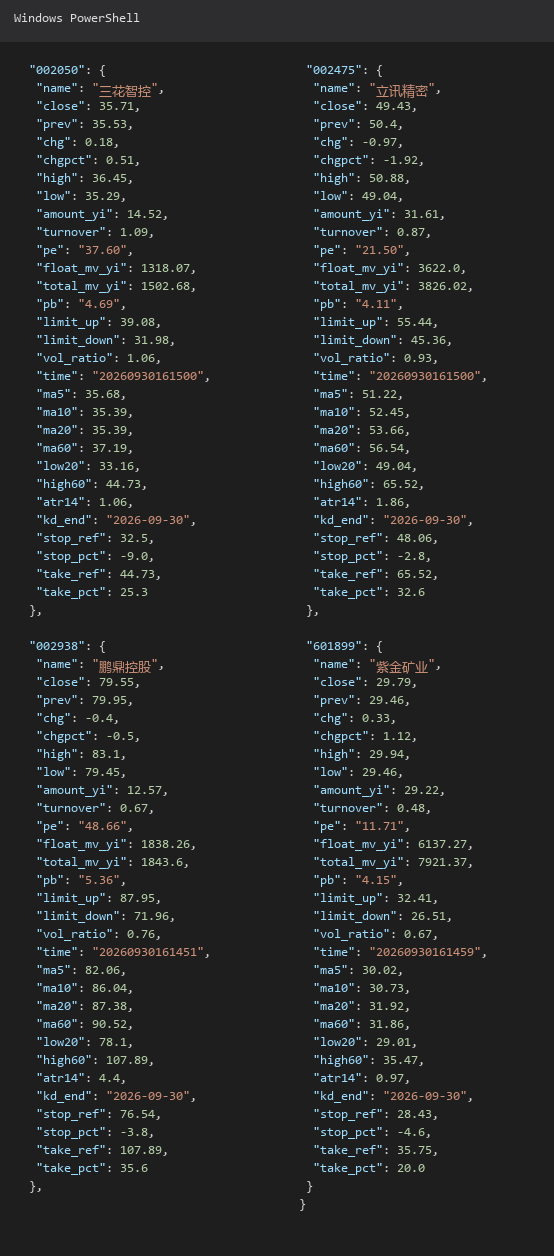
行情脚本四只标的的真实输出
图 2:fetch_quotes.py 一次性取回 4 只标的的完整字段(终端实跑输出)
数字准不准?拿行情页对一遍。
标的 | 收盘价 | 成交额 | 换手率 | 量比 |
|---|---|---|---|---|
紫金矿业 601899 | 29.79 | 29.22 亿 | 0.48% | 0.67 |
立讯精密 002475 | 49.43 | 31.61 亿 | 0.87% | 0.93 |
鹏鼎控股 002938 | 79.55 | 12.57 亿 | 0.67% | 0.76 |
三花智控 002050 | 35.71 | 14.52 亿 | 1.09% | 1.06 |
上表 16 个数字取自下图 4 张行情页截图,与脚本输出逐项完全一致,最高价、今开、昨收也全部对得上。这就是我敢把脚本当数据源的原因——它的输出随时可以被公开界面证伪,编不了。
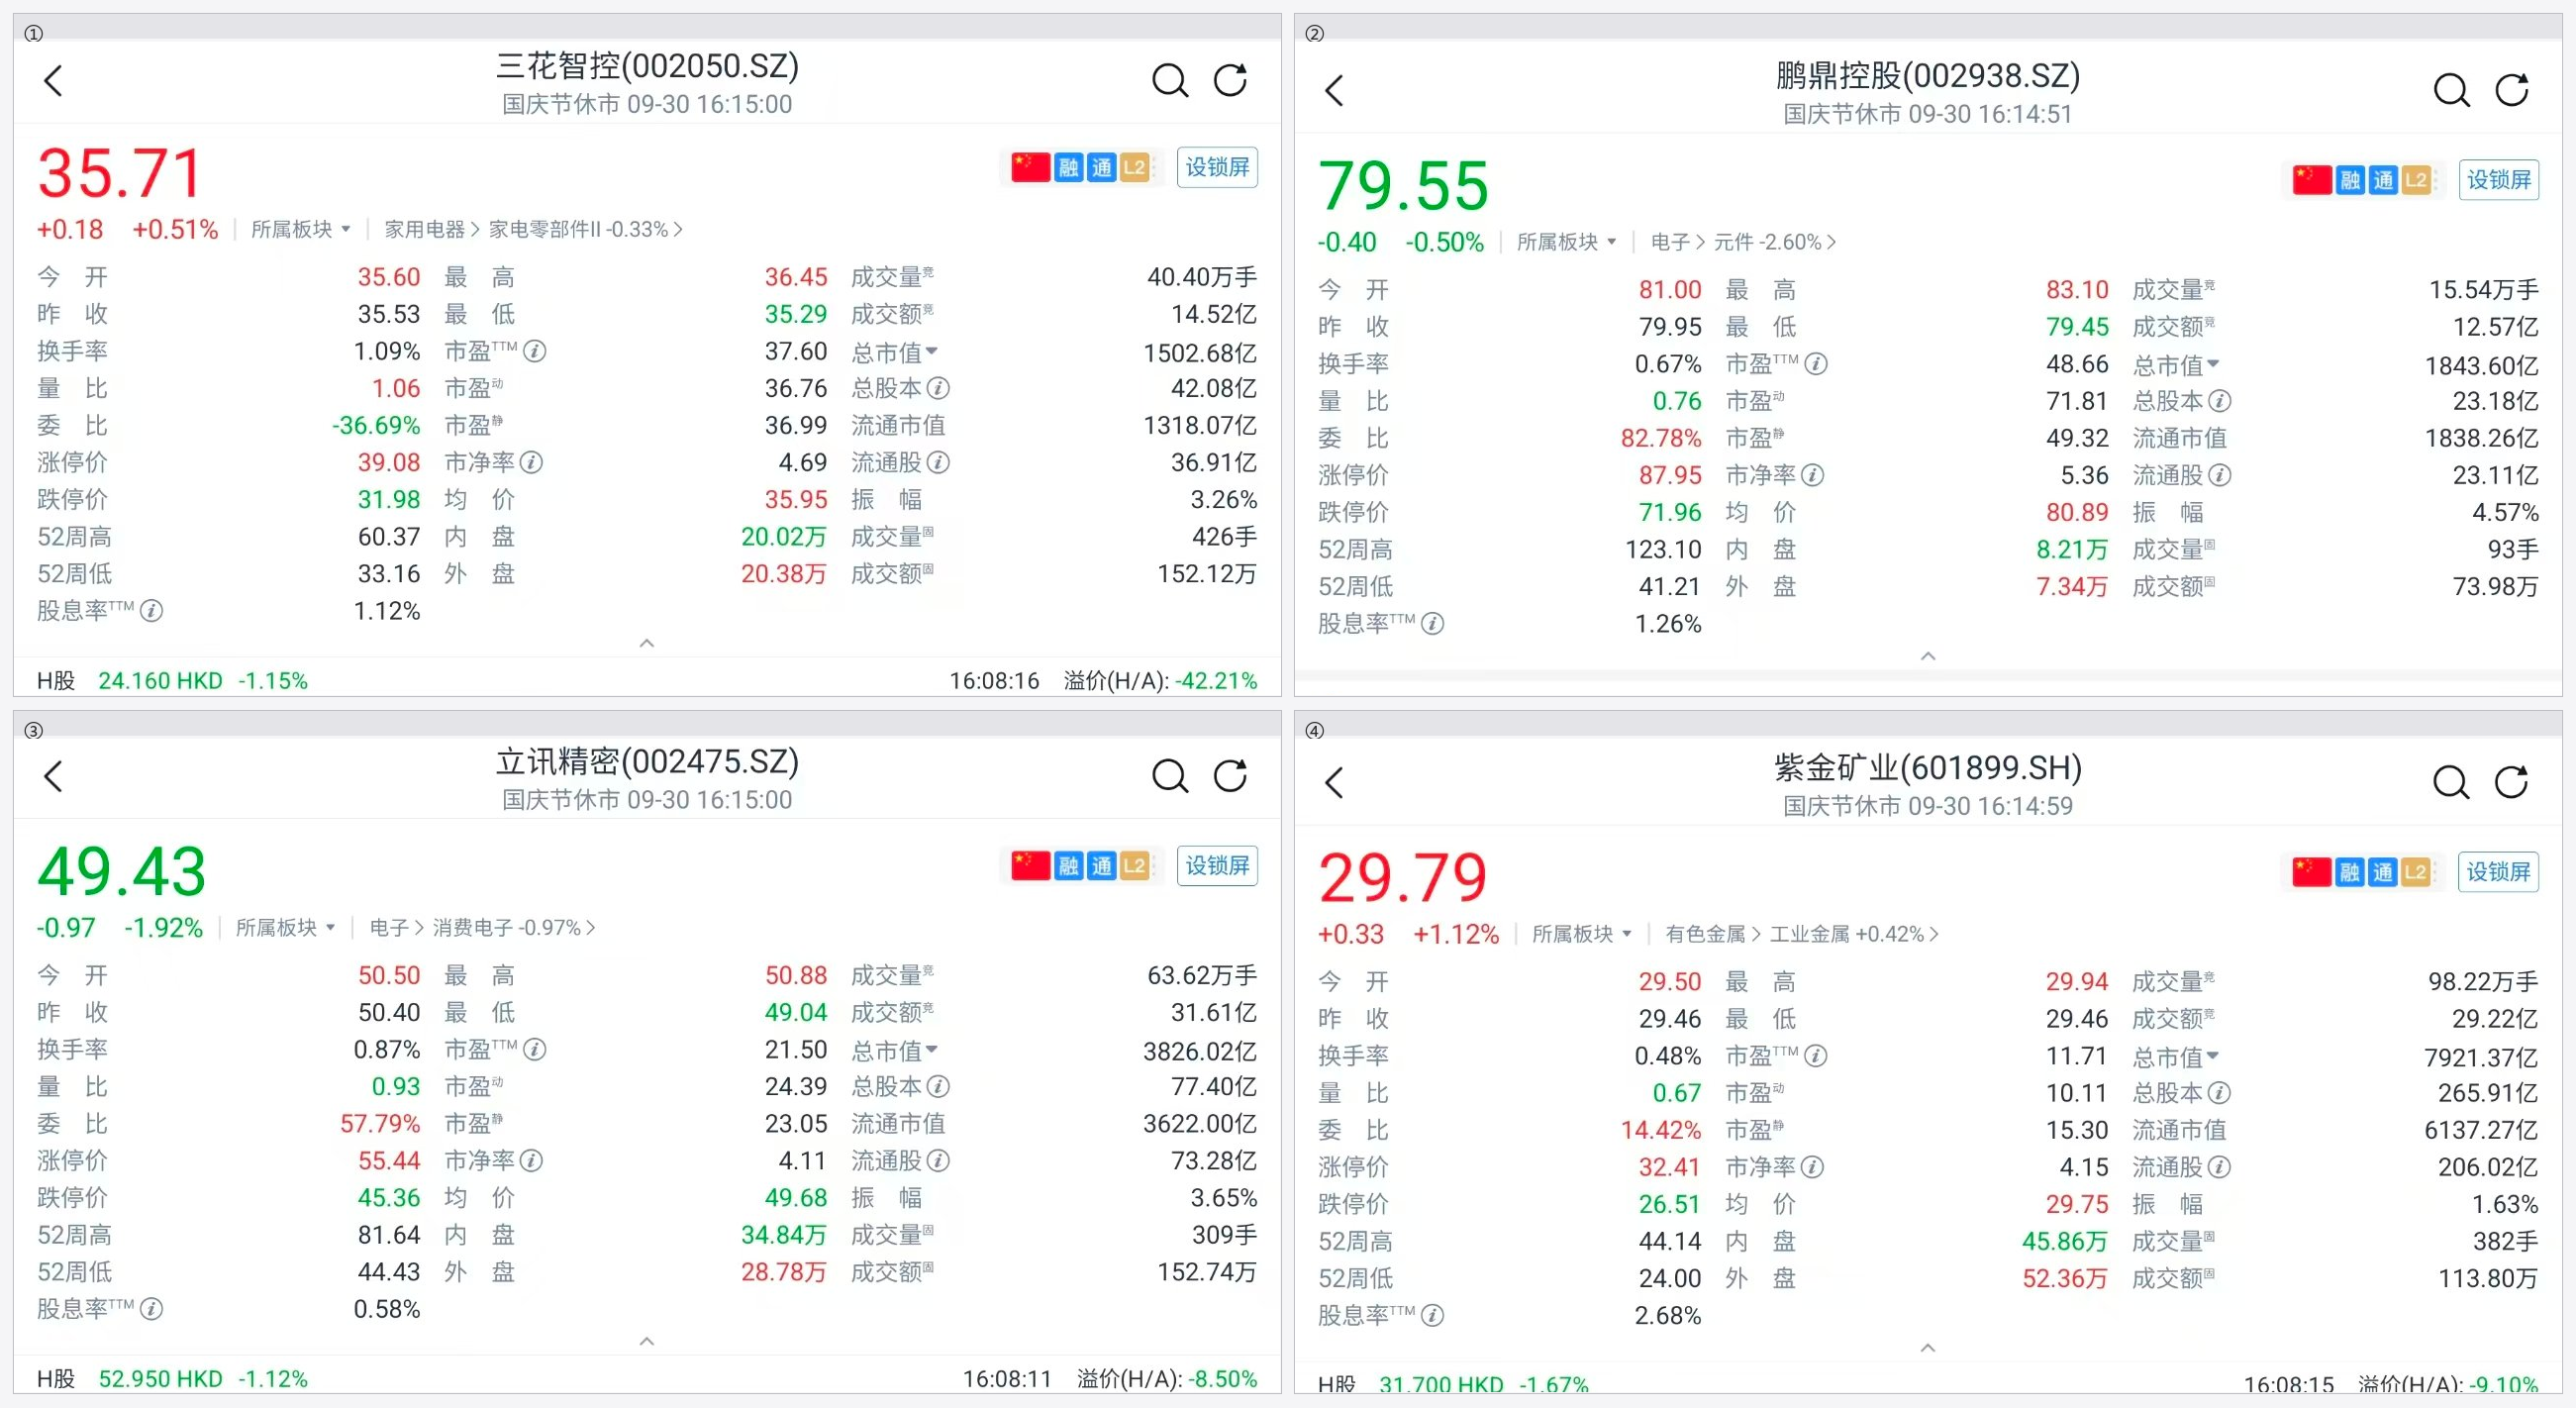
四只标的的行情页截图,用于交叉验证脚本取数
图 3:4 只标的的行情页截图(截取顶部报价区)。读者可自行逐项核对,四个字段 × 四只标的全部吻合
脚本里有个兜底设计值得抄:主循环用 try/except 包住每只票,单只失败只在那只票上记 "error": "异常类型: 信息",不会让整批挂掉。
3.5 止损止盈:宁可手算,不要抄脚本
我的统一规则(写在一份口径文件里,脚本只负责提供原始字段):
止损 = 收盘价 − max(2 × ATR14, 收盘价 × 8%)
止盈 = 收盘价 × 1.20
      (若近 60 日最高价落在 +15%~+35% 区间,改用该前高)
用上面的真实输出走一遍:
- 三花智控:
2 × 1.06 = 2.12<35.71 × 8% = 2.86→ 取 2.86,止损35.71 − 2.86 = 32.85;止盈本该35.71 × 1.2 = 42.85,但前高 44.73 是 +25.3%,落在 15%~35% 区间 → 改用前高 44.73 - 鹏鼎控股:
2 × 4.40 = 8.80>79.55 × 8% = 6.36→ 止损79.55 − 8.80 = 70.75;前高 107.89 是 +35.6%,超出 35% 上限,不启用 → 止盈79.55 × 1.2 = 95.46
这就是我把公式写进文件、而不是写进代码的原因:公式是会变的判断,判断必须能被人工复核。
四、踩过的 5 个坑
坑 1:日 K 的字段名是 qfqday,不是 dayqfq
现象:KeyError: 'dayqfq'。
排查:我按常规接口命名习惯(周期 + 复权方式)去猜字段名,猜错了。于是直接把返回 JSON 的 key 打印出来看:
print(list(d['data']['sh601899'].keys()))真实返回:
data节点下的 key = ['qfqday', 'qt', 'mx_price', 'prec', 'version']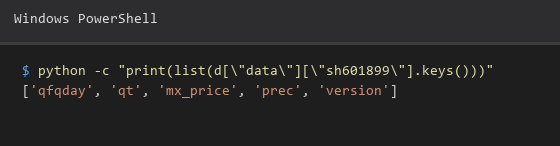
打印返回 JSON 的 key,字段名是 qfqday
图 4:打印返回 JSON 的 key,确认字段名是 qfqday 而不是猜的 dayqfq
解决:前缀在前,是 qfqday(周线则是 qfqweek)。脚本写成 node.get("qfqday") or node.get("day"),多一层兜底。
教训:猜接口字段名几乎必错,先
print(keys())再写代码,比事后 debug 快得多。
坑 2:东财 push2 同日高频请求被限流
现象:脚本抛
{"error": "RemoteDisconnected: Remote end closed connection without response"}排查:换 UA、加 Referer 都无效,减小标的数量也无效;隔一段时间再请求又能通。结合返回时机判断是服务端对来源 IP 的频率限制,不是参数错误。
解决:三条路,按顺序降级——① 脚本直连(最快,非高频时稳);② 让 WorkBuddy 用网页抓取去请求同一个东财 URL(走另一条出口,实测可绕过限流);③ 实在不行才动用付费数据工具。同时把每日调用压成"一次批量取全部标的",不要一只一只请求。
我复跑时又撞上一次,正好验证了降级路径有效——换成网页抓取请求同一个 URL,4 只票的数据一次全回来了:
{"f12":"002475","f14":"立讯精密","f62":-500848272.0,"f184":-15.85}
{"f12":"601899","f14":"紫金矿业","f62":83903952.0,"f184":2.87}(f62 是元:立讯 −5.01 亿、主力净占比 −15.85%;紫金 +0.84 亿、+2.87%。)
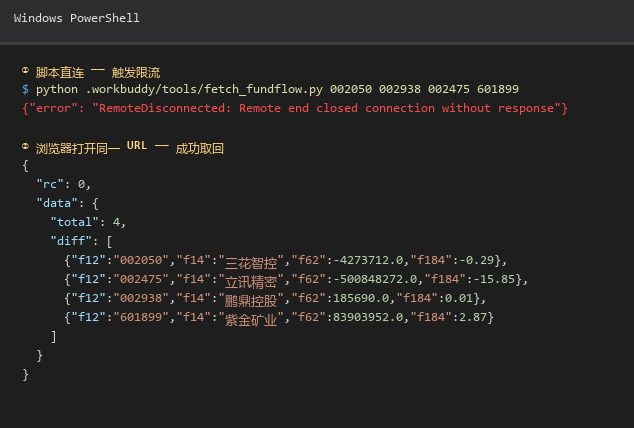
限流报错与浏览器访问同一接口成功返回
图 5:上:脚本直连触发 RemoteDisconnected;下:浏览器打开同一 URL 成功取回 JSON
坑 3:东财 push2his 偶发 rc:102(无数据)
现象:某天用它取指数日 K,返回 rc: 102、data: null。
排查:我先怀疑是限流(坑 2),改用腾讯 qt.gtimg.cn 取指数立刻成功。但我复测了同一个接口,返回 rc: 0 且数据正常:
rc = 0 | data = {'code': '000001', 'klines': ['2026-09-30,3839.25,3842.19', ...]}解决:结论修正为——这是偶发/参数相关的,不是永久失效。所以正确应对不是"换掉它",而是永远准备第二条通道:指数行情一律以腾讯 qt.gtimg.cn 为主,push2his 作备份。免费接口没有 SLA,双通道冗余是必须的。
这里也纠正我自己一个错误:我一度在工作笔记里把它记成"push2his 不可用",复测才发现是过度归纳。接口笔记要写"某天某参数下失败",不要写"接口坏了"。
坑 4:两融接口的排序列叫 DATE,写 DIM_DATE 会报错
现象:查个股融资融券明细,按 DIM_DATE 排序直接失败。复跑的真实报错原文:
DIM_DATE -> success= False  message= 'DIM_DATE排序列不存在'
DATE     -> success= True   message= 'ok'
          首行日期= 2026-09-29 00:00:00   RZYE= 4989966005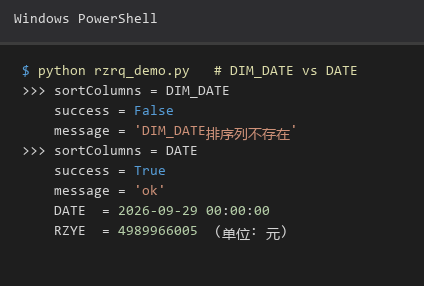
两融接口排序列 DIM_DATE 与 DATE 的对比
图 6:同一段代码,换排序列的两种结果——DIM_DATE 直接报错,DATE 正常返回
排查:东财数据中心不同报表的日期字段名不统一,这个报表返回的字段本身就叫 DATE。更要命的是——我之前的笔记把这条记反了,写成"DIM_DATE 可用、DATE 报错",害我多绕一圈。
解决:
params = {
    'reportName': 'RPTA_WEB_RZRQ_GGMX',
    'columns': 'ALL',
    'sortColumns': 'DATE',      # ← 必须是 DATE
    'sortTypes': '-1',
    'filter': '(SCODE="002050")'
}
# 多只标的必须用 in,不能写成 (SCODE="a")(SCODE="b")——那会被当成 AND,返回空
# filter=(SCODE in ("002050","601899"))
另外 RZYE(融资余额)单位是元,上面那个 4989966005 是 49.90 亿,别当成亿元直接用。
坑 5:脚本输出的 stop_ref 是旧口径,直接抄会全表写错
现象:我建了个每月 1 日自动重算止损止盈的定时任务,首次冒烟运行时发现——脚本给的值和口径文件里记的值对不上。
排查:翻脚本源码,发现它内部写死的是一套旧规则:
stop = max(lo20 * 0.98, px * 0.90)     # 旧
take = max(hi60,        px * 1.20)     # 旧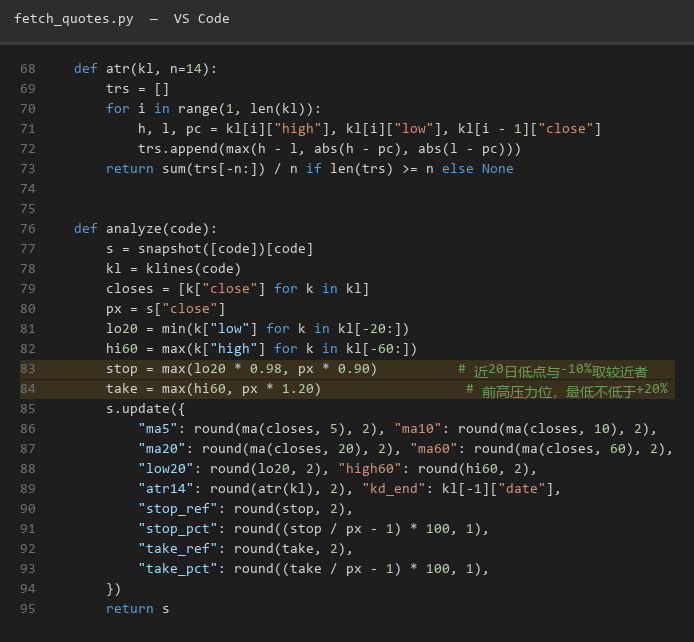
fetch_quotes.py 中 analyze() 里的旧口径两行
图 7:fetch_quotes.py 里 analyze() 函数体内的旧口径(高亮的第 83–84 行)
而口径文件里是 close − max(2×ATR14, close×8%)。用 4 只演示标的实测,两套规则的差距(2026-09-30 收盘口径):
标的 | 规则止损 | 脚本 | 偏离 |
|---|---|---|---|
三花智控 002050 | 32.85 | 32.50 | −0.35 |
鹏鼎控股 002938 | 70.75 | 76.54 | +5.79(7.3%) |
立讯精密 002475 | 45.48 | 48.06 | +2.58 |
紫金矿业 601899 | 27.41 | 28.43 | +1.02 |
止盈也一样:鹏鼎按规则是 95.46,脚本给 107.89。4 只全部偏离,且方向一致地"放宽止损"——凑巧没出事,但这是实质性风险。
解决:脚本只采信原始字段(close / atr14 / low20 / high60),止损止盈一律按口径文件手算。 我没有改脚本(它有其他调用方),而是在口径文件开头加了醒目警告,并把这条规则写进定时任务的提示词里。
这周最有价值的一条教训:自动化任务上线前必须做一次"冒烟对照"——拿它跑一遍已有的正确结果,对不上就说明有隐藏的口径漂移。这次如果没做,止损位会被悄悄改掉而毫无察觉。
五、解决方案速查表
坑 | 症状 | 解决 |
|---|---|---|
字段名猜测错误 |
| 先 |
东财限流 |
| 批量请求 + 降级到网页抓取同一 URL |
push2his 偶发无数据 |
| 双通道冗余,主用腾讯 |
两融排序列 |
| 用 |
脚本口径漂移 | 止损值与口径文件不符 | 只取原始字段,公式以口径文件为准,上线前冒烟对照 |
六、效果与数据
- 成本:取数环节零消耗——纯脚本,不调用模型。整个每日简报任务的联网开销压到 1 次检索 + 4 次搜索。
- 成功率:2026-09-30 那次跑批,行情脚本全部标的均成功;本次复跑 4 只演示标的同样全通。资金流脚本本次复跑触发了限流(见坑 2),降级后 4 只数据全部取回。
- 耗时:从 15–20 分钟手工操作,变成定时任务自动触发、结果直接推送。
- 可验证性:每个数字都能回到接口原文核对;源之间冲突(比如不同口径的涨跌停家数)会在报告里并列标注,不取单一来源。
- 可复用:
.workbuddy/tools/下三个脚本(fetch_quotes.py行情 /fetch_fundflow.py资金流 /monthly_ret.py月度涨跌幅),零第三方依赖,换一组股票代码就能直接用。
一个提醒:定时任务本身只消耗额度、不产生收益,它能自动化的只是"最耗时的那一半"(取数、整理、初稿),最后那一步还是要自己来。
七、可复用的三条经验
- 确定性的活,别让模型干。 取数、计算、格式化——写成脚本,一分不花,还能复现。模型只留给需要判断的部分。
- 口径写进文件,不写进代码。 公式是会变的判断,写在文件里能被人工复核;写死在代码里就变成黑箱。坑 5 就是反面教材。
- 免费接口必须双通道。 没有 SLA 的东西随时会挂,主通道 + 备份通道是标配;接口笔记写"某天某参数下失败",别写"接口坏了"——我在这上面已经错过一次。
本文涉及的行情数据仅为技术接口演示用途,不构成任何投资建议。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号