Prompt Flow工作流解析:基于Prompt Flow告别零散Prompt,标准化开发LLM应用24.5
原创
Prompt Flow工作流解析:基于Prompt Flow告别零散Prompt,标准化开发LLM应用24.5
原创
未闻花名
发布于 2026-10-05 18:35:59
发布于 2026-10-05 18:35:59
一、前言
在刚开始接触到大模型应用时,普遍认为Prompt只是简单的文字描述,只需随意编写语句,就能驱动大模型完成问答、改写、总结等各类任务。在一般场景中,单条简短的Prompt确实可以实现基础效果,Prompt开发无技术门槛,无需体系化构建与流程设计。但在真实的项目迭代、场景落地、企业部署过程中,单一、零散的Prompt弊端会彻底暴露:效果随机性极强、输出风格不可控、无法追溯问题根源,一旦遇到多步骤链式推理、私有知识库问答、多模型联动等复杂场景,单纯堆砌文本式的Prompt写法完全无法适配需求。
事实上,高质量的大模型应用落地,Prompt从来不是简单的文字拼接,而是一套具备严谨逻辑、分层架构、可迭代优化的专业构建体系。零散Prompt之所以难以落地,核心问题不在于提示词文本本身,而在于缺乏标准化的流程管控、节点拆分与逻辑固化。传统粗放式的Prompt开发模式,没有分层设计、没有链路追溯、没有模块解耦,导致AI任务只能单次触发、无法复用迭代,对应用的实际效果也大打折扣。而Prompt Flow的出现,彻底补齐了这一行业短板,它重新定义了Prompt工程化开发模式,将单一的文本提示升级为节点化编排、流程化调度、可视化管控的完整工作流,让Prompt构建有规范、有逻辑、可调试、可落地。
二、核心基础认知
1. 核心定义
Prompt Flow是一个大模型应用流程开发框架,主打低代码流程编排、可视化调试、工程化落地三大核心能力。不同于传统单纯编写提示词的开发模式,Prompt Flow以“流程节点”为核心单元,将大模型应用的完整链路拆分为独立模块,实现任务解耦、逻辑清晰、可复用、可追溯。核心特点可分为三点:
- 低代码流程编排:无需大量重复业务代码,通过节点拖拽、配置关联即可完成大模型任务流程搭建,降低LLM应用开发门槛。
- 可视化全链路调试:所有执行步骤可视化展示,告别传统代码黑盒运行模式,每一步输入输出、运行状态均可直观查看。
- 工程化标准化落地:统一开发规范、目录结构、部署方式,适配个人开发、团队协作、企业线上落地全场景。
为方便通俗理解,可将传统LLM开发与Prompt Flow开发做明确对比,两者核心差异:
- 传统Prompt开发:属于一次性输入输出模式,所有逻辑、上下文、提示词、模型调用全部揉在一段代码里。问题无法精准定位、代码无法复用、无法批量优化迭代,仅能支撑简单测试场景,无法落地企业级项目。
- Prompt Flow开发:属于流水线式开发,将加载上下文、组装提示词、调用大模型、汇总结果四大核心步骤拆分为独立节点。各节点各司其职,支持单独调试、单独修改、单独替换,大幅降低大模型应用的开发与维护成本。
Prompt Flow具备极强的通用性,适配市面绝大多数主流大模型接口,兼容标准化调用规范,凭借良好的兼容性与工程化能力,Prompt Flow目前已成为企业级LLM应用开发的主流框架之一。
2. 核心优势
Prompt Flow相比传统纯Prompt开发方式,拥有五大不可替代的核心优势,也是其成为应用实践首选的核心原因:
流程可视化,问题排查零门槛:
- 整个AI任务链路以节点化、图形化方式展示,我们可清晰查看每一步执行状态、输入输出数据、精准报错位置,彻底解决传统开发“黑盒运行”的痛点,大幅提升调试效率。
任务解耦,模块可复用可迭代:
- 将复杂AI任务拆分为上下文加载、模型推理、结果处理等独立节点,单个节点的修改、优化不会影响整体流程,通用节点可跨项目复用,极大减少重复开发工作量。
标准化规范,适配团队协作开发:
- 框架自带统一的目录结构、配置文件规范、代码开发标准,团队开发有统一依据,不同开发者可快速接手、迭代项目,解决了传统Prompt开发杂乱无章、无法协作的问题。
原生支持批量测试与效果评估:
- Prompt Flow内置批量测试能力,可一次性录入多组测试问答样本,批量运行工作流,统一评估模型回答的准确率、稳定性,方便开发者快速优化提示词与流程逻辑,适配企业持续迭代需求。
一键部署,无缝对接线上业务:
- 本地开发调试完成后,可直接将编排好的工作流打包部署为标准API服务,无需额外改造业务代码,快速实现线上落地,同时适配私有化部署、云端部署等多种企业部署场景。
3. 适用场景
Prompt Flow 适配绝大多数大模型落地场景,覆盖轻量化个人开发、中度复杂AI任务、企业级线上业务全维度场景,实用性极强:
- 基础轻量化场景:包含智能问答、知识库检索问答、文本摘要、内容改写、关键词提取等简单AI任务,上手门槛低,是基础Prompt Flow的核心实操场景。
- 进阶复杂场景:包含多轮对话推理、智能体任务编排、多模型串联调用、文档解析问答、结构化数据抽取等复杂逻辑任务,可解决单Prompt无法实现的链式AI需求。
- 企业级业务场景:覆盖批量内容审核、智能客服系统、企业私有知识库平台、自动化文案生成、代码辅助开发等正式线上业务系统,稳定性与可维护性满足企业生产要求。
只要是需要多步骤执行、可追溯、可迭代优化、可线上部署的大模型应用,均可以通过Prompt Flow实现,完美适配个人开发、团队项目、企业落地全场景。
三、标准化架构与配置
Prompt Flow所有开发流程均遵循统一的工程规范,整体架构分工明确、模块解耦、层级清晰,是实现大模型应用可复用、可调试、可部署的核心前提。标准化的架构规范,让不同开发者、不同团队的LLM应用拥有统一的开发范式,彻底解决传统Prompt开发无序、无法协作、无法迭代的问题。
1. 整体架构说明
Prompt Flow采用模块化、分层式的标准架构,将配置、流程定义、业务逻辑完全拆分。整体架构严格遵循“配置与逻辑分离、节点与流程分离”的工程思想,各层级模块职责独立、互不耦合,能够适配本地调试、团队协作、线上部署、二次迭代全场景,是企业级大模型应用开发的通用标准架构。
2. 配置规范与核心作用
Prompt Flow 依靠标准化配置体系实现流程自动化调度与模型对接,所有配置与业务逻辑完全解耦,从架构层面提升项目的安全性、可维护性与可拓展性。整套配置体系分为三类核心能力,各司其职、相互配合,支撑整套AI工作流稳定运行:
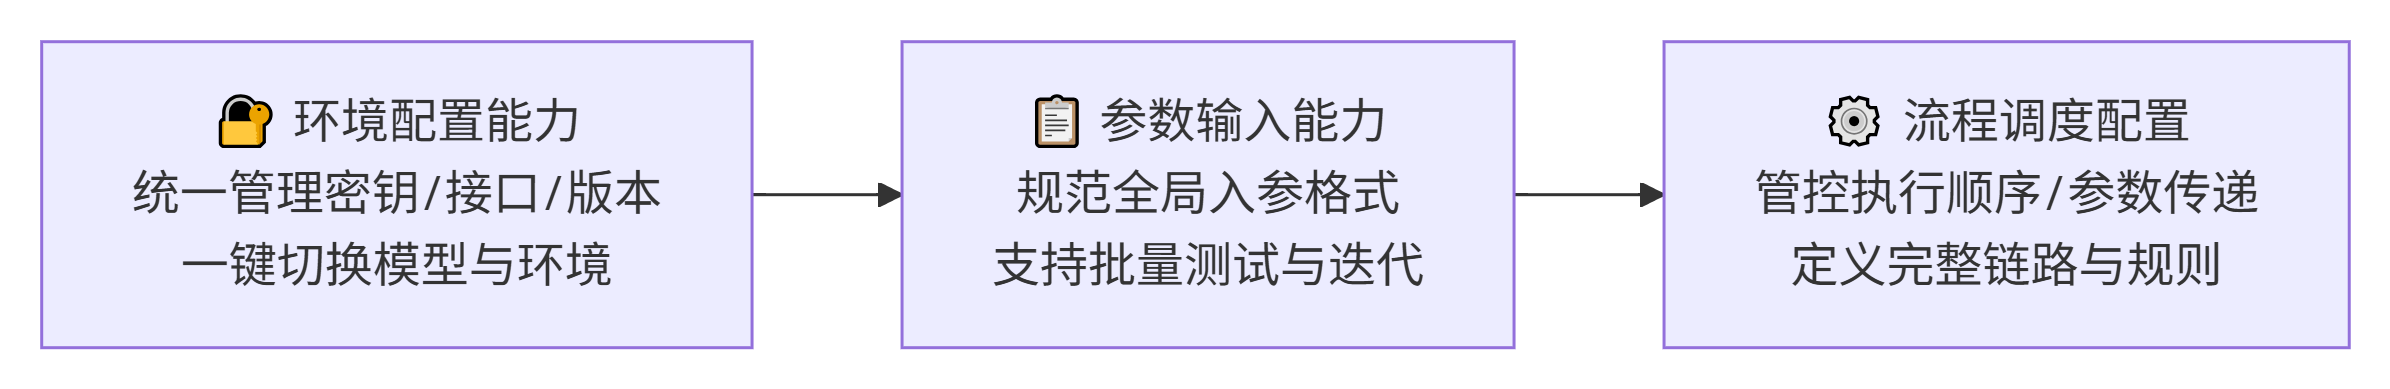
- 环境配置能力:统一管理大模型密钥、接口地址、模型版本等核心私密参数,杜绝硬编码风险,保障接口调用安全,支持一键切换模型、切换服务环境,适配多场景部署需求。
- 参数输入能力:统一规范工作流全局入参格式,定义标准化输入结构,支持自定义测试样本、批量测试、参数迭代,让模型效果评估有统一标准。
- 流程调度配置能力:作为工作流的核心调度中枢,统一管控节点执行顺序、跨节点参数传递、全局输入输出结构,定义整套AI任务的完整执行链路与逻辑规则。
三类标准化配置相辅相成,构成Prompt Flow运行的基础支撑,让大模型应用开发告别随意编写的粗放模式,走向规范化、体系化、工程化的开发模式。
3. 流程调度原理详解
流程调度配置是Prompt Flow框架的核心中枢,掌控整套工作流的执行逻辑,是实现节点化编排、自动化运行、可视化管控的关键所在。其核心作用是将零散的业务节点串联为完整的AI流水线,统一管控执行顺序、数据传递、输入输出关联,整体分为三大标准化模块,逻辑闭环、层级清晰:
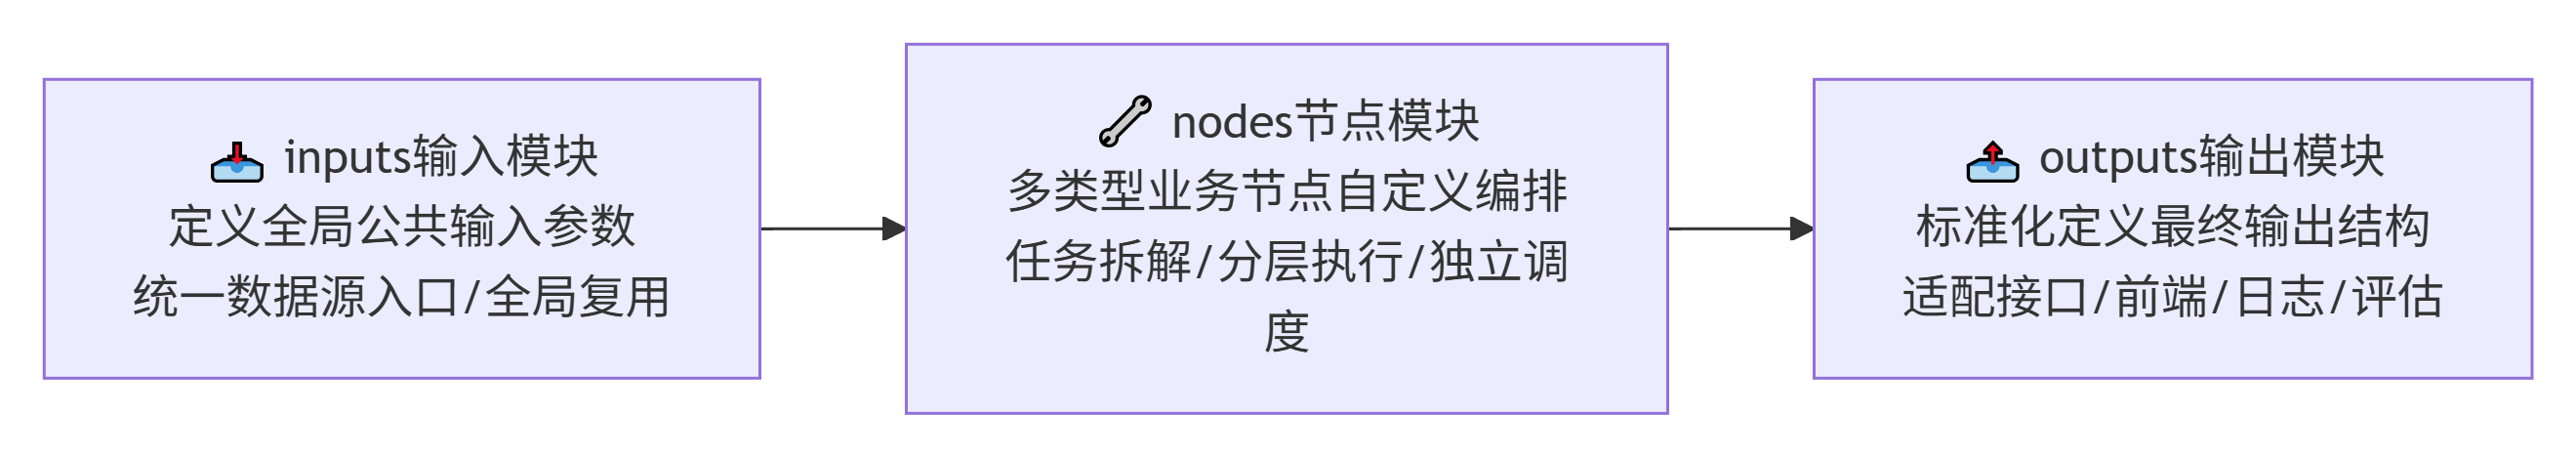
- inputs输入模块:定义工作流全局公共输入参数,统一所有业务节点的数据源入口,实现参数统一管控、全局复用,保证整套流程输入规范统一。
- nodes节点模块:支持多类型业务节点自定义编排,按照业务逻辑顺序组装完整AI任务链路,实现多步骤任务拆解、分层执行、独立调度,适配简单问答、复杂推理等各类场景。
- outputs输出模块:标准化定义工作流最终输出结构,统一对外数据返回格式,适配接口调用、前端展示、日志留存、效果评估等后续拓展需求。
四、核心节点机制与运行逻辑
Prompt Flow工作流的核心设计思想是任务拆解、单责独立、流水线执行,将复杂的大模型应用任务,拆分为多个职责单一、互不耦合的独立节点。各节点可独立调试、独立迭代、独立替换,通过框架自动完成数据串联与流程调度。
1. 节点一:上下文加载节点
该节点是整套AI工作流的前置预处理环节,核心通用能力为文本预处理、检索匹配、上下文构建。主要用于解决大模型知识滞后、无私有领域数据、内容易幻觉的行业痛点,为模型推理提供真实、可靠的参考依据,是所有知识库问答、领域问答类LLM应用的通用前置模块。
- 通用开发规范:Prompt Flow 所有业务节点均遵循统一注册规范,通过框架标准装饰器完成节点注册,可被流程调度体系自动识别、调度、执行,无需额外配置。
- 核心输入能力:统一接收用户原始提问内容,作为整个预处理环节的唯一数据源,为后续检索、清洗、上下文生成提供基础依据。
- 核心开发规范:采用Prompt Flow官方专属装饰器完成节点注册,符合框架标准化开发要求,可被流程调度文件自动识别、调度与执行。
- 核心入参:仅接收用户实时提问参数,作为知识库检索的唯一依据,参数简洁、逻辑清晰。
该节点的通用执行逻辑分为三层标准化流程,适配绝大多数检索增强类AI场景,层层递进、逻辑通用:
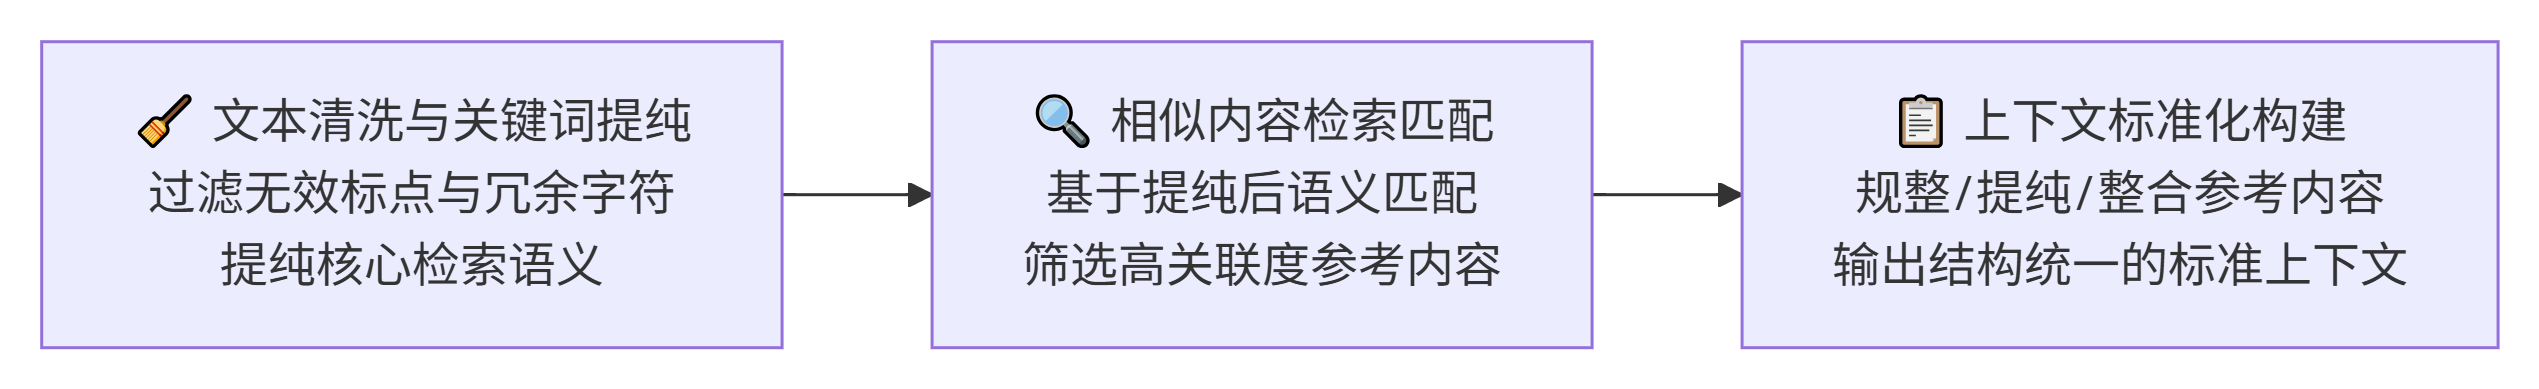
- 文本清洗与关键词提纯:自动过滤无效标点、冗余字符,提纯用户提问的核心检索语义,规避无效字符干扰,提升内容匹配的精准度。
- 相似内容检索匹配:基于提纯后的核心语义,匹配对应领域参考内容,筛选高相似度、高关联度的有效参考资料。
- 上下文标准化构建:对检索到的参考内容进行规整、提纯与整合,输出结构统一、语义清晰的标准上下文,为模型推理提供可靠输入。
该节点的核心技术价值是实现AI问答有据可依、推理有源可溯,从架构层面解决大模型幻觉、内容编造、答案无依据的核心问题。该预处理逻辑可通用适配所有RAG问答、领域知识库问答、智能咨询等场景,可根据业务需求自由拓展检索数据源与匹配规则。
2. 节点二:模型接口调用节点
该节点是整套Prompt Flow工作流的核心推理中枢,承担模型配置加载、提示词工程组装、大模型接口调用、推理结果解析、异常容错处理的全流程核心能力。作为LLM应用的算力与推理核心,该节点适配所有兼容通用规范的大模型,具备极强的通用性、兼容性与稳定性,是标准化LLM应用的核心通用模块。
通用模块架构:节点遵循“配置解耦、逻辑分层”的设计思想,分为两大通用核心模块,适配所有模型对接场景:
核心模块拆解:节点分为两大核心函数,分工明确、解耦性强:
- 环境配置解析模块:通用化读取项目环境配置,自动解析模型密钥、接口地址、模型标识等核心参数,支持环境变量优先级适配,兼容本地调试与线上部署双模式,彻底实现配置与业务逻辑解耦。
- 模型推理执行模块:包含标准化的配置加载、提示词组装、接口请求、结果解析四层通用逻辑,同时内置通用异常捕获机制,可精准识别网络异常、鉴权异常、参数异常等各类问题,保障服务稳定运行。
3. 节点三:结果汇总输出节点
该节点是Prompt Flow工作流的标准化收尾模块,核心通用价值是全链路数据整合、结果标准化、日志可追溯,是区分传统零散Prompt调试与工程化LLM开发的关键标识。该节点统一汇总全流程链路数据,规整输出格式、留存执行日志,适配调试复盘、线上运维、业务展示、效果迭代等通用场景。通用核心特性:
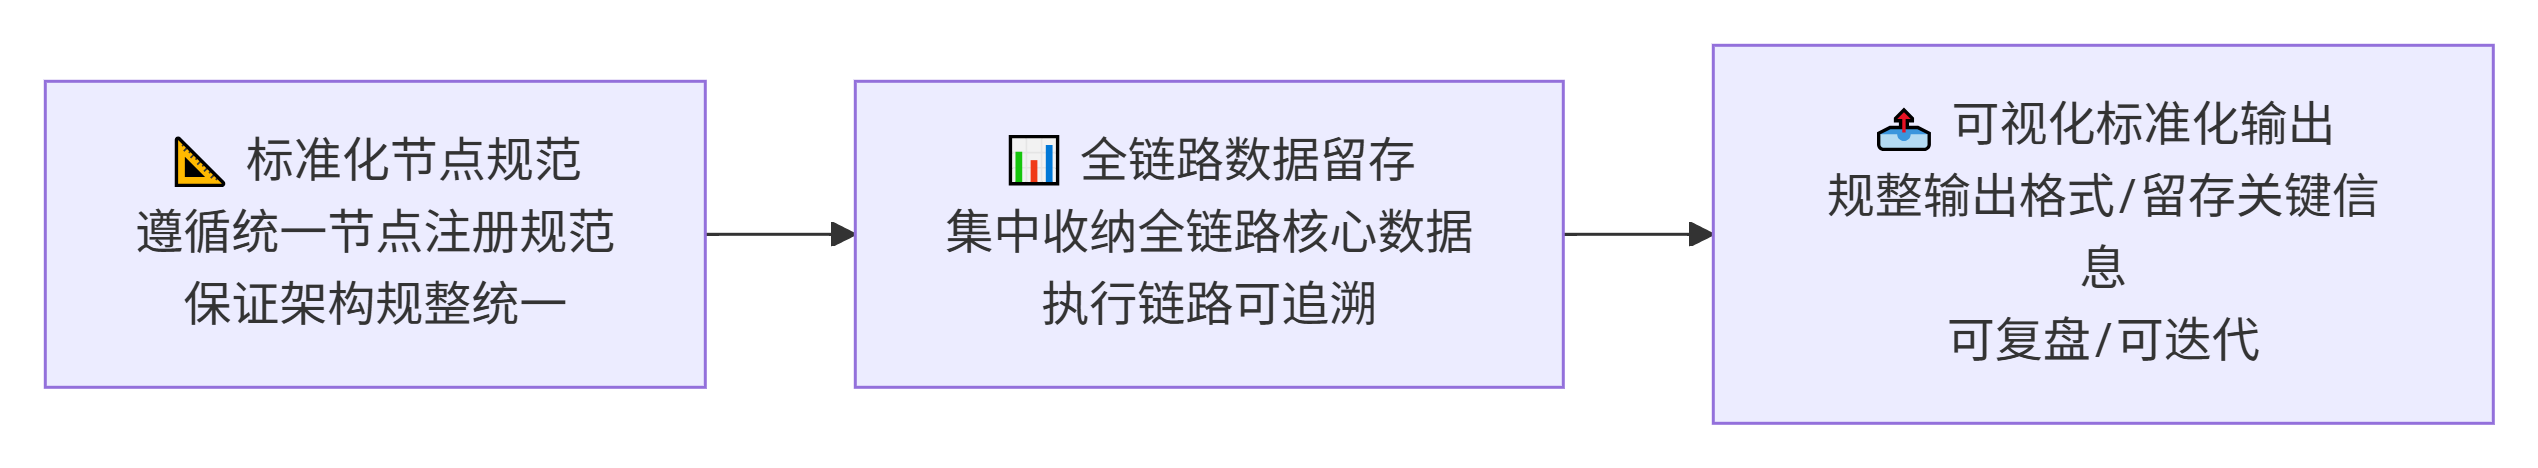
- 标准化节点规范:遵循Prompt Flow统一节点注册规范,与前置节点保持开发范式统一,保证整套流程架构规整、统一。
- 全链路数据留存:集中收纳用户输入、预处理上下文、模型推理结果等全链路核心数据,实现AI执行链路无丢失、可追溯。
- 可视化标准化输出:规整输出内容格式、留存关键执行信息,让每一次模型推理都有完整日志、可复盘、可优化、可迭代。
五、完整示例与运行全流程
该示例基于 Prompt Flow 构建"文档问答"DAG 流程,完整演示大模型应用的三环节执行链路:
- load_context:模拟知识库检索,提取关键词并返回上下文片段
- qa_prompt:从 .env 读取腾讯混元API密钥,组装 system/user 消息并调用hy3模型生成回答
- output_summary:汇总问题、上下文与回答,输出最终结果
1. 项目完整源码汇总
1.1 整体目录结构
doc_qa_flow/ ├─ flow.dag.yaml # 流程定义(3节点:load_context → qa_prompt → output_summary) ├─ inputs.json # 测试输入 ├─ .env # 混元 API 配置(密钥/URL/模型) ├─ load_context.py # 环节1:上下文加载 ├─ qa_api.py # 环节2:混元模型调用 └─ output_summary.py # 环节3:结果汇总
1.2 环境配置文件(.env)
TENCENT_API_KEY=sk-ymL****************************Od2ilaYFM7
HUNYUAN_BASE_URL=https://tokenhub.tencentmaas.com/v1
HUNYUAN_MODEL=hy3
1.3 测试输入文件(inputs.json)
{
  "question": "Prompt Flow是什么?"
}
1.4 流程定义文件(flow.dag.yaml)
inputs:
  question:
    type: string
    description: 用户提问

nodes:
  - name: load_context
    type: python
    source:
      type: code
      path: load_context.py
    inputs:
      question: ${inputs.question}

  - name: qa_prompt
    type: python
    source:
      type: code
      path: qa_api.py
    inputs:
      context: ${load_context.output}
      question: ${inputs.question}

  - name: output_summary
    type: python
    source:
      type: code
      path: output_summary.py
    inputs:
      question: ${inputs.question}
      context: ${load_context.output}
      answer: ${qa_prompt.output}

outputs:
  answer:
    type: string
    reference: ${output_summary.output}
1.5 上下文加载节点(load_context.py)
from promptflow.core import tool

@tool
def run(question: str):
    """环节1:模拟加载知识库上下文(真实项目可替换为向量库检索)"""
    print("=" * 56)
    print("[环节1] load_context - 上下文加载开始")
    print(f"  用户提问: {question}")


    # 1. 关键词提取
    print("  步骤1/3 提取检索关键词...")
    keywords = question.strip().replace("?", "").replace("?", "")
    print(f"    关键词: {keywords}")


    # 2. 模拟向量库检索
    print("  步骤2/3 向量库检索相似文档...")
    doc_list = [
        "Prompt Flow用于搭建、评估大模型应用流程,支持可视化调试、批量测试与一键部署AI服务。",
        "Prompt Flow提供流程可视化设计器,支持拖拽式构建LLM应用。",
    ]
    top_doc = doc_list[0]
    print(f"    命中 {len(doc_list)} 条文档,选取最高相似度片段(0.92)")


    # 3. 上下文合并
    print("  步骤3/3 合并上下文片段...")
    print(f"    上下文内容: {top_doc}")
    print("[环节1] load_context - 上下文加载完成")
    print("=" * 56)
    return top_doc
1.6 模型接口调用节点(qa_api.py)
"""环节2:混元模型调用节点(从 .env 读取密钥,调用 OpenAI 兼容接口)"""
import json
import os
import urllib.request


from promptflow.core import tool


def _load_env():
    """手动加载 .env(零依赖),已存在的环境变量优先"""
    env_path = os.path.join(os.path.dirname(__file__), ".env")
    if not os.path.exists(env_path):
        return
    with open(env_path, "r", encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if not line or line.startswith("#") or "=" not in line:
                continue
            key, _, value = line.partition("=")
            os.environ.setdefault(key.strip(), value.strip().strip('"').strip("'"))


@tool
def run(context: str, question: str) -> str:
    """基于参考上下文,调用混元模型生成回答"""
    print("=" * 56)
    print("[环节2] qa_prompt - 大模型生成开始")


    # 1. 加载配置
    print("  步骤1/4 加载模型配置(.env)...")
    _load_env()
    api_key = os.environ.get("TENCENT_API_KEY") or os.environ.get("HUNYUAN_API_KEY")
    base_url = os.environ.get("HUNYUAN_BASE_URL", "https://tokenhub.tencentmaas.com/v1")
    model = os.environ.get("HUNYUAN_MODEL", "hy3")
    print(f"    模型: {model} | 接口: {base_url}/chat/completions")
    print(f"    密钥: {api_key[:6]}**** (已脱敏)")


    # 2. 组装提示词
    print("  步骤2/4 组装 system/user 消息...")
    messages = [
        {"role": "system", "content": "你是专业文档问答助手。严格依据提供的参考上下文回答用户问题,禁止编造不存在的信息。"},
        {"role": "user", "content": f"参考上下文:\n{context}\n\n用户问题:{question}"},
    ]
    print(f"    system: 严格依据上下文回答,禁止编造")
    print(f"    user  : 上下文[{len(context)}字] + 问题[{question}]")


    # 3. 发起请求
    print("  步骤3/4 调用混元模型推理...")
    req = urllib.request.Request(
        f"{base_url}/chat/completions",
        data=json.dumps({"model": model, "messages": messages}).encode("utf-8"),
        headers={
            "Authorization": f"Bearer {api_key}",
            "Content-Type": "application/json",
        },
    )
    try:
        with urllib.request.urlopen(req, timeout=30) as resp:
            data = json.loads(resp.read().decode("utf-8"))
            answer = data["choices"][0]["message"]["content"]
            print(f"    请求成功,消耗 tokens: {data.get('usage', {}).get('total_tokens', 'N/A')}")


        # 4. 返回结果
        print("  步骤4/4 解析并返回回答...")
        print(f"    回答: {answer[:60]}...")
        print("[环节2] qa_prompt - 大模型生成完成")
        print("=" * 56)
        return answer
    except urllib.error.HTTPError as e:
        err_msg = f"[HTTP {e.code}] {e.read().decode('utf-8', errors='ignore')[:200]}"
        print(f"    [错误] {err_msg}")
        print("=" * 56)
        return err_msg
    except Exception as e:
        print(f"    [错误] {e}")
        print("=" * 56)
        return f"[ERROR] {e}"
1.7 结果汇总输出节点(output_summary.py)
from promptflow.core import tool

@tool
def run(question: str, context: str, answer: str) -> str:
    """环节3:结果汇总输出"""
    print("=" * 56)
    print("[环节3] output_summary - 结果汇总")
    print(f"  问题: {question}")
    print(f"  上下文来源: 本地文档库")
    print(f"  回答: {answer}")
    print("=" * 56)

    return (
        f"[执行汇总]\n"
        f"问题: {question}\n"
        f"回答: {answer}"
    )
2. 工作流全链路执行逻辑
整套Prompt Flow工作流遵循"输入→上下文加载→模型推理→结果汇总→输出"的标准化流水线逻辑,执行顺序固定、参数传递清晰、无逻辑漏洞,完整全链路执行步骤:

- 步骤一:读取全局输入参数:系统自动加载全局测试参数,获取用户提问内容,作为整个工作流的启动触发条件。
- 步骤二:执行上下文加载节点:清洗用户提问关键词,检索本地预设知识库,匹配对应Prompt Flow介绍文档,输出标准化上下文内容,传递至下一节点。
- 步骤三:执行模型推理节点:读取全局模型配置,组装规范问答提示词,调用腾讯混元模型,基于参考上下文生成精准回答,同步记录token消耗与接口请求状态。
- 步骤四:执行结果汇总节点:整合用户问题、检索上下文、模型回答三类数据,格式化日志信息与最终输出结果,完成单次问答全流程闭环。
- 步骤五:对外输出结果:工作流输出标准化问答内容,供开发者查看或业务系统调用。
整套流程全程全自动串联执行,无需人工干预,每一步的输入输出、运行状态、报错信息均可可视化查看,极大提升LLM应用的调试与迭代效率。
3. 项目运行结果输出
基于本次完整源码运行项目,可得到标准化、可追溯的日志输出与精准问答结果,实战运行效果优势明显。
运行命令:
pf flow test --flow . --inputs question="Prompt Flow是什么?"输出结果:
Prompt flow service has started... 2026-08-17 22:35:16 +0800 21372 execution.flow INFO Start executing nodes in thread pool mode. 2026-08-17 22:35:16 +0800 21372 execution.flow INFO Start to run 3 nodes with concurrency level 16. 2026-08-17 22:35:16 +0800 21372 execution.flow INFO Executing node load_context. node run id: 0fa25423-edb1-4938-9e70-8862763cb8a8_load_context_0 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> ======================================================== 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> [环节1] load_context - 上下文加载开始 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> 用户提问: Prompt Flow是什么? 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> 步骤1/3 提取检索关键词... 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> 关键词: Prompt Flow是什么 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> 步骤2/3 向量库检索相似文档... 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> 命中 2 条文档,选取最高相似度片段(0.92) 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> 步骤3/3 合并上下文片段... 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> 上下文内容: Prompt Flow用于搭建、评估大模型应用流程,支持可视化调试、批量测试与一键部署AI服务。 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> [环节1] load_context - 上下文加载完成 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [load_context in line 0 (index starts from 0)] stdout> ======================================================== 2026-08-17 22:35:16 +0800 21372 execution.flow INFO Node load_context completes. 2026-08-17 22:35:16 +0800 21372 execution.flow INFO Executing node qa_prompt. node run id: 0fa25423-edb1-4938-9e70-8862763cb8a8_qa_prompt_0 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> ======================================================== 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> [环节2] qa_prompt - 大模型生成开始 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 步骤1/4 加载模型配置(.env)... 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 模型: hy3 | 接口: https://tokenhub.tencentmaas.com/v1/chat/completions 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 密钥: sk-ymL**** (已脱敏) 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 步骤2/4 组装 system/user 消息... 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> system: 严格依据上下文回答,禁止编造 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> user : 上下文[48字] + 问题[Prompt Flow是什么?] 2026-08-17 22:35:16 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 步骤3/4 调用混元模型推理... 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 请求成功,消耗 tokens: 98 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 步骤4/4 解析并返回回答... 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> 回答: 根据参考上下文,Prompt Flow 是用于搭建、评估大模型应用流程的工具,它支持可视化调试、批量测试与一键部署 AI... 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> [环节2] qa_prompt - 大模型生成完成 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [qa_prompt in line 0 (index starts from 0)] stdout> ======================================================== 2026-08-17 22:35:17 +0800 21372 execution.flow INFO Node qa_prompt completes. 2026-08-17 22:35:17 +0800 21372 execution.flow INFO Executing node output_summary. node run id: 0fa25423-edb1-4938-9e70-8862763cb8a8_output_summary_0 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [output_summary in line 0 (index starts from 0)] stdout> ======================================================== 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [output_summary in line 0 (index starts from 0)] stdout> [环节3] output_summary - 结果汇总 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [output_summary in line 0 (index starts from 0)] stdout> 问题: Prompt Flow是什么? 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [output_summary in line 0 (index starts from 0)] stdout> 上下文来源: 本地文档库 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [output_summary in line 0 (index starts from 0)] stdout> 回答: 根据参考上下文,Prompt Flow 是用于搭建、评估大模型应用流程的工具,它支持可视化调试、批量测试与一键部署 AI 服务。 2026-08-17 22:35:17 +0800 21372 execution.flow INFO [output_summary in line 0 (index starts from 0)] stdout> ======================================================== 2026-08-17 22:35:17 +0800 21372 execution.flow INFO Node output_summary completes. { "answer": "[执行汇总]\n问题: Prompt Flow是什么?\n回答: 根据参考上下文,Prompt Flow 是用于搭建、评估大模型应用流程的工具,它支持可视化调试、批量测试与一键部署 AI 服务。" }
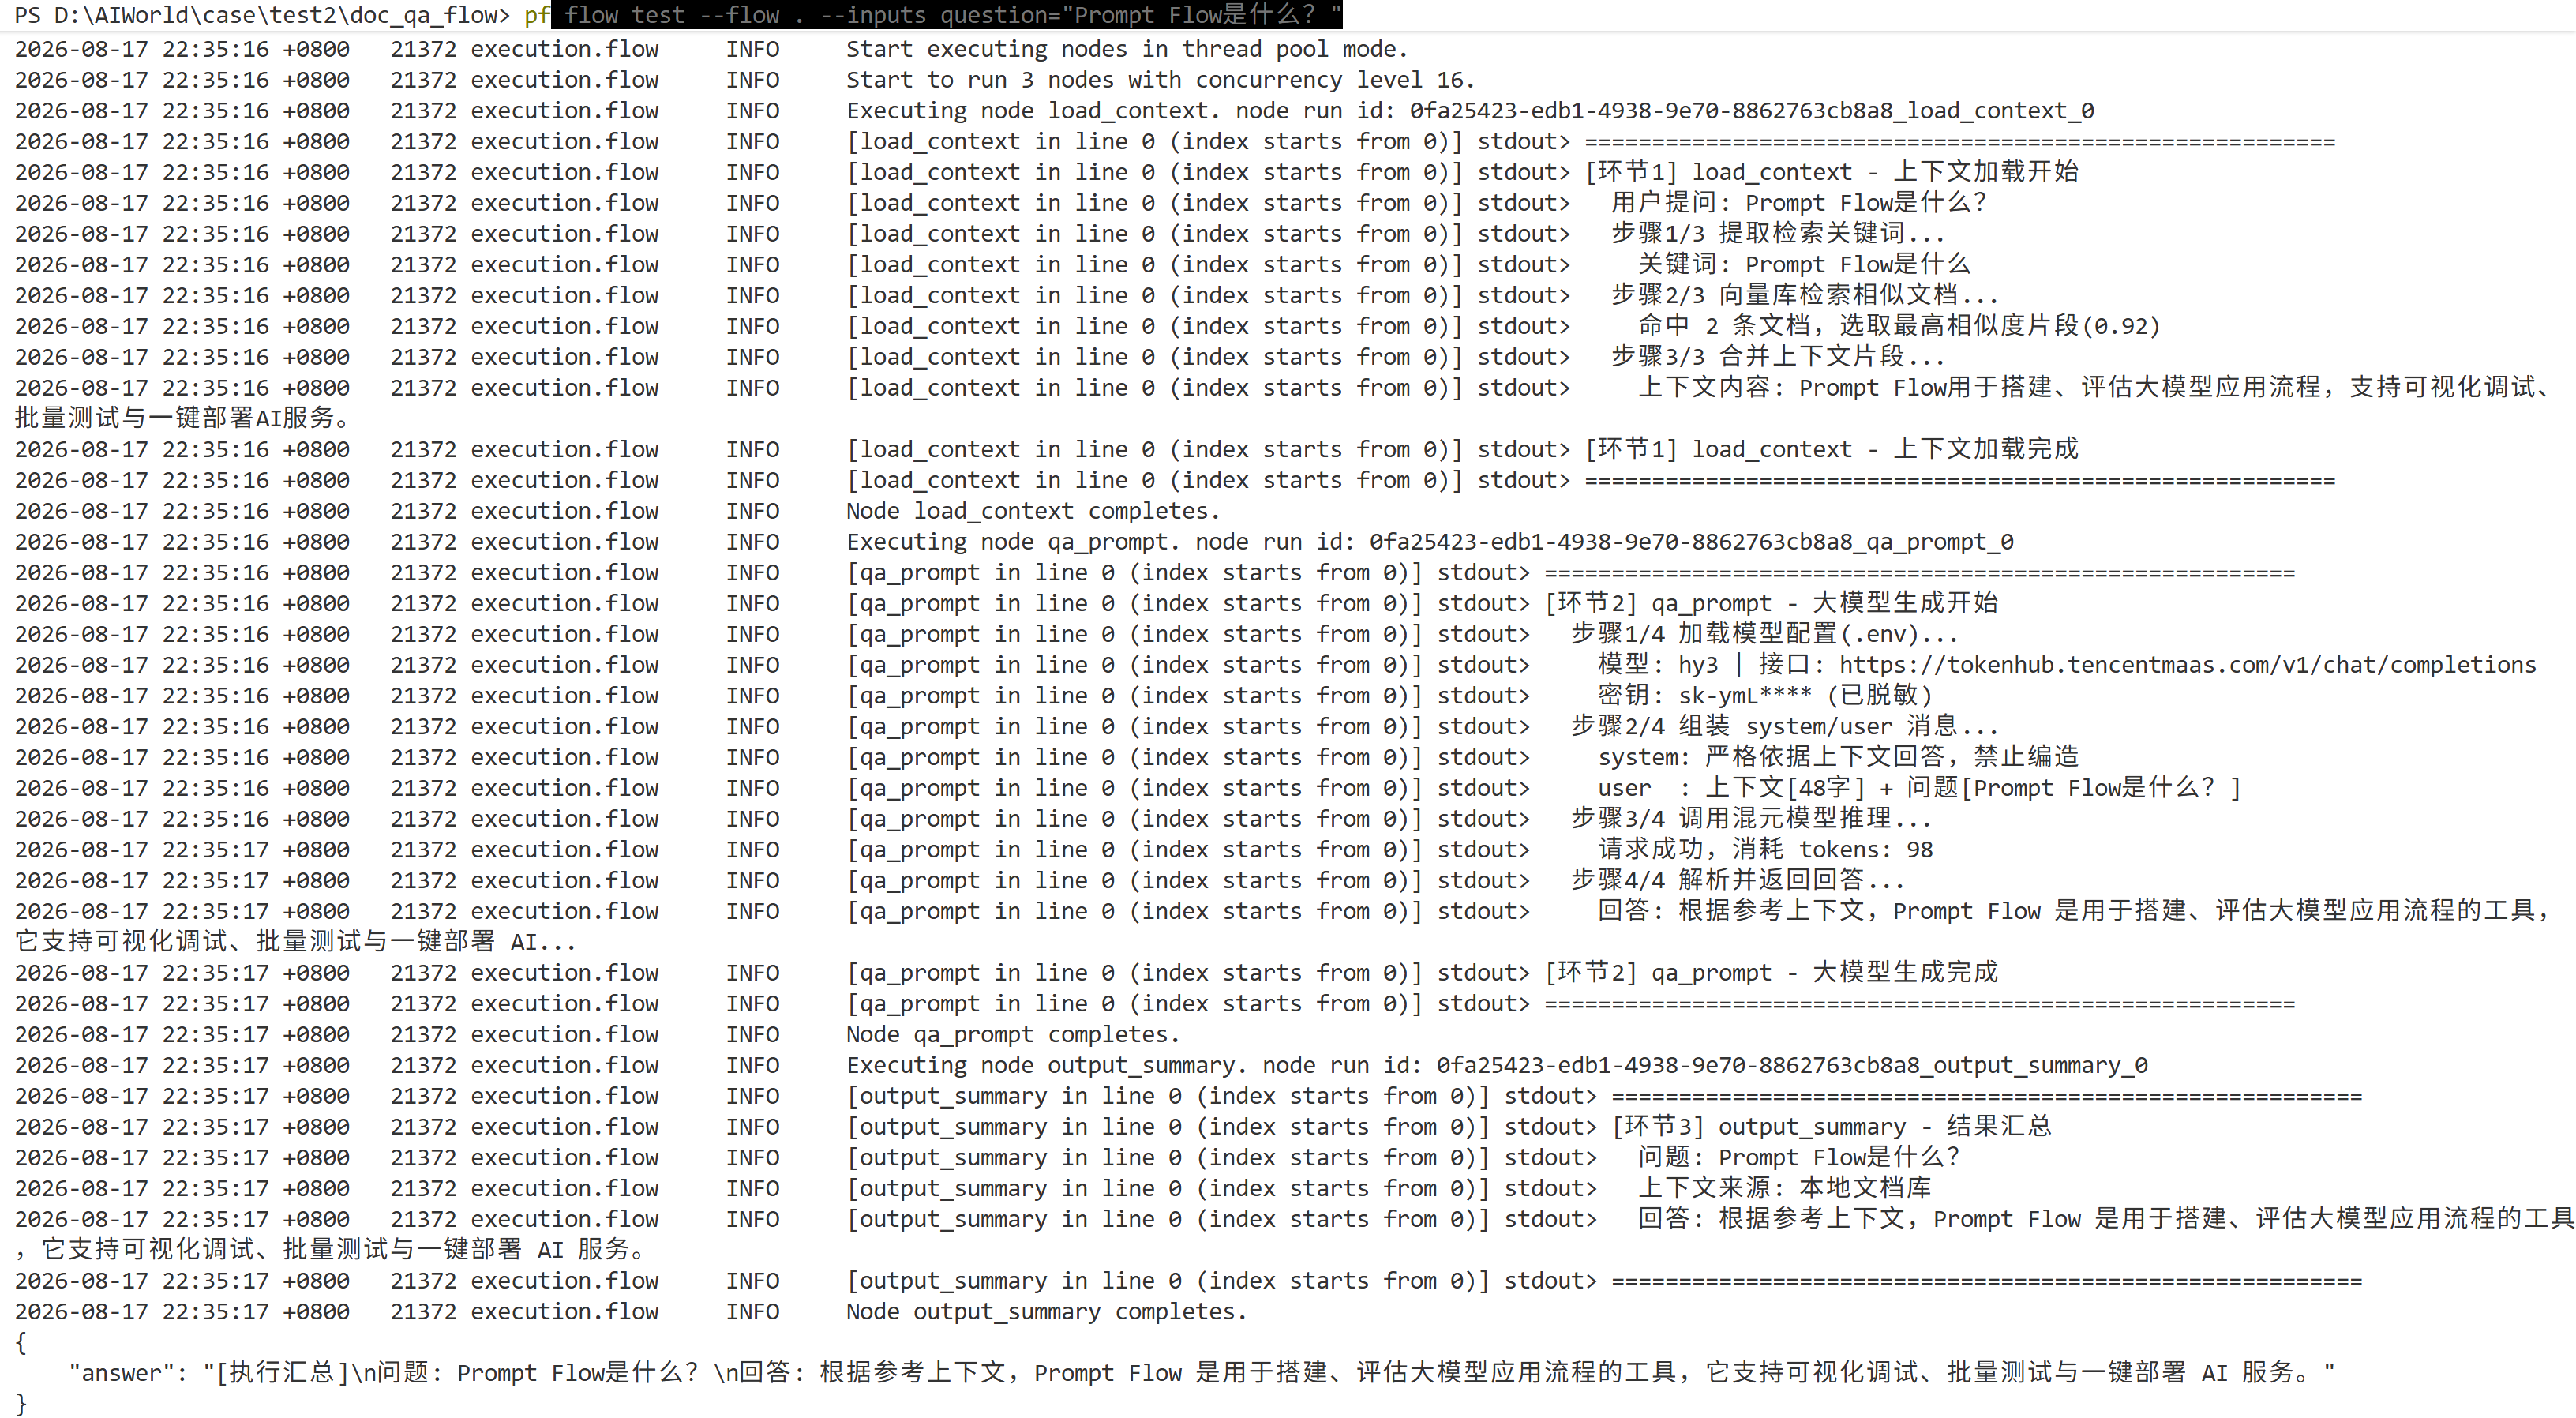
输出说明:
- 日志完整性:依次打印三个节点的完整执行过程,清晰展示关键词提取、文档检索、配置加载、提示词组装、接口请求每一步细节,同时脱敏展示密钥、统计token消耗,兼顾安全与可调试性。
- 回答精准度:最终输出结果格式规整、逻辑清晰,回答内容严格基于预设知识库,精准阐述Prompt Flow核心功能与优势,无编造、无偏差、无幻觉问题。
- 可拓展性:我们可自由修改inputs.json中的提问内容,快速测试各类问答场景,适配基础开发调试需求。
六、应用实践优化总结
1. 本地RAG知识库升级
以上示例采用模拟知识库检索逻辑,仅适用于基础演示,真实企业落地场景中,可快速升级为完整成熟的RAG知识库系统:
- 文档解析升级:替换原有模拟文档列表,新增PDF、Word、TXT等多格式本地文档解析逻辑,支持企业私有文档批量导入。
- 向量数据库对接:接入FAISS、Chroma等轻量向量数据库,实现文档切片、向量存储、相似度召回能力,支撑海量知识库检索。
- 检索逻辑优化:新增文档权重排序、相似度阈值过滤、多文档拼接整合功能,大幅提升知识库问答的精准度与专业性。
2. 多节点流程拓展
基础三节点问答流程可自由拓展迭代,适配各类复杂AI任务场景,可新增的常用拓展节点与功能如下:
- Prompt优化节点:自动打磨、优化提示词,提升模型回答质量与稳定性。
- 多模型对比节点:同时调用多个大模型,对比回答效果,择优输出最优结果。
- 结果校验节点:对模型输出内容做合规性、准确性校验,过滤无效、违规、错误回答。
- 多轮对话记忆节点:留存历史对话上下文,实现连续问答、多轮推理,适配智能客服、人机交互场景。
七、总结
区别于传统零散的Prompt调试,Prompt Flow真正实现了大模型应用的工程化、标准化、可视化、可落地,解决了LLM开发不稳定、难调试、难复用、难部署的核心痛点。
对于我们开发者而言,大模型开发真的不只是简单写写提示词那么简单。刚开始我们都以为Prompt靠语感随便写就行,但真正落地场景后就会发现,零散的Prompt极不稳定、没法迭代、更不能商用,而Prompt Flow的出现,刚好补齐了传统Prompt开发的所有短板。掌握Prompt Flow是从“只会写提示词”进阶到“会工程化落地AI项目”的关键一步。它降低了复杂LLM应用的开发门槛,让我们都能快速搭建稳定、高效、可迭代的大模型业务流程。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号