#WorkBuddy# 400 份祖传乱码文件 0.25 秒体检:把无损率从 72% 拉到 90%
原创
#WorkBuddy# 400 份祖传乱码文件 0.25 秒体检:把无损率从 72% 拉到 90%
原创
用户12784192
发布于 2026-10-06 10:28:35
发布于 2026-10-06 10:28:35
#WorkBuddy# 400 份祖传乱码文件 0.25 秒体检:把无损率从 72% 拉到 90%
痛点:乱码最可怕的不是报错,而是不报错
接手任何一个有年头的目录,都可能遇到这种情况:一批文本文件,有人用 UTF-8 存的,有人用记事本存成了 GBK,还有几份是从老系统导出的 Big5 和 UTF-16。双击打开,一部分正常,一部分满屏"锟斤拷",更隐蔽的那部分——居然也能读,只是偶尔冒出一个方块问号。
多数人的第一反应是写一段教科书式的代码:
for enc in ("utf-8", "gbk", "latin-1"): try: return raw.decode(enc) except UnicodeDecodeError: continue
这段代码的问题是:它只在"崩"的时候换策略,从来不验证"猜对了没有"。GBK 的字节几乎总能被 GB18030 或 CP1252 强行解出点什么,于是流程一路绿灯地走完,输出一份看起来正常、实际已经损坏的文件。乱码最可怕的不是报错,而是不报错——你根本不知道哪些文件被悄悄写坏了。
根因:解码是"猜",猜完不复核等于没做
文本文件里没有元数据标注编码,解码本质上是统计推断。三个常见盲区:
- BOM 盲区:带 BOM 的 UTF-8 用 utf-8 解码会在开头残留一个 U+FEFF 隐形字符,肉眼不可见,却会让后续 diff、搜索、入库全部出错;
- 无 BOM 的 UTF-16 盲区:检测器对它是重灾区,纯统计方法几乎必然漏判;
- 单候选盲区:只取检测器的 top1 结果,而 GBK/GB18030、Big5/GBK 字节高度重叠,top1 错了就全错。
解法不是换更聪明的检测器,而是把"猜"变成"猜 + 验 + 认错"三级闭环:先尽可能猜准,再用逐字节校验复核,复核不过就老实隔离,绝不带病输出。
实测:400 份文件、8 种编码、40 份人为损坏
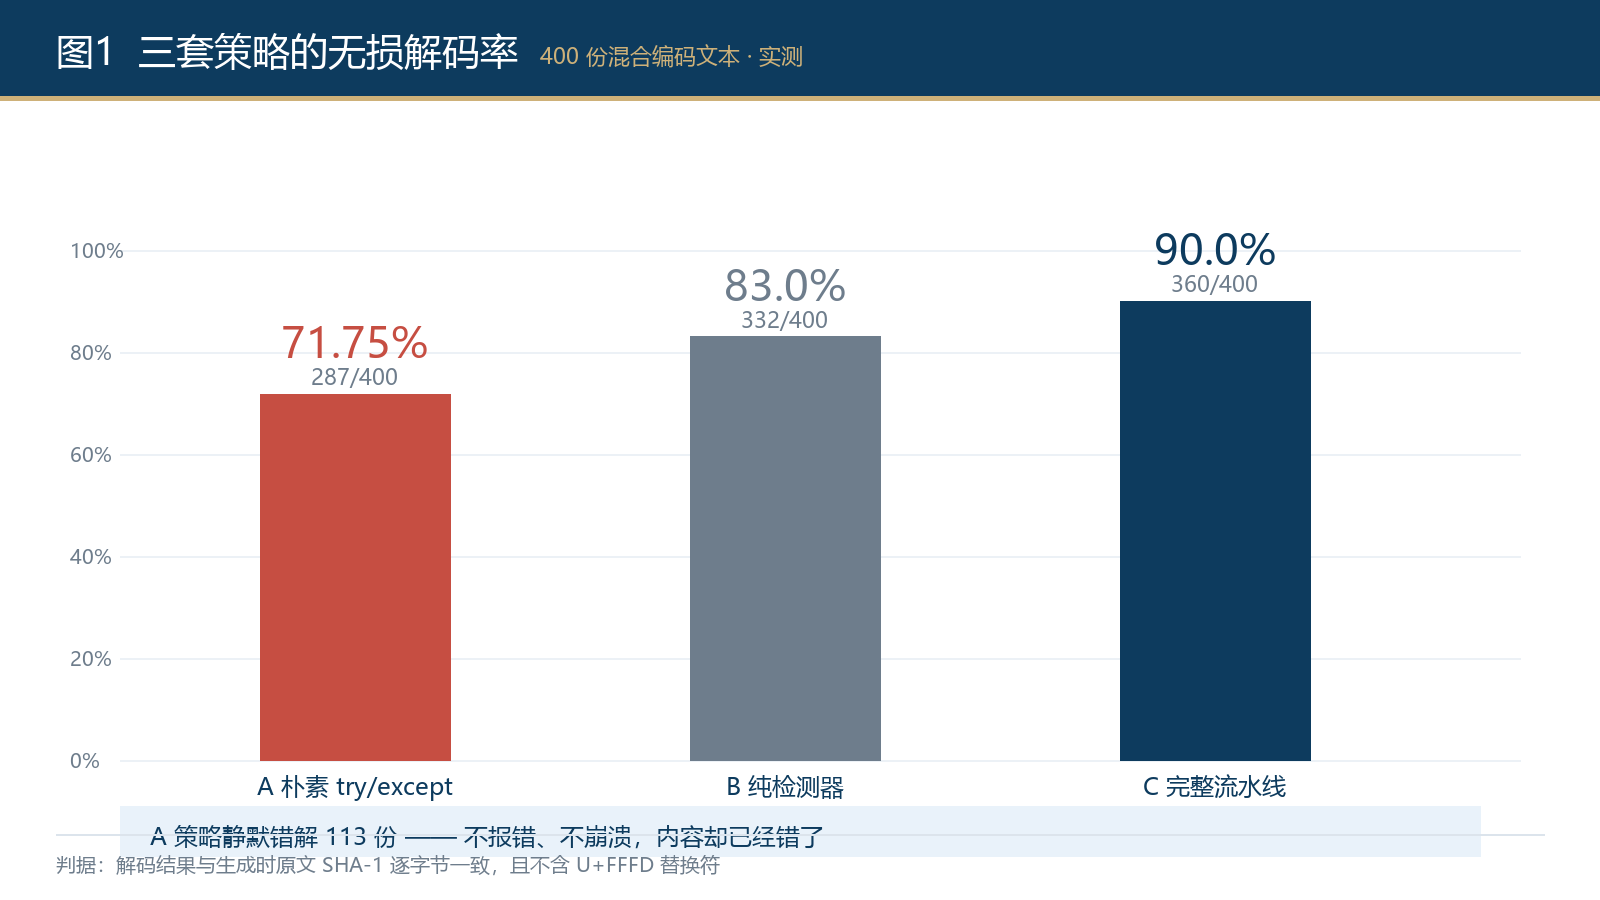
我合成了一批通用技术笔记语料:400 个文件共 1.68 MB,覆盖 8 种编码(UTF-8、UTF-8-BOM、GBK、GB18030、Big5、CP1252、无 BOM 的 UTF-16LE/BE),并随机向 40 个文件尾部注入了另一种编码的字节(模拟"多人多编辑器追加写"造成的混合损坏)。每份文件保留了生成时的 SHA-1,解码结果与原文逐字节比对,不含 U+FFFD 替换符才算"无损"。三套策略同题竞速:
策略 | 无损 | 无损率 | 说明 |
|---|---|---|---|
A 朴素 try/except | 287/400 | 71.75% | 静默错解 113 份 |
B BOM+纯检测器 | 332/400 | 83.00% | 无 BOM 的 UTF-16 全军覆没 |
C 完整五级流水线 | 360/400 | 90.00% | 40 份损坏文件全部拦截 |
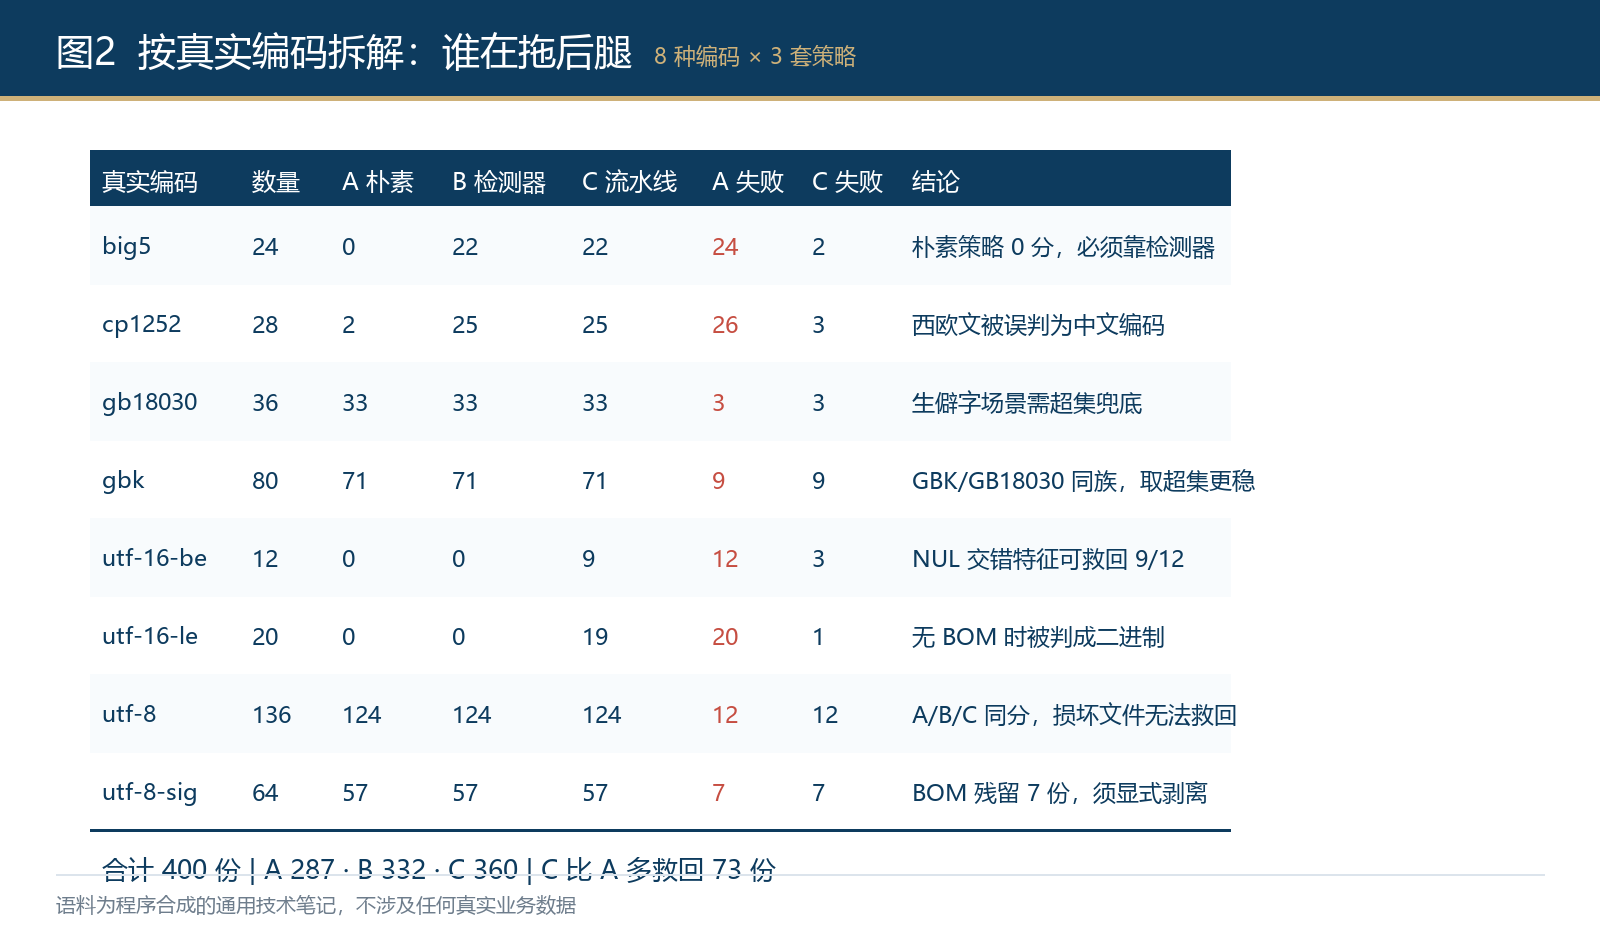
拆到编码维度更能说明问题:Big5 在朴素策略下 0/24 全灭;UTF-16LE/BE 在纯检测器下 0/32 全灭;加上"NUL 字节奇偶位交错"这条结构规则后,UTF-16 立刻救回 28 份。C 策略比 A 多救回 73 份文件,而隔离区精准命中全部 40 份损坏文件:召回 100%、精确 100%、误伤 0。
性能上完全不是瓶颈:400 份文件完整流水线 0.245 秒跑完,吞吐 6.87 MB/s,单文件平均 0.61 毫秒。也就是说,哪怕目录里是几万份文件,也只是分钟级的一次性成本。
可复制代码:五级决策流水线
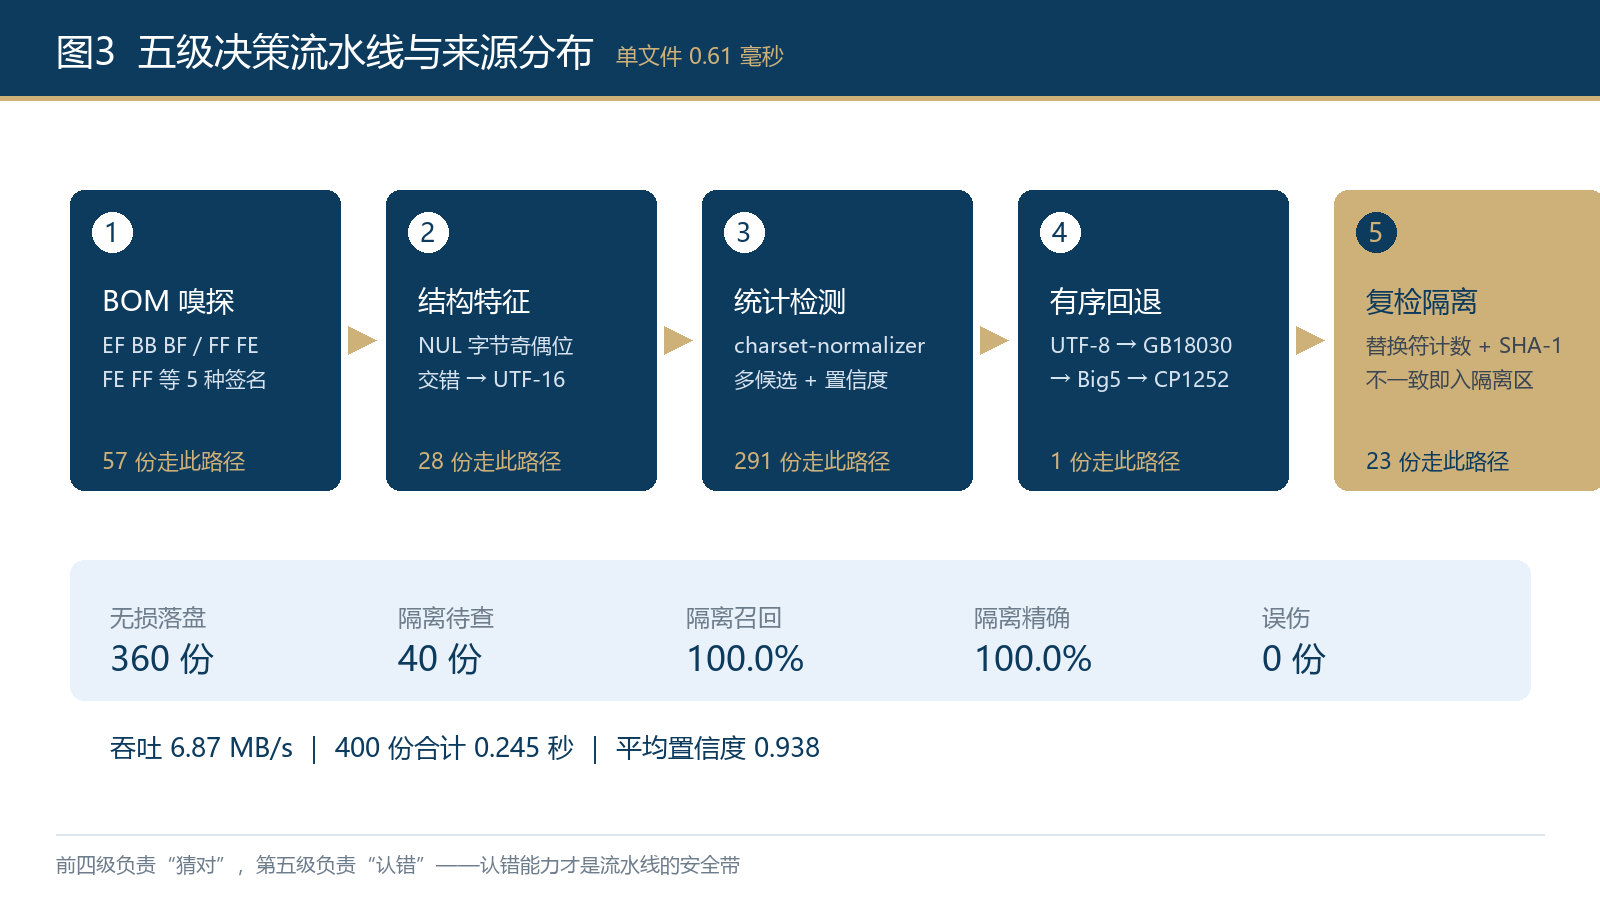
核心逻辑如下,可直接套用(pip install charset-normalizer):
import hashlib
from charset_normalizer import from_bytes

REPL = "\ufffd"  # U+FFFD 替换符

def nul_profile(raw: bytes):
    """无 BOM 的 UTF-16 会让 NUL 字节固定落在奇或偶位"""
    n = len(raw)
    if n < 8 or n % 2:
        return None
    ev = sum(raw[i] == 0 for i in range(0, n, 2)) / (n / 2)
    od = sum(raw[i] == 0 for i in range(1, n, 2)) / (n / 2)
    if ev > 0.30 and ev > od * 2: return "utf-16-be"
    if od > 0.30 and od > ev * 2: return "utf-16-le"
    return None

def smart_decode(raw: bytes):
    # 1) BOM 嗅探:5 种签名,最可靠,优先级最高
    for sig, enc in [(b"\xef\xbb\xbf", "utf-8-sig"), (b"\xff\xfe", "utf-16-le"),
                     (b"\xfe\xff", "utf-16-be")]:
        if raw.startswith(sig):
            return raw.decode(enc), enc, "bom"
    # 2) 结构特征:救检测器的盲区
    if (u := nul_profile(raw)):
        return raw.decode(u), u, "rule"
    # 3) 统计检测:多候选,GBK 家族取超集
    m = from_bytes(raw, steps=10, chunk_size=2048)
    if m and m.best():
        enc = m.best().encoding
        enc = "gb18030" if enc in ("gb2312", "gbk", "hz") else enc
        return raw.decode(enc), enc, "detect"
    # 4) 有序回退:从严到宽
    for enc in ("utf-8", "gb18030", "big5", "cp1252"):
        try:
            return raw.decode(enc), enc, "fallback"
        except UnicodeDecodeError:
            continue
    # 5) 认错:带病文本进隔离区,不带病输出
    return raw.decode("utf-8", errors="replace"), "utf-8", "replace"

def safe_convert(path_in: str, path_out: str):
    raw = open(path_in, "rb").read()
    text, enc, how = smart_decode(raw)
    if text.count(REPL) or text.startswith(REPL):
        open(path_out + ".quarantine", "w", encoding="utf-8").write(text)
        return enc, how, False          # 隔离,人工复查
    open(path_out, "w", encoding="utf-8").write(text)
    return enc, how, True               # 无损落盘
关键在第 5 级:errors="replace" 不是失败处理,而是隔离信号——解码结果里出现了替换符,说明这文件我们读不干净,写进 .quarantine 后缀等人工确认,绝不混进正常输出。
踩坑清单
utf-8-sig 与 utf-8 别混:读文件用 utf-8-sig 能自动剥 BOM,写文件用 utf-8-sig 会自动加 BOM,用错方向会让 BOM 搬家而不是消失; 检测器返回的编码名要先归一化:gb2312/hz 实际都该按 gbk 家族处理,再取超集 gb18030,否则生僻字必炸; Big5 与 GBK 互相"看起来都能解":单靠检测器 top1 会互串,置信度阈值加隔离复核才稳; 验证一定要用 SHA-1 逐字节比对,肉眼抽查在 400 份文件面前毫无意义; 二次编辑前先转码:在乱码文件上直接改内容再保存,损坏会被固化,神仙也救不回来。
在 WorkBuddy 里一句话完成
上面这套流水线不需要你写代码。把目录丢给 WorkBuddy,说:
帮我盘点 <目录> 下所有文本类文件的编码分布,逐个无损转成 UTF-8:先做 BOM 嗅探和 UTF-16 结构特征识别,再用 charset-normalizer 多候选检测,解码结果含替换符的文件单独隔离到 quarantine 子目录并出清单,最后给我一张"总数/无损/隔离/耗时"的汇总表,全程不要改动原文件。
WorkBuddy 会自己生成脚本、跑批、核对校验和并回传报告,你只需要看最后的数字。
收尾
编码治理是一次性的"还债":0.25 秒跑完 400 份文件,换来的是此后所有文本处理的确定性。三组数字值得记住——朴素策略 71.75%、纯检测器 83%、五级流水线 90%,而那 40 份真正损坏的文件,靠的不是更聪明的猜测,而是"敢于认错"的隔离机制。先体检、再转码、后入库,顺序不能反。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号