炸裂!Word、PPT、Excel、PDF终于不再各说各话:5.5k Star anydoc 一锅端成干净 Markdown
原创
炸裂!Word、PPT、Excel、PDF终于不再各说各话:5.5k Star anydoc 一锅端成干净 Markdown
原创
小华同学ai
发布于 2026-10-06 17:01:10
发布于 2026-10-06 17:01:10
嗨,我是小华同学,专注解锁高效工作与前沿AI工具!每日精选开源技术、实战技巧,助你省时50%、领先他人一步。👉免费订阅,与10万+技术人共享升级秘籍!
文档处理最烦的,往往不是“转成 Markdown”,而是 Word、PPT、Excel、PDF 每种格式都带着自己的脾气。
anydoc 的思路很直接:先把不同文件解析成同一个 Document 模型,再从同一条出口生成干净 Markdown。
如果你正在做 RAG、知识库、文档问答或 Agent 文件读取,这个项目值得先收藏。本文只讲它解决了什么问题,以及接入前必须知道的边界。
anydoc 封面:复古机场分拣风格,多个文档格式进入统一 Markdown 出口
文档转换最麻烦的,从来不是“转”
很多团队一开始会给每种文件找一个工具:DOCX 用一个解析器,PPTX 再接一个,PDF 还要单独处理,最后把结果拼到同一条 AI 流程里。
问题很快就会出现:
- 标题、列表、脚注和表格在不同格式里表现不一致;
- 同一份内容经过不同工具后,Markdown 规则、转义方式和空行习惯都不一样;
- 图片、嵌入对象和表格结构容易丢,后面的 RAG 切分只能继续打补丁;
- 文件扩展名改了,解析器可能就判断错,但文件内容本身并没有变。
真正难的是让“输入格式不同”不再影响“输出结构”。
anydoc 到底是什么?
一句话理解:anydoc 是一个用 Rust 编写的文档转换底座,把多种办公文档统一转成 GitHub-Flavored Markdown。
官方 README 列出的输入包括 Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV 和 PDF,同时提供 Rust、Node.js、Python、浏览器 WebAssembly 和 CLI 绑定。项目还附带 Agent Skill,可以让兼容的编程 Agent 直接学会调用它读取文档。
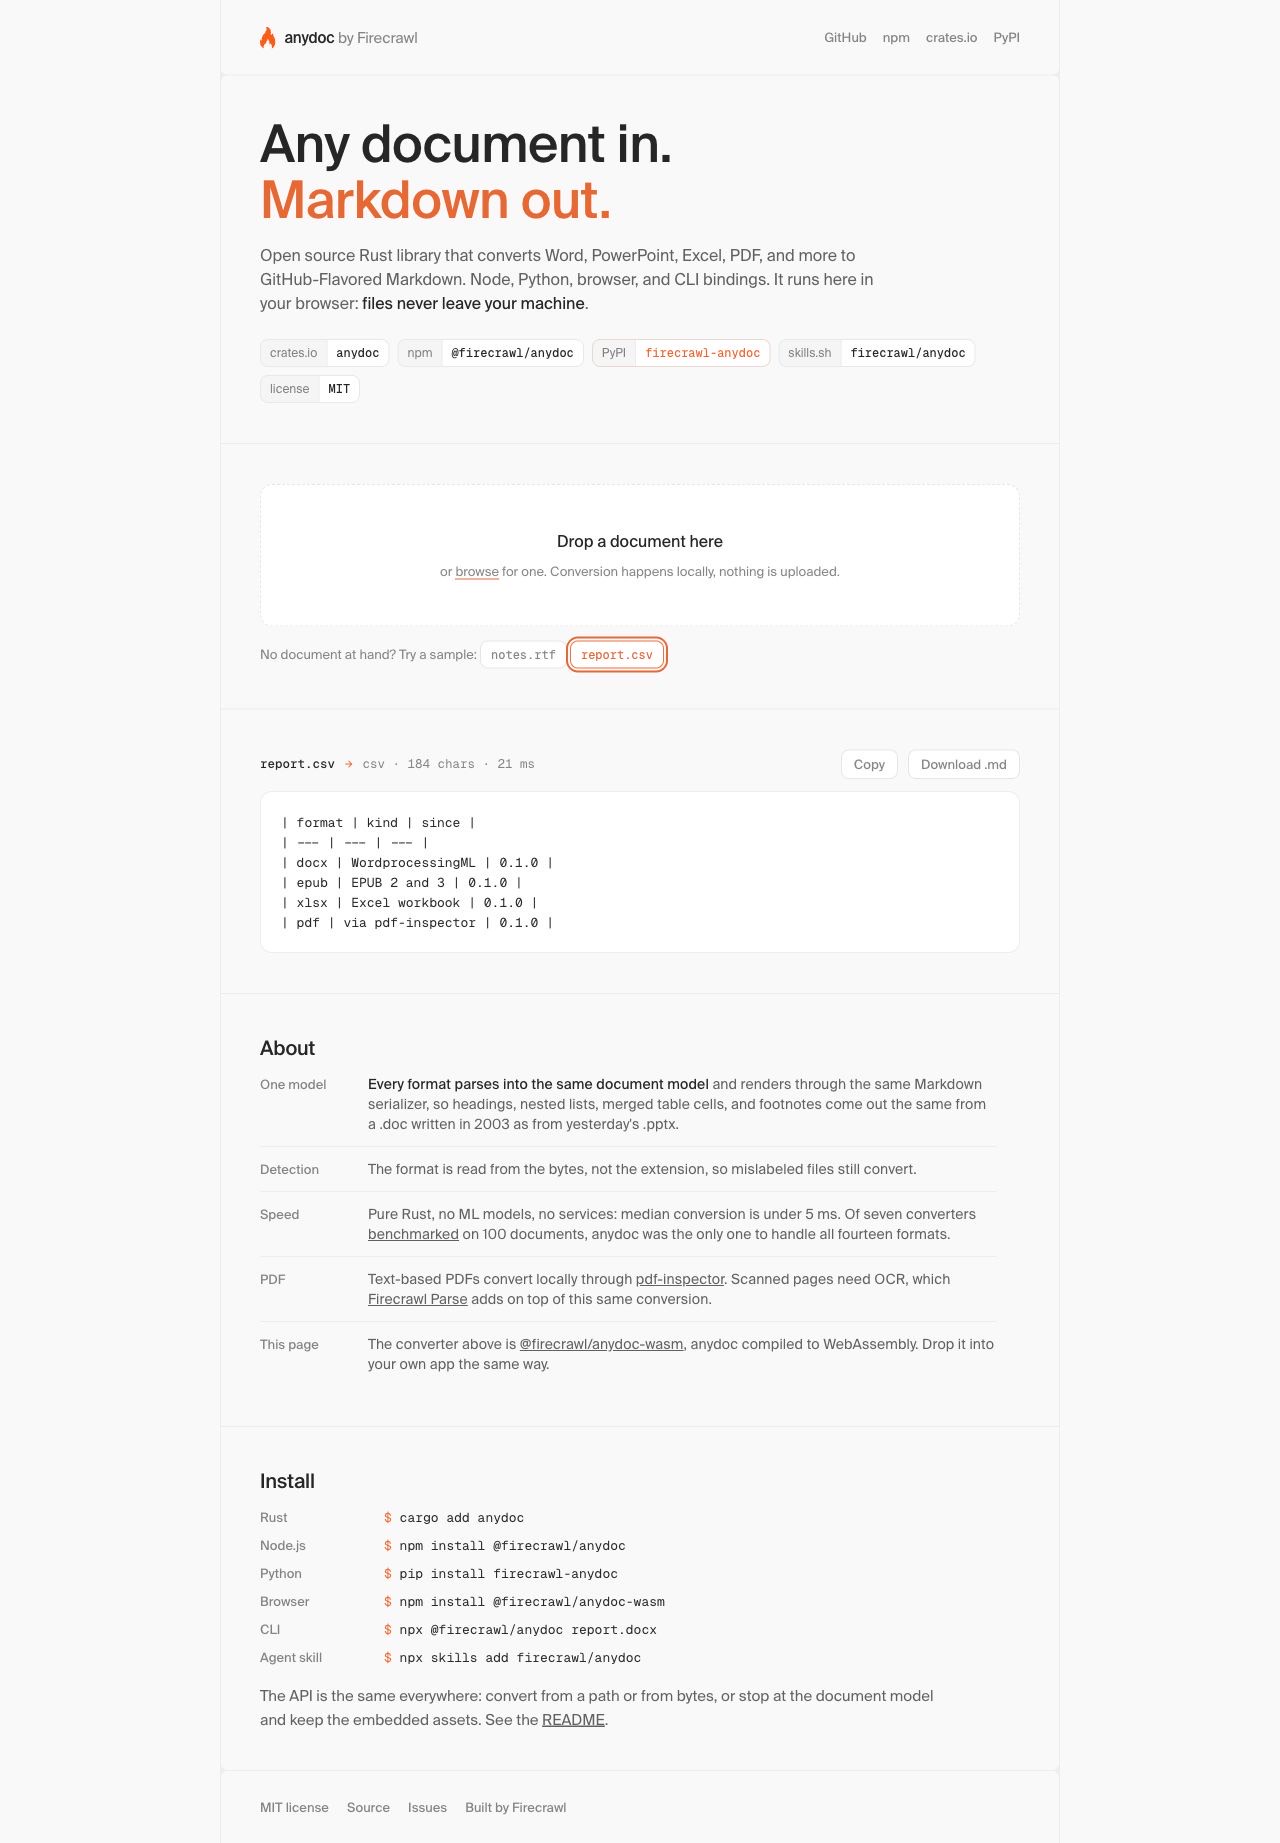
anydoc 项目原始素材:官方截图,浏览器端本地将 CSV 转换成 Markdown
官方在线 Demo 还有一个很值得注意的细节:浏览器版本使用 WebAssembly 在本地完成转换,文件不会上传到服务器。对于内部资料、合同和本地知识库,这个默认路径很有吸引力。
它的核心不是“格式多”,而是“中间模型统一”
处理环节 | 传统拼接式方案 | anydoc 的统一路线 |
|---|---|---|
文件识别 | 经常按扩展名分流 | 根据文件内容标记判断格式 |
解析结果 | 每个工具一套结构 | 汇入共享 Document 模型 |
Markdown 输出 | 各工具自己拼规则 | 统一 GFM 序列化器 |
表格、脚注、标题 | 需要逐格式修补 | 在统一输出层集中处理 |
嵌入图片和对象 | 容易在中间丢失 | 模型保留资源字节和媒体类型 |
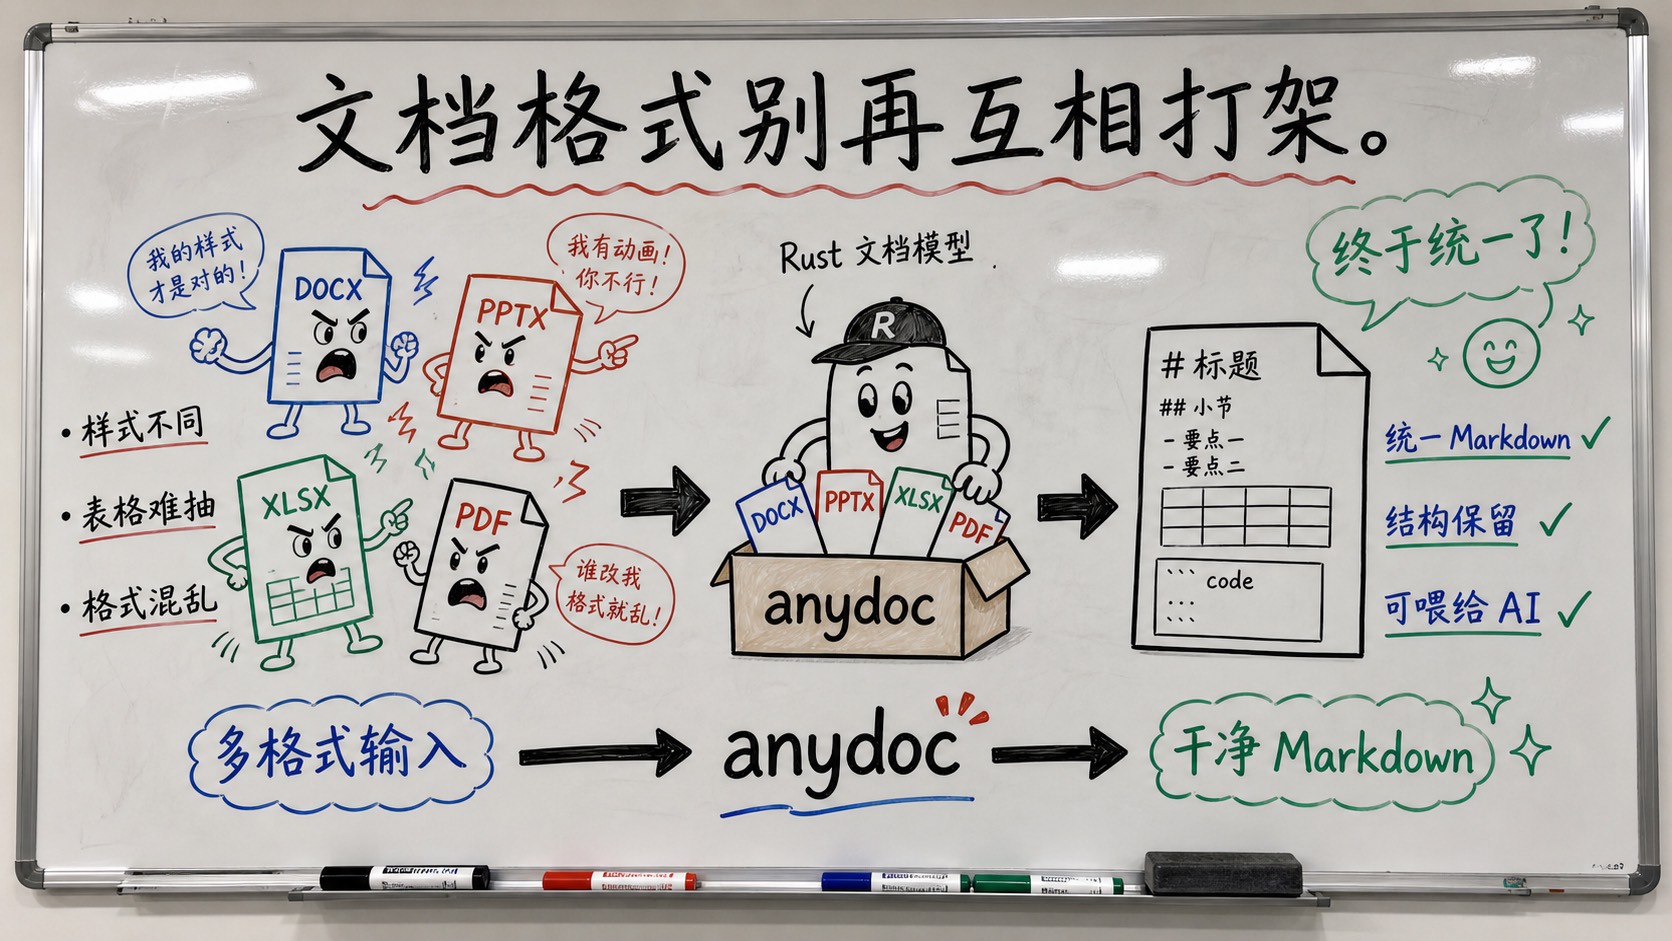
趣味创作白板图:DOCX、PPTX、XLSX、PDF 被 anydoc 统一成干净 Markdown
这个设计带来的实际收益是:修一次 Markdown 转义、表格或标题锚点问题,多个输入格式都能一起受益。
4 步看懂 anydoc 的工作流
- 读取文件字节,支持从路径或内存中的 bytes 开始;
- 根据 PDF 头、RTF 标记、OLE 流、ZIP 包中的 MIME 等内容判断格式;
- 把标题、段落、列表、表格、脚注、图片资源等汇入共享 Document 模型;
- 通过统一的 GFM Markdown 序列化器输出结果,或者停在 Document 模型继续加工。
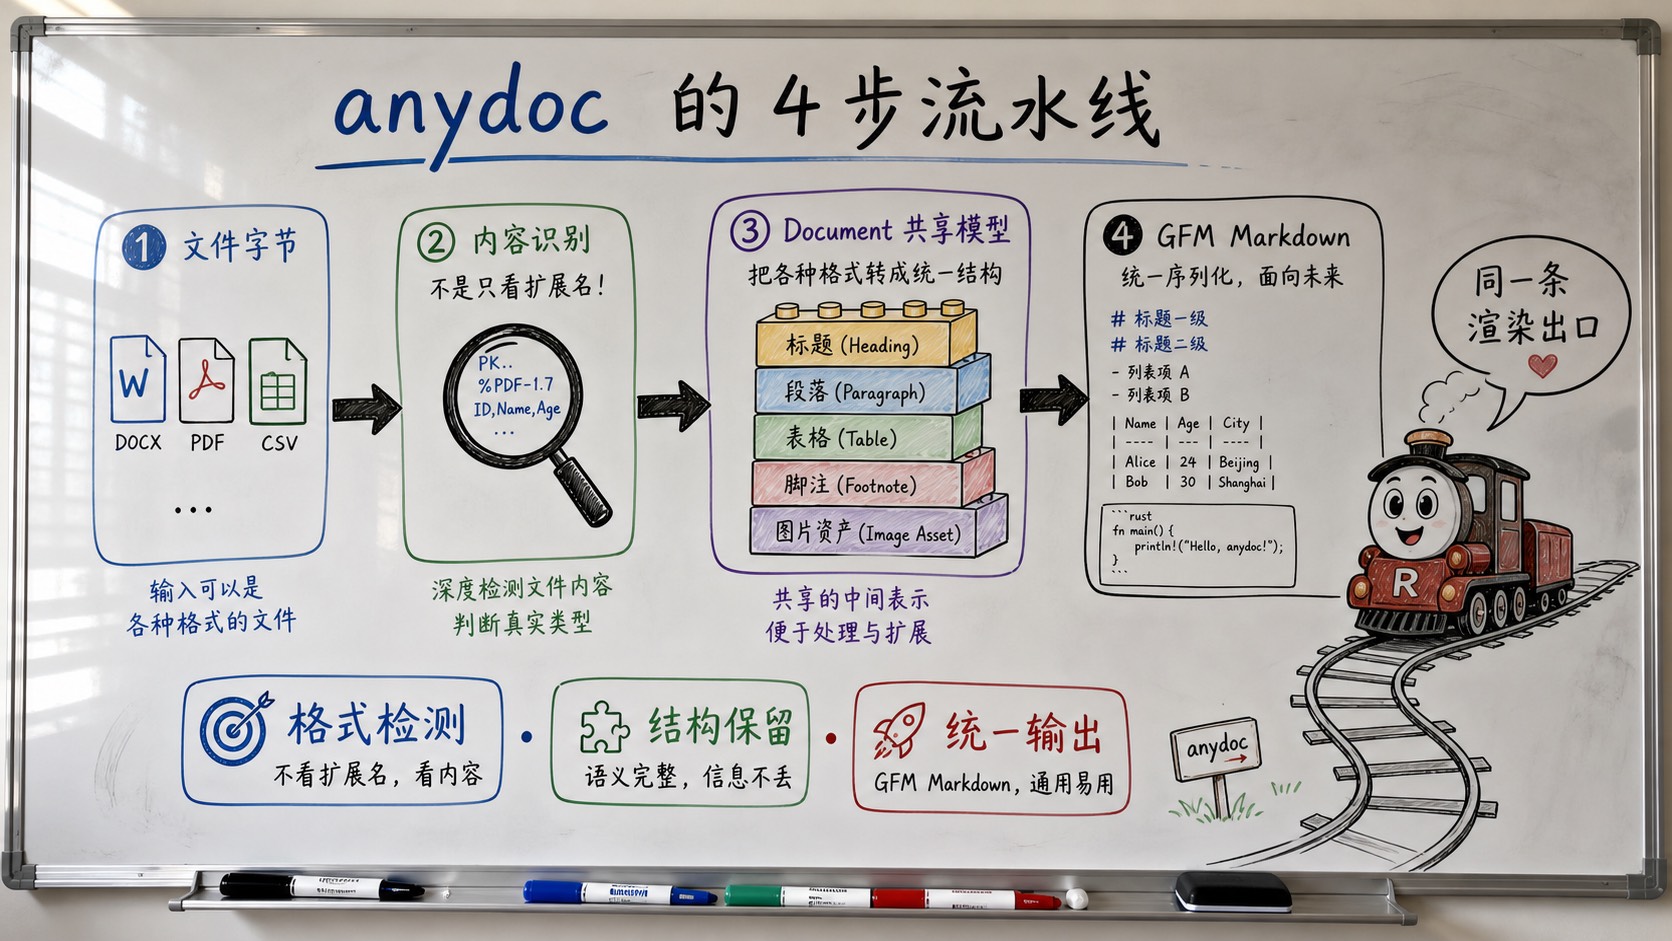
趣味创作白板图:anydoc 从文件字节到 GFM Markdown 的四步流水线
这条链路对 AI 应用尤其重要:你可以把 Markdown 作为通用中间格式,也可以保留 Document 模型里的图片和嵌入资源,不必一开始就把所有内容压扁成纯文本。
值得关注的 5 个能力
1. 输入格式覆盖够广
项目支持 .doc、.docx、.docm,多种 PowerPoint 和 Excel 格式,以及 OpenDocument、RTF、EPUB、CSV、PDF。对于“用户随手上传什么都可能有”的系统,这比只支持 DOCX 的解析器更省分流逻辑。
2. 结构保留不止正文
README 列出的结构包括标题锚点、粗体、斜体、删除线、行内代码、代码块、链接、内部交叉引用、嵌套列表、合并单元格、表头、引用、脚注、尾注和演讲者备注。
3. 嵌入资源不会被简单丢掉
图片和嵌入对象会在 Markdown 中以替代文本呈现,同时原始字节会保留在 Document 模型中,并带有媒体类型信息。做知识库时,你可以根据业务决定:只喂文字,还是把图片资产一起入库。
4. 本地、快速、少依赖
项目强调纯 Rust、无机器学习模型、无外部服务。README 的基准测试中,anydoc 在 100 份真实文档、14 种格式上给出的中位转换时间是 4.4ms。不过这是项目自己的测试结果,真实耗时仍要用你的文件集回归。
项目基准指标 | anydoc 结果 |
|---|---|
覆盖格式 | 14/14 |
中位转换时间 | 4.4ms |
综合得分 | 81 |
测试文档 | 100 份 |
5. Agent 接入成本很低
它不仅是一个库,还提供了 Agent Skill:
npx skills add firecrawl/anydoc
```bash
安装之后,Agent 可以把文档转换当成一个标准能力来调用。对 Codex、Claude Code、Cursor 这类需要读取项目资料和附件的工作流来说,这个入口比每次手写解析脚本更容易复用。
3 种最小接入方式
CLI:先快速验证一份文件
npx @firecrawl/anydoc report.docx
npx @firecrawl/anydoc slides.pptx -o slides.md
npx @firecrawl/anydoc - --format csv < data.csv
```bash
Node.js:接入后端或构建脚本
npm install @firecrawl/anydoc
```bashimport { toMarkdown, toMarkdownBytes } from '@firecrawl/anydoc'
const markdown = await toMarkdown('report.docx')
const fromBytes = await toMarkdownBytes(bytes, 'csv')
```bash浏览器:本地转换文件
npm install @firecrawl/anydoc-wasm
```bashimport init, { toMarkdownBytes } from '@firecrawl/anydoc-wasm'
await init()
const markdown = toMarkdownBytes(bytes)
```bash它适合什么,不适合什么?
适合:
- 多格式文件上传、知识库入库和 RAG 预处理;
- Agent 读取 DOCX、PPTX、CSV 等用户资料;
- 需要统一 Markdown 输出的内容流水线;
- 想在浏览器本地完成基础文档转换的工具。
不适合直接当成:
- 扫描件 PDF 的 OCR 引擎;
- 追求完全还原 Word 页面视觉效果的排版器;
- 对复杂图表、宏、密码保护文件零改动转换的万能工具;
- 不做真实文件回归,就直接承诺所有业务文档都能完美解析的黑盒。
项目边界与我的判断
anydoc 解决的是文档结构归一化,不是所有文档问题:
- 图片型 PDF 没有可提取文字时,仍然需要独立 OCR 能力;
- Markdown 本身无法完整表达 Word/PPT 的视觉布局,样式还原和语义转换要分开评估;
- 加密、损坏、未知格式和超过安全限制的文件会返回明确错误,业务层需要记录失败原因;
- 项目 benchmark 很亮眼,但你的文件可能包含特殊字体、复杂合并单元格或嵌入对象,必须建立自己的样本集。
如果你的系统正在被“每种文件一个解析器”拖慢,anydoc 值得作为统一入口试一轮。它最有价值的地方,不是格式列表很长,而是把格式差异压在解析层,把后续 AI、搜索和入库流程统一起来。
后续我会继续拆解它的 Document 数据结构、Node/Python 绑定和 Agent Skill 实际接入方式。
项目地址
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号