#WorkBuddy# 30 万行脏 CSV,一条流水线跑完归一/去重/补全/异常剔除/聚合
原创
#WorkBuddy# 30 万行脏 CSV,一条流水线跑完归一/去重/补全/异常剔除/聚合
原创
用户12784192
发布于 2026-10-07 09:53:12
发布于 2026-10-07 09:53:12
作者所处行业与岗位:信息技术服务业 · 数据与效率工具工程师 本文全部数据均由脚本合成(300,000 条订单样本,随机种子固定),不含任何真实业务数据。
一、脏数据不是"个别错",是"结构性错"
做数据的人都有同感:真正耗时间的不是分析,是"把数据弄干净"。一份从系统导出的 CSV,往往同时带着六种毛病——缺失、重复、格式不统一、异常值、空白字符、字段口径不一致。手动开表格一列列改,30 万行够改一整天。
这次的实验对象是我用脚本造出来的一份 30 万行订单 CSV。我故意把它"弄脏":金额有的写 1234.5、有的写 ¥1,234.50、有的写 1,234.5元;时间戳有 2026-03-05 14:23:00、有 2026/3/5 14:23、还有一串 Unix 秒;地区和状态混入空格与别名(已支付 / 已完成 / cancel);再撒上缺失单元格、整行重复、以及 -999999 这种异常值。
目标只有一个:用一条固定流水线,把脏数据推进去,把"干净、可直接聚合"的数据拿出来。
二、让 WorkBuddy 先把"脏"分类,我照单写代码
我没有一上来就写清洗脚本。先让 WorkBuddy 通读表头和 20 行样本,让它输出"问题清单 + 处理策略"。它的回答基本确定了我后面的骨架:
- 格式类 → 归一化(去符号、去千分位、统一日期)
- 重复类 → 先归一、再按"业务主键 + 全字段"去重
- 缺失类 → 分列策略:数值型用中位数,分类型用"未知",文本型用"无"
- 异常类 → 越界值先置空、再按缺失策略补,避免污染聚合
- 聚合类 → 只在"有效状态"(已付款 / 已完成)上求和
这份清单比我自己拍脑袋想得全,尤其是"先归一再去重"这一步——顺序反了,重复就删不干净。
三、流水线的五个阶段
① 归一:把每一列变成"可比较的标准值"。金额剥掉 ¥、元、千分位;数量剥掉 件;时间戳按"纯数字且长度 ≥9 → Unix 秒,否则按三种日期格式依次尝试"。
② 去重:分两轮。第一轮按原始字符串判重,第二轮按归一后的关键列判重。两轮之差,就是"肉眼看着不一样、其实是同一条"的模糊重复。
③ 补缺:按列策略填充,同时记录每列的缺失数,便于回头质控。
④ 治异常:金额 < 0 或 > 100 万的、数量不在 1–1000 区间的,先判为异常、置空,再走补缺逻辑。
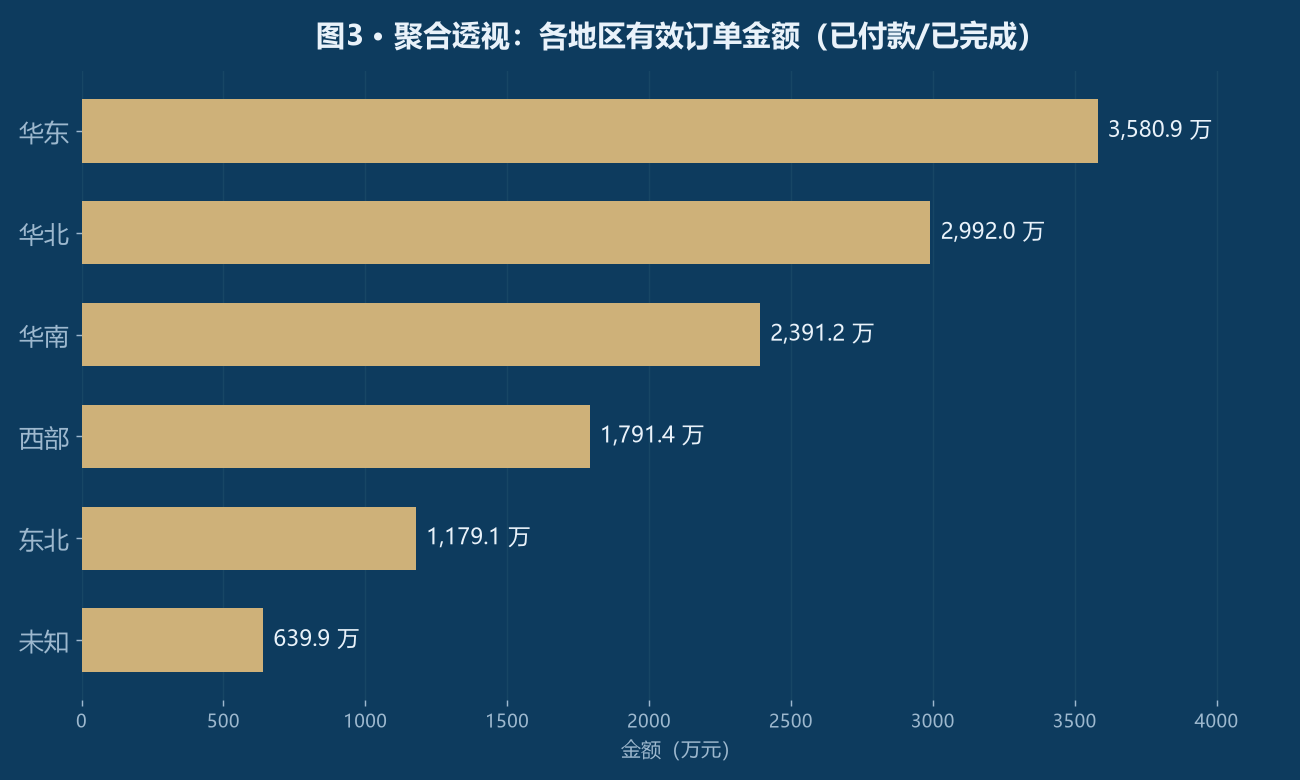
⑤ 聚合透视:清洗干净后,才做"各地区有效订单金额"的汇总。
四、真实跑批结果(非示意)
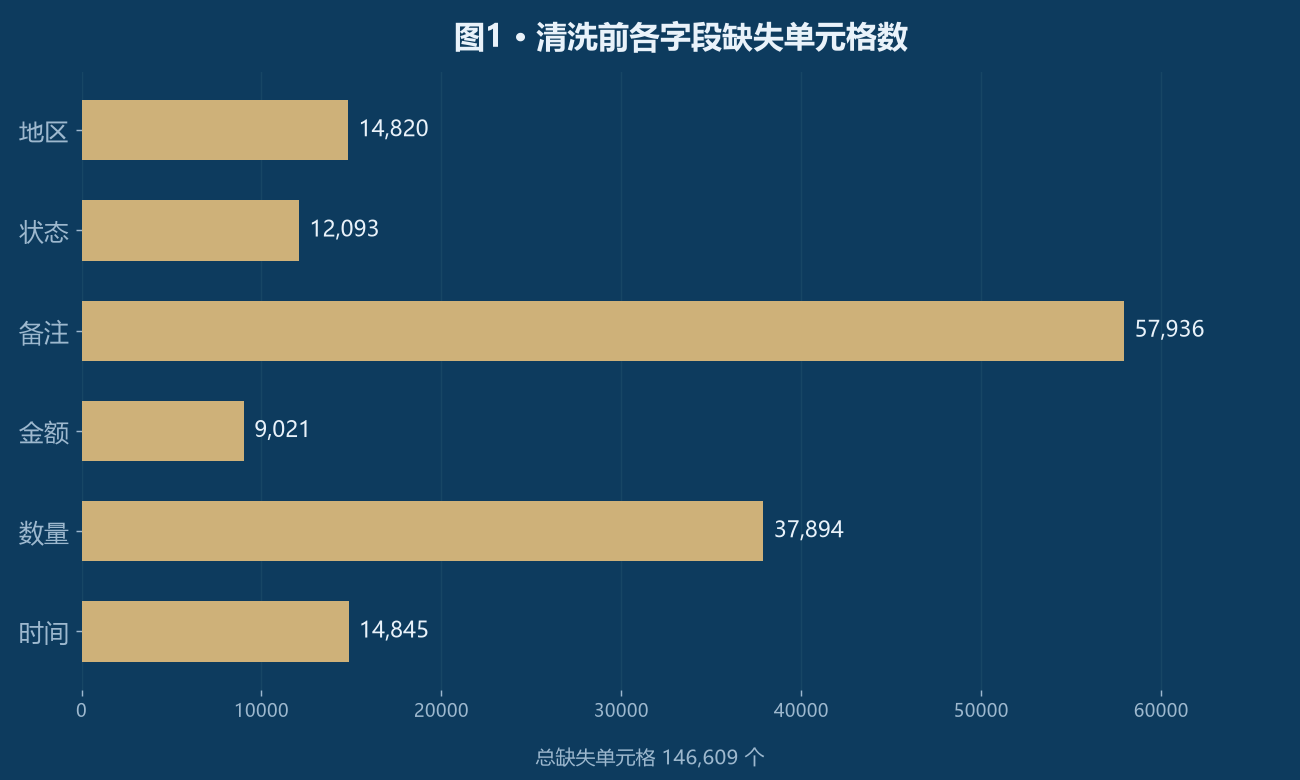
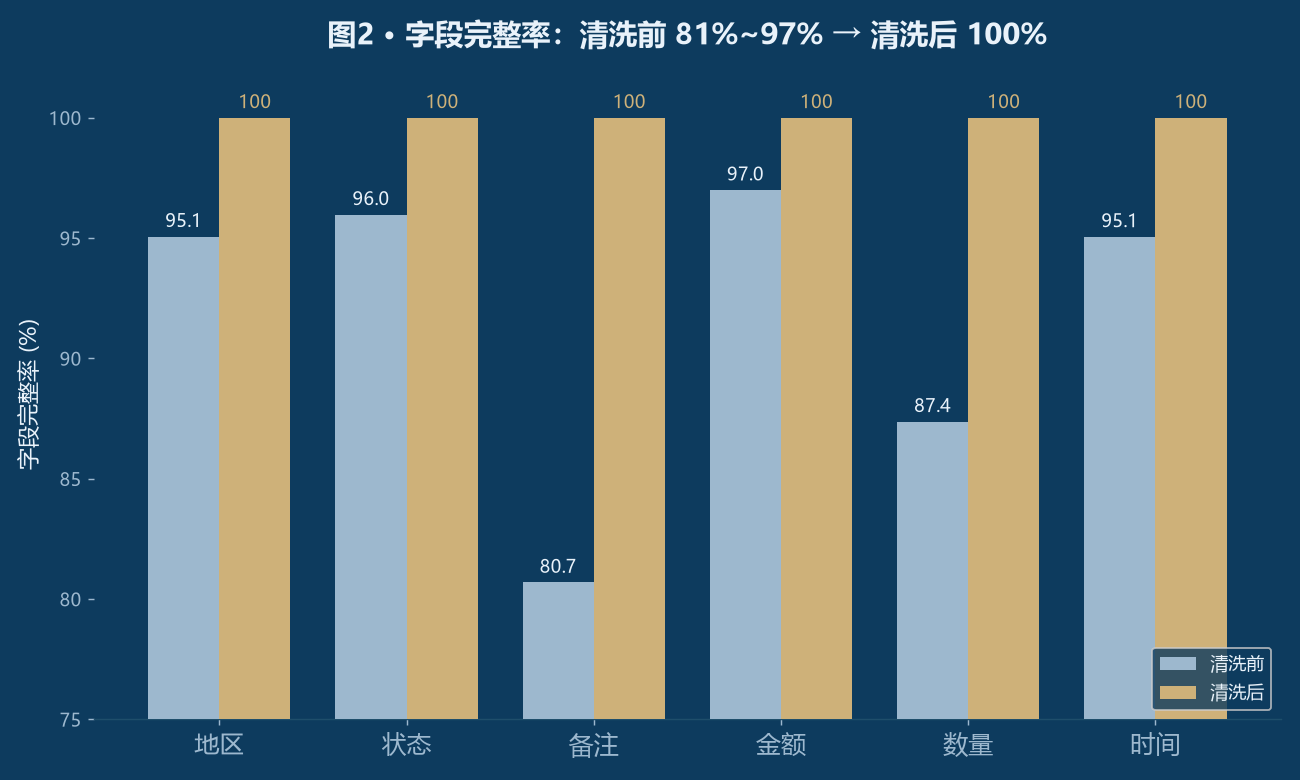
原始行数 308,852 | 清洗后行数 300,000 | 删除重复行 8,852(其中 3,738 靠归一化才现形) 修复缺失单元格 146,609 | 修正异常值 721(金额 448 / 数量 273) 金额补全中位数 403.53 | 数量补全众数 16 | 清洗耗时 42.67 秒
一句话:30 万行、14.6 万个空洞、8,852 条重复,42 秒收工。 关键是这 42 秒可复现、可重跑,换一份新数据只改路径。
五、核心代码(一段就够)
import pandas as pd, numpy as np

df = pd.read_csv("raw.csv", dtype=str, keep_default_na=False)

# 1) 归一
df["region_n"] = df["region"].str.strip()
df["status_n"] = df["status"].str.strip().replace(
    {"已支付": "已付款", "完成": "已完成", "cancel": "已取消"})
df["amount_v"] = (df["amount"].str.replace(r"[¥元,]", "", regex=True)
                  .apply(lambda x: float(x) if x.strip() else np.nan))
df["ts_v"] = df["ts"].map(parse_ts)          # 纯数字→Unix秒,否则按三种日期格式试

# 2) 去重(按归一后关键列)
keys = ["order_id", "ts_v", "region_n", "amount_v", "qty_v", "status_n"]
df = df.drop_duplicates(subset=keys)

# 3) 治异常 → 补缺
df.loc[(df.amount_v < 0) | (df.amount_v > 1_000_000), "amount_v"] = np.nan
df["amount_v"] = df["amount_v"].fillna(df["amount_v"].median())
df["region_n"] = df["region_n"].replace("", "未知")

# 4) 聚合透视
valid = df[df.status_n.isin(["已付款", "已完成"])]
pivot = valid.groupby("region_n")["amount_v"].agg(["sum", "count"])
六、三个真实的坑
坑一:先补缺再去重 = 白干。 我第一版先填了缺失、再判重,结果"一条空备注、一条写了备注"的两条记录永远不相等,重复删不干净。必须先归一、再去重、最后补缺。 坑二:**
x or np.nan** 在 0 值上翻车。 金额为0是合法值,但0 or np.nan会返回np.nan,把 0 元订单误判成缺失。判断空值要用x.strip()=='',不能用真值判断。 坑三:**float('')** 直接抛异常。 缺失单元格转 float 会ValueError,整条 pipeline 中断。所有转换都要包一层 try/except 或先判空——脏数据里"空字符串"比"数字"更常见。
七、收尾
这套流水线最大的价值不是"快",而是把清洗从"手工作坊"变成"可重跑的工序":同一个脚本,今天跑订单、明天跑流水、后天跑对账,只要换列名映射。配合 WorkBuddy 先把"脏"分类、我照着写代码,整个链条从"改一天表"压到"42 秒出结果"。
数据均由脚本合成,随机种子
20261007固定,任何人重跑都能得到同一份结果。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号