十个样本一起到达,为什么不能共用一个采样时间?
原创
十个样本一起到达,为什么不能共用一个采样时间?
原创
用户12804073
修改于 2026-10-07 20:12:11
修改于 2026-10-07 20:12:11
设备每隔一段时间采一个点,攒够十个点再发给电脑。接收程序给这十个点填上同一个“当前时间”,写进 CSV。图能画出来,却看不出这十次采样之间真正的间隔。
问题不一定出在传感器。接收端记录了数据到达的时间,随后把它当成了采样时间。
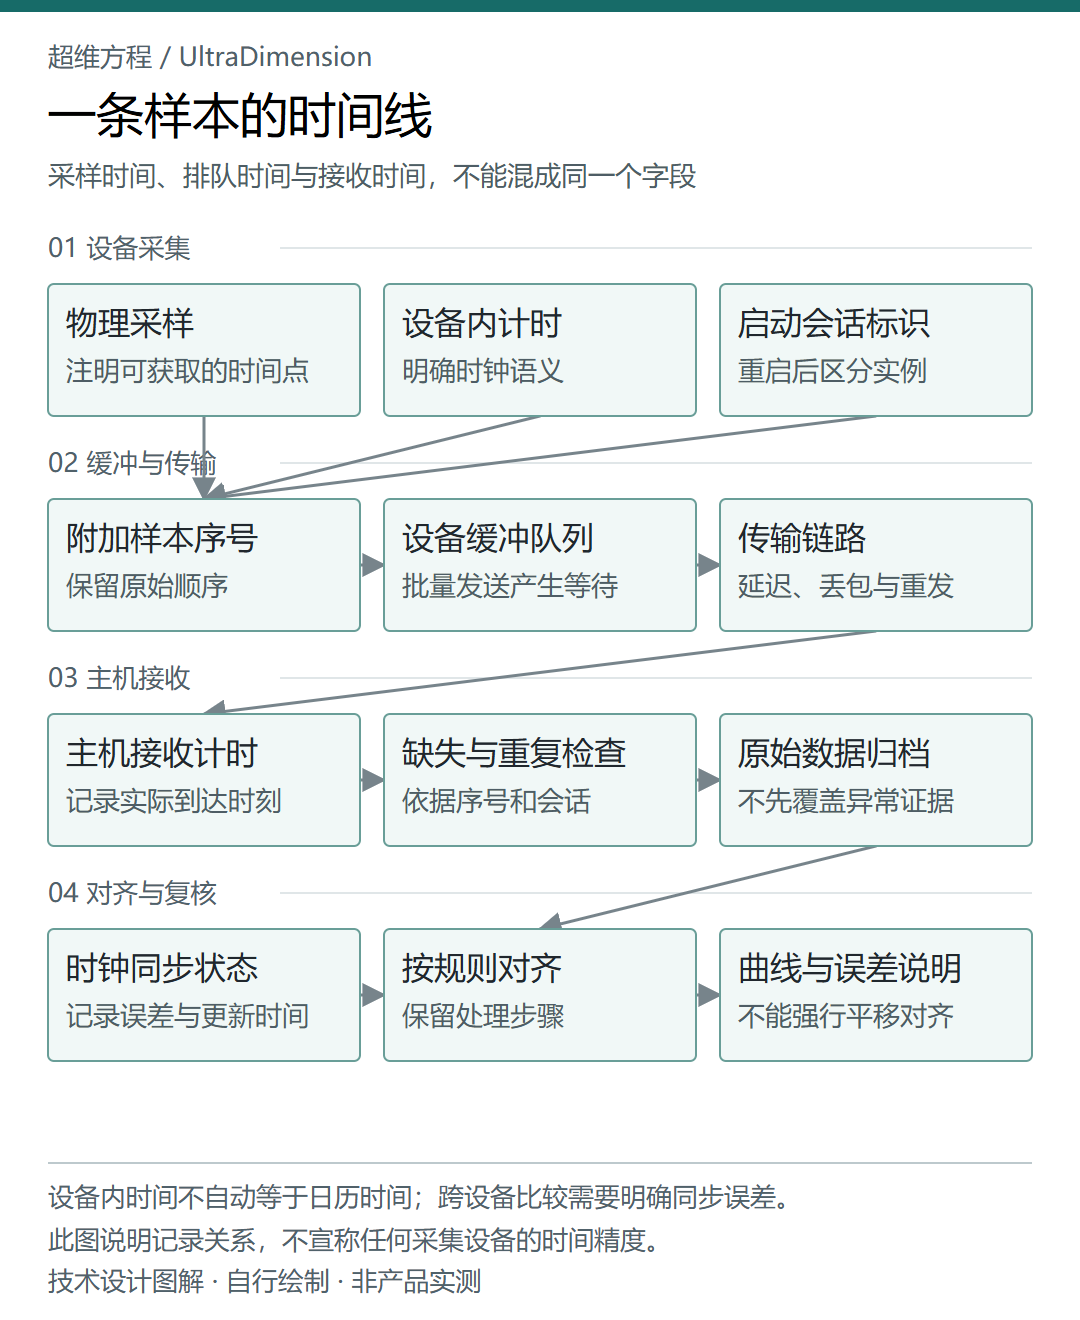
采样、设备缓冲、链路传输和主机接收的时间关系
图中设备计时与主机计时是不同来源;没有建立时钟映射时,不能直接相减求传输延迟。
用一组虚构数据看清字段含义
下面只演示记录格式,不代表某个设备的采样精度。假设设备在同一次启动中,从计时值 1,000,000 微秒开始,以精确的 10,000 微秒间隔采集十个点,序号为 700 到 709。
一个数据批次可以保留以下信息:
{
  "boot_id": "example-boot-A",
  "first_sequence": 700,
  "first_sample_us": 1000000,
  "sample_interval_us": 10000,
  "sample_count": 10
}
在这个理想化假设下,第 700 个样本的时间是 1,000,000 微秒,第 709 个样本是 1,090,000 微秒。电脑可能只收到一个包,但包里的样本并不是同时产生的。
上面的等间隔重建有前提:时间点定义一致、实际采样间隔符合假设、没有漏采。如果软件调度让采样间隔变化,就需要保留实际时间戳或相应误差信息,不能照着配置的周期把数据“补成准时”。
接收时间仍然有用,只是应单独叫 host_received_at,用来观察批量到达和排队情况,不覆盖采样字段。
微秒计数不等于微秒精度
读到一个以微秒为单位的整数,并不说明时间戳距离物理采样瞬间只有一微秒误差。调用发生在中断、驱动读取之后还是业务任务中,会改变这个数字的含义。
如果实际只能在读完寄存器后计时,就把字段描述写成“读取完成时间”。测量对象明确,比给它起一个含糊的 timestamp 名字更有用。
以 ESP-IDF 为例,esp_timer_get_time() 表示 ESP Timer 初始化后经过的时间。官方文档说明,深度睡眠唤醒后该计时会从零重新开始。因此不能默认不同启动周期的数值属于同一条连续时间线。
重启之后,序号相同也可能不是同一批数据
设备重启后,计时值和序号都可能从较小的值重新开始。如果接收程序只按序号去重,新启动的数据可能被误删;如果只按计时值排序,两次运行又可能混在一起。
启动实例标识可以帮助区分这些情况。示例里的 example-boot-A 只是占位符,真实实现必须能区分需要区分的启动实例。具体用什么机制生成,应结合持久化能力、碰撞风险和协议约束确定。
把序号与启动实例放在一起后,再判断重复、乱序或缺失。不要在原始记录入库前就静默丢掉所有“看起来重复”的行。
两个设备的曲线,最后再谈对齐
设备 A 和设备 B 各自的计时器没有天然共同起点。联网成功,也不能证明两个时间基准的偏差满足业务要求。
先确定允许的对齐误差,再选择同步方式并评估实际误差。没有这样的依据,只能比较各自时间基准内的变化,不能为了图好看而把两条曲线平移到重合。
排查时可以加入可控的批量发送、通信延迟和设备重启。保留原始序号、原始时间字段及接收顺序,把后续排序、插值和对齐另存为处理步骤。否则,整理后的曲线可能已经把要找的故障证据抹掉了。
参考:ESP Timer 官方文档。
作者:超维方程技术团队。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号