跑了 23 次行业日报后 I回头自查,发现前 10 期有 11 条有问题
原创
跑了 23 次行业日报后 I回头自查,发现前 10 期有 11 条有问题
原创
用户12804504
发布于 2026-10-07 19:35:34
发布于 2026-10-07 19:35:34
一个在强合规行业做自动化的人,聊聊怎么让 AI 干出来的活敢拿去签字
作者背景:汽车玻璃制造企业检测实验室 · 负责 CNAS 实验室认可 + ECE 法规认证证书管理
数据截至 2026-10
先回答标题里的问题:那 11 条是什么
先给结论,免得你一路读下去还不知道值不值。
我做的行业日报自动化跑了 23 次。某天我突然想:前 10 期里,有多少条其实站不住?
于是全部拉出来重跑一遍核对,结果是:
判定 | 条数 | 典型问题 |
|---|---|---|
完全不成立 | 6 条 | 信息本身是假的或严重误导 |
参数 / 归属有误 | 5 条 | 事实存在,但数值或法规归属错了 |
成立但缺官方原文 | 5 条 | 结论对,但证据链不完整 |
前 10 期里,11 条有问题或需返工(6 条不成立 + 5 条参数归属错误),另有 5 条虽成立但需补官方原文。
而这批日报是我“按时发出、格式整齐、看起来很专业”的。如果我不回头查,这 11 条会一直躺在我的记录里,直到某天被人拿来当依据。
这才是我今天想写的全部内容。
一、第一个坑:AI 最危险的不是做错,是“看起来对”
刚开始用 AI 做合规类工作时,我踩过一个典型坑。
某份行业报告提到「R43 新增耐盐雾 1000h + EMC 限值下降 5dB」。如果这条成立,意味着要调整整个对欧出口方案。
我没有逐页翻标准,而是直接拿本地那份官方 R43 全文 PDF 做关键词计数:
检索词 | 整合版命中 |
|---|---|
salt spray` / `salt fog | 0 |
electromagnetic` / `emc` / `30 MHz` / `1 GHz | 0 |
2 260 g` / `2.26 kg | 0 |
同时认定 EMC 限值属于 UN R10(电磁兼容),不是 R43(安全玻璃)。结论:这条信息不成立,不能据此做任何决策。
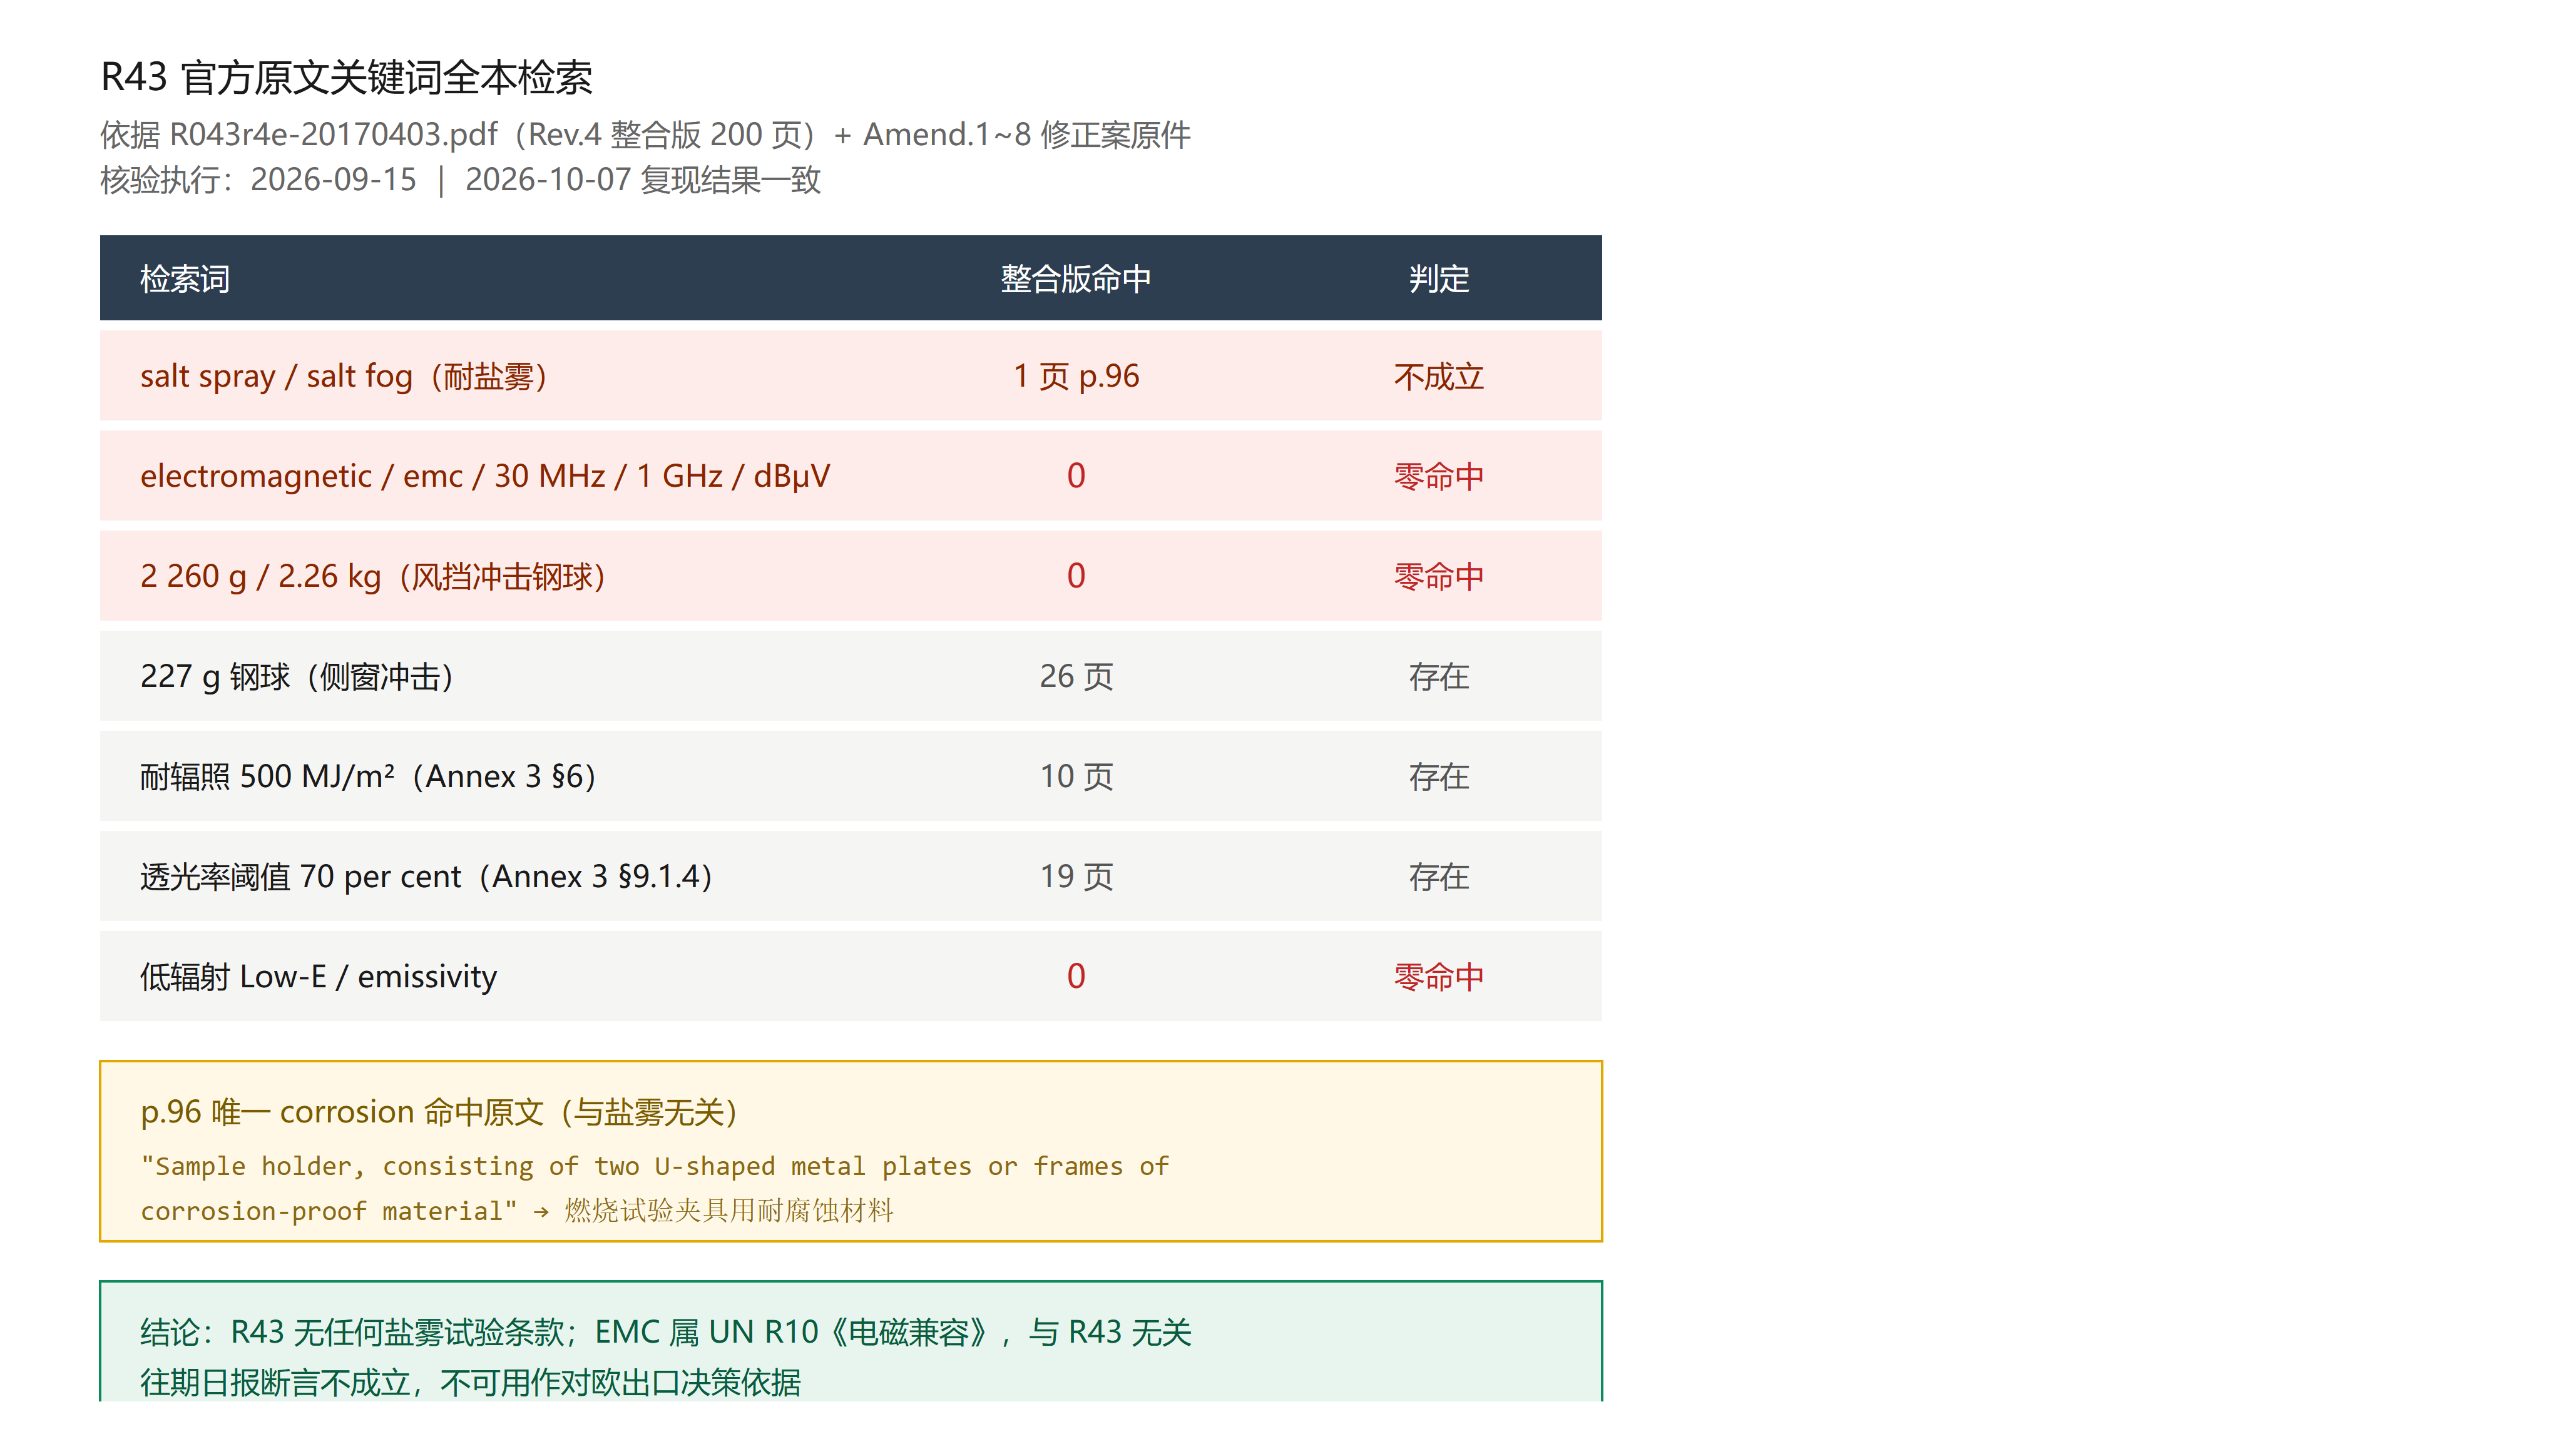
图:R43 Rev.4 整合版(200 页)+ Amend.1~8 修正案原件的全本关键词检索结果。核验执行 2026-09-15,2026-10-07 复现结果一致。注意 p.96 唯一那个 corrosion 的上下文——是燃烧试验的夹具用耐腐蚀材料,与盐雾试验毫无关系。
这就是我最大的体会——在合规领域,AI 最擅长的是把错误信息流畅地复述出来。它不会告诉你“这个结论没有条款号支撑”,只会把“具体数值 + 无出处”讲得特别像真的。
所以我给自己定了一条硬规矩:
法规结论必须以官方原文为准。禁用文档分享站、认证代理软文;“具体数值 + 无条款号”的结论,一律直接退回。
这条规矩后来变成了我所有自动化任务的第一道关卡。
二、我把“AI 说的”降级为“AI 帮我找的”
关键动作是:不让 AI 直接下结论,而是让它把结论的证据链摊开。
我现在跑每条行业动态,必须走五道关卡(G1–G5):
关卡 | 检查内容 |
|---|---|
G1 | 是不是官方载体发的? |
G2 | 能不能取到原始条文? |
G3 | 有没有做到条款级引用? |
G4 | 来源合规性(不是营销号)? |
G5 | 是否留痕可追溯? |
任何一条不过,就不进入我的日报。这套关卡后来帮我从源头拦下了大量问题——但真正让我震惊的是回头自查的结果。
你可能觉得“这也检查得太狠了”——但反过来想,如果这 10 条是我自己手工看原文,漏掉的概率是多少?AI 让我有了批量自查的可能,仅此而已,但它绝不该替我判断。
三、否定证据法:它比肯定证据更可靠
上面那个“0 次”的方法,我后来封装成了标准动作,叫否定证据法。
要推翻一个说法,不需要证明它错,只需要在权威原文里找不到支撑,且能确认“它应该在的地方也没有”。
这个方法的妙处在于:它是可复现的。任何人都能拿同一份 PDF、跑同一个脚本、得到同一个数字。AI 在这里的作用是“帮你写这个脚本”,而不是“替你相信结论”。
逐页翻阅 | 关键词全本计数 | |
|---|---|---|
结论类型 | 主观判断“我好像没看到” | 客观数字“0 次” |
可复现性 | 别人不一定会得出同样结论 | 任何人跑同一脚本得同一数字 |
可留痕 | 难以证明 | 输出可存档 |
速度 | 200 页,逐页读耗时数小时 | 一次性全本扫描 |
类似的还有锚点意识:跨系统传递数据时,record_id 是唯一可靠锚点,绝不能靠文件名或序号传内容。我曾因为用序号传,导致 6 张讲解卡内容全部错位——而如果当时只写“文件名”看起来更简洁。
四、让 AI 做“可验收”的活,而不是“看起来完整”的活
举两个真实的对比。
失败的做法:整理成绩单 → 让 AI 分析 → 输出结论。
结果:格式漂亮,但不可追溯,出了错没人知道错在哪一步。
成功的做法:整理成绩单 → 让 AI 分析 → 强制输出每一分的得分来源。
结果:任何一个结论都能一路追回到原始行。
同样的思路我还用在文档生成上:
• 文档 HTML 化后,跑 html-review 五维质检(design-token 合规、结构完整、排版合理性、文体契合度、装饰合理性),不通过就回炉。实测有周报一次就拿到 95 分。
• SVG 图形必须过 XML 解析器才算数——因为“浏览器里看着对”和“文件是合法的”是两件事。
五、几条具体的、救过我命的经验
1. 说了规则却没写检查脚本,规则一定会被自己违反
我给自己的小程序定过一条规则:「所有文案集中到 const.js 管理」。
结果一扫描:68 处硬编码文案散在 8 个 wxml 文件里。
于是我补了一个事务式替换脚本,89 处全量校验,任一处不匹配就整体不写。第一次跑就拦下 1 处错配。
结论:规则的执行力不能靠自觉,要靠脚本。
2. 批量文件操作会被周期性打断,必须设计成可重入
迁移 67 份月考卷,脚本跑到 31 份被 SIGTERM 打断了。删除脚本更惨,被打断多次,进度从 67→65→43→21→16→0。
我的对策:
• 循环重试 + 每轮核对剩余数,不假设一次跑完
• 删除操作内置双保险:「同名且大小一致」才删
第二条尤其重要——真正的保护不是“别删错”,是“删错了能自动停下”。
3. 归一化规则里,“删除噪声词”是个陷阱
我想把 24 所学校的卷子归一化,第一版用了“删掉校区名 / 噪声词”。
结果:把「交大附中嘉定」的嘉定删了,把「存志高中学英语」的级中删了。两版文件名逻辑都判错,差点误删不同学校的卷子。
正确做法:改用 24 所白名单 + 内容哈希 md5 去重,绝不做“看起来安全的删除”。
凡是“删掉 X 之后剩下的应该是 Y”这种推理,X 里面往往藏着关键信息。
4. 接口不存在就明说,不要假装能做
我在资料库 skill 里想批量删除重复文件,翻了 api-manifest.json 的 33 个 API,确认没有 delete-node 接口。
那就如实告诉用户:「接口不支持,请手动清理这 17 份“__重复待删__”文件」——而不是编一个“已清理”的结果。
同理,做立体几何试卷时有一道题算出了二面角 0° 这种退化结果。我的处理是标注“见原卷解析版”,不编造答案。
退化结果(0°、平行、重合)往往是题意理解错了的信号,不是答案。
六、给不同角色的一点建议
如果你做认证 / 检测 / 合规类工作:
一定要建“否定证据法”习惯。AI 帮你找原文可以,帮你判断不行。把结论的证据链摊开比拿到结论本身重要。
如果你做批量数据处理:
所有去噪规则都要有兜底。永远假设“我以为的噪声”里藏着你不知道的信息。
如果你在小程序 / 网页上做生成:
本地 localStorage 按源隔离——公开链接经过 302 → SPA 外壳 → iframe 三个不同源,进度不会共享。这个坑我踩过,隐私场景下反而正好符合需求。
如果你和我一样要养孩子 + 上班:
AI 最好的用法是把你不想重复做的流程固化掉,而不是替你做判断。我把周报、归档、组卷、OCR 清洗这些都固化成了技能,把“要不要相信”这件事留给自己。
七、一点数据参考
• 日报自动化连续跑了 23 次,回头自查前 10 期发现 11 条有问题(6 条不成立 + 5 条有误)
• 证书台账核对:110 个证书号零遗漏 + 220 张截图录入
• 月考卷归档:67 份 / 0 失败,MD5 逐文件校验后清源目录释放 622 MB
• 英语词组背诵台:2876 词组,可挖空 78%,8628 次出题验证 0 次答案泄漏
• 错题本知识点体系 59 条,立体几何卷 22 题 / 44 幅原卷图零转录
这些数字都不是为了炫技,而是想说明一件事:AI 在这些场景里的价值,是让我有余裕去做“回头自查”这件事。手工流程下,我不会有这个余裕。
一句话总结:
让 AI 干活很容易,让 AI 的活可被审计很难。但只有后者,才能真正用在有签字责任的地方。
如果你也在做类似的合规 / 检测工作,欢迎交流你踩过的坑——尤其是那些“看起来做对了其实错了”的,那才是真正花钱的地方。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号