自动化脚本跑到一半死了: 可重入设计的三个坑
原创
自动化脚本跑到一半死了: 可重入设计的三个坑
原创
用户12804504
发布于 2026-10-08 09:08:59
发布于 2026-10-08 09:08:59
自动化脚本跑到一半死了:
可重入设计的三个坑
67 份文件迁移到 31 份被中断、删除脚本从 67 → 0 反复重来、归一化规则差点误删不同学校的卷子
分享三个真实批量任务里踩过的坑,以及让脚本能被安全打断的设计方法
一、先说结论:批量脚本必须设计成“可重入”
先看一组真实数据。这是一次归档任务,中间被环境中断了好几次:
阶段 | 进度 |
|---|---|
迁移 67 份试卷 | 搬到 31 份时被打断 |
补齐剩余 | 又搬 36 份 |
删除冗余副本 | 67 → 65 → 43 → 21 → 16 → 0,反复中断 |
最终的“成功”是循环重试跑出来的,不是一次跑出来的。
如果我把脚本设计成“跑一遍就算完成”,那 31 份和 0 份之间的差距,就会变成一堆没人知道处理到哪里的半成品。
批量脚本的正确目标不是“跑完”,而是任何时刻被打断都能安全恢复。
这和“跑完就行”的直觉是反的。
二、坑一:删除脚本必须双保险,不能靠“我以为删对了”
出事的过程
归档完成后要清理源目录的冗余副本,一共 67 个文件。
我第一版删除脚本的逻辑很简单:遍历目标目录 → 删除源目录同名文件。
结果每删约 20 个就被中断一次,进度跳成 67→65→43→21→16→0。更要命的是——我完全不知道哪些是安全删的、哪些是独一份的。
如果当时有一份文件被误删,而我又恰好在中断后没去核对,那份数据就没了。
改法:删除前做双重校验
后来我把删除条件改成:
校验项 | 说明 |
|---|---|
① 源文件存在 | 避免报错 |
② 目标存在同名文件 | 确认不是源目录独有的 |
③ 大小一致 | 内容基本确认 |
④ MD5 一致 | 最终确认,不是只看大小 |
并且:任何一条不满足 → 跳过、记录、留到最后打印清单。
我还放弃了“更聪明”的方案
顺带说一句,我试过把文件丢进回收站(用 Windows 的 SHFileOperationW + FOF_ALLOWUNDO),想着万一删错能恢复。结果这个接口在当前环境返回空回显,而且部分执行了。
局部执行 + 无回显 = 比直接删更危险,因为你不知道到底删了哪些。
于是改成直接 os.remove + 循环重试,反而可靠。“更安全的机制”如果状态不明,它就不是更安全。
三、坑二:归一化绝对不能用“删噪声词”
这一节我觉得是全文最值得看的。
任务背景
归档试卷文件名格式很乱,典型的是:
原始文件名 |
|---|
上海交通大学附属中学嘉分校高一数学10月月考.docx |
存志高中学英语10月月考.docx |
七宝中学生物-解析10月月考解析.docx |
上海中学10数学10月月考.docx |
我要提取出“学校名”和“科目”,好按学校分类。
第一版:删噪声词(错的)
我想当然地写了规则:删掉校区名、“月考”、“解析”这类噪声词。
跑完一看,错误率触目惊心:
原始文件名 | 问题 |
|---|---|
上海交通大学附属中学嘉分校 | 「嘉」被当成噪声删掉,校名被毁 |
存志高中学英语 | 级中被删,变成「存志高中学英」 |
七宝中学生物-解析10月月考解析 | 解析没删干净,重复残留 |
最严重的是“嘉定”被当成了噪声删掉——那是校区的关键信息。
而且第二个版本也错了。两版逻辑都判错,差点按错误的规则改文件名。
改法:白名单 + 长名优先
正确的做法完全不“聪明”:
步骤 | 操作 |
|---|---|
1 | 准备 24 所学校的白名单 |
2 | 在文件名里找最长匹配的那个学校名 |
3 | 学校名确定后,剩下的部分才是“去掉噪声” |
就这三步。用“枚举已知答案”代替“猜未知结构”。
修正后全部错误清零。
为什么第一版会失败
“删掉 X 之后剩下的应该是 Y”这个推理,X 里面往往藏着关键信息。
“嘉”、“级中”、“解析”看起来都是噪声,但在特定文件名里它们是有效信息的一部分。而“猜结构”这件事,永远会漏掉你没见过的模式。
能用白名单枚举的,不要用规则去猜。
附带一个设计原则:先预演
改完脚本后,我先加了个 --apply 开关,默认只打印“打算怎么改”,不实际执行。同时导出一张 改名回滚表.csv,记录原名↔新名↔目标的对应关系。
这让我敢直接改 67 个文件的文件名——因为随时能反悔。
还有一点:改名前保留原文件(只改名不删除),让回滚有天然兜底。
四、坑三:改完不验收,等于没改
这一节最简单,但代价最大。
真实案例
我出卷子时写了个裁图脚本,批量从试卷原图裁出题目。跑完看着挺顺——
结果其中一道题算出了二面角 0°。
0° 是退化值(垂直的两面不可能二面角为 0)。这不是答案,是提示我题意理解错了。
但真正的问题不是这个 0°,而是:我如果当时没停下来,这个 0° 就会被当成“答案”写进讲解卡里打印给孩子。
另一个例子:脚本用正则匹配题号,只认纯数字,于是 10. 这种带点号的格式匹配不上,连带多截了相邻的题目——一道题被裁得只剩一半,后面修了一轮。
我现在的验收纪律
动作 | 要求 |
|---|---|
脚本改完 | 先做语法检查(node --check / py_compile) |
改代码后 | 用 DOM 桩渲染全部视图,目视验收 |
生成 SVG | 必须过 XML 解析器 |
批量生成文档 | 必须打开看一眼,不能只看“没报错” |
最后一条是最重要的:“脚本没报错”和“结果是对的”是两件完全不同的事。
五、把这些沉淀成规范
踩完这些坑之后,我给自己定了几条硬规矩:
1. 任何批量操作,先做只读扫描
不确定影响范围时,先只读扫描出清单,不要直接动手。先看清楚“动了会怎样”,再决定动不动。
2. 记录表和脚本一起产出
每次批量操作都留一张记录表(改名记录、迁移记录、删除清单)。出问题时这是唯一的溯源依据。
3. 删除是不可逆的,默认不删
先改名归档、确认无误、过了我自己这一关,再谈删除。
4. 环境报错要区分“可重试”和“不可重试”
SIGTERM / WinError 5(权限占用)→ 清掉占用重试;
rmdir / rmtree 在某些环境会被拦截 → 换独立 .py 脚本走 os.rmdir 自底向上删空目录。
不要把两类错误混在一个 try/except 里糊过去。
5. 保留回滚路径直到确认无误
原文件保留、回滚表留存、脚本默认预演——这三个加起来,才能支撑你敢对 67 个文件动手。
六、如果你也在写批量脚本
最该记住的一条:
假设你的脚本会在任意时刻被杀,然后让它能从被杀的地方继续。
具体来说:
• 循环重试 + 逐轮核对剩余数,不要假设一次跑完
• 删除前做 MD5 级校验,宁可跳过也不误删
• 归一化用白名单枚举,不要用“删噪声词”猜结构
• 默认预演 + 记录表 + 保留原文件,让操作可回滚
• 改完必须目视验收,“没报错”不等于“对”
最后补一句:中间状态是有价值的。
我那个“删到一半”的脚本,如果能在任意时刻停下来告诉你“已删 43、跳过 2、待确认 1”,那它就不是失败的脚本,而是正在工作的脚本。
如果你也遇到过“脚本跑到一半死了”,欢迎交流你踩过的坑——尤其是那些“看起来做对了其实错了”的,那才是真正花钱的地方。
附图:删除脚本的真实中断进度
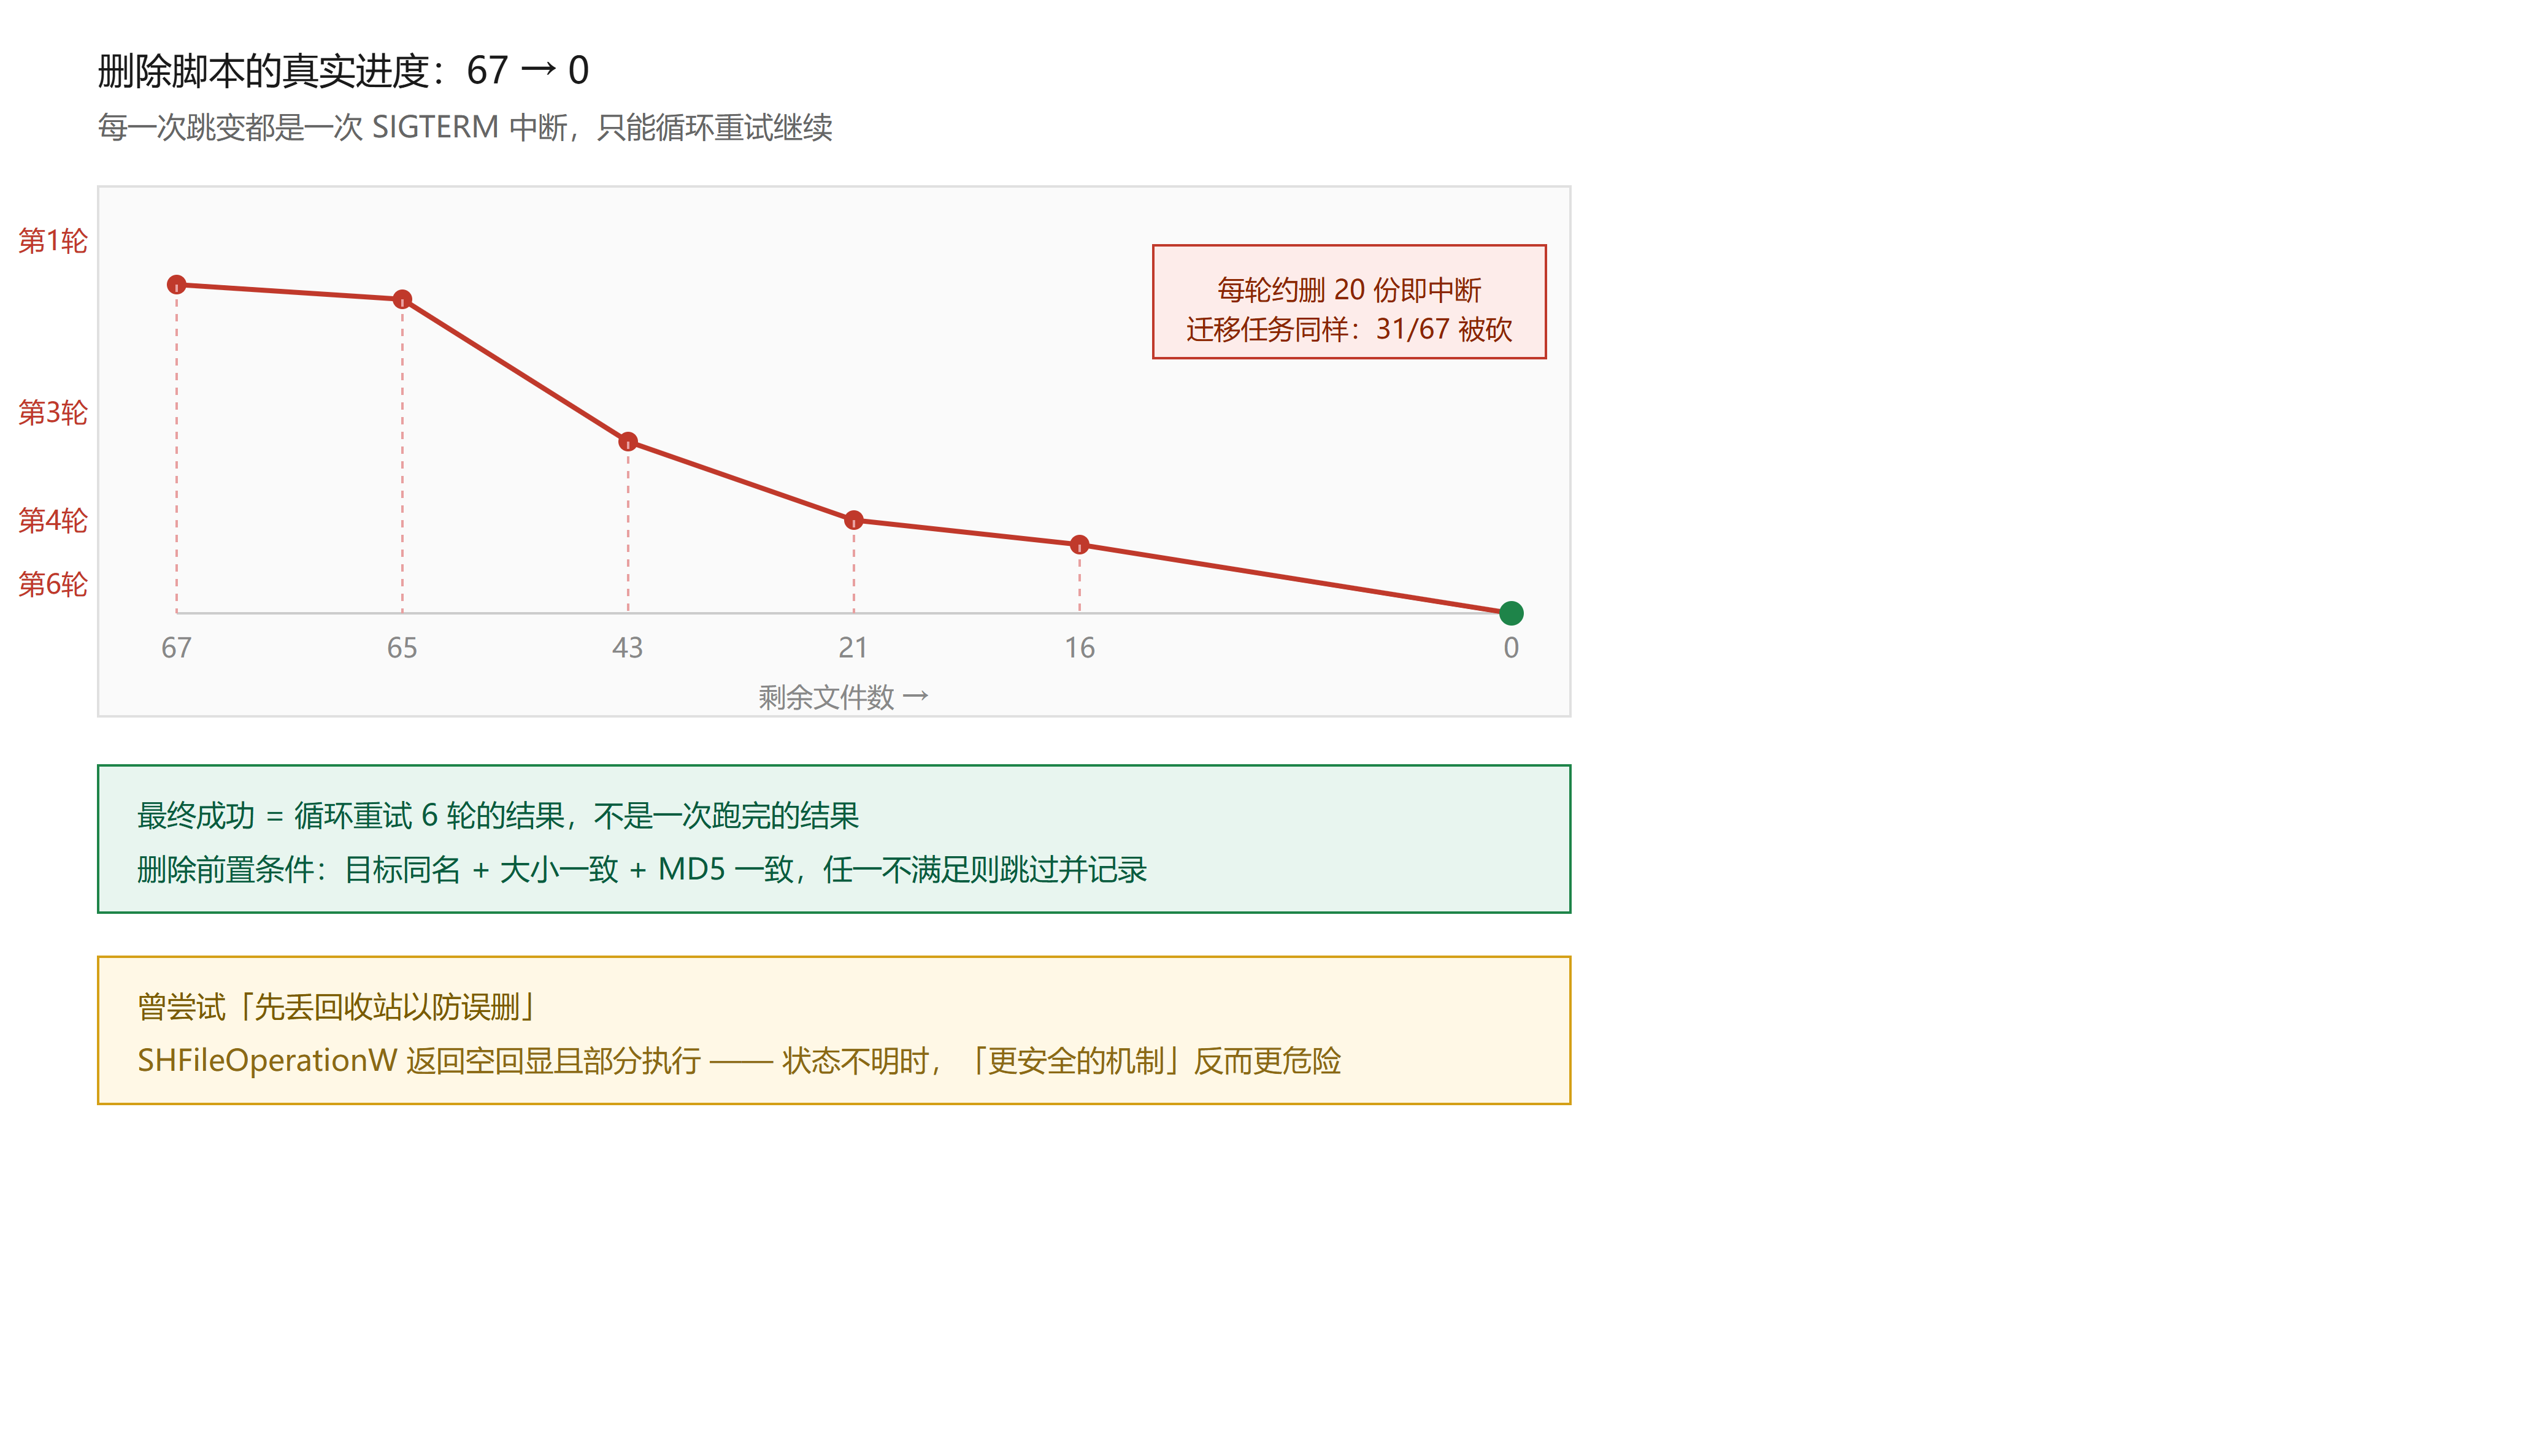
图:删除 67 份冗余副本时的真实剩余数变化(67→65→43→21→16→0)。每一次跳变都是一次 SIGTERM 中断。数据来自 2026-10-05 实际归档任务记录。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号