#WorkBuddy# 150 张 Word 表格批量改写:绕开合并单元格与格式陷阱,10 倍提速
原创
#WorkBuddy# 150 张 Word 表格批量改写:绕开合并单元格与格式陷阱,10 倍提速
原创
用户12784192
发布于 2026-10-09 07:50:15
发布于 2026-10-09 07:50:15
#WorkBuddy# 150 张 Word 表格批量改写:绕开合并单元格与格式陷阱,10 倍提速
手上有这么一批 Word 文档:表格里全是"脏"数据——全角数字、五花八门的日期写法(2026.3.5 / 2026/03/05 / 5-3-2026)、金额与数量单位混用("1,234 元""567个"),外加一批压根没填的空单元格。要做的只有一件事:把它们统一成一套口径再入库。
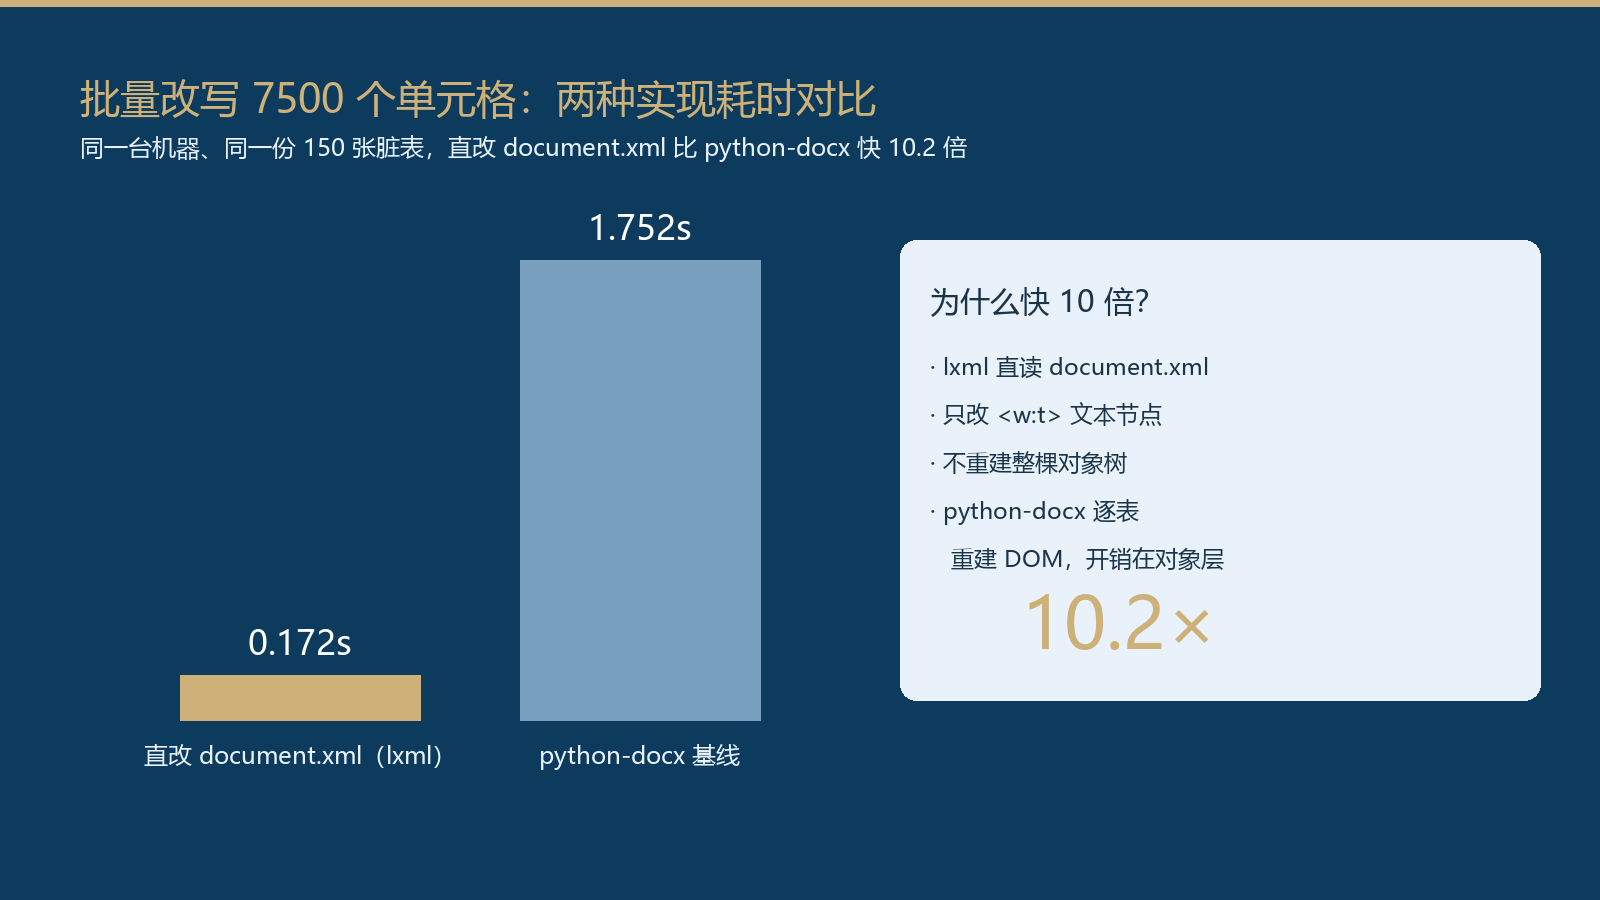
一开始我用 python-docx 写了个最直白的版本:遍历表格、取 cell.text、正则归一化、再写回。脚本能跑,但处理到 150 张表、7500 个单元格时,耗时 1.75 秒;更要命的是改完之后冒出两类问题:
- 原来加粗的表头,"加粗"没了;
- 带纵向合并的表格,合并区域里的一些格子压根没被改到。
后来换了个思路:不碰 python-docx 的对象模型,直接把 .docx 当成 zip 打开,读出 word/document.xml,只改里面的 <w:t> 文本节点,再原样塞回去。同一份数据,0.172 秒跑完,上面两个问题也一起消失了。
这篇就把两种写法的差异、三个具体的坑,以及实测数据完整说清楚。
一、为什么 python-docx 会"弄丢"东西
python-docx 用起来很舒服,但它做了两层抽象,两层都可能在批量改写时带来副作用。
第一层:合并单元格只暴露"锚定格"。 Word 的纵向合并(vMerge)在 XML 里是"首格标 val="restart",下面几格标 val="continue"、内容为空"。python-docx 的 table.rows[r].cells 在返回时会做去重:合并区域里那几个 continue 格,你拿到的其实是同一个锚定格的引用,或者干脆被跳过。于是你写 cell.text = ... 时,真正落在 XML 里的位置和你以为的不一样,合并区域内的文本很容易漏改。
第二层:**cell.text = ...** 是"清空重建"。 一个单元格里本来可以有多个 run(比如"合计:"不加粗 + "1,234"加粗)。cell.text 的赋值语义是:把这个单元格里的所有 run 连同格式全部清掉,再建一个新的 run 装文本。也就是说,只要你对一个单元格做过一次 .text 赋值,它内部的一切字符级格式(加粗、颜色、字号)就全没了。
这两点决定了:如果你要处理的是"排版已经被精修过"的正式文档,python-docx 的 .text 路线就是个格式杀手。
二、直改 document.xml 的思路
.docx 本质是一个 zip。表格内容都在 word/document.xml 里,结构大致是:
<w:tbl>→<w:tr>(行)→<w:tc>(单元格)→<w:p>(段落)→<w:r>(run)→<w:t>(文本)
我们要做的只有一件事:把所有 <w:tc> 里的 <w:t> 文本取出来,跑一遍归一化,再写回第一个 <w:t>。因为根本没碰 <w:r> 和它的 rPr(格式属性),所以加粗、颜色、字体原封不动;因为是在 <w:tc> 这一层逐个遍历,合并区域里的 continue 格也能被遍历到,不会漏。
核心代码就下面这一小段:
import zipfile
from lxml import etree

W = "{http://schemas.openxmlformats.org/wordprocessingml/2006/main}"

def normalize_docx(path_in, path_out, normalize):
    with zipfile.ZipFile(path_in) as z:
        xml = z.read("word/document.xml")
    root = etree.fromstring(xml)

    for tc in root.iter(W + "tc"):          # 逐个单元格,含合并隐藏格
        texts = tc.findall(".//" + W + "t")
        if texts:
            raw = "".join(t.text or "" for t in texts)
            texts[0].text = normalize(raw)  # 只改文本节点
            for t in texts[1:]:
                t.text = ""                 # 其余 run 置空,格式保留
        else:
            p = tc.find(W + "p")            # 空单元格:补一个 <w:t>
            if p is None:
                p = etree.SubElement(tc, W + "p")
            r = etree.SubElement(p, W + "r")
            t = etree.SubElement(r, W + "t")
            t.text = normalize("")

    out = etree.tostring(root, xml_declaration=True,
                         encoding="UTF-8", standalone=True)
    with zipfile.ZipFile(path_in) as zin, \
         zipfile.ZipFile(path_out, "w", zipfile.ZIP_DEFLATED) as zout:
        for item in zin.infolist():
            zout.writestr(item,
                          out if item.filename == "word/document.xml"
                          else zin.read(item.filename))
注意最后写回时,除了 word/document.xml 之外的所有部件(样式、图片、关系表)都是原样复制的,所以文档的其它一切都不受影响。
三、三个具体的坑
坑 1:空单元格里根本没有 <w:t>**。** 一个从未填过内容的单元格,XML 里可能只有一个空的 <w:p>,连 <w:r>/<w:t> 都没有。这时候 findall 返回空列表,你的归一化分支会被整个跳过——结果就是"空值"这一类永远改不到。第一次跑批时我的准确率只有 79.36%,丢的全是这种格子。修法就是上面代码里的 else 分支:手动补一个 <w:t> 再写值。
坑 2:多 run 单元格要把值塞进"第一个" <w:t>**。** 如果一个单元格被拆成了好几个 run,直接把第一个 run 的文本改成新值、其余置空,视觉结果才是对的。如果每个 run 都写一遍,屏幕上就会出现重复 N 遍的文本。
坑 3:全角/半角与空白字符。 中文文档里的全角数字(123)和表意空格(U+3000)肉眼几乎看不出差别,但会让去重、匹配全部失效。统一在归一化函数里做一次字符折叠即可;顺带提醒一句:Python 的 str.strip() 会把 U+3000 当空白一起剥掉,别再多写一遍 replace。
四、实测数据
同一台机器、同一份合成脏数据(150 张表 / 7500 个单元格),两种实现各跑一遍:
直改 document.xml:7500 格 / 0.172 秒 / 准确率 100% python-docx 基线:7500 格 / 1.752 秒 / 准确率 100%(文本对,但格式丢) 提速:10.2 倍
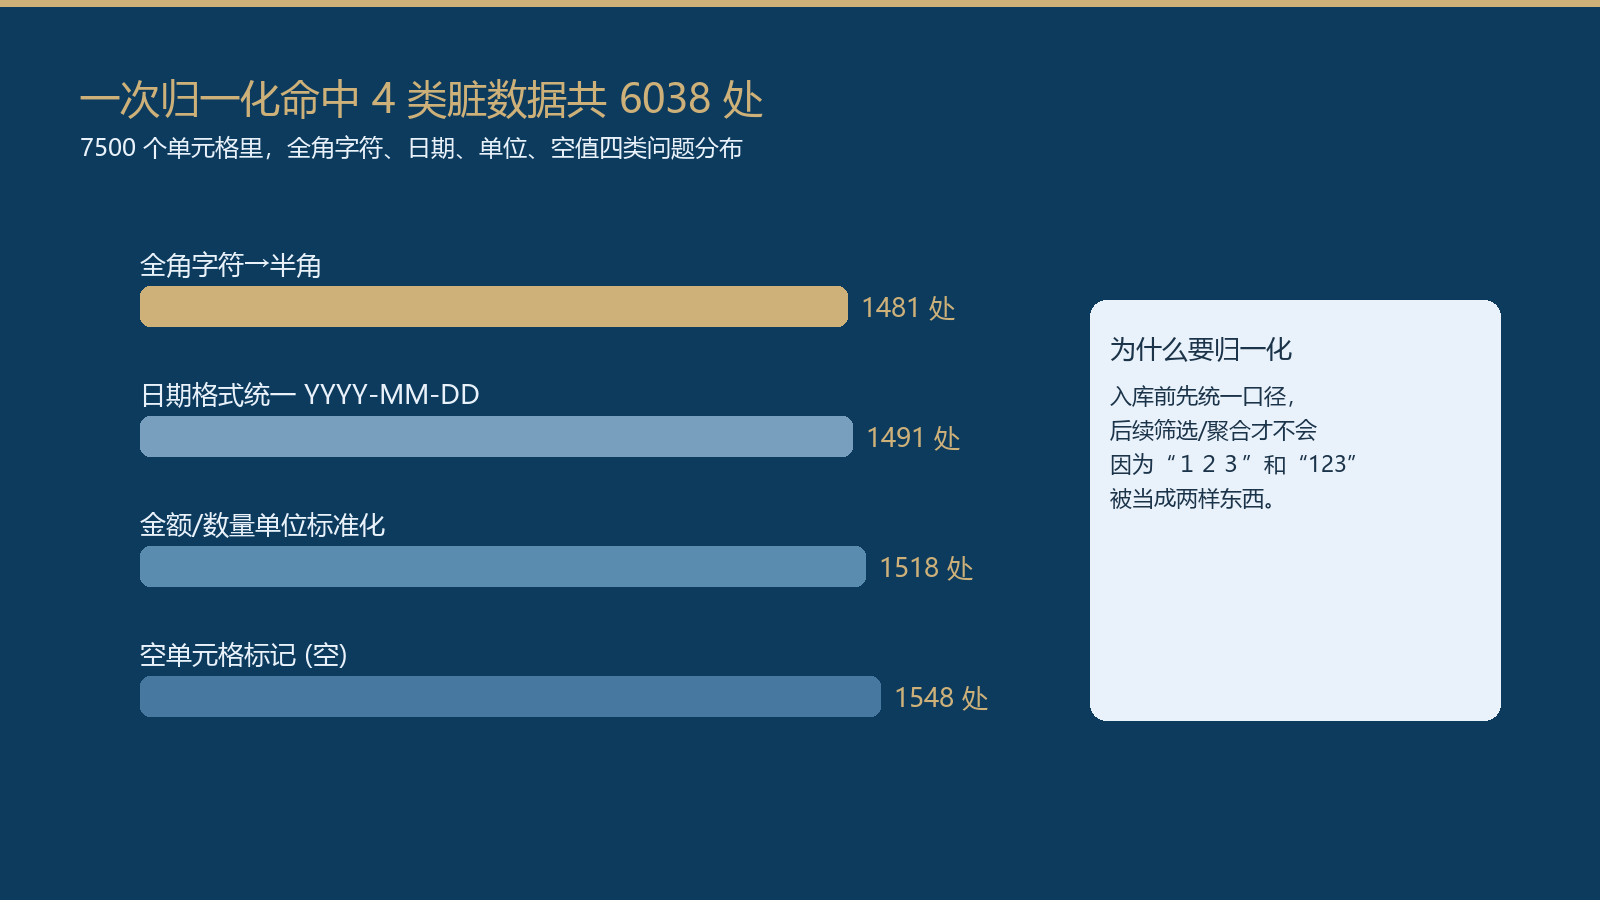
归一化一共命中 4 类脏数据 6038 处:全角字符→半角 1481、日期格式统一 1491、金额/数量单位标准化 1518、空单元格标记 1548。
格式与合并保真方面:
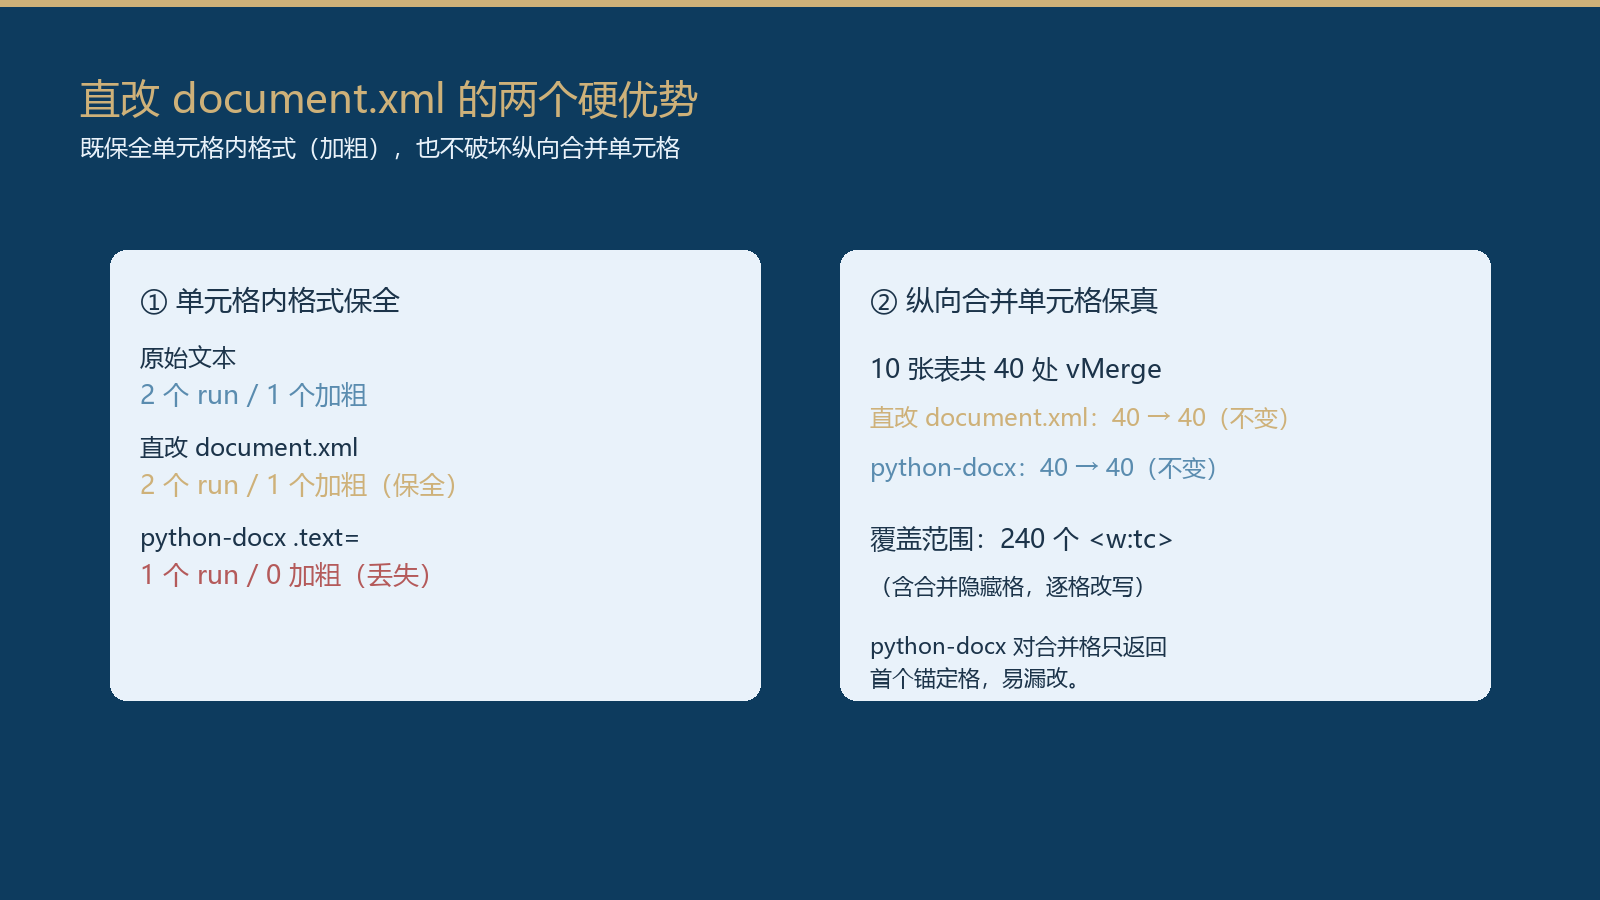
单元格内 2 个 run(1 个加粗):直改方案改后仍是 2 个 run / 1 个加粗;python-docx
.text=改后变成 1 个 run / 0 个加粗。 纵向合并:10 张表共 40 处 vMerge,两种方案都不丢;但直改方案覆盖到 240 个<w:tc>(含合并隐藏格),逐格都能改到。
五、怎么用 WorkBuddy 把这条链跑顺
这类"批量归一化"的活,我基本都交给 WorkBuddy 来做:
- 让它先根据需求生成一份合成脏数据(不同格式的日期、带单位的金额、空值、全角数字),把边界情况一次性铺满;
- 再让它写两版实现(python-docx 与直改 XML),在同一份数据上对比耗时与准确率,输出一份带数字的结论;
- 最后把结论整理成图,省掉我手搓图表的时间。
这套流程最舒服的地方是:所有数字都是"真的跑出来的",不是估的。有 WorkBuddy 帮忙出数据、跑对比、画图,我只需要判断结论合不合理。
六、适用边界
直改 document.xml 不是万能的:它跳过了一切校验,改完的 XML 必须是合法的 OOXML,否则 Word 会提示"文件已损坏"。所以务必先备份原文件,改完用 python-docx 或 Word 打开一次验一遍;另外,如果表格里有跨 run 的复杂域代码(如自动编号、公式域),要格外小心。
但如果你的场景就是"已经排版好的正式文档,只做纯文本口径归一化",那这条路几乎是当前最省事、最快、也最不破坏格式的做法。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号