多档案室集中监管平台开发:跨库房温湿度数据汇聚与可视化实现
原创
多档案室集中监管平台开发:跨库房温湿度数据汇聚与可视化实现
原创
HONSOR盛世宏博
发布于 2026-10-09 10:27:43
发布于 2026-10-09 10:27:43
多档案室集中监管平台开发:跨库房温湿度数据汇聚与可视化实现
物联网 · 盛世宏博 · 多库房汇聚 · 集中监管 · 数据可视化 · 分布式采集
关键词:多档案室、集中监管平台、温湿度数据汇聚、跨库房监控、数据可视化、分布式采集、InfluxDB、Grafana 标签:#物联网 #Modbus #TCP/IP #UDP #POE供电 #腾讯云 #Wireshark #Python #InfluxDB #以太网温湿度传感器 #网口温湿度变送器 #机房监控
一、多档案室集中监管的业务背景
大型档案馆、机关单位或企业集团往往管理着多个分散的档案室——可能分布在同一栋楼的不同楼层,也可能跨楼宇甚至跨园区。每个档案室独立部署了温湿度传感器和本地监控设备,但缺乏统一的监管视图。
核心痛点:
痛点 | 影响 |
|---|---|
各库房数据孤岛 | 无法横向对比各库房环境状态 |
告警分散 | 每个库房独立告警,值班人员需逐个查看 |
历史数据无法统一分析 | 无法做跨库房的长期趋势分析和能耗评估 |
运维效率低 | 巡检需逐个库房跑,无法远程集中诊断 |
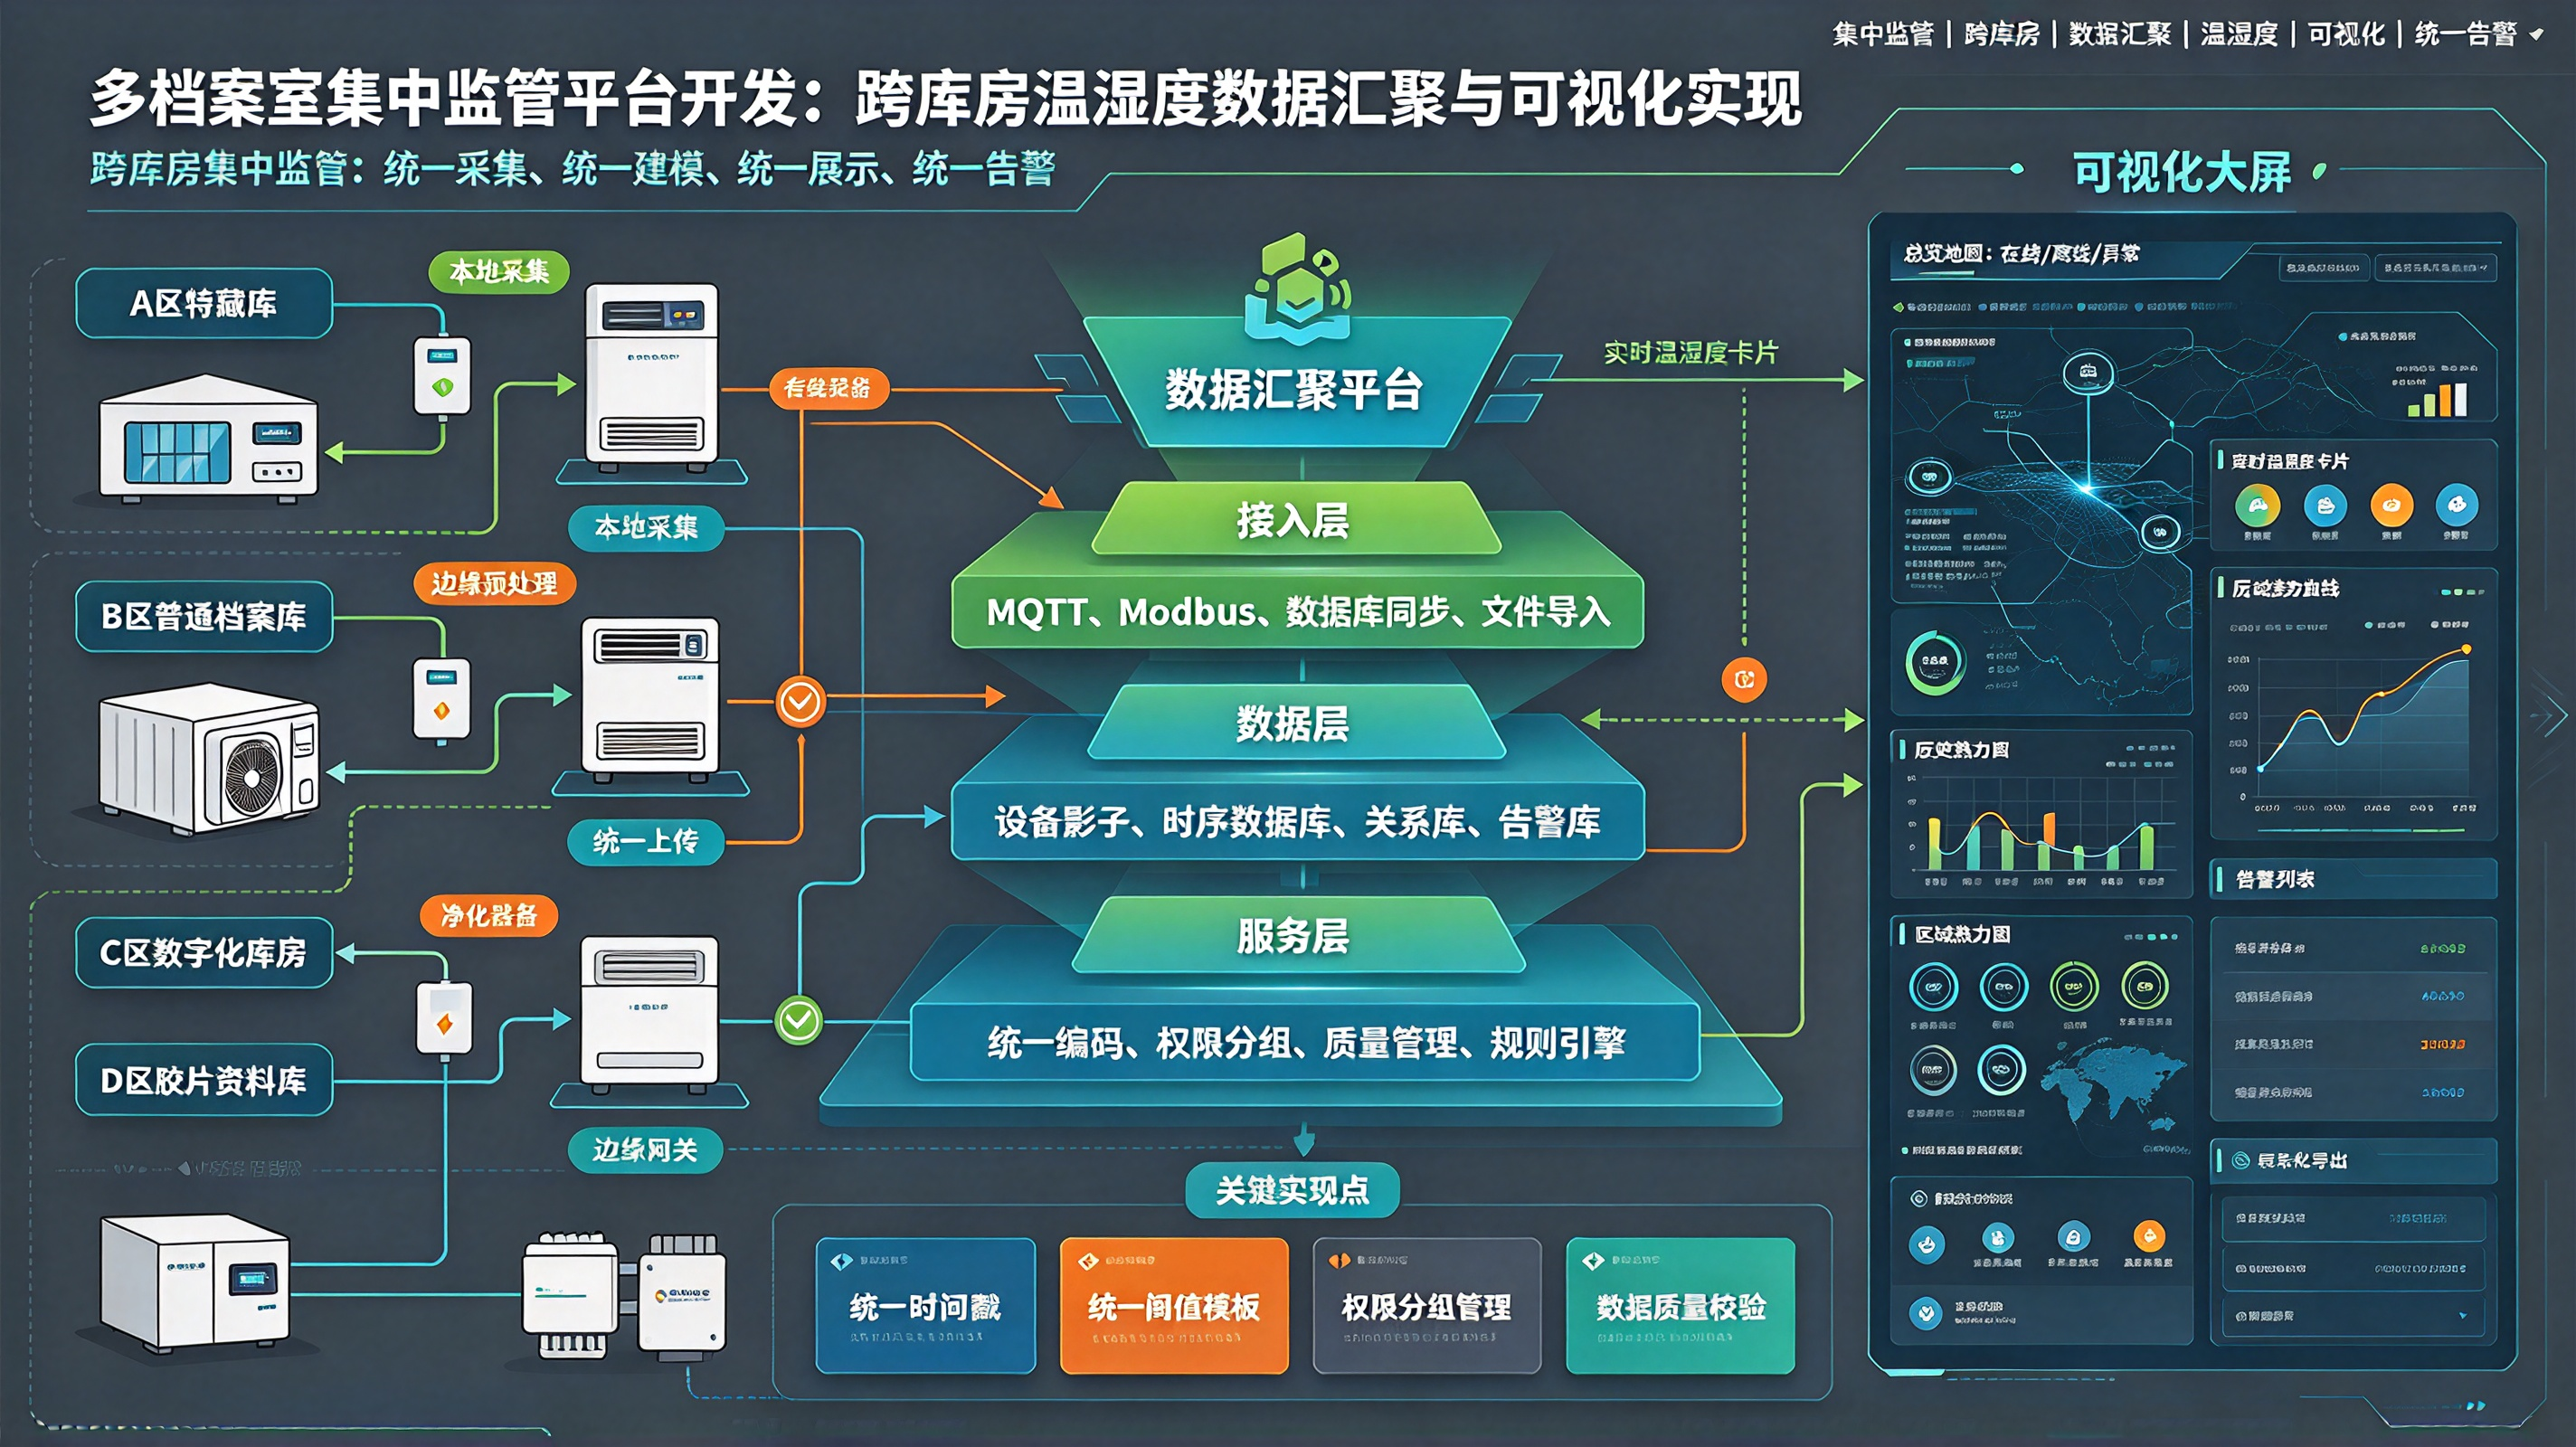
建设目标:构建一个集中监管平台,将分散在N个库房的温湿度数据实时汇聚、统一存储、集中展示,实现"一个屏幕看全部、一条规则管所有"。
二、系统总体架构
┌─────────────────────────────────────────────────────────────┐
│                    集中监管平台(中心端)                      │
│  ┌──────────┐  ┌──────────┐  ┌──────────┐  ┌──────────┐   │
│  │ 数据接入层 │→│ 时序数据库 │→│ 可视化层  │→│ 告警引擎  │   │
│  │ (TCP/UDP  │  │(InfluxDB)│  │(Web/Grafana)│(阈值/趋势)│   │
│  │  Modbus)  │  │          │  │          │  │          │   │
│  └──────────┘  └──────────┘  └──────────┘  └──────────┘   │
└──────────────────────────┬──────────────────────────────────┘
                           │ 局域网/专网/VPN
          ┌────────────────┼────────────────┐
          ▼                ▼                ▼
   ┌─────────────┐  ┌─────────────┐  ┌─────────────┐
   │  档案室 A    │  │  档案室 B    │  │  档案室 C    │
   │ 传感器×12    │  │ 传感器×8     │  │ 传感器×16    │
   │ 采集网关     │  │ 采集网关     │  │ 采集网关     │
└─────────────┘ └─────────────┘ └─────────────┘架构分层说明:
层级 | 职责 | 技术选型 |
|---|---|---|
采集层 | 各库房本地传感器数据采集 | 以太网温湿度变送器(Modbus TCP/UDP上报) |
接入层 | 接收各库房上报数据,协议解析 | Python异步TCP/UDP Server |
存储层 | 时序数据写入与压缩存储 | InfluxDB 2.x |
可视化层 | 多库房仪表盘、趋势图、热力图 | Grafana + 自研Web前端 |
告警层 | 阈值判断、趋势预测、通知分发 | 自研规则引擎 + 短信/邮件/Webhook |
三、数据汇聚方案
3.1 两种汇聚模式对比
模式 | 原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
主动拉取(Pull) | 中心平台轮询各库房网关 | 架构简单、可控性强 | 库房多时轮询周期长 | ≤20个库房 |
被动接收(Push) | 各库房网关主动上报 | 实时性好、扩展性强 | 需库房端支持上报功能 | ≥20个库房 |
推荐方案:中小规模用Pull,大规模用Push,或混合模式(关键库房Push+普通库房Pull)。
3.2 数据接入层核心逻辑
# data_ingest.py - 数据接入核心(精简版)

import asyncio
import struct
from influxdb_client import InfluxDBClient, Point

class DataIngestServer:
    def __init__(self, influx_url, token, org, bucket):
        self.client = InfluxDBClient(url=influx_url, token=token, org=org)
        self.write_api = self.client.write_api()
        self.bucket = bucket
        self.room_registry = {}  # room_id → (ip, port, protocol)

    async def handle_udp(self, reader, writer):
        """UDP数据接收"""
        data = await reader.read(1024)
        # 解析:room_id(2B) + sensor_id(2B) + temp(4B float) + humi(4B float)
        room_id, sensor_id = struct.unpack('>HH', data[:4])
        temp, humi = struct.unpack('>ff', data[4:12])
        self._write_to_db(room_id, sensor_id, temp, humi)
        writer.close()

    def _write_to_db(self, room_id, sensor_id, temp, humi):
        point = Point("env_data") \
            .tag("room_id", str(room_id)) \
            .tag("sensor_id", str(sensor_id)) \
            .field("temperature", temp) \
            .field("humidity", humi)
        self.write_api.write(bucket=self.bucket, record=point)
四、数据存储设计
4.1 InfluxDB数据模型
Measurement: env_data
Tags:        room_id, sensor_id, floor, building
Fields:      temperature, humidity, battery(可选), rssi(可选)
Timestamp: 采集时间(毫秒精度)关键设计决策:
设计项 | 选择 | 理由 |
|---|---|---|
room_id/sensor_id作为Tag | 支持按库房/传感器快速过滤和分组聚合 | Tag用于查询条件,Field用于数值 |
温度/湿度作为Field | 需要聚合计算(avg/max/min) | Field支持数学运算 |
保留策略 | 原始数据30天,降采样数据5年 | 平衡存储成本与历史追溯需求 |
4.2 降采样(Downsampling)
// InfluxDB Flux降采样任务:每5分钟聚合一次
from(bucket: "env_raw")
  |> range(start: -10m)
  |> filter(fn: (r) => r._measurement == "env_data")
  |> aggregateWindow(every: 5m, fn: mean)
  |> to(bucket: "env_downsampled", org: "archive")
五、可视化实现
5.1 核心展示页面
页面 | 内容 | 技术实现 |
|---|---|---|
总览大屏 | 所有库房实时状态卡片(温度/湿度/在线数) | HTML+CSS Grid + WebSocket推送 |
单库房详情 | 传感器点位分布图 + 实时曲线 | SVG平面图 + ECharts |
趋势分析 | 跨库房对比曲线、日/周/月报表 | Grafana + 自研报表导出 |
热力图 | 库房内温湿度空间分布 | Canvas热力图渲染 |
告警面板 | 当前告警列表 + 历史告警统计 | 实时表格 + 柱状图 |
5.2 Grafana仪表盘配置要点
关键配置:
1. 变量设置:room_id(下拉多选)、time_range(时间范围)
2. 面板1:库房状态总览(Stat面板,显示各库房当前温湿度+阈值颜色)
3. 面板2:跨库房温度对比(Time Series,按room_id分组)
4. 面板3:告警统计(Bar Chart,按库房/级别分组)
5. 刷新间隔:5s(总览)、30s(趋势)
5.3 自研Web前端核心代码
// 实时数据推送(WebSocket)
const ws = new WebSocket('ws://platform.example.com/ws/env');
ws.onmessage = (event) => {
    const data = JSON.parse(event.data);
    // data格式: {room_id, sensor_id, temperature, humidity, timestamp}
    updateCard(data.room_id, data.temperature, data.humidity);
    updateChart(data.room_id, data.timestamp, data.temperature);
};
六、告警引擎设计
6.1 告警规则模型
规则结构:
{
  "rule_id": "TEMP_HIGH_01",
  "name": "库房高温告警",
  "scope": ["room_001", "room_002"],     // 适用库房
  "condition": "temperature > 28",       // 判断条件
  "duration": 300,                       // 持续300秒才触发(防抖动)
  "severity": "WARNING",
  "notify_channels": ["sms", "email"],
  "cooldown": 1800                       // 同一规则30分钟内不重复通知
}
6.2 告警去重与聚合
场景 | 处理方式 |
|---|---|
同一库房3个传感器同时超温 | 合并为1条告警:"库房A高温(3个测点)" |
同一规则5分钟内重复触发 | 抑制,不重复通知 |
跨库房同类告警 | 汇总为1条:"3个库房触发高温告警" |
告警恢复 | 自动发送恢复通知 |
七、性能与可靠性
7.1 性能基准
指标 | 数值 | 说明 |
|---|---|---|
单平台最大接入库房数 | 200+ | 取决于网络带宽和InfluxDB性能 |
单库房最大传感器数 | 64 | 实际项目通常8~24个 |
数据写入吞吐 | 10,000点/秒 | InfluxDB 2.x,SSD存储 |
查询响应时间 | <500ms | 单库房24小时数据 |
WebSocket并发 | 500+ | 前端大屏同时在线 |
7.2 可靠性保障
风险 | 措施 |
|---|---|
中心平台宕机 | 各库房本地采集网关独立运行,平台恢复后补传 |
网络中断 | 本地缓存最近24小时数据,网络恢复后批量补写 |
数据库满 | 自动降采样 + 冷数据归档到对象存储 |
前端页面卡顿 | 虚拟滚动 + 数据分页 + Canvas渲染 |
八、典型坑
- Tag基数爆炸:把sensor_id作为Tag但数量超过10万,导致InfluxDB内存暴涨。解决:合理设计Tag粒度,必要时用Field替代。
- 时区混乱:各库房服务器时区不一致,数据时间错乱。解决:统一UTC+8,写入时强制转换。
- 告警风暴:一个传感器故障导致每秒触发一次告警。解决:加告警抑制和聚合规则。
- 网络带宽不足:200个库房同时Push数据撑爆上行带宽。解决:采集端本地聚合后上报均值。
- Grafana面板加载慢:查询时间范围过大。解决:默认显示最近1小时,历史查询异步加载。
- 前端WebSocket断连不重连:页面长时间打开后数据停止更新。解决:加重连机制和心跳检测。
- 库房命名不规范:room_001/库房1/档案室一混用。解决:建立统一的库房编码规范。
- 忽略离线检测:传感器离线但平台不告警。解决:加心跳超时检测(>3个采集周期未上报即告警)。
- 降采样任务失败:Flux脚本语法错误导致数据丢失。解决:任务上线前在InfluxDB UI中验证。
- 权限管理缺失:任何人都能看到所有库房数据。解决:RBAC模型,按库房分配查看权限。
九、小结
多档案室集中监管平台的核心挑战不在于单一技术点的难度,而在于分布式数据汇聚的可靠性、海量时序数据的存储效率、以及多层级可视化的用户体验。架构上遵循"采集分散、汇聚集中、存储分层、展示分级"的原则,技术上InfluxDB+Grafana组合已经足够成熟,关键在于数据模型设计和告警规则的精细化配置。
平台建好只是第一步,真正产生价值的是持续运行中的数据积累——当有了跨库房、跨季节、跨年份的环境数据后,才能做能耗优化、设备预测性维护、档案保存环境趋势分析等更深层次的应用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号