#WorkBuddy# 2197 个文件批量改名:朴素脚本静默吃掉 123 个文件,我用"先计划后执行"把风险降到 0
原创
#WorkBuddy# 2197 个文件批量改名:朴素脚本静默吃掉 123 个文件,我用"先计划后执行"把风险降到 0
原创
用户12784192
发布于 2026-10-09 10:45:22
发布于 2026-10-09 10:45:22
#WorkBuddy# 2197 个文件批量改名:朴素脚本静默吃掉 123 个文件,我用"先计划后执行"把风险降到 0
一、先说我踩的那次坑
有个目录,两千多个文件,名字是十几年的沉淀:Q3 Report final .txt、[2023-07-14] memo #3.docx、contract(12)'s backup~.xlsx、NTFS_report_51.bin、全角空格、全角书名号、末尾三个点、重复连字符……什么样的都有。
我的第一版脚本只有五行逻辑:遍历、算新名、os.replace、打印进度、结束。跑完控制台干干净净,0 报错,进度条到 100%。我还挺满意。
直到几天后核对清单,发现少了 123 个文件。
不是报错,不是中断,是静默消失。这才是最可怕的地方:脚本没有告诉你它做了什么。
二、根因:三件事叠在一起
第一,**os.replace** 遇到同名会直接覆盖,并且不报错。 两个文件名不同、归一化后却一样("a b.txt" 和 "a b.txt" 两个空格),谁排在后面谁就把前面的顶掉。这是 123 个文件里的大头。
第二,改名这件事有顺序依赖。 只要涉及"交换名字"或"轮转编号"——A 改名成 B、B 改名成 C——一步到位必然丢数据。我的语料里埋了 1 组 2 文件交换和 1 组 3 文件轮转,朴素方案下交换丢了 1 个、轮转丢了 2 个,而且没有任何提示。
第三,冲突和路径长度要到"改名那一刻"才暴露。 你不知道目标名是否已存在、归档后全路径会不会超过 Windows 的 260 字符上限。等它暴露时,木已成舟。
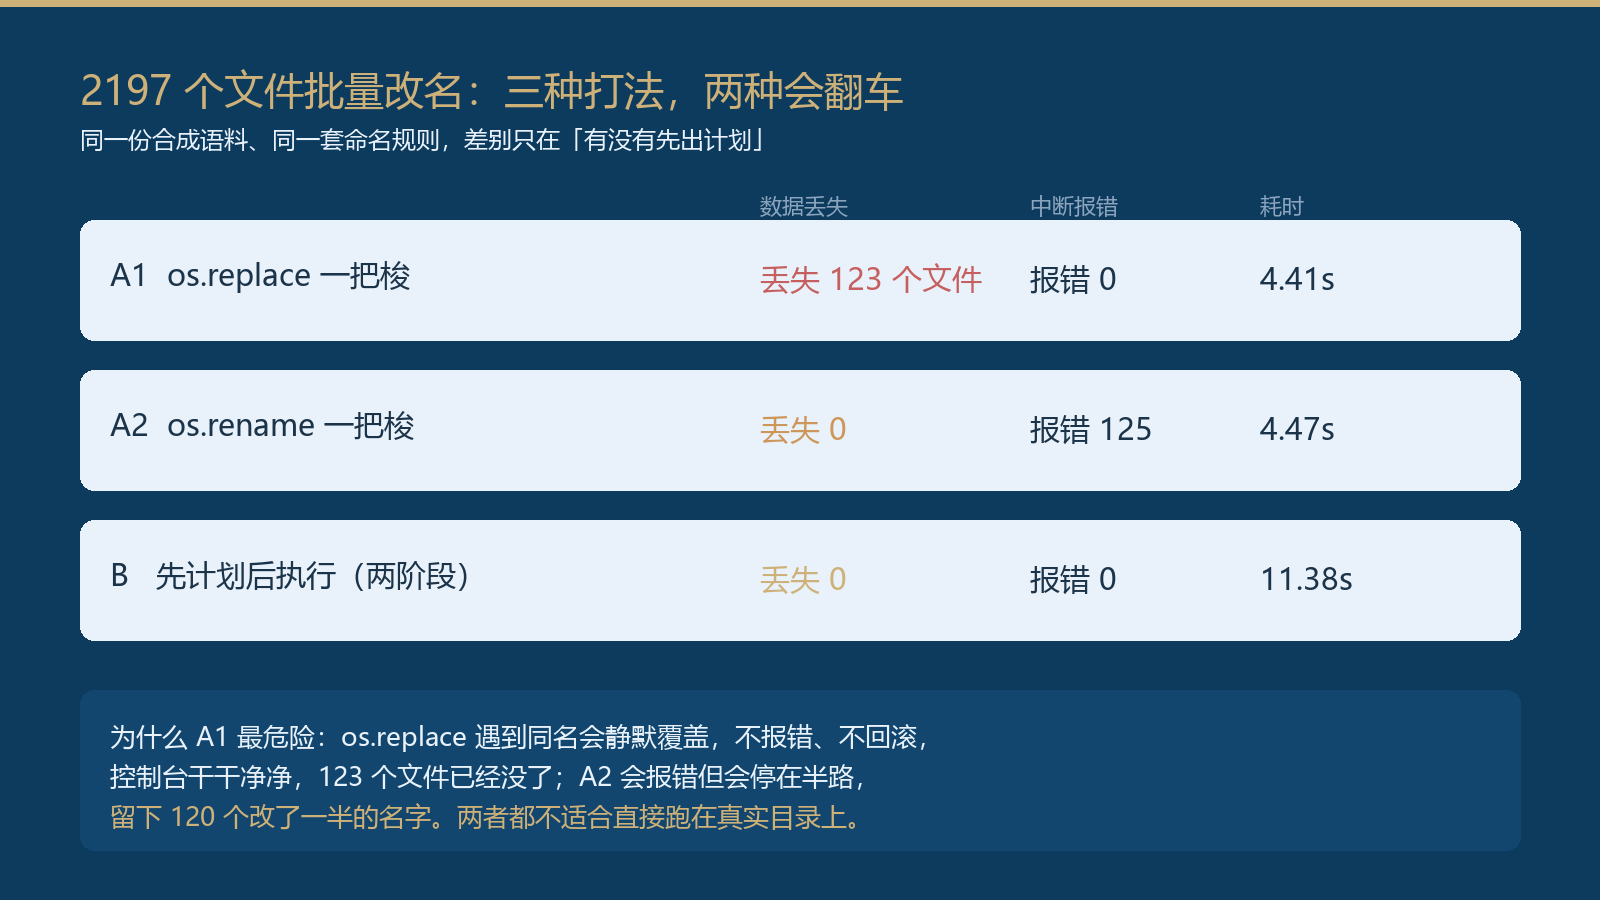
换个写法用 os.rename 会好一点吗?会报错,但更糟——中途崩了,目录停在半路:120 个文件改了名、125 个操作抛异常,脏名字和干净名字混在一起,比不改还难收拾。
三、实测:三种打法的差距
语料是我用固定随机种子现场合成的 2197 个文件 / 5.90 MB(最长文件名 155 字符,平均 26.4 字符),里面刻意埋了 240 个"归一化后必然撞车"的双胞胎、120 个内容完全重复的文件、40 个超长名、以及交换/轮转两组顺序陷阱。三份同种子副本,保证公平。
打法 | 改名成功 | 静默丢失 | 中断报错 | 残留脏名 | 耗时 |
|---|---|---|---|---|---|
A1 | 2197 | 123 | 0 | 0 | 4.41 s |
A2 | 2072 | 0 | 125 | 120 | 4.47 s |
B 先计划后执行(两阶段) | 2197 | 0 | 0 | 0 | 计划 1.83 s + 执行 9.54 s |
注意 A1 那一列:零报错,却丢了 123 个文件。如果只看控制台,你会以为一切正常。
B 方案慢一点(11.4 秒 vs 4.4 秒),但它多做了四件事,每一件都在"动手之前"完成:
四、流水线:五步,全部在动手前算完
1)扫描与体检。 遍历得到每个文件的相对路径、大小、SHA-1、修改时间。
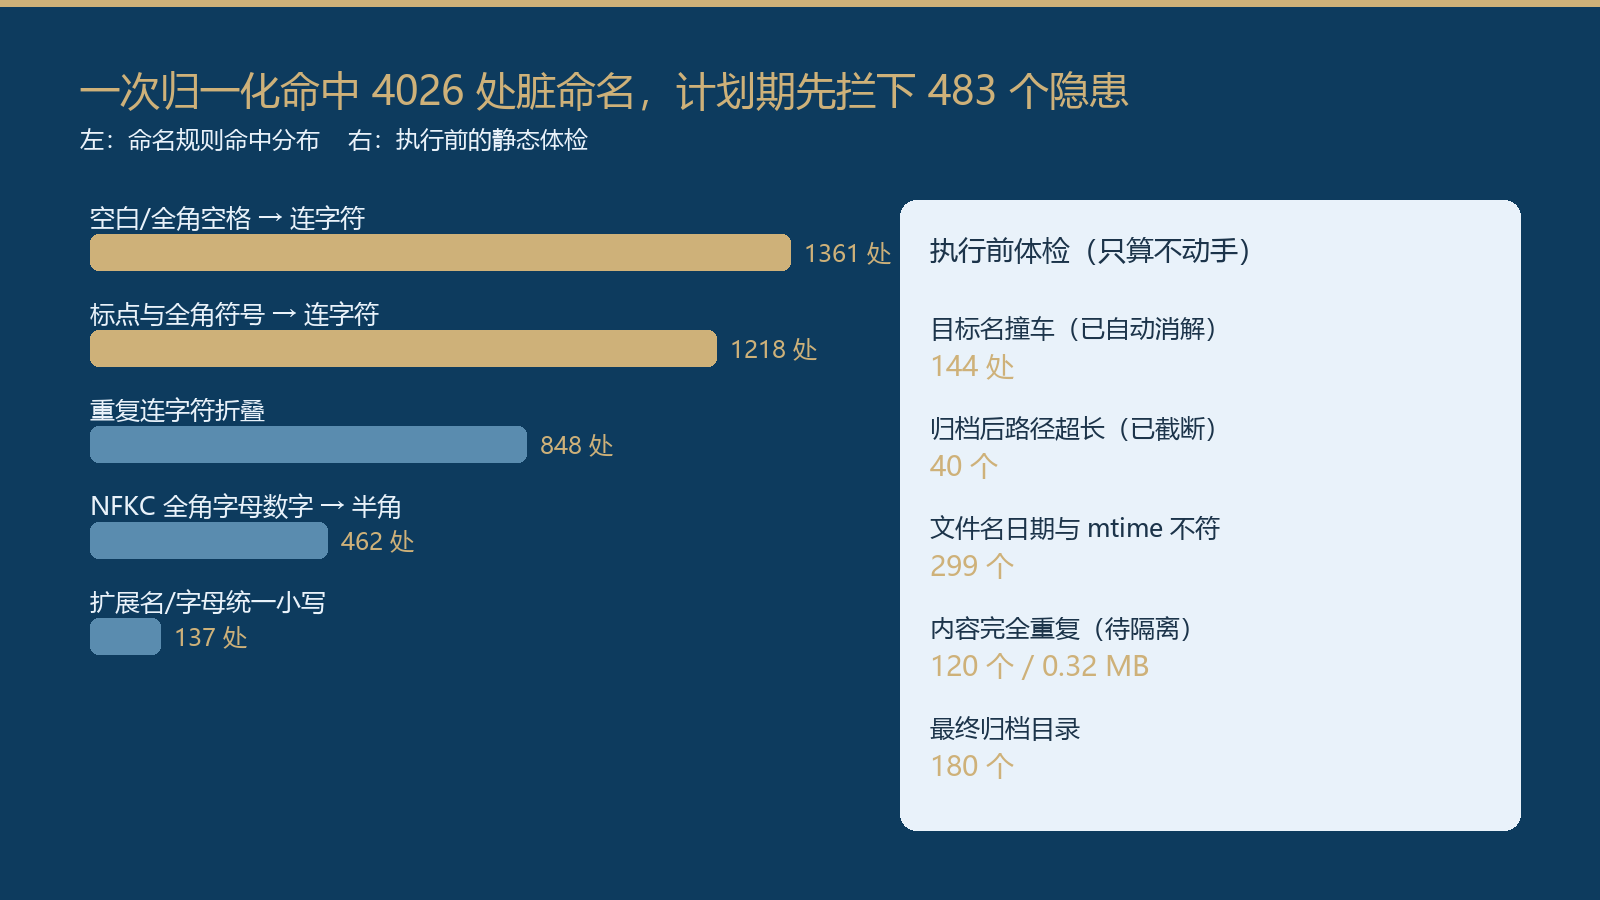
2)命名归一化。 五条规则,本次共命中 4026 处:空白/全角空格转连字符 1361 处、标点与全角符号转连字符 1218 处、重复连字符折叠 848 处、NFKC 全角转半角 462 处、大小写统一 137 处。
3)冲突消解。 目标名撞车的,144 处全部自动追加 -1、-2 后缀,绝不覆盖。
4)长度守卫。 归档后会多出 YYYY/MM/ 两级,本次有 40 个文件的最终路径会超过 240 字符预算,全部按"截断 + SHA-1 前 8 位"重写,保证既唯一又可读。
5)去重与归档。 内容完全相同的 120 个文件(0.32 MB)移入隔离区而不是删除;归档只认文件名里的日期,没有日期的一律进 _nodate/ 待人工确认——不拿 mtime 冒充日期,因为改名、拷贝、同步都会改掉 mtime。本次另有 299 个文件"文件名日期"与"mtime 年月"对不上,被单独标出来。
核心代码就两段,归一化 + 两阶段执行:
import os, re, unicodedata, hashlib
RESERVED = {"CON","PRN","AUX","NUL"} | {f"COM{i}" for i in range(1,10)} | {f"LPT{i}" for i in range(1,10)}
MAX_PATH, MAX_NAME = 240, 200

def normalize(name):
    stem, dot, ext = name.rpartition(".")
    if not dot: stem, ext = name, ""
    s = unicodedata.normalize("NFKC", stem)          # 全角 -> 半角
    s = re.sub(r"\s+", "-", s)                        # 空白/全角空格 -> 连字符
    s = "".join(c if (c.isascii() and (c.isalnum() or c in "._-")) or ord(c) >= 0x4E00 else "-" for c in s)
    s = re.sub(r"-{2,}", "-", s).strip("-._").lower() or "unnamed"
    if s.upper() in RESERVED: s = "_" + s             # 躲开 Windows 保留设备名
    return s + ("." + ext.lower() if ext else "")

def apply_two_phase(root, ops, journal):
    tmp_of = {}
    for i, (src, dst) in enumerate(ops):              # 阶段一:先换临时名
        sabs = os.path.join(root, src)
        tmp = os.path.join(os.path.dirname(sabs), "__ren_%05d__.tmp" % i)
        os.rename(sabs, tmp); tmp_of[src] = tmp
    for src, dst in ops:                              # 阶段二:再落最终位
        dabs = os.path.join(root, dst)
        os.makedirs(os.path.dirname(dabs), exist_ok=True)
        os.rename(tmp_of[src], dabs)                  # 目标存在即抛错,天然防覆盖
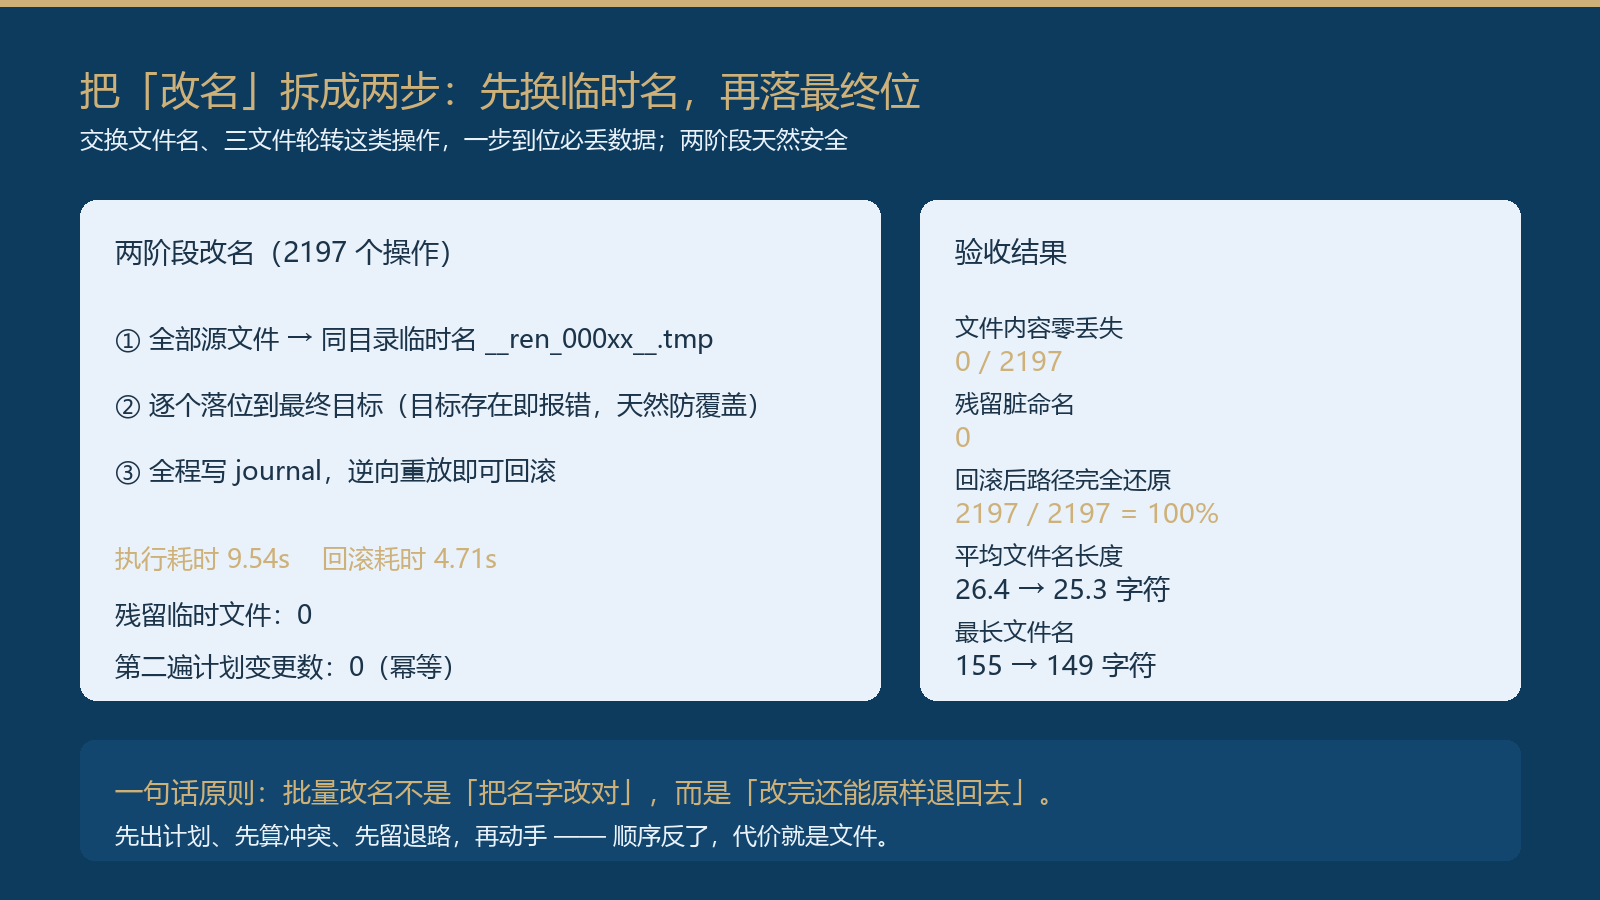
journal.append((src, dst)) # 全程留痕,可逆向重放两阶段是整套方案的命门:先把所有源文件换成互不冲突的临时名,再统一落位。这样无论你要交换两个名字还是轮转三个编号,都不会互相踩踏。第二阶段故意用 os.rename 而不是 os.replace——目标一旦存在就抛异常,让"覆盖"这件事在物理上不可能发生。
五、验收:改得动,也要退得回
验收项 | 结果 |
|---|---|
文件内容丢失 | 0 / 2197 |
残留脏命名 | 0 |
残留临时文件 | 0 |
回滚后路径完全还原 | 2197 / 2197 = 100%(耗时 4.71 s) |
第二遍计划变更数 | 0(幂等,重复跑不产生副作用) |
归档目录数 | 180 |
文件名平均长度 | 26.4 → 25.3 字符(最长 155 → 149) |
回滚就是把 journal 逆向重放一遍。跑完再算一次计划,0 变更——这才是可以放进定时任务里长期跑的状态。
六、踩坑清单(按被坑的惨烈程度排序)
os.replace静默覆盖是第一杀手。 宁可用os.rename让它在冲突时炸掉,也不要让它悄悄顶掉一个文件。 批量改名永远是两阶段。 只要目录里存在任何"交换"或"轮转",一步到位必丢数据。 大小写不敏感是 Windows 的隐藏雷。Report.txt和report.txt在你眼里是两个文件,在 NTFS 眼里是同一个。归一化到小写前,一定要按小写做冲突检测。 路径长度要在"最终位置"上算,不要在"当前位置"上算。 归档多两级目录、文件名加个后缀,都可能让 250 字符变成 265 字符然后创建失败。 别拿 mtime 当文件日期。 拷贝、同步、解压都会改它。名字里没有日期就老实进_nodate/,让人看一眼,比自动猜错强。 生成器本身也会撞名。 我第一版语料生成时因为随机撞名,清单记了 2205 条、磁盘只有 2197 个文件,导致"丢失数"恒定为 8。教训:清单必须以磁盘实际状态为准重建,不能记流水账。
七、给 WorkBuddy 的提示词模板
我要对
<目录>下的文件做批量改名与归档,请按下面约束生成脚本,并且先给计划、我确认后再执行: 1. 先扫描出每个文件的路径、大小、SHA-1、修改时间,输出一份"改名计划表"(旧名 → 新名 → 归档目录 → 是否冲突)。 2. 命名规则:NFKC 归一化、空白转连字符、非[A-Za-z0-9._-]与中日韩字符之外的符号转连字符、折叠重复连字符、统一小写、避开 Windows 保留名、单名不超过 200 字符、归档后全路径不超过 240 字符。 3. 冲突一律追加-1/-2后缀,绝不覆盖;内容哈希相同的文件移入_duplicates/而不是删除。 4. 归档只认文件名里的日期(YYYY-MM-DD或YYYYMMDD),没有日期的进_nodate/;同时报告"文件名日期与修改时间不一致"的清单。 5. 执行必须两阶段:先换临时名再落最终位;用os.rename不用os.replace;全程写 journal 支持一键回滚。 6. 跑完给我验收报告:丢失数、残留脏名数、临时文件残留数、回滚还原率、第二遍计划的变更数(必须为 0)。
八、写在最后
批量改名的技术含量不高,但它有一个残酷的特性:成功的时候没有反馈,失败的时候也没有反馈。你唯一能依靠的,是把"改名"这件事从一次性的动作,变成"计划 → 校验 → 执行 → 复盘 → 可回滚"的闭环。
按人工 8 秒改一个文件算,2197 个文件大约要 4.9 小时;这套流水线跑完是 11.4 秒(约 1500 倍)。但真正值钱的不是快,是改完还能原样退回去——123 个文件的教训,换这一条原则,我觉得值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号