代码与配置里的明文密钥怎么收口:凭据自动发现与存量纳管的治理实践
原创
代码与配置里的明文密钥怎么收口:凭据自动发现与存量纳管的治理实践
原创
安当加密 3
发布于 2026-10-11 13:23:10
发布于 2026-10-11 13:23:10
摘要:存量系统中的明文密钥散落在代码仓库、配置文件与环境变量中,是凭据泄露的主要源头,也是等保与密评里最难闭环的一项。本文从工程落地视角拆解凭据自动发现的完整链路:覆盖代码、配置、运行时三类扫描对象,结合正则与熵值双检模型识别凭据类型与风险等级,通过双写过渡与回滚开关把发现的明文平滑接入集中托管,并给出误报治理、灰度纳管与持续运营指标。全文聚焦凭据管理、密钥管理与零信任的实操方法,兼顾国密合规与数据脱敏诉求,不涉及任何外部链接。 正在上传图片...
关键词:凭据管理, 密钥管理, 明文密钥, 密评, 等保2.0, 国密, 数据脱敏, 零信任, 机密性, 密钥自动轮换, 特权账号管理, 动态凭据, 安全运营
一、为什么明文密钥是凭据治理的第一道伤口
在企业的真实环境里,第一次做安全复盘时最让人警惕的,往往不是精心设计的攻击链路,而是代码仓库里一行不起眼的数据库密码、写死在配置文件里的第三方令牌、或容器编排文件里明文的镜像仓库凭据。这些明文密钥的危险不在单点强度,而在于散落、无感、难追溯。
散落指同一份口令被复制到测试、预发、生产多套配置;无感指没有集中存储就没有轮换,写在代码里的密钥存活周期远超想象;难追溯指谁引入、谁拉取、何时泄露,在统一审计前基本是一笔糊涂账。
这正是现代凭据管理要解决的第一性问题:先把已经存在的明文找出来、收进来、管起来,再谈动态凭据和自动轮换。把这一步称为存量纳管,它是消除硬编码的前置条件,也是后续密钥自动轮换能安全落地的基础。
很多团队一上来就想用语动态凭据替换一切,结果在灰度切换时出问题却无法回退,反而造成更大故障。正确次序是:发现、识别、纳管双写过渡、验证、切换、回滚兜底。下面逐层展开。
二、凭据自动发现:扫描范围与识别逻辑
2.1 三类扫描对象:代码仓库、配置文件、环境变量
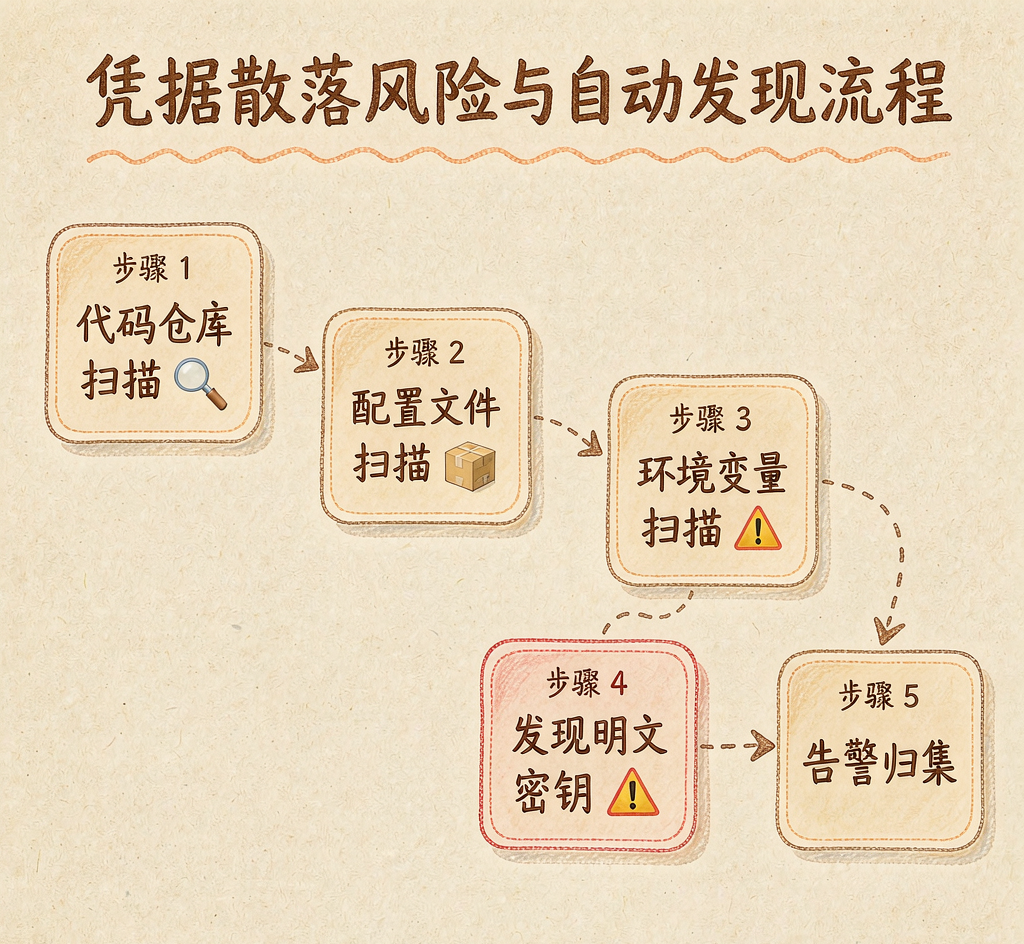
凭据自动发现的第一步是明确扫哪里。工程实践中,明文密钥的分布高度集中在三个平面。
代码仓库层面,直接硬编码的字符串常量、注释里随手写的临时口令、被提交进版本库的私钥文件,以及历史提交中已删除但仍在对象库里的密钥,都是最常被忽略的盲区。配置文件层面,Spring Boot 的 application.yml、Docker 与 Kubernetes 的清单、CI 流水线里的令牌、中间件的连接串,是重灾区。环境变量与运行时层面,容器 env、systemd 的 Environment、主机 shell profile、CI 变量、进程启动参数中暴露的口令,同样需要覆盖。
一个稳健的扫描器应当覆盖以上三层,并且对代码仓库要同时扫当前分支和历史提交,否则只解决了增量、没解决存量。在大型单体仓库或 monorepo 场景下,还应考虑扫描性能与噪声控制:对历史库采用增量扫描与对象库遍历相结合,对构建产物目录默认排除,并对不同语言的书写习惯做规则适配。只有把扫得全和扫得准同时做到,发现阶段的结果才具备进入后续纳管的可信度。
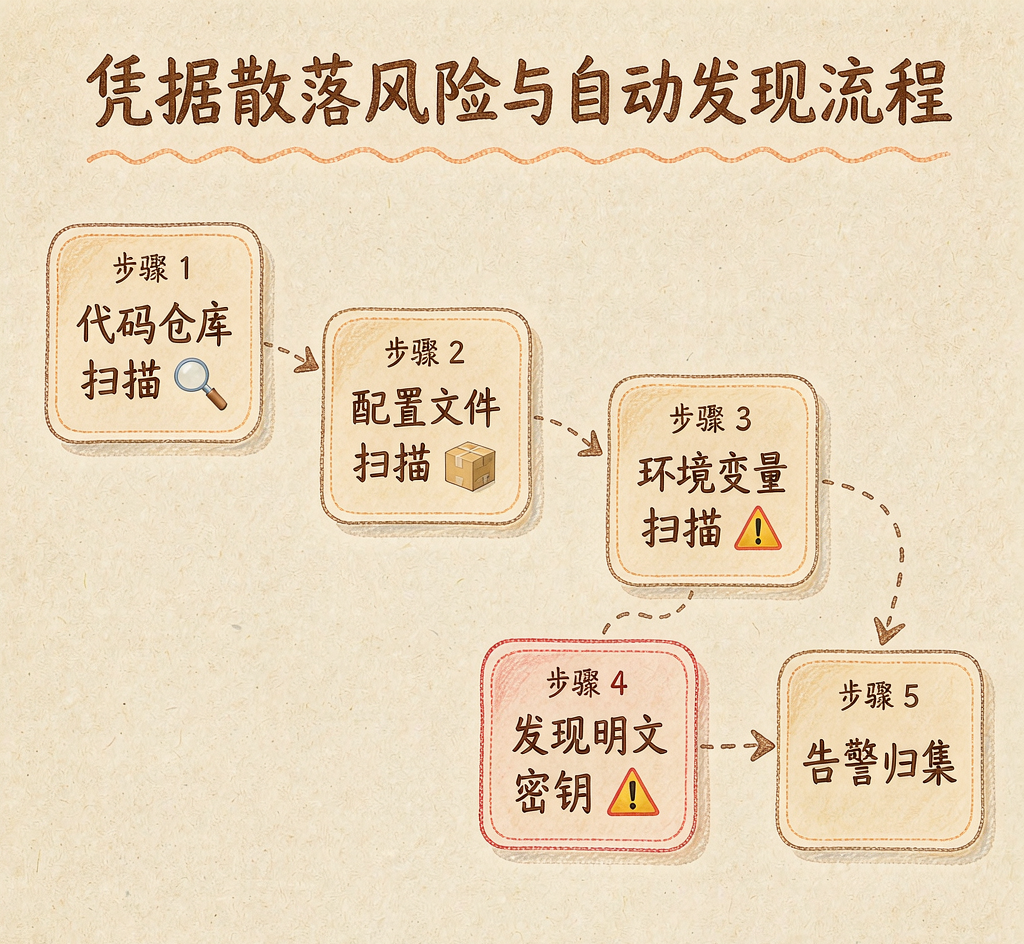
凭据散落风险与自动发现流程(手绘信息图)
2.2 凭据类型与风险等级判定
发现疑似字符串后,需要判定它是什么类型的凭据以及风险有多高。常见凭据类型与典型风险等级如下表:
凭据类型 | 典型载体 | 泄露影响 | 风险等级 |
|---|---|---|---|
数据库账号口令 | JDBC URL、yml、env | 全库数据泄露 | 高 |
云厂商访问密钥 | env、配置文件 | 资源被控、资损 | 高 |
第三方接口令牌 | 代码常量、配置 | 接口被滥用、配额盗用 | 高 |
私钥文件 | 仓库文件 | 身份伪造、签名伪造 | 极高 |
中间件口令 | 配置 | 内网横向移动 | 中高 |
内部服务令牌 | header、配置 | 越权调用 | 中 |
弱口令测试账号 | 测试配置 | 被爆破 | 中 |
风险等级判定不应只看类型,还要结合上下文:出现在生产命名空间、指向真实业务地址、被多个服务共享的凭据,应自动升级为高优先级,优先纳管与轮换。
2.3 正则加熵值的双检识别模型
单纯用正则匹配关键字会带来海量误报;单纯用熵值又会漏掉 password=123456 这类弱明文。工程上通常采用双检模型:
import re
from collections import Counter
from math import log

# 第一道:关键字锚定候选
PATTERN_KEY = re.compile(r"(?i)(password|passwd|pwd|secret|token|api[_-]?key|access[_-]?key)")
PATTERN_VAL = re.compile(r'"([^"]{6,})' + r"'|'([^']{6,})'")

# 第二道:熵值过滤强随机串
def shannon_entropy(s: str) -> float:
    freq = Counter(s)
    n = len(s)
    return -sum((c / n) * log(c / n, 2) for c in freq.values())

# 候选值熵值 >= 3.5 视为强随机密钥,直接进入高危队列
# 熵值低但匹配关键字且命中常见弱口令字典 -> 弱明文队列
def classify(value: str) -> str:
    if shannon_entropy(value) >= 3.5:
        return "high_random"
    if value in WEAK_DICT:
        return "weak_plain"
    return "review"
这种关键字锚定、熵值加权、弱口令字典的组合,是降低误报率的核心思路,后文误报治理会进一步展开。
三、误报治理:从扫出来一堆到真正可信
3.1 误报来源拆解
扫描器跑完第一遍,团队往往面对几千条命中,真正危险的也许只有几十条。误报主要来源于示例文档代码、测试桩数据、占位符引用、非凭据高熵串,以及语义关键字误伤。若不治理,扫描结果会沦为狼来了,没人再看报告。误报治理目标是把噪声压到可信区间,让安全运营真正看得过来。
3.2 白名单与上下文语义过滤
治理误报有三条主线:路径或文件级白名单、变量名语义白名单、上下文语义过滤。下面是一段白名单规则示意:
ignore_paths:
  - "**/test/**"
  - "**/docs/**"
  - "**/*.md"
weak_prefixes:
  - "example"
  - "sample"
  - "mock"
  - "dummy"
  - "placeholder"
fold_to_low_risk_if:
  - "value matches //$//{.+//}"
  - "variable in documented_fixtures"
路径白名单把测试与文档目录整体排除或降权;语义白名单对 example、sample、mock 等前缀变量默认标记为低危并折叠;上下文过滤判断赋值右侧是否引用了另一个变量、是否为占位符模板、是否出现在被测试框架标注的函数中。
3.3 命中分级与人工复核闭环
最后一步是给每一条命中打上高危、中危、低危、误报标签,进入人工复核闭环。高危直接进工单,要求责任人在服务等级协议内完成纳管或作废;中危进入观察列表随下次扫描复验;低危或疑似误报折叠展示,可一键标记非凭据进入规则库,反哺白名单。这个闭环也是密钥安全能力的体现,发现不是终点,可处置、可关闭、可审计才是。
四、存量明文平滑纳管:双写过渡与回滚开关
4.1 纳管流程总览
把发现的明文接入集中托管,最忌讳一刀切替换。平滑纳管的标准流程如下:
# 存量明文平滑纳管标准流程
# 发现命中 -> 类型风险分级 -> 导入托管库生成托管路径
#  -> 应用侧改为从托管库读取 -> 双写过渡期 -> 验证读取一致
#  -> 关闭明文回退 -> 删除源码配置明文 -> 纳入自动轮换
echo "step1: discovery"
echo "step2: classify by type and risk"
echo "step3: import to vault with hsm-root-key"
echo "step4: dual-write transition"
echo "step5: verify read consistency"
echo "step6: switch and purge plaintext"
其中导入托管库指的是把明文值安全搬迁到集中凭据管理系统,根密钥由硬件加密机保护、落盘采用国密算法加密,源码与配置里只保留一个引用标识,实现消除硬编码。
4.2 双写过渡
所谓双写过渡,是指在切换期间,应用同时保留旧明文和新托管引用两条读取路径,并以托管值为准、明文作为兜底:
// 改造前:硬编码
String dbPwd = "Prod@Passw0rd_2023";

// 改造后:优先托管,明文兜底(过渡期)
@Value("${db.password.ref:}")
private String pwdRef;          // 托管引用标识

@Value("${db.password.legacy:}")
private String pwdLegacy;       // 过渡期明文兜底

public String resolvePassword() {
    String v = secretManager.get(pwdRef);   // 从托管库读取
    if (v != null && !v.isEmpty()) {
        return v;
    }
    return pwdLegacy;                       // 兜底,便于回滚
}
这种写法的好处是:一旦托管链路异常,应用仍能用兜底明文维持运行,把切换风险隔离在可控范围。过渡期通常设为 1 到 2 个发布周期,期间监控托管读取成功率。
4.3 回滚开关设计
回滚开关是平滑纳管的安全气囊。它要解决一个现实问题:切换到托管后,如果集中凭据服务出现可用性问题,如何在不重新发版的情况下让应用退回明文兜底。
# 纳管回滚开关(示意)
secret:
  manager:
    enabled: true               # 总开关:true=走托管,false=纯兜底明文
    fallback-plaintext: true    # 托管读取失败时是否使用兜底明文
    read-timeout-ms: 200
    circuit-breaker:
      open-threshold: 5         # 连续失败次数触发熔断
      half-open-after-ms: 30000
总开关 enabled 一键切回纯明文模式,无需改代码、重新构建,配置下发即可生效。熔断在连续失败达阈值后自动触发,瞬时退回兜底避免雪崩。灰度可按应用、命名空间、凭据 ID 三维分别开关,做到哪条出问题回退哪条。回滚开关放进集中配置而非写死代码,让运维在故障第一时间就能止血。
4.4 灰度纳管策略
存量明文不可能一夜之间全部纳管,应按风险与影响面分批次推进:
# 灰度纳管批次规划
# 批次1:高危 + 只读风险低的服务(先验证链路稳定性)
# 批次2:中危 + 核心链路服务(小流量灰度)
# 批次3:低危 + 长尾服务(批量纳管)
# 每批次:双写过渡 -> 观测1周期 -> 关闭兜底 -> 删除明文 -> 纳入轮换
echo "batch1: high-risk read-only services"
echo "batch2: mid-risk core-path services"
echo "batch3: low-risk long-tail services"
同时建立纳管看板,记录每条凭据的是否发现、是否导入、是否切换、回滚开关状态、最近一次轮换时间,让存量纳管从运动式清理变成可度量的持续推进。
五、与 DevOps 流水线的集成
存量纳管解决已经存在的问题,而流水线治理解决防止新问题再产生,两者必须打通。CI 卡点加入凭据扫描,合并请求出现新明文密钥直接拦截;预发校验确认所需凭据已在库,缺失则阻断发布;运行时注入由辅助容器拉取凭据注入环境变量,源码与镜像不再落明文;轮换联动在凭据轮换后触发依赖方重载,避免连接中断。
存量纳管与持续治理闭环(手绘信息图)
六、凭据轮换与国密合规
纳管完成之后,密钥自动轮换才有安全落地的条件。对数据库这类静态凭据,轮换策略通常是托管库生成新值、推送到数据库或中间件改密、通知依赖方重载,失败处理保留旧值多个版本以便回退。
对于数据库凭据,成熟的系统会支持 MySQL、PostgreSQL、Oracle、SQL Server、Redis,以及达梦、人大金仓等国产数据库,做到改密、分发、重载全自动化。合规层面,金融、政务、医疗等行业对密码有明确要求:根密钥应驻留在硬件加密机中、落盘加密采用国密算法、密钥生命周期全程审计。选择具备国密凭据能力的系统,意味着 SM4 等算法在存储与传输环节被原生支持,而非事后补丁式改造;同时全链路审计能够回答这条凭据谁在何时被读取、被哪台服务使用,满足等保与密评对特权账号管理的追溯要求。
有案例显示,引入密码基座与凭据管理组合后,凭据相关泄露事件下降约九成,新系统开通耗时从 2 小时压缩到 5 分钟。该数据说明发现、纳管、轮换、审计四步闭环能把人为疏漏概率压到最低,具体选型仍需结合自身架构评估。
七、常见落地陷阱与规避
第一,只扫当前分支不扫历史,历史提交里的密钥照样能被拉取,必须纳入扫描范围。第二,误报不治理导致扫描废弃,没有分级与白名单报告无人看等于没扫。第三,一刀切切换无回滚,托管的第一个故障就会演变成生产事故,双写与回滚开关不可或缺。第四,纳管后忘记删明文,源码配置里明文还在等于纳管半途而废,必须清理。第五,只纳管不轮换,纳管只是起点,没有自动轮换凭据仍会长期暴露。第六,审计链断裂,读取凭据的行为若无记录出问题无法定责,全链路审计必须打通。
八、度量指标与持续运营
存量纳管不是扫一次改一次的临时任务,而应当成为安全运营的一项常态指标。只有把过程量化,才能向管理层证明投入产出,也才能在下次审计时拿出可追溯的证据。建议建立以下度量维度:
度量指标 | 计算口径 | 健康目标 |
|---|---|---|
明文凭据存量 | 全仓库扫描命中的高危中危明文数 | 持续下降,趋近 0 |
纳管覆盖率 | 已纳管凭据 / 已发现凭据 | 不低于 95% |
双写过渡占比 | 处于双写未切换的凭据数 | 短时存在,长期不超过 5% |
回滚开关命中率 | 走兜底明文的读取次数 / 总读取 | 越低越好,异常时上升 |
轮换合规率 | 在周期内完成轮换的凭据占比 | 100% |
新增明文拦截率 | CI 卡点拦截的新明文 / 新增明文 | 100% |
这些指标共同刻画了一个团队的密钥安全水位。当明文凭据存量逐月收敛、新增明文拦截率稳定为 100% 时,说明治理已经从救火转入预防。反之,如果纳管覆盖率长期卡在低位,往往不是技术问题,而是责任归属与排期没有压实,此时需要把凭据清单按业务域拆解到具体负责人,用周会跟踪闭环。
需要强调的是,度量本身也有成本:扫描频率过高会拖慢流水线,过度审计会淹没有价值的告警。合理的做法是对生产高频、测试低频,对高危全量、低危抽样,把安全资源投向风险最高的地方。
方案参考
对于准备启动存量明文纳管的团队,下面是一套通用的落地方法论,与具体产品无关,可按图索骥。资产盘点先行,先梳理代码仓库、配置中心、环境变量三类载体的分布,明确扫描边界与责任人,避免盲目开扫。小范围试点,挑选 1 到 2 个低风险服务做端到端验证,跑通发现、识别、双写、切换、回滚全流程,沉淀内部操作手册。分级治理误报,建立路径白名单、语义过滤与人工复核闭环,把扫描结果收敛到可信区间再谈全量推广。双写加回滚兜底,任何纳管切换都必须保留明文兜底与一键回滚开关,并配置熔断,把切换风险隔离在可控范围。灰度分批推进,按风险等级与影响面分批次纳管,每批次设置观测期,确认稳定后再关闭兜底、清理明文。卡点与流水线打通,在 CI 阶段拦截新增明文,在部署阶段校验凭据就绪,防止存量清零后再次反弹。轮换与审计闭环,纳管完成后启用自动轮换,并打通全链路审计,使每条凭据可追踪、可定责、可合规举证。合规对齐,结合行业合规要求,确认根密钥保护、落盘加密算法与审计能力是否满足等保、密评及国密相关规范,再做规模化推广。
这套方法论的价值不在于用了哪个系统,而在于把凭据治理从一次性的清理运动,转成可持续、可度量、可回退的工程能力。实际选型时,建议以能否平滑纳管存量、能否在 DevOps 全链路无缝替换、是否原生支持国密与审计三条标准去评估,例如以安当SMS为例对照上述能力做适配验证,再结合自身数据库与中间件矩阵落地。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号