#WorkBuddy# 实战:AI 自动化一天连发 11 篇教程——逆向 React 富文本编辑器的 5 个静默坑
原创
#WorkBuddy# 实战:AI 自动化一天连发 11 篇教程——逆向 React 富文本编辑器的 5 个静默坑
原创
用户12814938
发布于 2026-10-12 22:55:31
发布于 2026-10-12 22:55:31
#WorkBuddy# 实战:AI 自动化一天连发 11 篇教程——逆向 React 富文本编辑器的 5 个静默坑
一、背景:一个"点不动"的发布按钮
我用 WorkBuddy 搭了一条内容流水线:把日常踩坑实录写成教程,批量发到腾讯云开发者社区。目标是一天发 11 篇。脚本很快写完:填标题、填正文、填发布弹窗、点确认——然后卡死了。
现象非常诡异:发布弹窗里所有字段肉眼可见全部填好(原创已选、标签已选、封面已传),点"确认发布"后什么都没发生——不报错、不弹窗、不关闭,连一个网络请求都没有。
这就是本文的主角:React 受控组件里的"静默坑"。它们不抛异常、不留日志,看起来像"没反应",实际上是在组件内部校验处直接 return 了。接下来按排查顺序,把 5 个坑逐一拆开。
二、排查武器库:四个定位手段
在讲坑之前,先给四个通用武器,任何 React 页面自动化都用得上:
// 武器1: 网络监听——确认"到底发没发请求"
page.on("response", r => {
  if (r.url().includes("CreateArticle")) console.log(await r.body());
});

// 武器2: 拉取前端源码——校验逻辑全在 JS 里,下载下来全文搜关键字
// 页面上 performance.getEntriesByType('resource') 能列出所有已加载 JS

// 武器3: React fiber 探针——从 DOM 元素沿 fiber 树上行找组件实例
function fiberOf(el){
  for (const k in el){
    if (k.startsWith('__reactInternalInstance$') || k.startsWith('__reactFiber$')) return el[k];
  }
  return null;
}

// 武器4: 猴子补丁——实例方法不可靠时,包一层强制返回正确值第一个武器最先给出决定性证据:确认发布后确实零请求。问题不在网络、不在后端,而在前端校验——某一步没过,静默 early-return。
三、坑一:DOM 与 State"两张皮"
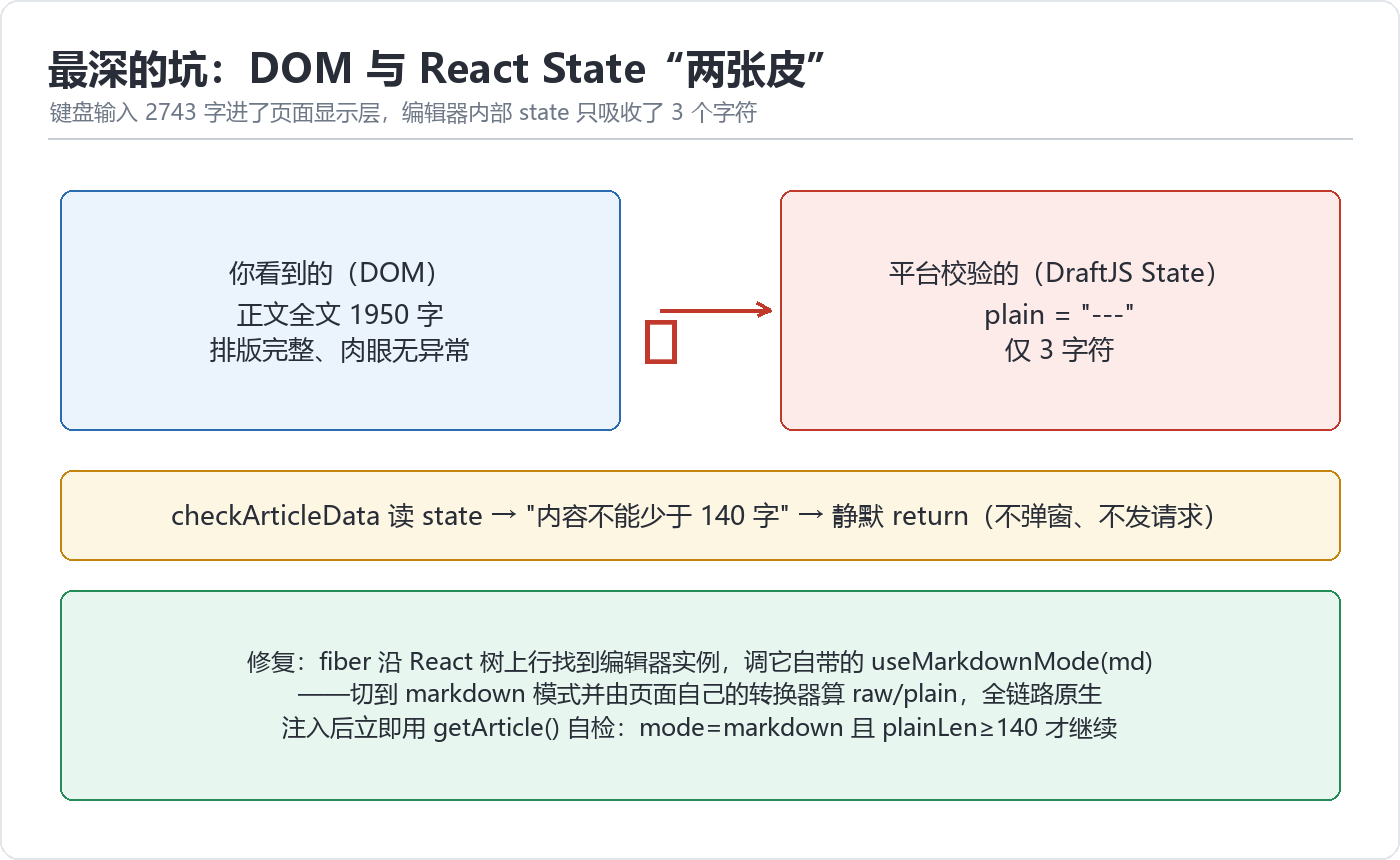
最深的坑在这。我从源码里挖到了编辑器的校验函数 checkArticleData,检查链是:标题非空 → 正文 plain ≥ 140 字 → 来源已选 → 标签已选。而报错 toast 只闪现几秒,高频抓取后终于逮到:"文章内容不能少于 140 字"。
可页面上正文明明有近 2000 字!用 fiber 探针现场调 getArticle() 一看真相大白:
{ mode: "rich", plainLen: 3, rawBlocks: 6 }
// 正文 2743 字打进了 DOM(可见 1950 字),
// 但富文本编辑器 DraftJS 的内部 state 只吸收了 "---" 3 个字符键盘输入(insert_text)只进了页面显示层,React 受控组件根本不认 DOM,只认 state。平台校验读的是 state,所以判定"内容为空"。
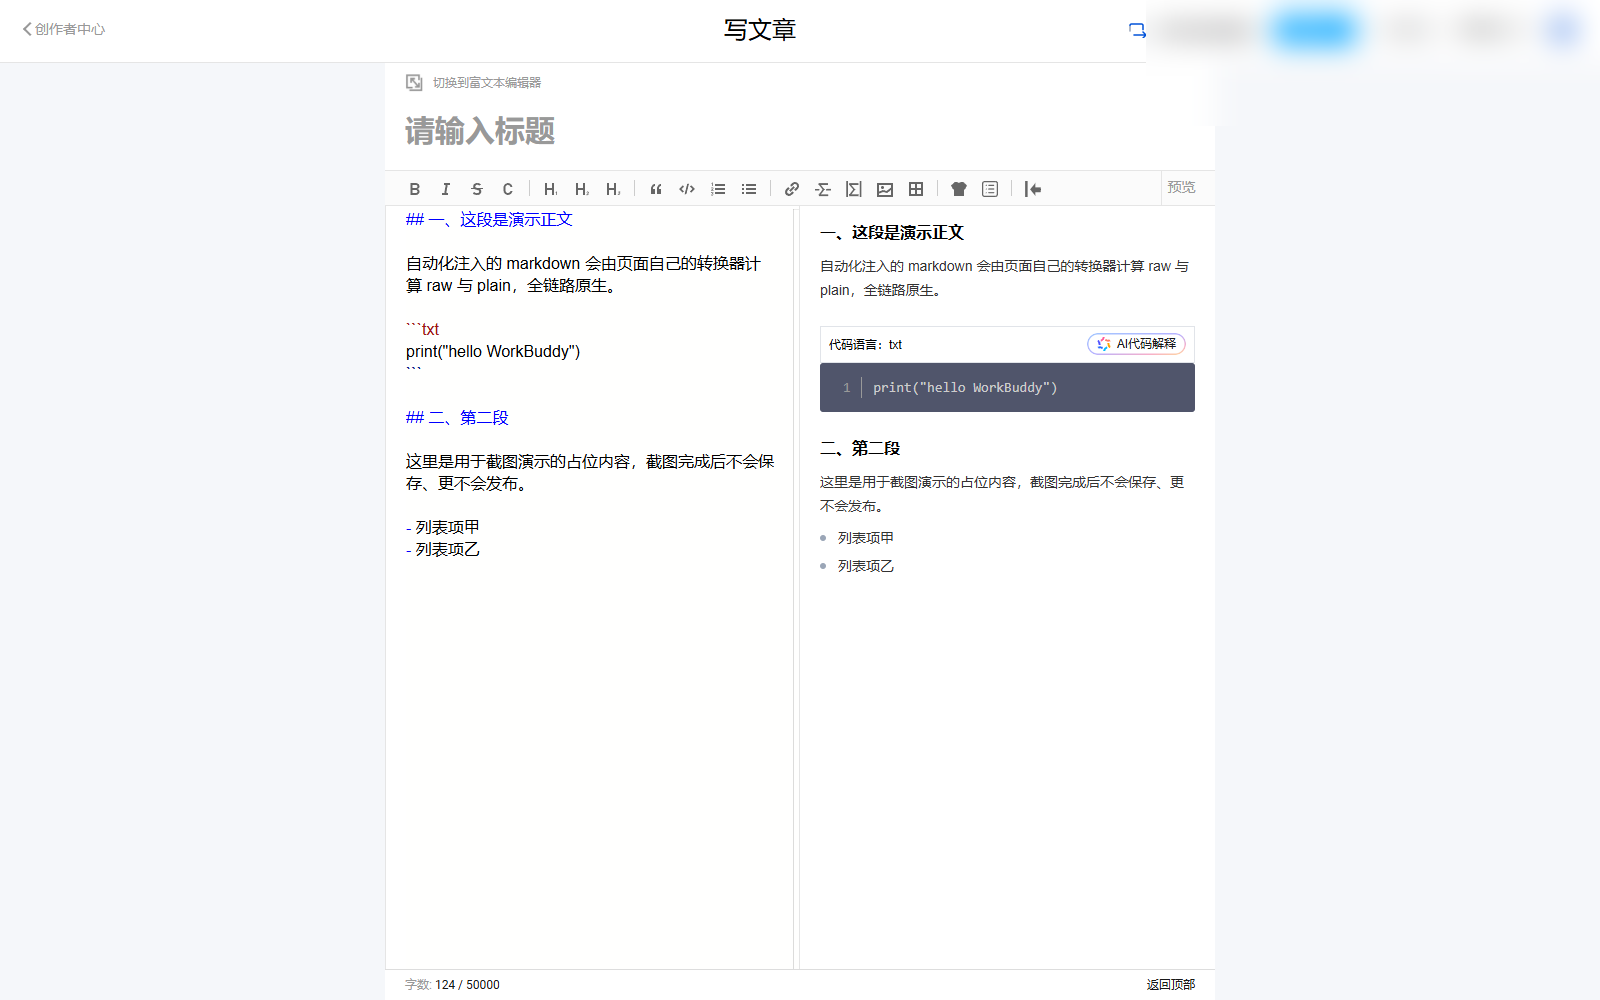
修复方案不是暴力塞 state,而是借力:fiber 找到编辑器实例,调它自带的 useMarkdownMode(md)——切到 markdown 模式并注入正文,之后 raw/plain 由页面自己的转换器计算,全链路原生。注入后立刻自检 mode==='markdown' && plainLen>=140,不过就中止。
四、坑二:双实例错乱,标题谁也填不进去
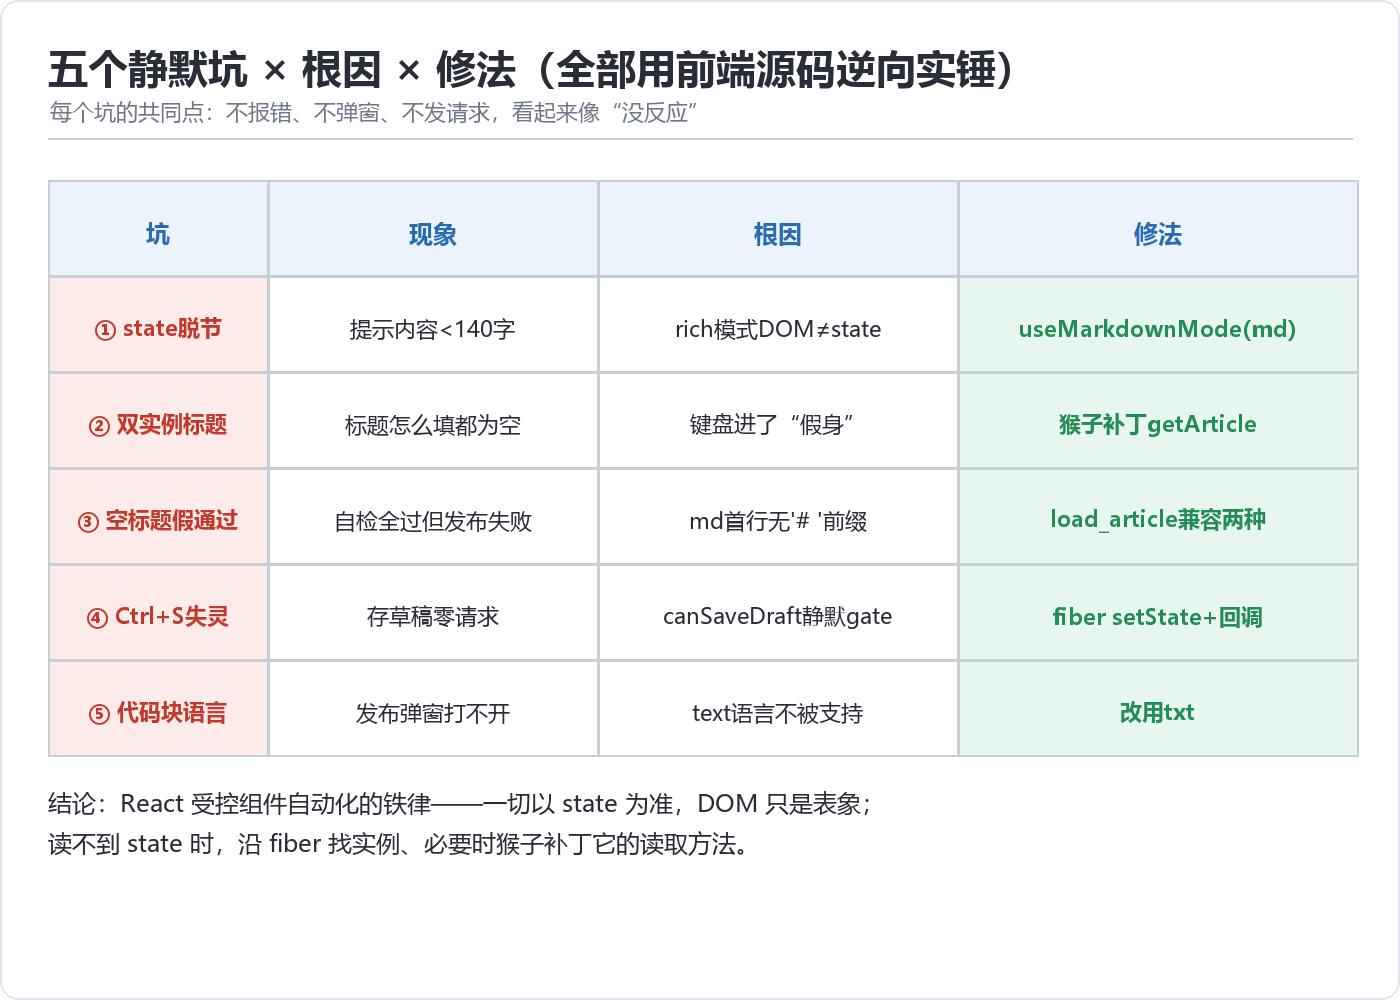
修完坑一连发顺利,但第二批文章卡住:草稿保存零请求。深挖后发现 state.title 是空的——"请输入文章标题"。
诡异的是,标题输入框里明明有字。进一步探针发现:页面上存在两个编辑器实例,键盘输入进了"假身",而发布/存草稿路径读取的是"真身" editor.current.getArticle()。setArticle 也试了,同样进不了真身。
最后的解法是釜底抽薪——猴子补丁:
const orig = ed.getArticle.bind(ed);
ed.getArticle = function(){
  const a = orig();
  if (window.__forcedTitle) a.title = window.__forcedTitle;  // 强制返回正确标题
  return a;
};
所有校验、存草稿、发布都走这个读取路径,补丁一层管到底。这是应对"不知道哪个实例是对的"的终极兜底。
五、坑三:空标题的"假通过"
标题修好后又翻车:一篇自检"全部通过"的文章,发布后标题是空的。回查发现极其简单的原因——markdown 文件首行是 #WorkBuddy# xxx,没有 # 的 H1 前缀,我的标题提取函数只认 # 开头,提取结果就是空串。后续所有"标题非空"的验证都是"空 == 空"的假通过。
教训:校验逻辑要防"双空相等"。修复后强制 len(title)>0 才放行。
六、坑四:canSaveDraft 的静默 gate
Ctrl+S 存草稿偶发零请求。源码里找到存草稿的门槛条件:
canSaveDraft = !publishing && !published && !savingDraft && (!currentDraftId || dirty)只要 currentDraftId 非零且 dirty 为 false,Ctrl+S 就一声不响直接跳过。修复:fiber 找到写页实例,setState({dirty:true, currentDraftId:0, ...}),并且在 setState 的回调里再调 handleArticleSave()——因为 React 的 setState 是异步批处理,同步紧跟的调用读到的还是旧值。这个"回调里再调"的细节卡了我三轮测试。
七、坑五:代码块语言 text 不被支持
最后一篇的发布弹窗干脆打不开,高频抓 toast 抓到:"当前编辑器暂不支持代码块标记为 text 语言"。我的自动补语言逻辑给空围栏补了 text,而官方只认 txt。一行改动解决。
八、全链路总览
三个核心环节见下面三张图:管线全流程、DOM/State 脱节示意、五坑对照表。
九、可迁移的经验
- React 受控组件自动化,一切以 state 为准,DOM 只是表象;读不到 state 就沿 fiber 找实例。
- 静默校验的抓法:错误 toast 存活只有几秒,要用 300ms 高频轮询抓文案,或者直接逆向前端源码找校验函数。
- 猴子补丁是兜底利器:当写入路径全部失灵时,补丁读取路径同样有效——因为所有消费方都走同一个读取函数。
- 保险丝设计:每步注入后自检,不过就中止,绝不把页面留在半填状态——批量自动化里,"确定失败"比"可能成功"更值钱。
这套管线最终做到:一条命令发一篇,一天 11 篇全部上线,零人工点击。踩坑的每一分钟,后来都变成了这篇教程的字数——这也是"薅羊毛"的底层逻辑:真实经历就是最好的素材。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号