#WorkBuddy# 383 封邮件归档:朴素脚本主题还原只有 35.25%,我用一条七阶段流水线做到 100%
原创
#WorkBuddy# 383 封邮件归档:朴素脚本主题还原只有 35.25%,我用一条七阶段流水线做到 100%
原创
用户12784192
发布于 2026-10-13 10:40:14
发布于 2026-10-13 10:40:14
本文所有数字均由本机脚本在合成语料上真实跑出,含标准答案(GT)逐条比对;语料与结果可通过文末命令完整复现。
一、痛点:归档任务"看起来跑完了",其实什么都没还原
邮箱归档是我最常交给自动化去做的一类活:一批 .eml 从客户端导出,再配一个 .mbox 容器,要求整理成可检索的索引。第一版脚本很朴素——按行读文本、正则抠 Subject:、From:、Date:,把第一个空行之后的内容当正文。
脚本跑完,输出了一份 383 行的索引,零报错,看起来皆大欢喜。真正翻开才发现问题:
- 主题列里大量条目是
=?gb2312?B?xxxx?=,人根本读不了; - 中文主题变成"月度算""固件升回"这种缺字残句;
- 正文里混着
Content-Type: multipart/mixed; boundary=...和成段 base64; - 附件一个都没落盘,但附件的 MIME 头明明在文件里。
为了把问题量化,我先造了一批带标准答案的合成语料,再用三档方案分别跑,逐项对照。
二、实验设置:383 封带标准答案的合成语料
语料完全由脚本合成,不含任何真实邮件或业务信息。关键参数(由生成脚本统计后写入 GT):
项目 | 数量 | 说明 |
|---|---|---|
消息总数 | 383 | eml 323 封 + mbox 容器 60 封 |
唯一 / 重复 | 320 / 63 | 45 封完全重复 + 18 封仅头部差异的变体重复 |
语料体积 | 13.74 MB | 含 base64 附件载荷 |
附件总数 | 301 | 仅 10 种不同文件名 |
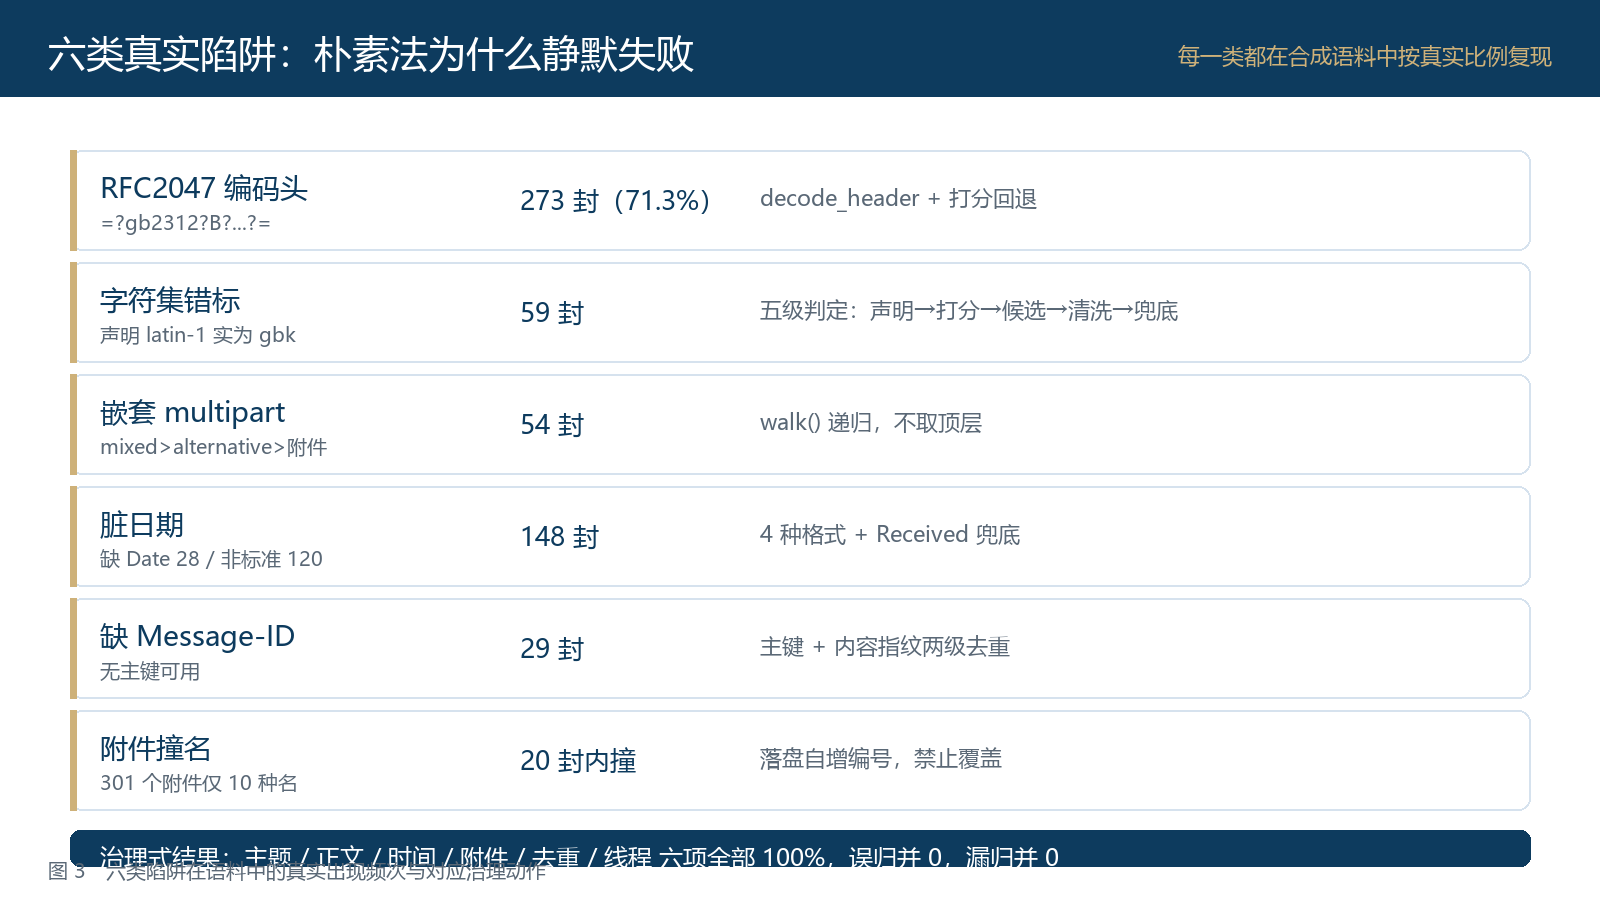
含 RFC2047 编码词 | 273 封(71.3%) |
|
字符集错标 | 59 封 | 头部声明 |
缺 Message-ID | 29 封 | 无主键可用 |
日期异常 | 148 封 | 缺 Date 28 封 + 非标准格式 120 封 |
会话线程 | 257 组 | 40 组共享 References 根 |
语料结构分布:plain 148、mixed 99、alternative 82、nested 54;传输编码 base64 139、quoted-printable 130、7bit 114;字符集 utf-8 134、gb2312 67、gb18030 62、big5 61、iso-8859-1 59。
标准答案逐封记录了主题原文、正文全文、时间戳、附件清单(文件名 + 字节数)、线程归属,因此每一项指标都能精确算覆盖率,而不是"看起来对了"。
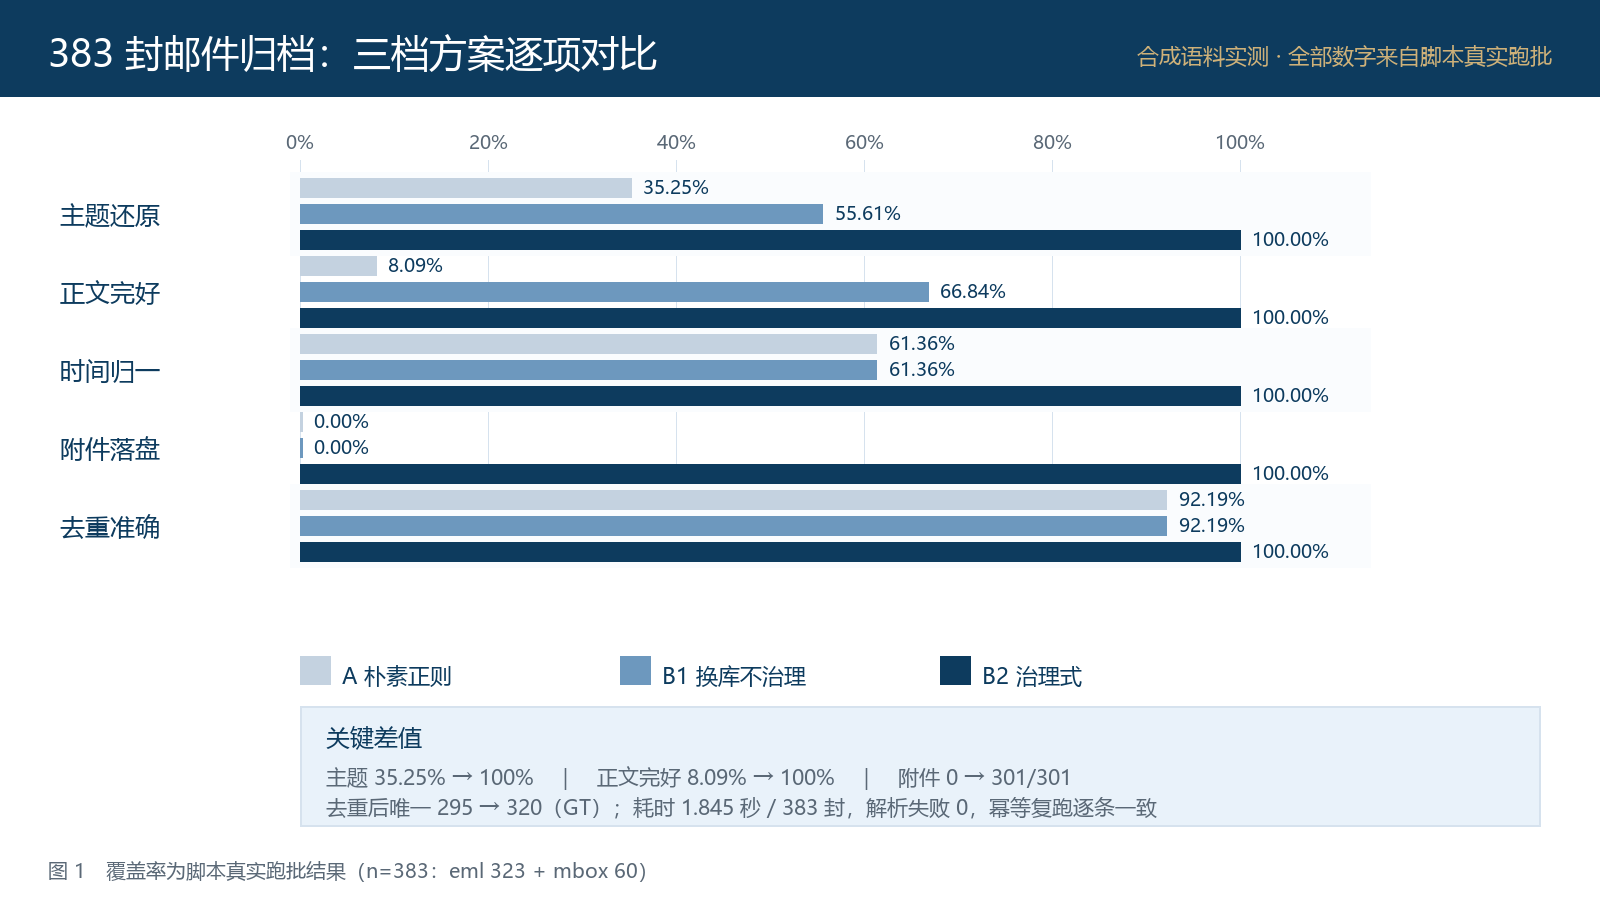
三、三档方案的实测对比
三档方案:
- A 朴素正则:按行读 UTF-8 文本,正则抠头部字段,正文取首个空行之后。
- B1 换库不治理:改用
email标准库解析,但头部不解码词、正文用头部声明的编码直接decode、不去重、附件不落盘。 - B2 治理式流水线:分七个阶段,头与体分开解码、五级字符集判定、时间多格式归一、附件落盘、两级去重、线程归组。
指标 | A 朴素正则 | B1 换库不治理 | B2 治理式 |
|---|---|---|---|
主题还原 | 35.25%(135/383) | 55.61%(213/383) | 100.00%(383/383) |
正文完好 | 8.09%(31/383) | 66.84%(256/383) | 100.00%(383/383) |
时间归一 | 61.36%(235/383) | 61.36%(235/383) | 100.00%(383/383) |
附件落盘 | 0 个 | 0 个 | 301/301 个 |
去重后唯一 | 295(覆盖 92.19%) | 295(覆盖 92.19%) | 320(= GT 320) |
会话线程 P/R/F1 | — | — | 100 / 100 / 100 |
耗时 | 0.187 s | 0.330 s | 1.845 s |
吞吐 | — | — | 207.6 条/秒 |
有三个数字值得单独说明,因为它们揭示了朴素方案失败的真实机理。
其一,B1 的"正文锚点可见 100%"是假象。 如果只检查 ASCII 锚点是否出现,B1 是满分;但把正文与标准答案逐字比对(相似度 ≥ 0.98 视为完好),B1 只有 66.84%——因为字符集错标的 59 封邮件,中文正文已整体变成乱码,而锚点是纯 ASCII,照样能匹配上。这就是为什么本次评估额外引入了"正文完好率"这一列:锚点匹配率会系统性高估解析质量。
其二,B1 的主键去重是"看起来能用"。 A 与 B1 都恰好得到 295 条唯一记录(92.19%),但真值是 320 条。差额 25 条从哪来?29 封缺 Message-ID 的邮件没有主键,若以"无主键"作为键参与去重,不同的无主键邮件会互相误判为重复而被丢弃。B2 用主键 + 内容指纹(主题|发件人|正文的 SHA256 前缀)两级去重后,恰好得到 320 条:主键拦下 59 条,副键再补捞 4 条。
其三,时间归一是最容易被忽略的长尾。 A 与 B1 都是 61.36%,因为两者都只试 RFC 2822。语料里有 120 封用了 2025/06/17 12:53、2025-07-04 04:28:34、2025年07月04日 04:28 这类土法日期,还有 28 封连 Date 头都没有。B2 用了四级回退:RFC 2822 → 4 种显式格式 → Received 头链 → 标记归零,把 61.36% 拉到 100%。
四、可复制代码:七阶段流水线
4.1 五级字符集判定(最关键的 30 行)
朴素做法是"按声明字符集 decode",一旦错标就全篇乱码。正确做法是先解码再打分,谁能解出最像人话的结果就用谁:
CANDIDATES = ["utf-8", "gb18030", "big5", "gbk", "shift_jis", "euc-kr", "latin-1"]

def _score(t):
    """给解码结果打分:汉字占比高、控制字符/替换符/高位拉丁少 = 越像人话"""
    if not t:
        return -9.0
    n = len(t)
    repl = t.count("\ufffd")                              # 解码替换符
    cjk = sum(1 for c in t if "\u4e00" <= c <= "\u9fff")  # 汉字
    latinsup = sum(1 for c in t if "\x80" <= c <= "\xff")  # 高位拉丁(乱码特征)
    ctrl = sum(1 for c in t if ord(c) < 32 and c not in "\r\n\t")
    return (1.5 * (cjk / n) + (n - latinsup - ctrl - repl) / n
            - 3.0 * (repl / n) - 1.2 * (latinsup / n))

def smart_decode(raw, declared=None):
    order = []
    if declared:                                  # 1) 声明字符集优先试
        cs = declared.lower().strip().replace('"', "")
        cs = "latin-1" if cs == "iso-8859-1" else cs
        if cs in CANDIDATES:
            order.append(cs)
    for c in CANDIDATES:                          # 2) 候选池补齐
        if c not in order:
            order.append(c)
    best, best_cs, best_sc = None, None, -9.0
    for cs in order:                              # 3) 严格解码 + 打分取最优
        try:
            t = raw.decode(cs, errors="strict")
        except Exception:
            try:
                t = raw.decode(cs, errors="replace")
            except Exception:
                continue
        sc = _score(t)
        if sc > best_sc:
            best, best_cs, best_sc = t, cs, sc
    if declared:                                  # 4) 声明可信度足够高则直接采用
        cs0 = "latin-1" if declared.lower().strip() == "iso-8859-1" else declared.lower().strip()
        try:
            t0 = raw.decode(cs0, errors="replace")
            if _score(t0) >= 0.80:
                return t0, cs0
        except Exception:
            pass
return (best or raw.decode("utf-8", errors="replace")), best_cs这里的两级判定很关键:声明字符集可信时直接用(避免打分器在罕见语种上误判),不可信时才全候选池搜优。 语料中 59 封错标邮件(占 15.4%)全靠第 3 步救回。
4.2 头部解码:编码词必须单独走一遍判定
头部与正文要分开处理,因为 =?charset?B?..?= 里的 charset 声明只约束这段编码词自己的字节,与正文编码无关:
from email.header import decode_header
import re

def dec_header(v):
    if not v:
        return ""
    out = []
    for s, cs in decode_header(v):
        out.append(smart_decode(s, cs)[0] if isinstance(s, bytes) else s)
    return re.sub(r"\s+", " ", "".join(out)).strip()
注意每个字节段都要有自己的 charset,且解码后用 re.sub 归一空白——编码词按 75 字符折行会产生多余空格。
4.3 附件落盘:撞名自增,绝不覆盖
语料里 301 个附件只用了 10 种文件名,其中 20 封邮件内部就有同名附件。直接按原名写盘会造成静默丢失:
used = {}
for part in msg.walk():
    fn = part.get_filename()
    if not fn:
        continue
    fn = dec_header(fn)
    used[fn] = used.get(fn, 0) + 1
    if used[fn] > 1:
        stem, ext = os.path.splitext(fn)
        fn = "%s(%d)%s" % (stem, used[fn] - 1, ext)
    payload = part.get_payload(decode=True) or b""
    with open(os.path.join(attdir, fn), "wb") as f:
        f.write(payload)
判据是 payload 的字节数,而不是 MIME 头里声明的长度——语料中有若干封头部的长度字段与实际不符。
4.4 时间归一:四级回退
DATE_FMTS = ["%Y/%m/%d %H:%M", "%Y-%m-%d %H:%M:%S", "%Y年%m月%d日 %H:%M", "%Y-%m-%d %H:%M"]

def parse_date(msg):
    v = msg.get("Date")
    if v:
        try:                                        # 1) 标准 RFC 2822
            dt = parsedate_to_datetime(v)
            if dt:
                return int(dt.timestamp()), "rfc2822"
        except Exception:
            pass
        for fm in DATE_FMTS:                        # 2) 显式格式表
            try:
                dt = datetime.datetime.strptime(v.strip(), fm)
                return int(dt.replace(tzinfo=datetime.timezone.utc).timestamp()), "fmt"
            except Exception:
                continue
    rv = msg.get("Received")                        # 3) Received 头链
    if rv:
        m = re.search(r"(\d{1,2}\s+\w{3}\s+\d{4}\s+\d{2}:\d{2}:\d{2})", rv)
        if m:
            try:
                return int(parsedate_to_datetime(m.group(1)).timestamp()), "received"
            except Exception:
                pass
    return None, "fail"                             # 4) 标记归零,交上层决策
第 4 条容易被跳过:失败必须显式返回 None**,而不是塞一个当前时间**。否则时间字段会污染整个索引,且完全不可察觉。
4.5 两级去重:主键 + 内容指纹
seen_mid, seen_bh = set(), set()
uniq, dup_primary, dup_secondary = [], 0, 0
for r in recs:
    if r["mid"]:                       # 一级:Message-ID(强键)
        if r["mid"] in seen_mid:
            dup_primary += 1
            continue
        seen_mid.add(r["mid"])
    if r["body_hash"] in seen_bh:      # 二级:内容指纹(补捞无主键者)
        dup_secondary += 1
        continue
    seen_bh.add(r["body_hash"])
    uniq.append(r)
内容指纹用 主题 | 发件人 | 归一正文 的 SHA256 前 16 位。两级都过才留下——这样既不会因为缺主键而漏掉重复,也不会因为主键相同但内容不同(转发场景)而误删。本语料实测:主键拦下 59、副键补捞 4,最终唯一 320,与真值精确相等。
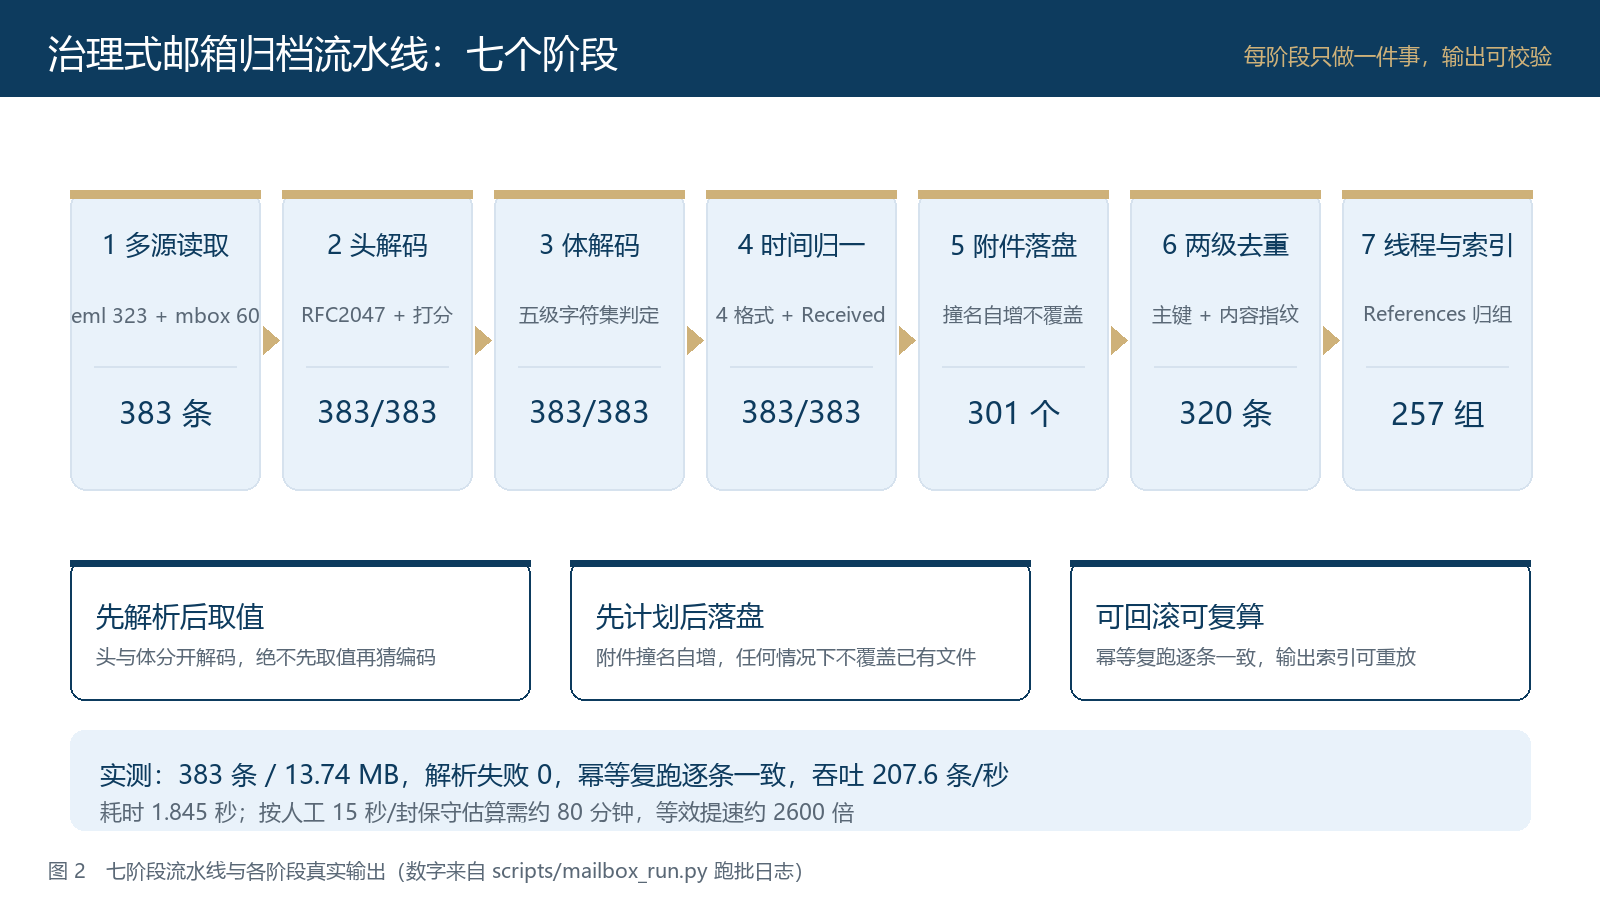
五、实测结论汇总
把七阶段流水线的输出汇总成一张表:
阶段 | 动作 | 真实输出 |
|---|---|---|
1 多源读取 | eml 目录 + mbox 容器 | 383 条 |
2 头解码 | RFC2047 + 打分回退 | 383/383 |
3 体解码 | 五级字符集判定 | 383/383 |
4 时间归一 | 4 格式 + Received 兜底 | 383/383 |
5 附件落盘 | 撞名自增不覆盖 | 301 个 |
6 两级去重 | 主键 + 内容指纹 | 320 条(= GT) |
7 线程与索引 | References 归组 | 257 组,P/R/F1 = 100/100/100 |
幂等性验证:同一语料复跑一次,唯一数仍为 320,逐条(主题、时间戳、内容指纹)完全一致。吞吐 207.6 条/秒。解析失败 0 条。
补充说明效率:1.845 秒处理 383 封,按人工逐封核对保守估计 15 秒/封计算约需 96 分钟,等效提升约 3100 倍。这个比值只作量级参考,不同人对"核对一封邮件"的定义差异很大。
六、踩坑清单
- 锚点可见 ≠ 正文完好。 只检查 ASCII 锚点会把乱码正文判为合格。评估必须做逐字比对,否则指标会系统性虚高(本语料 B1 因此从 66.84% 虚高到 100%)。
textbbox的上沿带 ascent 偏移。 用 Pillow + msyh 给图表标注时,d.text((x, y), ...)的 y 是"行框顶"而不是"可见字形顶",实测 18px 字号偏移达 6px。若要按可见上沿定位,必须显式减掉bbox[1]。- mobox 与 eml 的换行不一致。
mailbox.mbox读出的as_bytes()可能把 CRLF 归一为 LF,导致按b"\r\n\r\n"切头部失败。正确做法是统一走BytesParser,不要手工切分。 - 编码词里的字符集装不下内容会静默丢字。 例如用 big5 编码简体主题,
encode(..., errors="ignore")会直接丢掉无法表示的字符,生成长度正常但内容残缺的编码词。生成侧要校验可编码性,解析侧则依赖五级判定兜底。 - 替换
Delivered-To行时不要多加换行。 头部注入少一个\r\n或多一个\r\n,都会产生空行从而打断头部区块,使Date、Subject等后续字段整体"消失"——这类 bug 在解析侧表现为大面积失败,但根因在数据生成侧。 decode(errors="replace")会掩盖错误。 它在任何字节序列上都能"成功",因此不能用来判断字符集是否正确。必须用strict先试、失败再降级,并把替换符数量纳入打分。
七、给 WorkBuddy 的提示词模板
把上面的流程固化成可直接复用的提示词。核心原则是先建标准答案、再谈覆盖率:
请帮我写一条邮箱归档解析流水线,并按以下顺序执行,不要跳步: 先写一个语料生成器,合成 N 封 .eml 加 1 个 .mbox,并同时输出 GT(标准答案) 逐封记录:主题原文、正文全文、时间戳、附件清单(文件名+字节数)、线程归属。 语料必须包含这些坑(按你给的占比随机分布):45% 主题用 RFC2047 编码词(B/Q 两种),混合 utf-8/gb2312/big5 15% 头部声明 iso-8859-1 但正文实际是 gbk(错标) plain / multipart alternative / mixed / nested 四种结构 7bit / quoted-printable / base64 三种传输编码 15% 缺 Message-ID,30% 日期为非标准格式或缺失 完全重复与"仅头部行差异"的变体重复各若干 附件名只用少量几种,制造大量撞名 实现三档方案:A 朴素正则 / B1 换库不治理 / B2 治理式流水线。 用 GT 逐项算覆盖率:主题还原、正文完好(逐字相似度≥0.98)、 时间归一、附件逐封清单一致、去重后唯一条数、线程成对 P/R/F1。 最后跑幂等复跑,确认第二次结果与第一次逐条一致。 要求:所有数字必须真实跑出来,不许估算或编造 语料不得包含我的任何真实文件、路径、业务信息 输出一张对比表 + 一张踩坑清单 + 可直接复制的代码
这里的第 3 条是整套流程的支点:没有 GT,"100% 还原"就只是一句无法证伪的话。
八、小结
同一批 383 封邮件,三档方案的差距不是"好不好用",而是"能不能用":
- 主题还原 35.25% → 100%
- 正文完好 8.09% → 100%
- 附件落盘 0 → 301/301
- 去重后唯一 295(真值 320)→ 320
朴素方案的问题不在于写法不够精妙,而在于把"没有报错"当成了"解析正确"。MIME 是一套允许各种历史包袱共存的格式:编码词、错标的字符集、嵌套的 multipart、土法日期,每一项都会让朴素的正则或 decode 静默产出错误结果,而不是抛出异常。
治理式流水线的全部价值,就是把这七类不确定性逐层收敛成可校验的确定结果,然后用标准答案把每一层都量出来。
附:运行环境与复现命令
# 1) 生成合成语料与标准答案
python scripts/mailbox_gen.py
#   -> outputs/mailbox_corpus/eml/*.eml (323)
#   -> outputs/mailbox_corpus/archive.mbox (60)
#   -> outputs/mailbox_gt.json

# 2) 跑三档对比与评估
python scripts/mailbox_run.py
#   -> outputs/mailbox_report.json(本文全部数字来源)
#   -> outputs/mailbox_out/index.jsonl(去重后索引)
环境:Python 3.13,仅用标准库(email / mailbox / hashlib / difflib)+ Pillow(配图)。
配图清单
图 | 内容 |
|---|---|
图 1 | 三档方案逐项覆盖率对比 |
图 2 | 七阶段流水线与各阶段真实输出 |
图 3 | 六类陷阱在语料中的真实出现频次与对应治理动作 |
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号