从 PubMed 检索到本地 PDF 整理:医学文献资产化工作流实操指南
原创
从 PubMed 检索到本地 PDF 整理:医学文献资产化工作流实操指南
原创
用户7200114
发布于 2026-10-14 08:59:13
发布于 2026-10-14 08:59:13
从 PubMed 检索到本地 PDF 整理:医学文献资产化工作流实操指南
做临床科研、撰写 SCI 论文,几乎每一位医学研究生和青年医生都曾陷入过这样的文献泥潭:
浏览器里常年挂着几十个 PubMed 标签页,逐篇复制粘贴题名;好不容易下载下来的 PDF 散落在系统默认的“下载”文件夹里,全是 s41598-023-xxxx.pdf 这类无规则乱码;一周后开始写 Methods 部分,再想调取某篇关键论著的纳入排除与统计模型,只能硬着头皮重新检索……
这种散乱的文献检索与保存方式,不仅极其耗费精力,更直接切断了科研思考的连续性。真正高效的科研工作者,不会把精力耗在“手动下载、重命名、建文件夹”的低效重复中,而是把文献检索、全文批量获取、本地语义归档到方法学提取打造成一条高确定性的学术流水线。
一、全局视角:文献检索到本地资产化的三阶闭环
在动手执行单篇检索前,必须先在宏观上建立起“文献即学术资产”的工程化思维。标准的文献处理流由三个环环相扣的阶段组成:
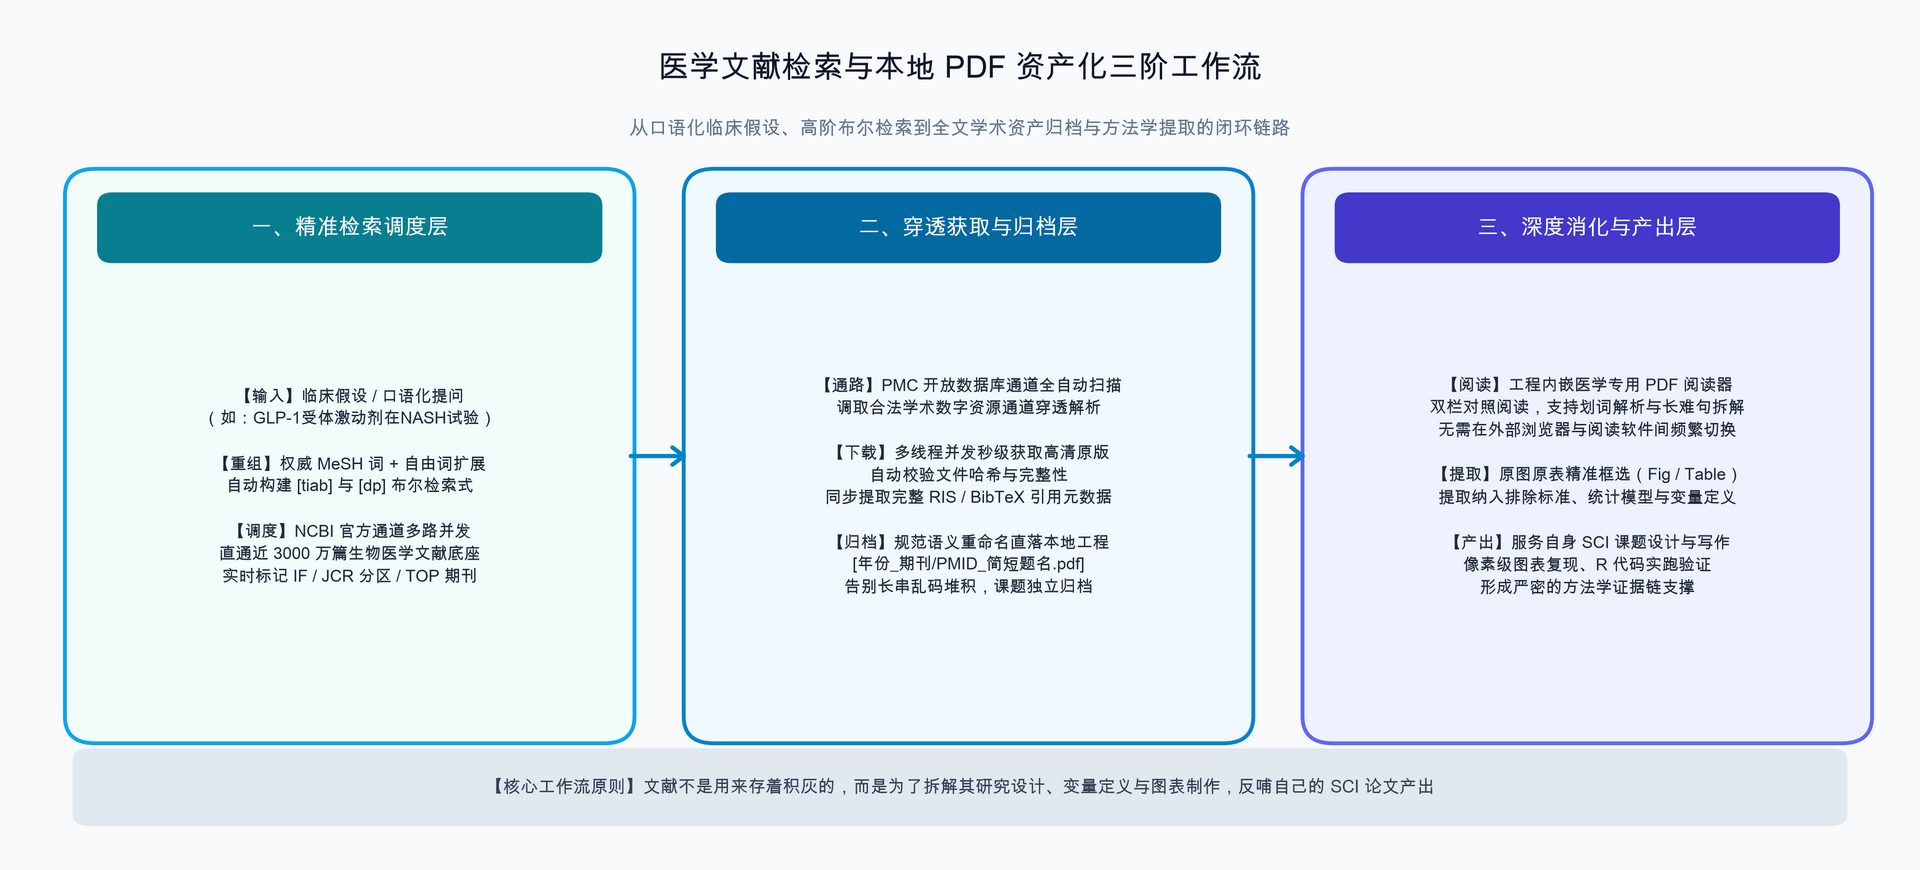
图 1:医学文献检索与本地 PDF 资产化三阶工作流全景图
从图 1 可以清晰看到,文献工作流包含三个进阶层级:
- 精准检索调度层:由临床假设驱动,通过权威 MeSH 与自由词扩展,生成标准化 PubMed 官方布尔式并实施并发检索;
- 穿透获取与归档层:自动对接 PMC 开放数据库与正规学术通道,批量校验下载并以语义化规则直落本地工作区;
- 深度消化与产出层:工作区内双栏对照阅读,框选提取关键图表与方法学参数,直接反哺自身 SCI 的设计与写作。
二、第一阶:从口语化假设到高阶 MeSH 布尔并发检索
很多初学者搜文献往往只敲两个宽泛的单词,结果不是检索出成千上万篇无关文献,就是漏掉了关键的高分论著。搭建工作流的第一步,是将研究问题转化为严密的高阶检索式。
请看 MedCortex 课程实操中的多检索式并发调度界面(如图 2):
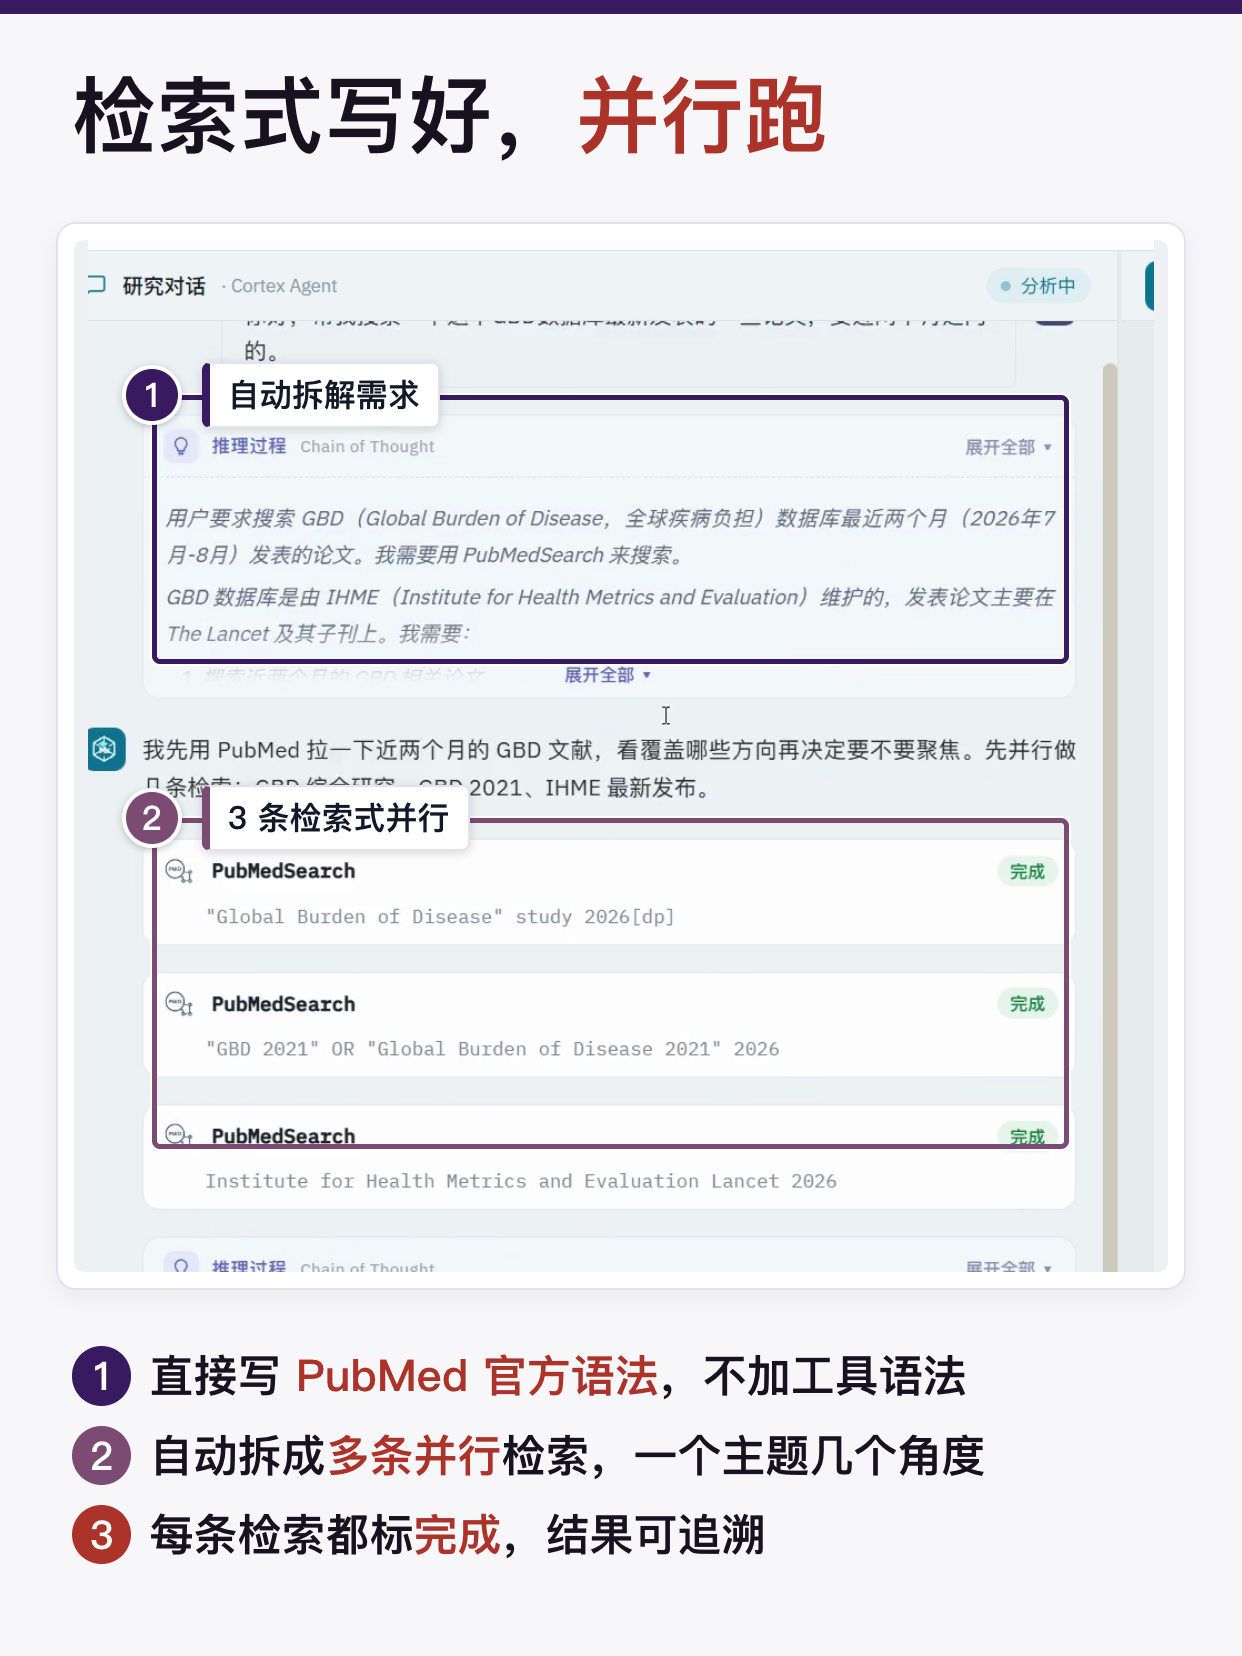
图 2:MedCortex 真实运行中的多检索式并行执行与学术标签标注界面(源自课程实操)
对照图 2,我们可以提炼出两项核心实操方法:
- 口语化临床假设规范转化为 MeSH 与字段限定:例如在探讨“GLP-1 受体激动剂在非酒精性脂肪肝中的临床试验”时,系统会自动重组权威主题词(MeSH)与自由词,并运用
[tiab](标题/摘要限定)与[dp](发表时间限定)构建严密逻辑。如图 2 中针对全球疾病负担的检索限定:"Global Burden of Disease" study 2026[dp],精准锚定时间窗口; - 多维度检索式并行调度与顶刊标签标注:单一检索式难免存在视角盲区。实战中可以同时从“主题全称”、“权威数据库版本”以及“顶级发刊机构”拆解出多条检索式并行执行。检索结果实时标注文献的影响因子(IF)、中科院 JCR 分区以及 TOP 期刊属性,让高价值文献一目了然。
三、第二阶:PMC 开放通路穿透与规范语义归档
检索出候选文献后,传统做法是逐篇打开期刊主页寻找下载入口,遇到付费拦截往往手足无措。高效的工作流应当实现合规通道解析与本地规范化沉淀。
请看系统完成下载与归档后的工作区真实视窗(如图 3):
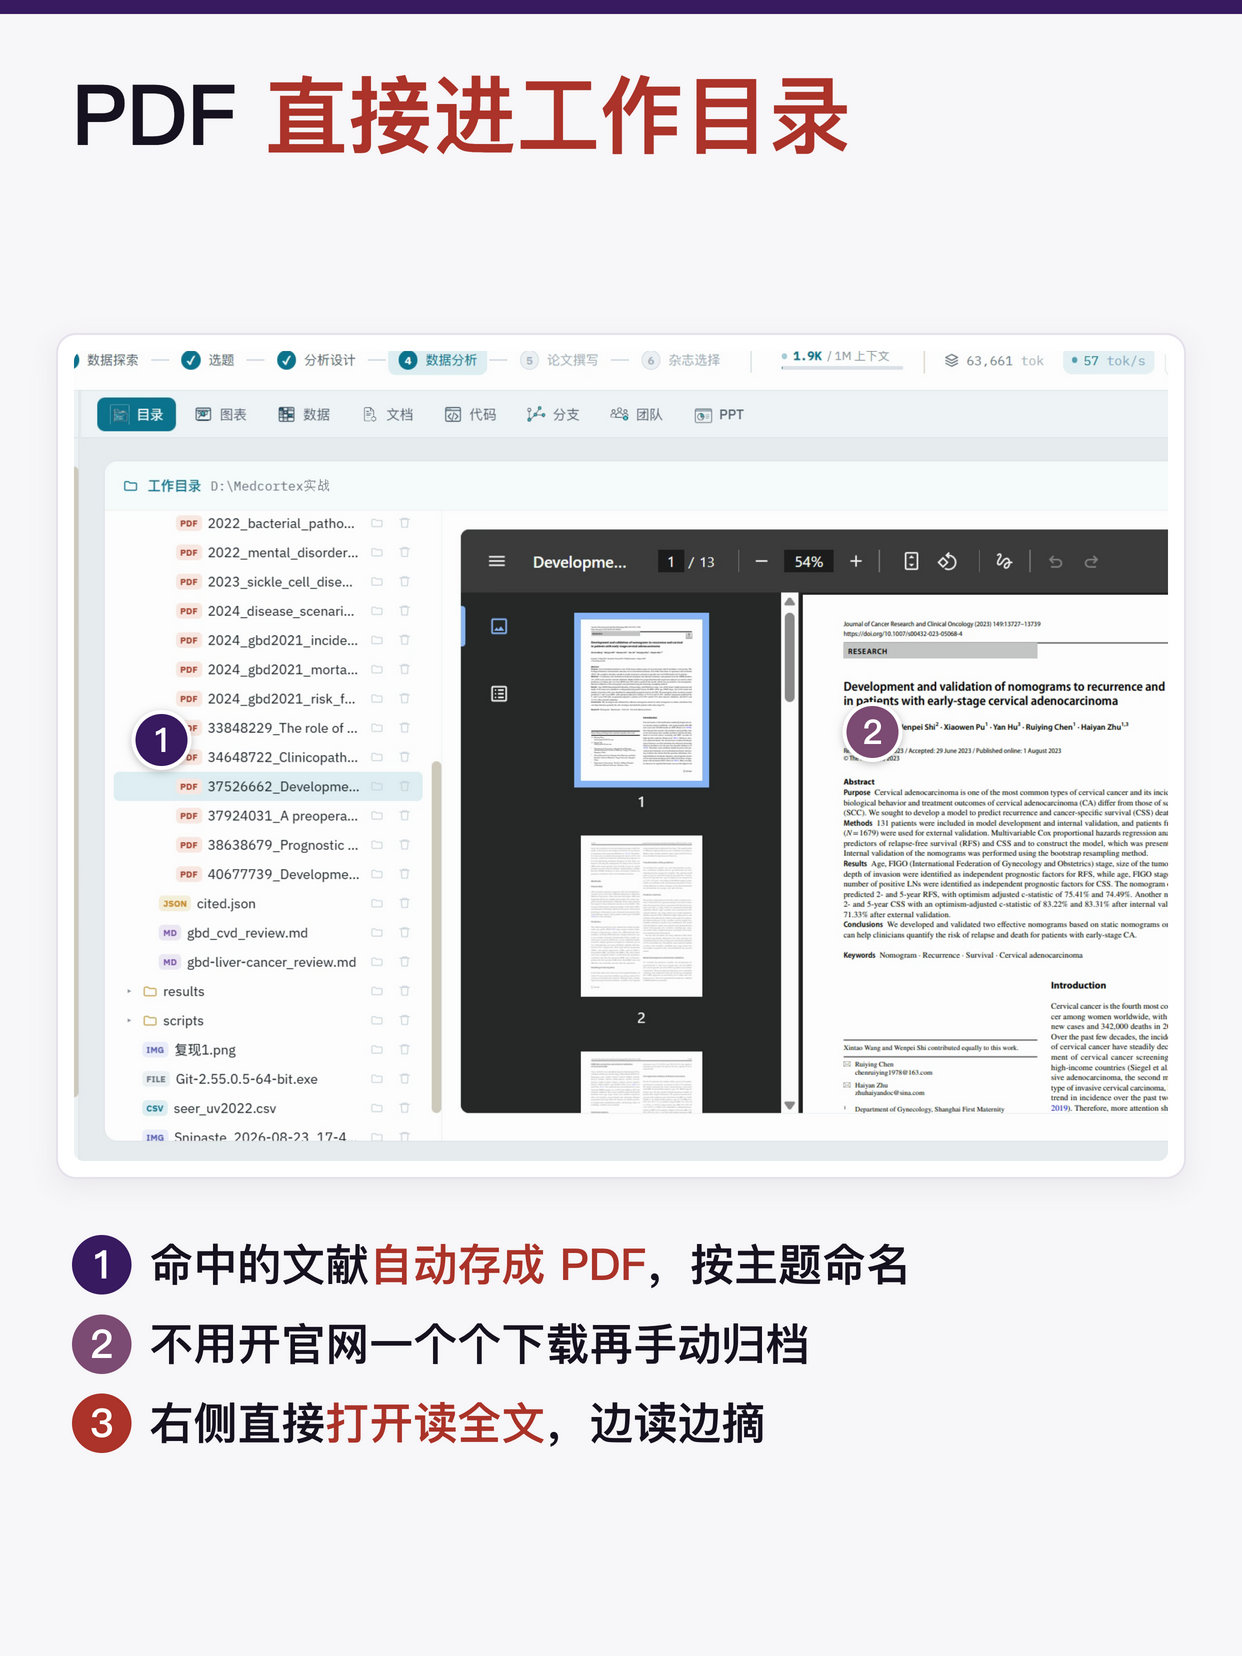
图 3:文献 PDF 规范重命名归档与工程双栏阅读视窗(源自课程实操)
观察图 3 左侧的文件目录与右侧的阅读界面,这套归档机制对后续论文产出有三大关键支撑:
- 规范语义重命名:下载文献自动以 年份_期刊/PMID_简短题名.pdf 格式统一重命名(如目录中的
2024_gbd2021_incidence...、37526662_Development...),彻底消除乱码文件名,便于按年份或唯一检索号秒级定位; - 课题独立工作区直落:文献直接存入当前科研工程目录,与数据清洗脚本、统计代码并列存放,便于整个研究课题的完整版本化备份;
- 工作区内双栏对照阅读:右侧内置医学专用 PDF 阅读器,左侧查验数据与代码,右侧对照原文精读 Methods 与结果图表,边读边提取关键参数,无需在多个外部软件间频繁切换。
四、第三阶:从“文献堆积”升华到“方法学提取与图表复现”
读文献的终极目的从来不是“读完打卡”,而是提取其中的研究设计、变量定义与图表逻辑,服务于自己的 SCI 论文产出。
请看从文献提取关键图表并在本地完成复现核对的实操过程(如图 4):
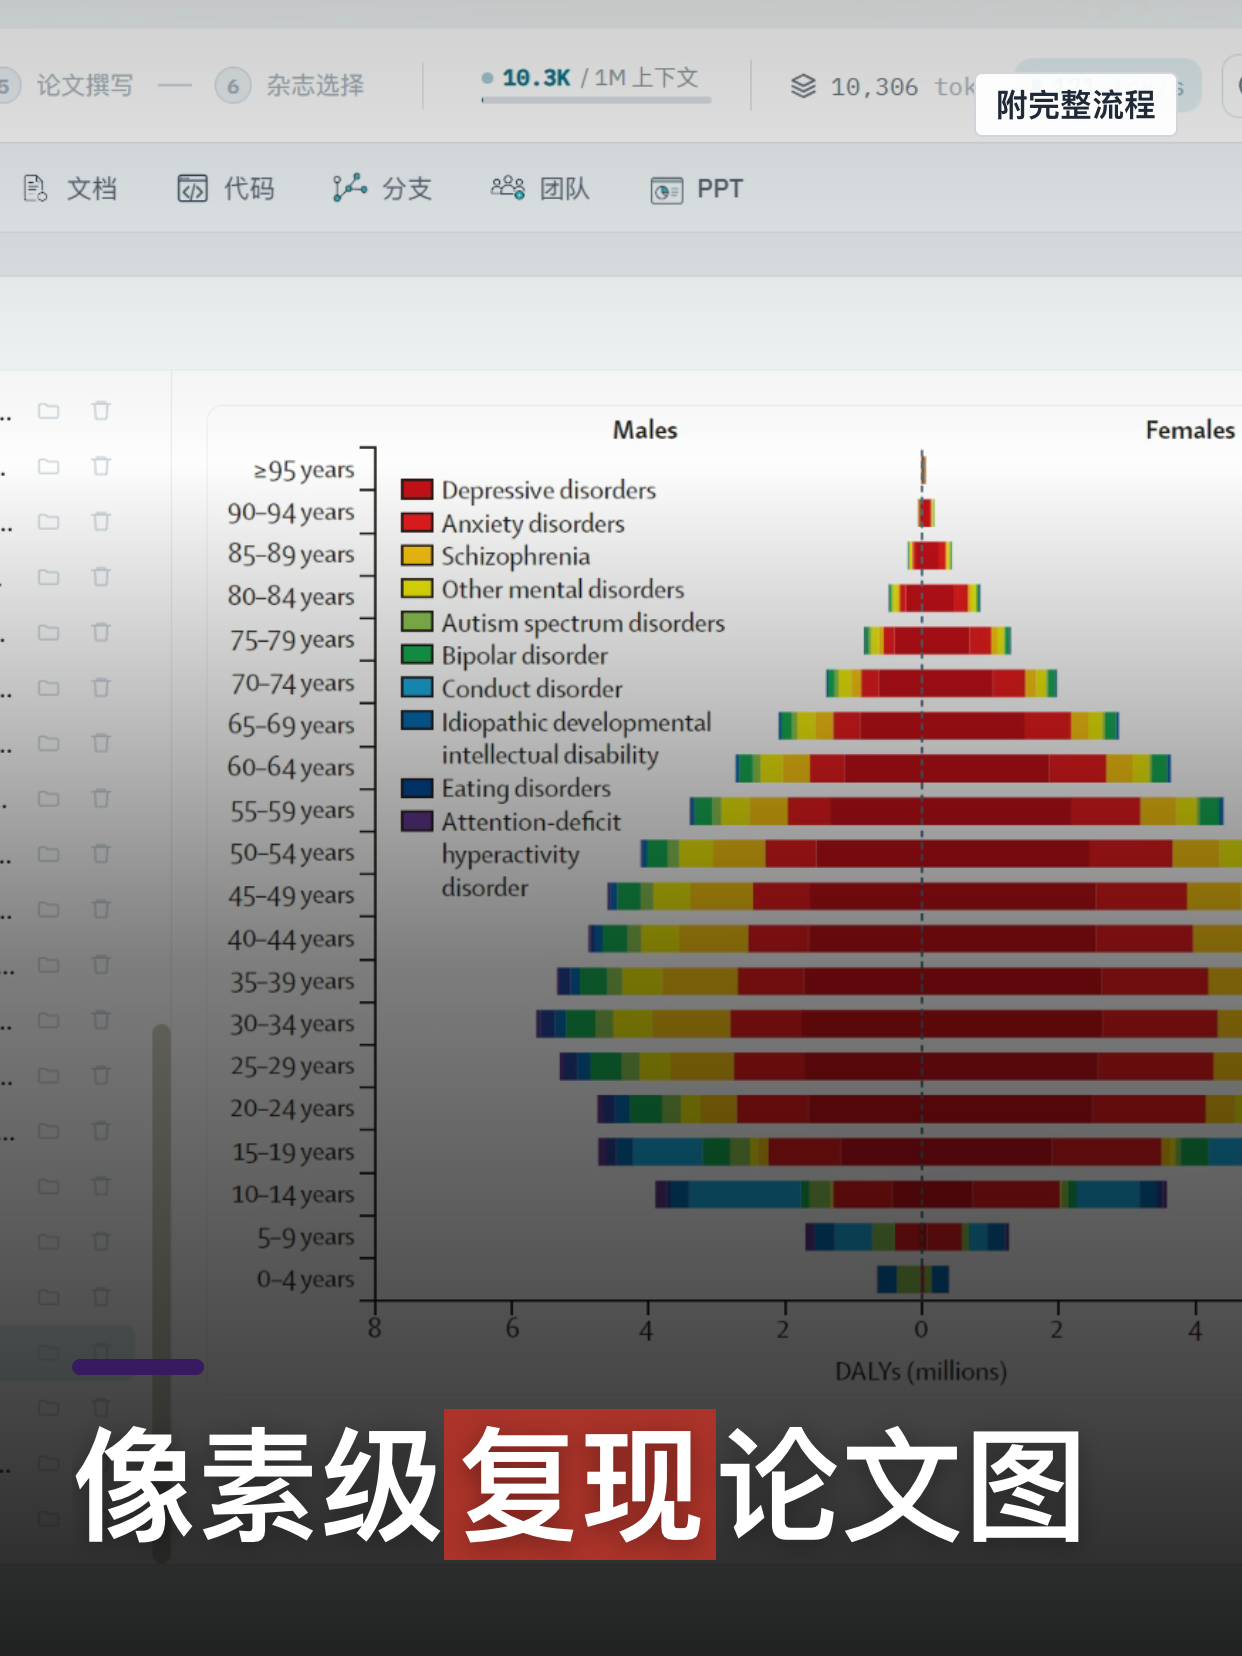
图 4:从原始文献提取图表并在本地运行 R 代码实现像素级复现对照(源自课程实操)
结合图 4,真正的学术资产转化包含两个关键动作:
- 原图原表精准框选(Fig/Table):在阅读器中定位目标页码,直接框选出文献的关键基线表(Table 1)、森林图或剂量反应曲线,记录下暴露、结局与协变量的测量定义;
- 本地代码实跑复现与差异核对:将论文的方法学逻辑转化为本地 R 运行代码,生成复现图表并与原图并列对比(如图 4 中的人口金字塔复现),系统自动核对并指出男女图例顺序等细微差异。这种严密复盘能让读者彻底吃透同类选题的分析流程。
五、医学科研文献工作流的 3 条落地准则
💡 带教总结:建立文献库的底层准则
- 查得准比查得多更重要:合理使用字段标签(如
[tiab]、[mesh]),宁可一开始用严密布尔语法精准收敛范围,也不要盲目导出数千篇无用引文。 - 以研究课题为单位隔离工作区:避免把所有方向的文献混在一个混乱文件夹中。一个课题独立建立一个工作目录,实现文献、清洗代码与统计结果同级受管。
- 把文献作为方法学案例而非阅读负担:阅读文献时重点提取其样本纳入排除标准、统计模型设置与图表表达逻辑,把文献真正转化为自己论文写作的证据底料。
🚀 搭建属于你的医学文献自动化工作流
告别手动复制粘贴与无序的文献堆放。掌握从官方检索式拆解、并行批量检索到本地目录结构化归档与图表复现的标准流程,把宝贵精力聚焦在临床问题挖掘、研究设计与论文写作本身。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号