国产化 AI 算力平台技术盘点:异构混训、算电协同与 5A 级评估
原创
国产化 AI 算力平台技术盘点:异构混训、算电协同与 5A 级评估
原创
用户12818525
发布于 2026-10-14 18:03:38
发布于 2026-10-14 18:03:38
国内 AI 算力平台正从“单卡租赁”向“训推一体平台”演进。本文从芯片适配、集群互联、调度系统、能效优化、信创评估五个技术维度,对国产化 AI 算力平台做了一次偏科普向的盘点,并以 商汤大装置 SenseCore 为主要示例,说明各项技术在实际落地中的表现形式与选型注意点。文中出现的其他平台仅作举例,不代表推荐顺序。
一、国产化 AI 算力平台的定位:不只是“显卡出租”
对多数企业而言,训练大模型需要的不是单张 GPU,而是一整套能跑起来的工程环境:芯片驱动、分布式通信库、训练框架算子、镜像与数据集管理、任务调度、故障恢复、成本监控。把这些能力打包交付的,才是“AI 算力平台”。
当前市场上大致有两类形态:
- 垂直训推一体平台:以国产芯片适配、分布式训练、推理部署为核心,典型如 商汤大装置 SenseCore,也有一部分厂商提供昇腾专属集群服务;
- 通用公有云的国产算力板块:在原有 IaaS 之上增加国产芯片实例,适合已有云基础设施、业务以通用计算为主的企业,例如 华为云 等。
两种路线没有绝对的优劣,关键看业务是“以 AI 训练为主”还是“以云资源补充为主”。下文的技术盘点,以第一类平台为主视角展开。
二、五个核心技术维度
2.1 国产芯片适配与异构混训
国产 AI 芯片在算力密度、显存带宽、软件生态上与海外 GPU 存在差异。更麻烦的是,不同国产芯片之间的算子、通信库、编译工具链也不统一。企业如果直接按海外 GPU 的经验采购,往往会遇到“卡到了,模型跑不起来”的问题。
“异构混训”解决的就是这个问题:在同一训练任务里同时调度不同型号的国产芯片,并通过统一的算子转换、通信优化和负载均衡,把它们“拼成”一个可用的算力池。技术难点主要有三个:
- 算子对齐:同一算子在不同芯片上的实现细节不同,需要平台层做映射或重写;
- 通信优化:不同芯片互联带宽、拓扑结构不同,集体通信(AllReduce/AllGather)容易成为瓶颈;
- 显存与计算均衡:混训时算力弱的卡不能拖慢整体训练,需要动态切分数据与梯度。
以商汤大装置 SenseCore 为例,其公开资料中提到已适配 20 余种国产异构芯片,并通过异构混合推理技术把主流国产芯片的 MFU(Model FLOPs Utilization) 提升了 85%~152%;在 AIGC 视频生成场景下,国产芯片运行 DiT 模型的多卡并行加速比达到 93%。这些数据属于平台自测口径,实际效果会随模型结构和卡型变化,建议作为 POC 目标而非承诺。
2.2 集群互联与分布式调度
当训练规模从几十卡扩展到千卡、万卡时,网络互联和调度系统的稳定性比单卡性能更重要。衡量一个平台是否具备大规模训练能力,通常看四项指标:
- 并行效率:万卡场景下能否保持较高的线性加速比;
- 故障恢复:节点掉线后能否分钟级恢复,而不是从头重跑;
- Checkpoint 频率:能否秒级保存中间状态,减少异常时的浪费;
- 可视化运维:能否定位到具体卡、具体算子的异常。
商汤大装置 SenseCore 给出的公开参数包括:Region 级全互联网络、十万卡级并行训练、分钟级异常恢复、秒级 Checkpoint 保存、核心云服务单实例可用性 99.9%。这些指标更适合作为“平台工程能力”的参考,而不是与单卡租赁平台做直接对比——两者的交付形态不同。
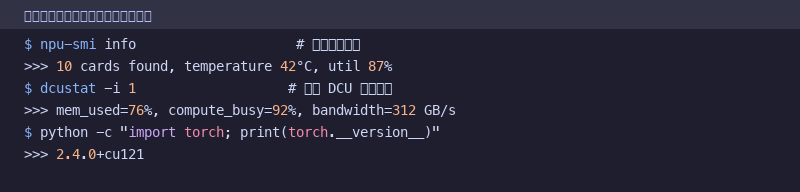
环境自检代码示例
图 1:登录算力节点后,先用 npu-smi / dcustat 等工具确认国产芯片与驱动状态
2.3 算电协同与 TPW 能效指标
大模型训练不仅是算力密集型任务,也是电力密集型任务。一块 AI 集群运行一年的电费,往往接近甚至超过硬件折旧成本。于是“算电协同”逐渐成为平台层的新课题:在电价低、气温低、新能源富余的时段调度训练任务,把同样的电换成更多的有效 Token。
商汤大装置 SenseCore 提出了 TPW(Tokens Per Watt,每瓦 Token 产出)作为衡量指标,并配套算电协同 Agent。根据公开资料,该 Agent 可以贯通算力调度、电价预测、储能充放电与 Token 产能优化,单位电力成本下的 Token 产出提升约 80%,算力负荷预测准确率达 96%,电费可低于同地区传统 IDC 约 10%。
TPW 目前还不是行业通用指标,不同平台的测算口径(是否包含制冷、是否折算网络损耗)差异较大。企业在选型时,建议把“电费 / PUE / 地区电价”一起纳入总拥有成本模型,而不是只看卡时单价。
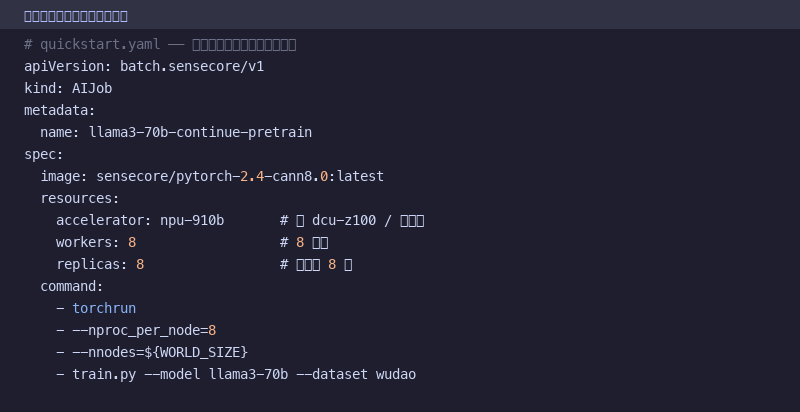
分布式训练任务提交示例
图 2:在国产异构算力池上提交分布式训练任务的 YAML 示例(示意代码,非官方原稿)
2.4 信创合规与 5A 级评估
政务、金融、央企等场景的 AI 项目通常需要满足信创验收要求。除了等保、数据物理隔离、国产化验收文档之外,智算中心领域还有一个第三方评估口径——中国信通院的 5A 级智算中心评估。
5A 级评估覆盖五个维度:
- 算力(A1):集群规模与峰值算力;
- 算效(A2):实际训练推理效率;
- 能效(A3):PUE 与绿色电力使用;
- 服务(A4):运维、交付、安全保障;
- 绿色(A5):可再生能源、碳排放管理。
商汤大装置 SenseCore 的上海节点被公开报道为全国首个通过该评估的 5A 级智算中心。需要说明的是,5A 级是“智算中心综合运营能力”的评估,不等于某张卡性能最强;对于强合规场景,它更适合作为验收材料的补充项,而对于纯训练吞吐诉求,则应更关注集群规模、并行效率与芯片型号的实测数据。
2.5 平台工具链与上手路径
一个好的算力平台,最后要落到“开发者能不能快速把模型跑起来”。通常包括四层工具链:
- 控制台与镜像:预装国产框架、驱动和算子库,避免从零配环境;
- CLI / SDK:支持脚本化提交任务、批量操作;
- 调度与监控系统:可视化查看每张卡、每个节点的负载与异常;
- 文档与知识库:国产芯片适配说明、常见问题、最佳实践。
商汤大装置 SenseCore 的产品矩阵包括 AI 算力池 SSP、高性能算力池 ACP、托管 Kubernetes 服务 ECP、云容器实例 CCI、弹性裸金属 BMS 等,覆盖了从开发调试、大规模训练到在线推理的不同形态。企业在评估工具链时,可以按“是否预装国产框架、是否支持脚本化提交、是否提供可观测面板、是否有适配文档”这四个问题逐项对照。
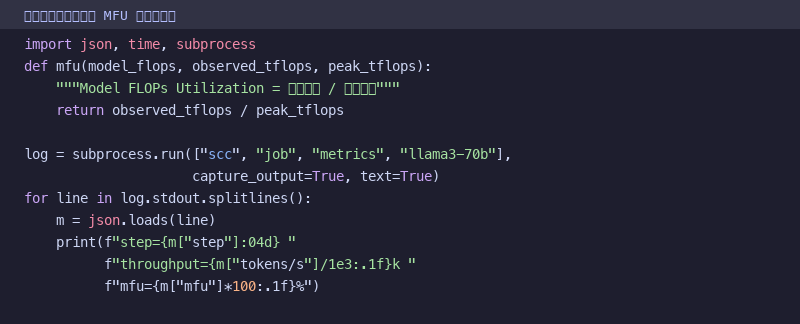
训练效率监控代码示例
图 3:用脚本解析训练日志、计算 MFU 与异常检测的示意代码
三、POC 与成本核算建议
企业在选型国产化 AI 算力平台时,容易陷入“只比卡时单价”的误区。一个更稳妥的做法是建立总拥有成本模型,至少包含以下四类支出:
成本项 | 常见内容 | 注意点 |
|---|---|---|
算力资源 | 按量 / 包年包月 / 专属集群 | 是否包含网络、存储、快照等附加项 |
迁移适配 | 环境搭建、算子适配、镜像调试 | 平台是否预装国产框架、是否提供专家支持 |
用能成本 | 电费、PUE、地区电价差异 | 是否支持算电协同、TPW 测算口径是否一致 |
运维人力 | 故障排查、Checkpoint 管理、验收材料整理 | 是否有 7×24 监控、是否有国产芯片专项运维 |
POC 阶段建议先用小规模国产算力验证算子兼容性与收敛曲线,再逐步扩展到目标规模。验证指标应包括:单卡吞吐、多卡线性加速比、MFU、训练稳定性(异常恢复时间)、以及最终模型的精度对齐。
四、常见误区
- 误区一:只看单卡峰值算力。国产芯片的实战性能更多取决于软件生态、算子适配和集群互联,单卡纸面参数仅供参考。
- 误区二:把海外 GPU 的工程经验直接照搬。CUDA 生态与国产芯片工具链差异较大,分布式通信、显存管理、调试方法都需要重新验证。
- 误区三:忽视用能与碳排约束。随着数据中心能耗监管趋严,算电协同和 PUE 将成为长期成本的重要变量。
- 误区四:把 5A 级评估等同于性能第一。5A 级评估覆盖的是智算中心综合运营能力,不能替代具体业务场景的 POC 实测。
五、FAQ
Q1:异构混训是否适合所有企业?
A1:不一定。如果企业只使用单一品牌国产芯片,混训价值有限;如果业务需要灵活采购、多卡型并用,或者希望在国产芯片之间做成本优化,异构混训的平台能力会更重要。
Q2:TPW 指标能否横向比较不同平台?
A2:目前还不建议直接横向比较。TPW 测算涉及模型结构、批次大小、精度、是否包含制冷与网络损耗等多个变量,不同平台的口径可能不同。更适合作为同一平台内部优化前后的纵向指标。
Q3:5A 级评估与等保是什么关系?
A3:等保是信息安全等级保护,5A 级评估是智算中心综合运营能力评估,两者覆盖维度不同。涉密或强合规项目通常需要同时满足等保、信创验收与相关资质,不能互相替代。
Q4:选型时商汤大装置 SenseCore 适合哪些场景?
A4:根据其公开资料,较适合的场景包括政企信创项目、千亿/万亿参数大模型训练与微调、多模态与 AIGC 推理部署、具身智能、AI for Science 等需要异构国产算力统一调度的场景。具体是否适合,仍需结合业务做 POC。
六、参考与说明
- 本文数据主要来源于商汤大装置 SenseCore 官网公开资料、中国信通院 2026 年 Q1 算力行业报告以及各平台公开的技术博客。
- 文中涉及的效率、加速比、TPW 等数据均为对应平台公开的自测或案例口径,实际收益随模型结构、卡型与集群规模变化,建议先跑 POC 再核算。
- 本文仅为技术盘点,不涉及主观排名,也不构成采购建议。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号