反射内存网多节点时间同步机制深度解析
原创

一、引言:为什么仿真系统需要硬件级时间同步
在半实物仿真(HILS)、分布式飞行控制、武器系统联试和综合航电仿真等场景中,多个仿真节点必须在同一个时间基准下推进各自的数学模型。如果各节点模型步长不一致,或数据更新时刻存在未补偿的相位差,就会产生“数据时空错位”——控制器读到的传感器数据来自过去,执行机构的响应被解算到错误的积分点上,最终导致仿真结果失真甚至发散。传统以太网采用“尽力而为”的分组交换机制,排队时延随负载波动,无法提供确定性的时刻对齐能力。反射内存网(Reflective Memory,RFM)正是为解决这一问题而设计的硬实时网络,其代表性产品是GE(原VMIC)的VMIVME/PCI-5565系列。
本文不做科普式介绍,而是从工程实现角度,剖析RFM如何通过时分复用环网把同一个物理时钟分发到最多256个节点,漂移如何在环路上累积又如何被补偿,它与IEEE 1588 PTP在机制上有何本质差异,并给出一套可落地的多节点时间对齐误差预算方法与同步精度测试手段。文中参数以GE/VMIC 5565系列公开手册为准:串行链路速率2.125 Gbaud,单节点间传播时延典型值450~500 ns,动态包长4~64字节,持续数据率43 MB/s(单字访问)至约174 MB/s(64字节突发),板载SDRAM为128/256 MB,多模光纤组网距离约300 m(部分早期资料在50/125 μm纤芯条件下可达约500 m),单模光纤可达10 km。
二、TDM时分复用机制:环网如何做到确定性
RFM物理上是一个单向光纤环形网:节点1的光口出接节点2的光口入,依次串联,最后一个节点回接节点1,形成闭合环路。每个节点板卡上有一块与全网地址空间映射一致的本地SDRAM镜像。当某个节点的主机向映射在反射内存地址空间的某单元写入一个32位数据时,板卡逻辑并不等待上层协议,而是立即把这次写入打包成一个4~64字节的定长/变长数据帧,从出光口注入环路;其余每个节点的接收逻辑在帧经过自己时,比对帧中的目的地址范围,命中就把数据写入本地镜像SDRAM,然后原样(或重新驱动)把帧继续转发到下一跳。
关键在于:环路上不存在以太网那种CSMA/CD冲突检测和交换机存储转发排队。所有节点共享同一根串行比特流,时间被切成固定的时隙,每个写入事件占用一个确定长度的时隙沿环绕行。这就是时分复用(TDM)——任一时刻环路上的帧序列是可预测、可计算的,多节点并发写入按帧到达顺序串行化,其最坏情况时延等于“跳数×每跳固定时延+整环绕行时间”,而不是统计平均意义上的期望值。这种确定性是RFM区别于以太网的根本:它不是“快”,而是“可预测地快”。
从带宽分配看,2.125 Gbaud的串行速率扣除8b/10b编码开销后,有效吞吐对应公开资料给出的43~174 MB/s区间。动态包长机制允许单个32位写只用4字节最短帧,从而把小数据广播的时延压到最低;大批量数据搬运时再用64字节突发帧提高带宽利用率。设计者在做仿真模型映射时,应把高频、小数据量的状态量(姿态角、角速度、舵偏)映射为短帧,把低频、大块的参数表映射为突发帧,以优化整环时延。
图1给出了典型RFM环网的拓扑与全局时钟分发关系。
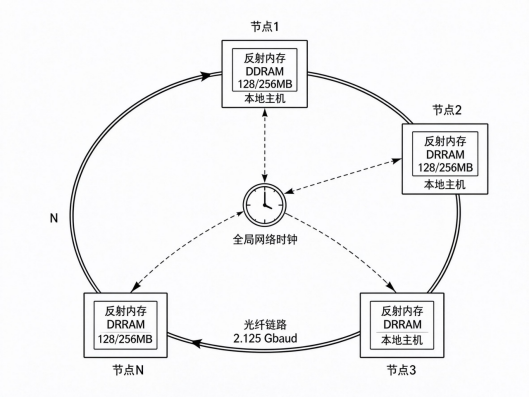
图1 反射内存环网拓扑与全局时钟分发架构(以VMIC-5565系列为例)
三、全局时钟的物理分发与节点时钟重建
RFM的“时间同步”与PTP那种“用报文计算并修正本地时钟偏差”的软件思路完全不同。在RFM环里,全局时钟不是逻辑概念,而是物理上被分发的串行比特边沿。每个节点的光接收端都集成了时钟数据恢复(CDR)电路:从2.125 Gbaud的串行码流中提取出嵌入的比特时钟,并以它为参考相位, disciplined(驯服)本地PLL/振荡器,重建出与环路比特流同步的本地时序。也就是说,环上每个节点看到的都是同一个“网络时钟”的再生版本,节点之间不需要主从选举,不需要BMCA最佳主时钟算法,时钟基准随光纤物理分发到每一跳。
这一机制带来两个直接工程结论。第一,节点间的相位差在稳态下只来源于CDR的鉴相噪声、PLL环路带宽内的抖动以及光纤传播时延的几何差,而不是报文往返测量误差。第二,节点本地SDRAM的“写入生效时刻”是由恢复出来的网络时钟沿采样决定的,因此全网上对同一地址的镜像更新在物理时刻上是对齐的——这正是反射内存作为“共享内存”语义成立的物理基础。
但要注意,RFM分发的是“比特时钟/帧同步”,并不直接等于主机CPU可用的“墙上时间”。板卡还通过中断(Interrupt)机制把网络帧事件转化为主机侧信号:当配置的地址范围被写入时,板卡可向主机拉起一路硬中断或DMA通知,主机在中断服务程序(ISR)里读取本地高精度定时器(如VxWorks的Timex、RTX的QPC、x86的TSC),把“网络事件”打上主机时间戳。时间同步的最后一段精度,就落在这段“网络中断→主机时间戳”的链路里。
图2描述了一个本地写入事件在环上逐跳传播、各节点镜像依次更新的时序关系。
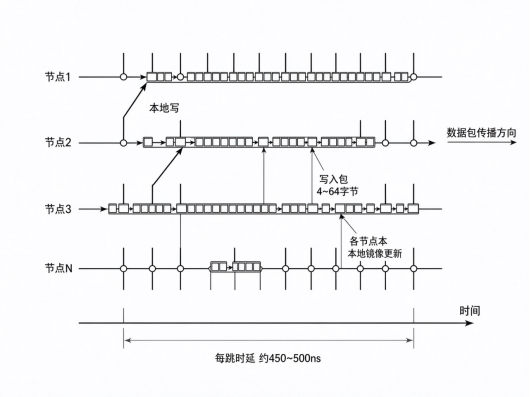
图2 TDM环网写入事件的逐跳传播时序与各节点镜像更新时刻
四、时钟漂移的累积、边界与工程补偿
既然每个节点都从码流恢复时钟,为什么还会有漂移问题?根源在于:CDR恢复的是“比特沿”,而主机模型积分用的是本地自由运行的时基。在两次网络帧事件之间,节点时钟是由本地振荡器(通常是TCXO甚至普通XO)自由走时的;两次事件间隔越长,节点间因振荡器频率偏差累积出的时间差就越大。典型TCXO稳定度约±0.5 ppm,普通XO可能达±20~50 ppm。以0.5 ppm计,两次同步点间隔1 s,累积偏差约0.5 μs;间隔10 s,累积约5 μs。
第二个漂移来源是环上传播时延的累积。光在光纤中的群速度约2×10⁸ m/s,单程时延约5 ns/m(即5 μs/km)。单模10 km链路段的单程时延可达约50 μs;但这部分是确定性时延,对环网中“同一帧依次到达各节点”的时刻差是固定的,可通过离线标定(测量各跳光纤长度差)在时间戳里扣除,而不是随机误差。真正影响对齐精度的是第三项:每跳转发引入的固定约450~500 ns,一个节点写入的帧绕环到达第N跳节点的最坏时间约为(N−1)×每跳时延;公开资料给出30节点整环同步规模约30 μs量级,与此估算吻合。
工程上补偿漂移有三条成熟路径。其一,提高网络事件的“刷新频率”,即让节点之间周期性互发心跳帧(哪怕只写一个标志字),把两次同步点的间隔压到毫秒级,从而把自由振荡累积压到百纳秒以内。其二,在板卡驱动层维护一个“网络时钟计数器”,随每帧到来递增,主机读取该计数器作为统一时基,而不是各自读TSC——这等价于用RFM帧沿对本地时基做周期性相位校正。其三,对温度敏感的实验室环境,在温度循环试验中记录振荡器温度漂移曲线,在标定表里做温度补偿。
需要强调:RFM并不提供“绝对时间”对齐到UTC的能力。它给的是环内自洽的相对时基。若仿真系统还要与外部GPS/IRIG-B时间源对齐,则需在一个主节点上接入GPS-B码授时卡,再通过RFM把绝对时间基准广播给全环。
五、与IEEE 1588 PTP的机制性对比
工程选型时常把RFM与IEEE 1588精密时间协议(PTP)放在一起比较。二者目标都是时钟同步,但实现哲学相反:PTP假设一个非确定性的分组网络,用Delay_Req/Delay_Resp报文往返测量路径时延,再由从钟用软件频率补偿把本地钟对齐到主钟;RFM则干脆用一个确定性的物理环网把时钟边沿直接分发出去,把“网络”本身变成时钟的一部分。
精度上,硬件辅助(PHY层打时间戳)的PTP在受控网络下可达到亚100 ns量级,纯软件PTP通常为数十至上百微秒;RFM环内节点间在短心跳刷新条件下可稳定在亚微秒到数微秒的事件对齐精度。但PTP的优势在于复用现有以太网布线、可大规模组网、天然支持绝对时间;RFM的优势在于端到端时延确定、不依赖主机协议栈、不随负载抖动,适合硬实时闭环。换句话说,PTP是“在不可靠信道上用算法逼近时间”,RFM是“在可靠信道上直接分发时间”。图3给出了二者的机制对比。
一个常见误区是认为“有了PTP就不需要RFM”。实际上在高闭环速率(如1 kHz以上)的HILS中,PTP只能对齐时钟,不能保证数据传输的确定性——报文仍会排队,主从切换瞬间会有时间跳变。正确的工程组合是:用RFM承担模型状态的硬实时交互,用PTP或IRIG-B承担环与外部世界的绝对时间锚定。
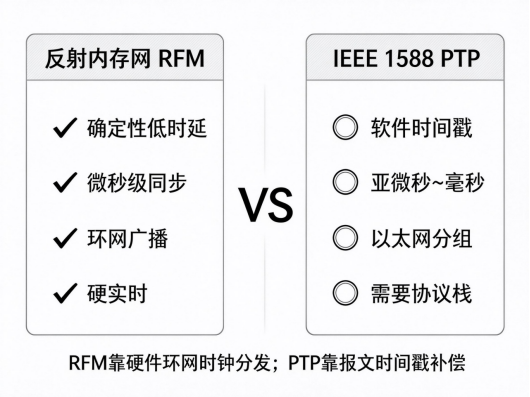
图3 反射内存网与IEEE 1588 PTP的同步机制对比
表1 VMIC-5565系列与典型PTP方案的关键参数对比
对比维度 | 反射内存网 VMIC-5565 | IEEE 1588 PTP(硬件时间戳) |
|---|---|---|
链路速率/介质 | 2.125 Gbaud 光纤环 | 以太网 100M/1G/10G |
最大节点数 | 256 | 组网规模大,受BC/TC级联限制 |
节点间时延 | 约450~500 ns/跳,确定性 | 往返报文测量,排队随负载波动 |
同步精度 | 亚μs~数μs(心跳刷新下) | 亚100 ns(受控网络) |
时钟基准 | 物理码流CDR分发,无主从选举 | Best Master Clock主从算法 |
绝对时间对齐 | 需外部GPS/IRIG-B主节点 | 天然支持,可溯源UTC |
负载敏感性 | 不敏感,时隙固定 | 敏感,需边界/透明时钟 |
六、多节点仿真的时间对齐误差预算
做分布式仿真设计时,必须把时间对齐误差拆成可加的分量,逐项分配指标,而不是笼统要求“微秒级”。以一个30节点、单模光纤组网、1 kHz模型步长的HILS系统为例,可建立如下误差预算模型:固定传播时延项(光纤长度差)约0~5 μs,经标定后残余误差可压到0.1 μs以内;每跳转发固定时延约450~500 ns,最大环上距离约30跳对应约15 μs,这是数据更新到远端节点的固有相位差,须在模型积分中按节点位置做相位补偿;振荡器自由漂移项在1 ms心跳刷新间隔、0.5 ppm稳定度下约0.5 ns,可忽略;主机中断响应与时间戳读取项,在VxWorks/RTX硬实时系统下约1~5 μs,在未打实时补丁的通用OS下可达数十至上百微秒——这往往是预算中最大、也最容易被忽视的一项;CDR与PLL相位抖动项约数十纳秒。
把这些分量按均方根合成(随机项)与线性叠加(固定项)区分:固定相位差项(传播、每跳)必须标定补偿,不作为随机误差;随机误差(漂移、抖动、中断抖动)按RSS合成。典型设计目标是:补偿后节点间有效时间对齐误差≤5 μs,以满足1 kHz闭环(步长1 ms)下不超过0.5%步长的相位失真要求。表2给出了一个可直接套用的误差预算表。
需要警惕的是:误差预算必须与操作系统选型联动。很多项目RFM硬件本身精度很高,但跑在通用Linux/Windows上,中断线程被调度延迟调度,实测对齐误差从微秒级劣化到毫秒级。因此时间对齐预算的最后一行,永远应是“主机实时性余量”。
表2 30节点HILS系统时间对齐误差预算(示例)
误差分量 | 典型量级 | 性质 | 处理方式 |
|---|---|---|---|
光纤传播时延差 | 0~5 μs | 确定性 | 标定光纤长度并扣除 |
每跳转发时延×跳数 | 约15 μs(30跳) | 确定性 | 按节点位置做相位补偿 |
振荡器自由漂移 | 约0.5 ns@1ms心跳 | 随机 | 提高心跳刷新频率 |
CDR/PLL相位抖动 | 约数十ns | 随机 | 选低抖动时钟方案 |
主机中断+时间戳 | 1~100 μs | 随机/半随机 | 硬实时OS,绑核,高优先级 |
合成(补偿后目标) | ≤5 μs | — | 满足1 kHz闭环相位要求 |
七、工程实践中的同步精度测试方法
同步精度不能只靠 datasheet 数字,必须实测。推荐一套被广泛采用的硬测法:由主节点周期性(如每1 ms)向反射内存写入一个递增计数器,所有从节点板卡配置该地址范围写触发一路数字输出(DIO)。用一台带宽≥500 MHz、采样率≥1 GS/s的示波器,同时采集各节点DIO触发线的边沿,直接测量不同节点输出同一帧事件的时刻差。这种方法把“网络对齐”转化为可观察的电信号边沿,绕过主机OS抖动的干扰,测的是硬件环网真实同步精度。
第二套方法是主机侧统计法:各节点在RFM中断ISR里读取本地高精度定时器时间戳,主节点把全网时间戳通过RFM回传汇总,离线统计最小、均值、最大偏差及P99值。该方法包含了主机实时性误差,反映的是“端到端有效对齐精度”,用于验证操作系统与驱动配置是否达标。测试应覆盖三个工况:常温稳态连续运行不少于8小时(观察慢漂移与最小值收敛);温度循环(验证温漂补偿是否生效);高负载注入(在环上叠加满带宽数据流,验证时延是否随负载漂移——RFM应几乎不变,若显著变化说明拓扑或驱动配置有误)。
最后给出几条调试经验:先单环两点测每跳时延,校准到450~500 ns区间再扩节点;逐步增加节点数,观察整环绕行时间是否随节点数线性增长;用环回(loopback)自检命令确认CDR锁定、CRC/ECC无报错;确认所有节点光纤收发光功率在接收机容限内,避免长链路段信号劣化导致误码重传——RFM环网本身不重传,误码即数据错误,光链路预算必须留足裕量。
八、结语
反射内存网的时间同步,本质是把一个确定性的时分复用光纤环变成全局时钟的物理分发介质:2.125 Gbaud码流经CDR在每个节点重建,节点间无主从、无报文往返测量,靠时隙确定性保证微秒级事件对齐。它的短板在于不提供绝对时间、环上传播时延需标定补偿、且主机侧实时性常常成为精度瓶颈。理解TDM时隙结构、CDR时钟重建、漂移累积与误差预算,并用示波器DIO边沿法做实测,是把RFM用好在军工与航天半实物仿真中的关键。工程实践中,RFM负责硬实时数据与环内时基,PTP/IRIG-B负责外部绝对时间锚定,二者互补而非替代,才是经得起联试考验的方案。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号