用 WorkBuddy 跑通「文物也疯狂」分镜工作流:从一句创意到一集完整分镜脚本
原创
用 WorkBuddy 跑通「文物也疯狂」分镜工作流:从一句创意到一集完整分镜脚本
原创
用户12822844
修改于 2026-10-16 14:56:56
修改于 2026-10-16 14:56:56
一句话版本:我把「文物也疯狂」系列的分镜生产,从"灵感 → 手写脚本 → 逐条手搓 prompt"的人力流水线,搬进了 WorkBuddy 的对话里,用 scene-based prompt 工作流把每一集拆成可编号、可复用、可迭代的场景单元。
我是谁,为什么需要这套工作流
我是做文物主题短视频的内容创作者,主力系列叫「文物也疯狂」——把陶俑、青铜器这类文物,和八一建军节、99 周年这类军事纪念题材,做成有叙事感的短内容。
这个题材的生产链路特别长:一集内容要从一句创意开始,经历分镜拆解、每个镜头的 AI 视频生成 prompt、角色形象一致性维护、旁白文案,最后才轮到成片。以前我最怕三件事:
- 分镜靠手写:一集十几个镜头写在文档里,改一处要全文找;
- prompt 靠手搓:每个场景一段描述,写到第三个就忘了第一个的用词风格,生成结果七零八落;
- 角色全靠脑记:同一对 IP 角色,这一帧裙子是绿的,下一帧衣服变了色。
工作流全貌:scene-based prompt
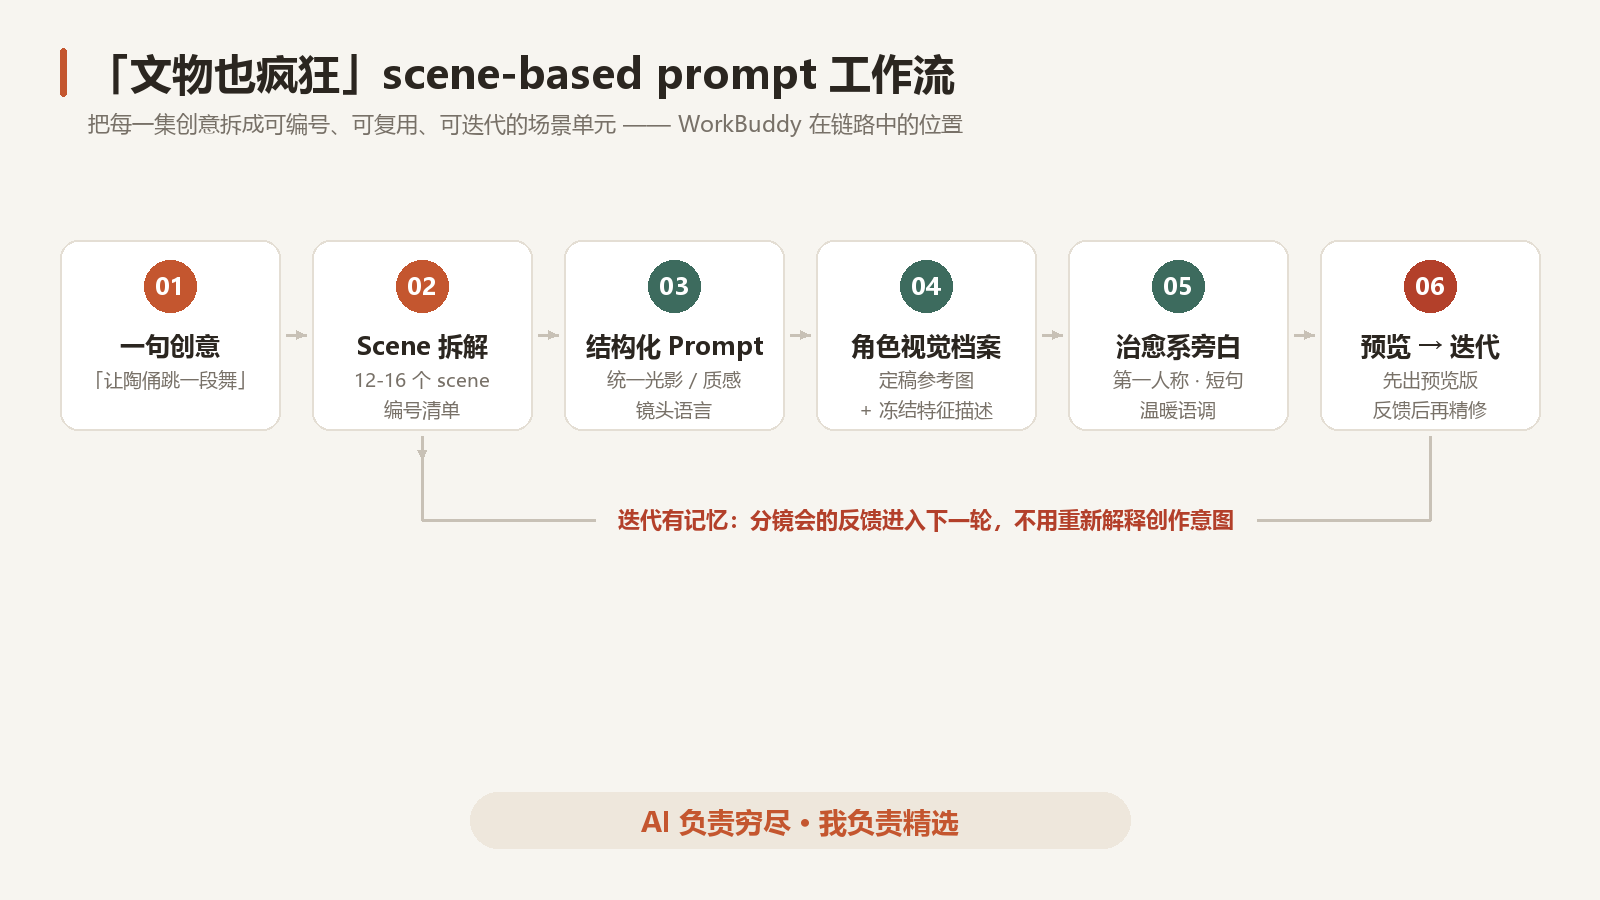
后来我把自己逼出来的方法沉淀成一句话:每一个镜头都是一个 scene,每一个 scene 都有编号和结构化 prompt。
一集"文物也疯狂"的分镜表长这样:
Scene | 内容 | 画面核心 | Prompt 要点 |
|---|---|---|---|
@scene#24 | 开篇引入 | 博物馆走廊空镜 | 缓慢推镜、冷色调、无人 |
@scene#25 | 文物亮相 | 陶俑特写 | 暖光、微尘、质感强调 |
@scene#26 | 拟人化演绎 | 陶俑"活"了 | 保持陶俑本体特征,动作拟人 |
@scene#27 | 转场收束 | 青铜器全景 | 拉镜、暗转、预留字幕位 |
这套编号体系就是整套工作流的地基。而 WorkBuddy 在其中的角色,是分镜师 + prompt 工程师 + 角色档案管理员 + 旁白文案四合一。
实操:一集分镜是怎么跑出来的
Step 1:把创意拆成 scene 清单
我把一集的创意(比如"让陶俑跳一段舞")直接丢给 WorkBuddy,让它按叙事节奏拆成 12-16 个 scene,每个 scene 输出四样东西:编号、画面内容、镜头运动、情绪关键词。拆完先不生成,人工过一遍取舍——AI 负责穷尽,我负责精选。
Step 2:批量生成场景 prompt
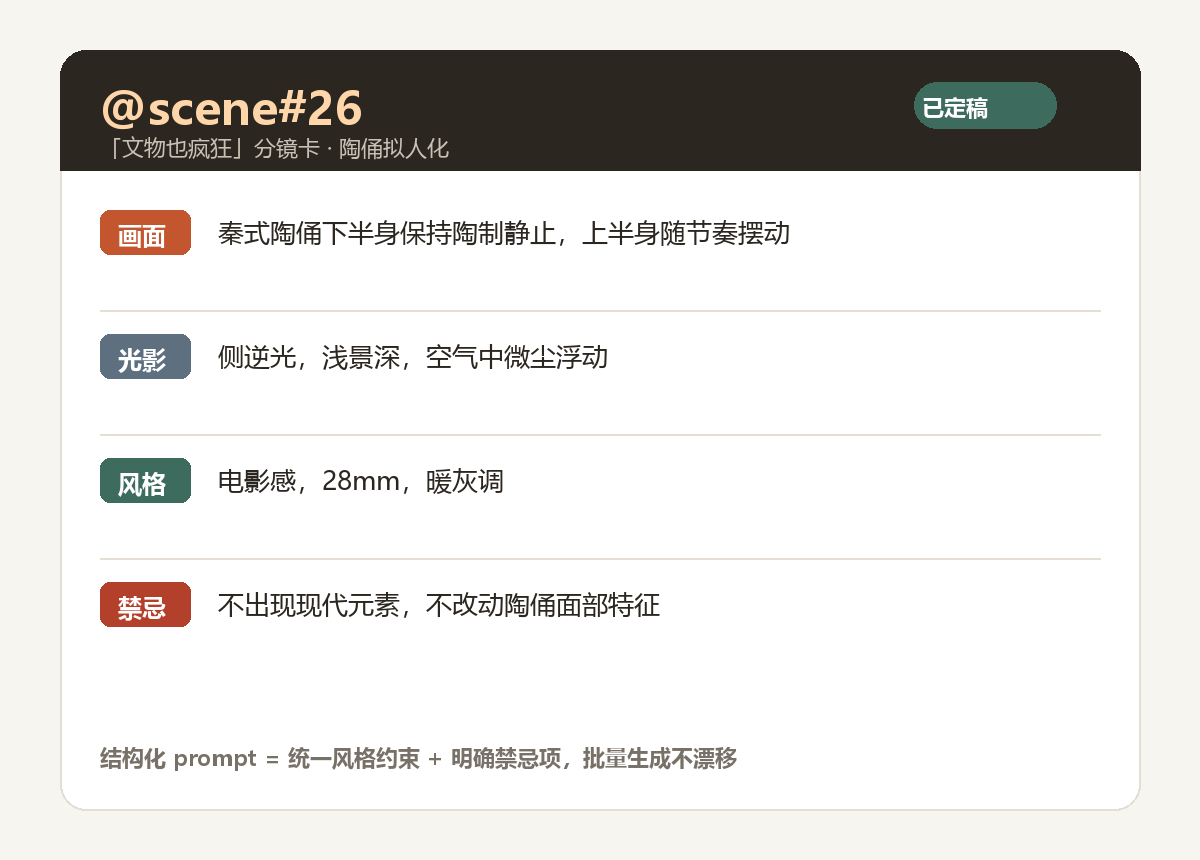
scene 清单定稿后,让 WorkBuddy 按清单逐条生成视频生成 prompt。关键是给死风格约束:统一的光影描述、统一的质感词、统一的镜头语言。我的 prompt 模板大概是:
@scene#26 陶俑拟人化
画面:秦式陶俑下半身保持陶制静止,上半身随节奏摆动
光影:侧逆光,浅景深,空气中微尘
风格:电影感,28mm,暖灰调
禁忌:不出现现代元素,不改动陶俑面部特征
"禁忌"那一行是踩坑踩出来的——AI 视频生成最爱给文物"加戏",不写禁忌,它敢给你整个墨镜戴上。
Step 3:角色一致性交给"参考图 + 档案"
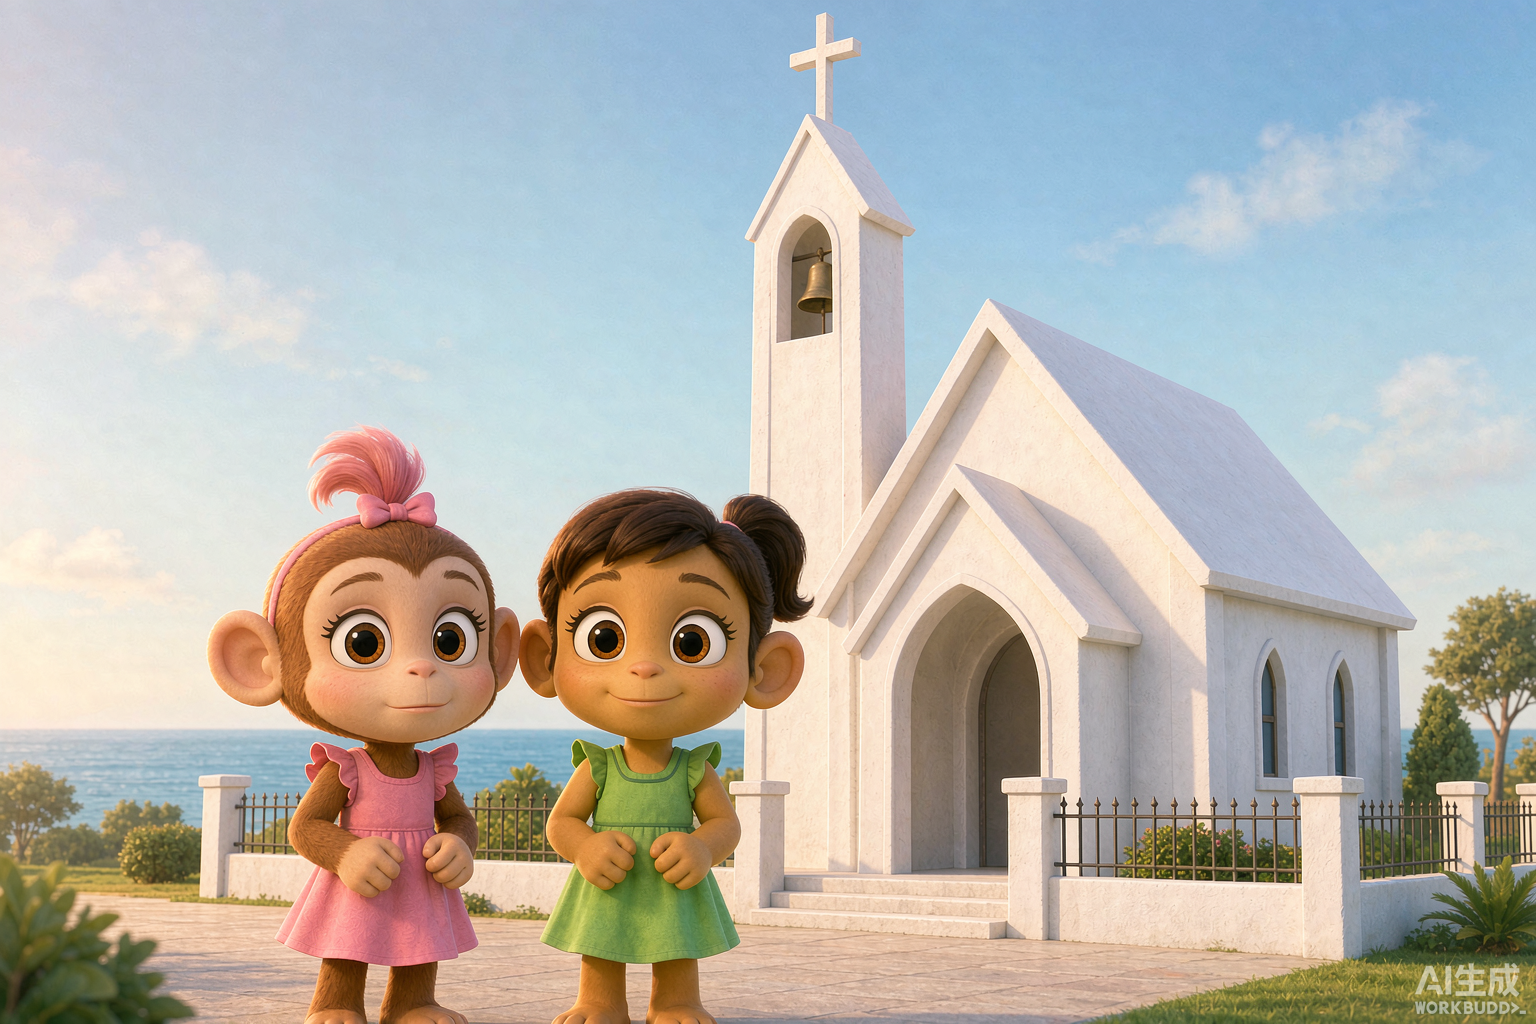
我有两个原创 IP 角色:姐姐马小舒(12 岁,绿裙子)和妹妹猴小心(10 岁,粉色衣服)。多镜头生成最容易翻车的就是角色形象漂移。我的做法是在 WorkBuddy 里给每个角色建一份"视觉档案":定稿参考图 + 一段不可动的特征描述(服装颜色、年龄感、标志性元素)。之后任何 scene 的角色 prompt 都从档案里取描述,保证第 1 帧和第 16 帧是同一个人。
Step 4:旁白文案的语调锁定
「文物也疯狂」的旁白是温暖、治愈的第一人称语调。我把语调要求写成固定约束(第一人称、短句、不堆砌形容词),WorkBuddy 出的稿子基本一遍过,偶尔超了字数再让它自己压。
Step 5:预览版 → 反馈 → 迭代
我习惯先出预览版再迭代。WorkBuddy 的好处是"迭代有记忆"——上一轮分镜会上的反馈(比如"scene#26 节奏太快"),下一轮它记得住,不用我每次重新解释一遍创作意图。
一个完整案例:阿那亚 3D 动画旅行视频
最近用这套流程完整跑了一支约 1 分钟的 3D 动画旅行视频:猴小心和马小舒去阿那亚,取景白教堂、孤独图书馆和 Pop Mart 餐厅三个地标。三个场景就是三个 scene 单元,角色档案保证两个角色跨场景一致,旁白用治愈系 vlog 语调串起来。以前这种多场景 + 多角色的脚本,创意定稿后我可能要再磨两天;现在分镜和 prompt 层基本一次成型,剩下的时间全花在精修上。
踩坑经验(都是学费换来的)
- 先拆 scene 再写 prompt,顺序不能反:没有清单直接写 prompt,写到第 8 条必然风格漂移;
- 每个 scene 的 prompt 里必须带"禁忌项":不写,AI 就自由发挥;
- 角色档案要"冻结":参考图定稿后就别再改,每改一次,历史 scene 全得跟着返工;
- 旁白和画面分开迭代:混在一起改,容易互相打扰;
- 善用迭代记忆,但关键决策要落成文字:对话里的口头共识,隔天可能"失忆",重要的风格约束要么写进 prompt 模板,要么让它整理成文档存档。
写在最后
这套工作流本质上就一句话:把创意拆成 scene,把 scene 交给 WorkBuddy,把自己留在创意和精选上。对个人创作者来说,AI 真正的价值不是替你创作,而是把你从重复劳动里捞出来,让你有时间纠结那些真正值得纠结的细节。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号