实测:统一内存 128GB 笔记本装 Debian 13 跑本地大模型, 显存怎么分才不翻车(附清单)
原创
实测:统一内存 128GB 笔记本装 Debian 13 跑本地大模型, 显存怎么分才不翻车(附清单)
原创
A1Book
修改于 2026-10-16 15:24:12
修改于 2026-10-16 15:24:12
【内容摘要】
本文以统一内存 128GB 笔记本为测试对象,实测 Debian 13 下的显存分配默认值陷阱、GTT 内核参数扩容效果、27B 级开源大模型三档参数量化的速度差异、五角色多智能体团队的内存占用,以及多模态模型的常驻数量边界,最后给出选型结论清单与避坑清单。
【编写目的】
用实测数据回答一个具体问题:128GB 统一内存机型装 Debian 13 后,显存该怎么分才能稳定跑本地大模型与多智能体任务。
一、实测背景
手上有台统一内存 128GB 的笔记本,LPDDR5X-8000 四通道统一内存,集成核显。想验证一件事:这台机器装 Debian 13 之后,显存到底该怎么分,才能稳定跑本地大模型和多智能体任务。本文只讲实测数据和结论,不做推荐。
二、实测一:BIOS 显存分配的默认值陷阱
开机按 F2 进 BIOS,UMA Frame Buffer Size 保持默认 Auto 时,GPU 实际只拿到 512MB 到 2GB 的固定显存。结果是系统明明还有大量空闲内存,推理框架却报显存不足,模型层被迫放到 CPU 上跑,速度掉到个位数。手动改成 Custom 并选 96GB(128GB 机型的 BIOS 上限)后,问题消失。
三、实测二:Linux 上限比 BIOS 更高
编辑 /etc/default/grub,在 GRUB_CMDLINE_LINUX_DEFAULT 追加 ttm.pages_limit=30720000 amdgpu.gttsize=120000,执行 update-grub 后重启。dmesg 输出显示 120000M of GTT memory ready,GPU 可寻址显存从 BIOS 的 96GB 提升到 120GB。
换算公式:pages_limit 以 4KB 页为单位,(GB 数乘以 1024 再乘以 1024)除以 4.096。120GB 对应 30720000。结论:Linux 下扩显存靠的是 GTT 内存池,不是 BIOS 的固定划分。但社区实测提醒,这个值不建议超过 108GB。
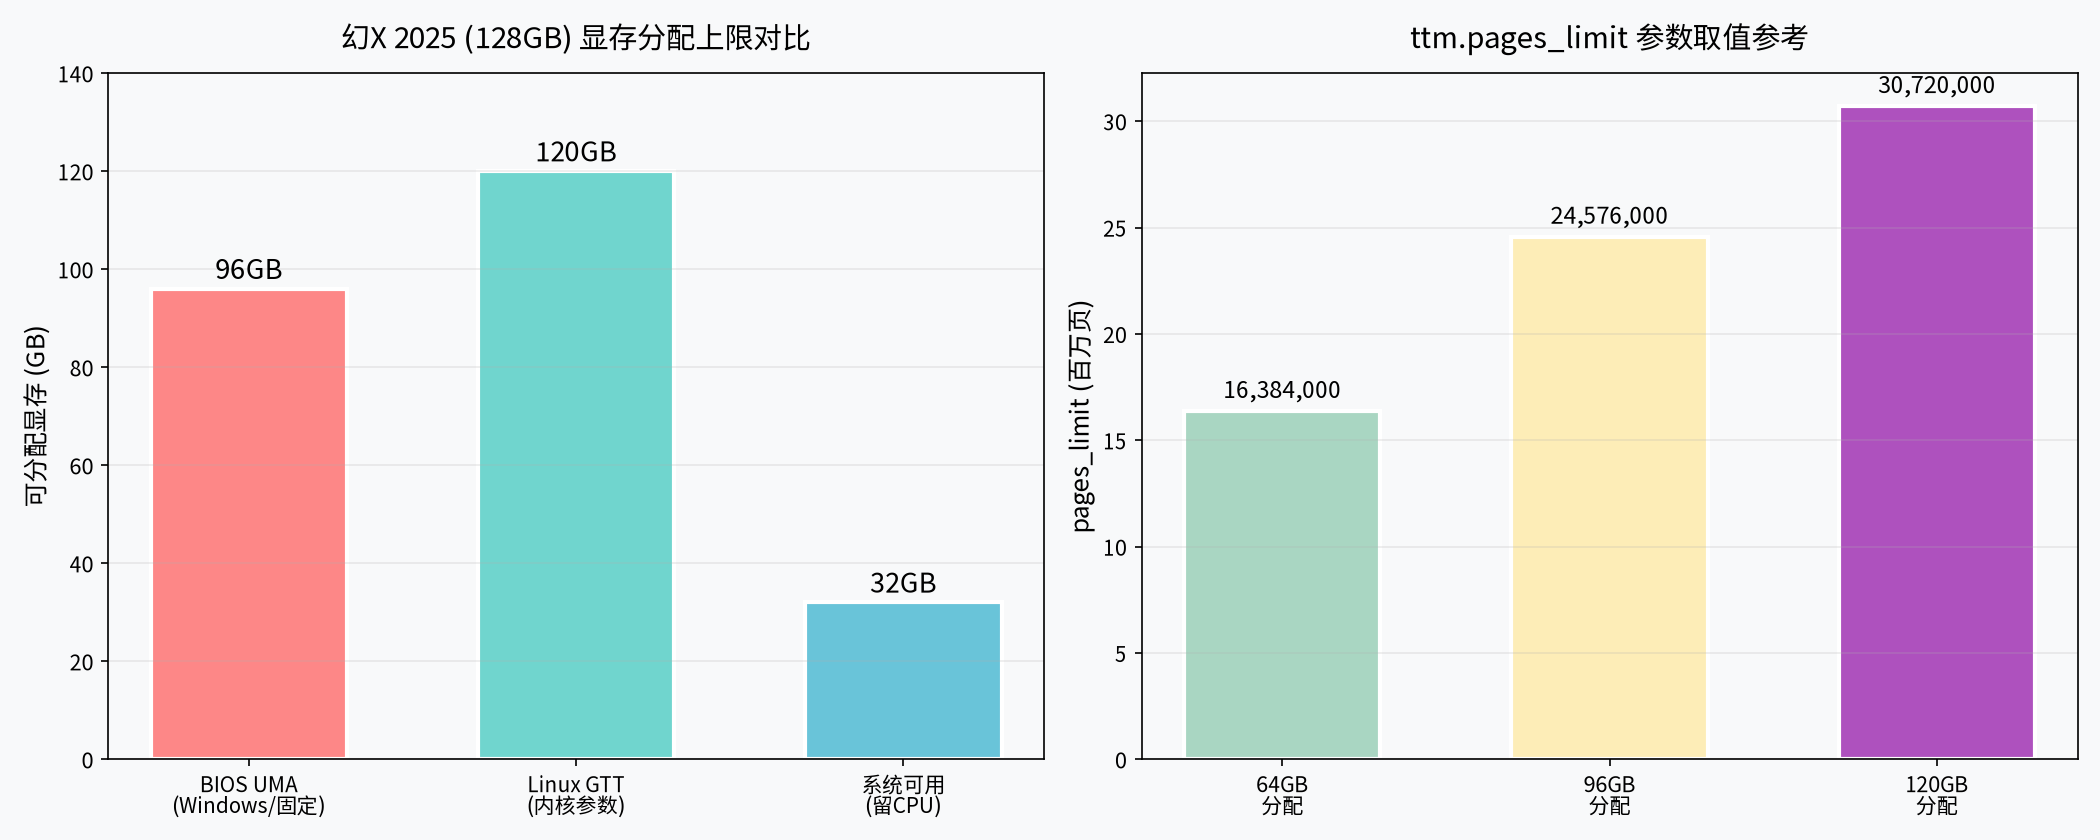
图 1 统一内存 128GB显存分配上限与 TTM 参数取值参考
四、实测三:Q4、Q5、Q8 三档量化的速度对比
测试对象为一个 27B 级开源大模型,三档参数量化(Q4_K_M、Q5_K_M、Q8_0),轮流对话模式,单模型实例。第一档参数 Q4_K_M:权重约 16GB,速度最快,长链路任务偶尔 JSON 解析出错。第二档参数 Q5_K_M:权重约 19GB,生成速度 22 到 28 token 每秒。第三档参数 Q8_0:权重约 29GB,生成速度 16 到 21 token 每秒。
结论:Q8 比 Q5 慢约 20% 到 30%。原因是 K-quant 量化有专门优化的矩阵运算内核,Q8_0 虽然精度约 99%,但数据搬运量更大、内核效率反而更低。哪怕 128GB 内存装得下整个 Q8,速度照样慢。换算参考:1 token 约等于 1.5 个汉字,22 token 每秒约合 33 汉字每秒,远快于普通人说话语速。
五、实测四:多智能体团队的内存占用
测试方案为五个角色轮流对话:总指挥、项目研究员、开发工程师、代码评审、文档工程师。实测占用:主模型权重约 19GB,KV 缓存预留 24GB,RAG 向量库 8GB,系统后台 16GB,编排框架与沙箱 4GB,合计约 71GB,剩余近 57GB。
关键发现:编排框架本身不加载模型权重,只通过 HTTP 调用推理服务。五个角色共用一份权重,区别只在 System Prompt、工具权限和对话上下文。结论:轮流对话模式下,显存开销约等于单智能体,是 128GB 机型最省资源的方案。
六、实测五:多模态模型该常驻几个
常驻一个轻量视觉模型,权重约 5GB,负责看图与截图解析。音频转写模型约 2GB,按需加载。生图模型 4bit 约 10 到 13GB,生成完立刻卸载。结论:常驻模型不要超过两个。常驻越多,留给 KV 缓存的空间越小,多智能体长对话容易触发 swap。
七、选型结论清单
第一,系统:Debian 13,启用 non-free-firmware,内核建议 6.13 以上。第二,显存:BIOS 设 96GB,Linux 用 TTM 参数扩到 120GB,不建议超过 108GB。第三,主模型:27B 级开源模型,选三档参数中的中档 Q5_K_M,权重约 19GB。第四,视觉模型:7B 级开源视觉模型常驻,权重约 5.2GB。第五,按需模型:音频转写、生图模型,用完即卸。第六,编排:五角色轮流对话,开启人工确认。
八、避坑清单
BIOS 显存保持 Auto,GPU 只拿到 512MB;TTM 参数设太大,系统内存被挤爆触发 swap;忘记启用 non-free-firmware;6.12 内核直接跑推理,间歇性崩溃;想做休眠,swap 要求不小于物理内存,128GB 机型不现实;并行子智能体开太多,KV 缓存叠加。
九、实测总结
128GB 统一内存确实把本地大模型的门槛拉低了:一份权重、五个角色、五十多 GB 富余。但前提是显存分配和模型档位算得清楚,否则再大的内存也会被 swap 吃掉。以上数据均来自公开社区实测与官方文档,实际表现请以本机实测为准。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号