地产尽调里的 AI:把上百页材料压成一张风险表
原创
地产尽调里的 AI:把上百页材料压成一张风险表
原创
用户12824290
修改于 2026-10-18 08:25:52
修改于 2026-10-18 08:25:52
一份上百页的材料,半天和半小时的差别
上个月处理一个项目,业主交过来数十份历史租约,加起来上百页。
按老办法,这活儿得逐份读,手工标注到期日、租金递增方式、免租期、违约条款,最后汇总成一张 Excel。干上大半天,出来还得自己复核两遍——因为这种表一旦错一个数字,后面算收益预测就全歪。
这次我试着用 AI 跑了一遍。不到半小时。
但过程里翻车了三次,其中一次差点让我把错误的结论发给客户。下面把完整流程和三个坑都写出来,方案不是万能的,边界也说清楚。
先说结论:这套方法不是所有场景都适用,但它确实救回了我的好几个下午。
为什么尽调这种活儿特别适合 AI
不是所有行业都值得硬套 AI。尽调能跑通,是因为同时满足三个条件。
第一个条件是文档密集。尽调材料里八成以上是文本——租约、评估报告、产证说明、往来邮件。本质工作就是「从大量文本里提取结构化信息」,这恰好是大模型最擅长的事。
第二个条件是风险点可以枚举。地产风险不是玄学,它是有清单的:租约到期集中度、免租期过长、递增条款缺失、产权不清、抵押未解、租赁备案缺失。既然能列成清单,就能让模型逐条对着找。
第三个条件是格式不统一。不同年份、不同出租人签的租约,条款表述千差万别。人工要靠业务经验才读得懂,正则表达式完全搞不定。但对模型来说这反而是优势——它不需要预定义规则。
三个条件同时满足时,AI 的投入产出比通常是正的。只有第一个条件(纯文档多)而没有第二个(规则不可枚举)的话,收益就一般了。
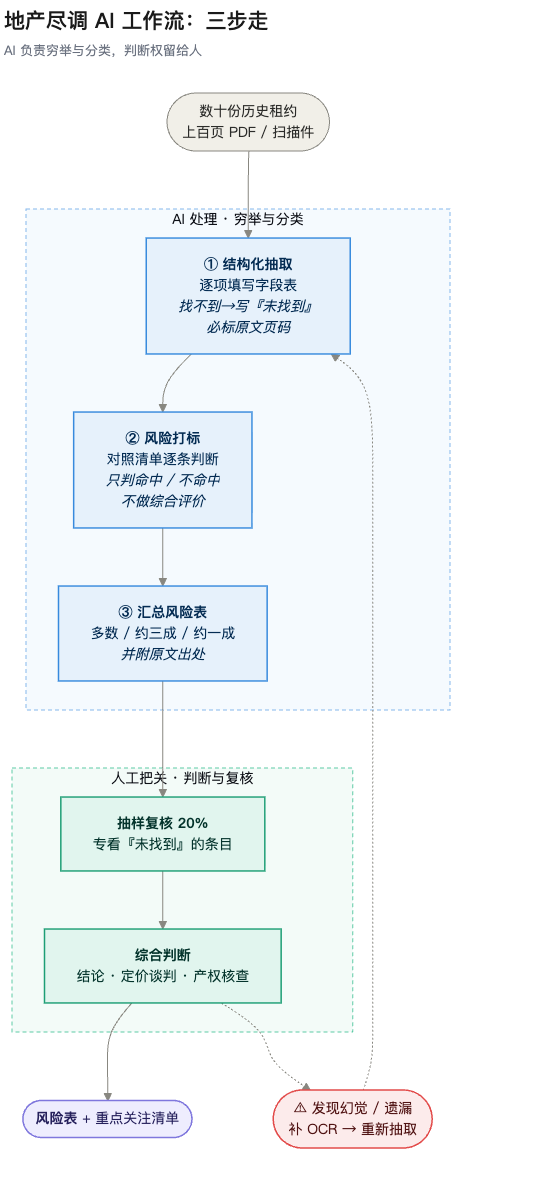
实际怎么跑:三步工作流
第一步:结构化抽取
目标是把每份租约转成统一字段。 这里有个关键点,我一开始踩了坑。
最初的提示词我写的是「请阅读这份租约并总结要点」。出来的结果很漂亮——段落通顺、要点齐全、措辞专业。但没法用。因为我需要的是能排序、能筛选、能求和的表格,不是散文。
改成这样之后,可用率从不到三成变成九成:
请逐项填写以下表格。 要求: 1. 找不到的字段一律填「未找到」,不要推测、不要用「可能」「大概」等表述 2. 每条结论标注在原文第几页 3. 违约条款、优先购买权等必须引用原文,不做概括 表格: 【字段模板】
三个约束缺一不可。「找不到就写未找到」这条是治幻觉的关键,后面还会细说。
第二步:按风险清单逐条打标
有了结构化数据,就让它对照行业风险清单归类。
这一步有个反直觉的发现。
我一开始是让模型直接回答「这个项目的租赁风险高不高」。它给的答案全是中庸的套话——「需要综合评估」「建议进一步核实」——完全没法用。
改成只做归类,不做判断之后,质量完全不一样:
原因很简单:AI 擅长穷举和分类,不擅长综合判断。 让它做分类,它能把数十份租约 × 十余个风险项 = 数百个判断全部做完且口径一致;让它做综合,它就只能给你一句废话。
综合判断这一步,留到我自己的表格里做。
第三步:汇总成风险表
最后拼成一张表。下表是示意结构,数字为演示用途:
实际交付时我会把「多数」「约一成」这类描述换成精确数字,落到可以排序筛选的表格里。
再配一段人话结论,给不熟悉这块的同事看。
这里建议附上你实际用的完整提示词,放代码块里。这是整篇文章被收藏最多的部分——开发者读者会直接复制去用。
三个真实的翻车点
这一段可能比上面的流程更有价值。
坑一:模型会编出不存在的条款
有一份租约,模型在风险表里填了「租金每年递增 3%」,还给了原文位置:中间某一页。
我点进去一看,那一页讲的是物业管理费。递增条款在这份租约里压根不存在。
这类幻觉最麻烦的地方在于——它给出的格式完全正确,位置标注也像模像样,不去点开原文根本发现不了。
解法是加一条硬约束:每条结论必须标注原文页码,标注不出来的直接判为无效。 加上这条之后,幻觉问题基本消失。
代价是大约一成的条目会因为「无法标注」被丢掉,但这部分本来就要人工复核,并不多花时间。
坑二:找不到,不等于不存在
连续好几份租约都报「未找到解约条款」。我一度以为这批租约没写这一条。
后来手工翻原文,其中一份藏在附件里的扫描件里。模型读不了扫描件,于是报「未找到」。
这件事之后我给自己定了一条规矩:
AI 说「没找到」,要理解成「我没找到」。
在做尽调的场景里,这是最危险的思维定式——它会让你直接漏掉风险,而且你甚至不知道自己漏了。
解法有两个:一是把扫描件先过一遍 OCR 转成文本再喂进去;二是流程里必须保留人工抽样复核,我一般随机抽 20%,专门看 AI 报「未找到」的条目——那部分风险最高。
坑三:长文档会丢前段内容
我原以为一次性把整个项目包全丢进去,模型能处理。
实际上前几十页的内容会明显被忽略。早期那几页里有一条免租期条款,输出里完全没有——不是判断错,是压根没读到。
模型没有「读到后面就忘了前面」这种物理机制,但注意力分配上,长上下文里靠前的内容确实更容易被稀释。
解法:切到以单份文件为单位处理,每份独立跑一次,最后再汇总。 不要指望模型一次读完整个项目包——每份租约就是一次单独调用,成本增加但结果可靠得多。
AI 干不了的三件事
讲完能做什么,得讲不能做什么,不然容易被评论区质疑。
第一,定价和谈判。
AI 能帮我算 Cap Rate、能做敏感性分析,但「业主要价这个数,有没有多少谈判空间」是人的判断。我用 AI 做的只是把敏感性分析表铺开,让人来读那张表。谈判还是得坐在桌前,看对方表情。
第二,产权和法律认定。
小产证、抵押查封、权属纠纷——这些必须人工查档、看原件。模型在产权问题上基本等于瞎猜,任何情况下不能采信。
我们吃过亏:某个项目产证是小产证,模型在报告里写的是「产证齐全,建议正常推进」。人工一查才知道后续交易要另做安排。这个错如果没复核就发出去,是会影响客户决策的。
第三,最终结论。
我把它的定位明确成「初筛工具」:把上百页材料压成一张表,让我在十几分钟内知道该重点看哪几份文件。
决策仍然是我做的。
如果要说一个判断标准的话:
如果 AI 出错,你能不能在 10 秒内发现。
做不到,就别把它放在关键路径上。
这套思路能迁移到哪
最后提炼一下方法论,这部分可能对不在地产行业的朋友也有用。
判断一个场景适不适合这套做法,看三个条件:
- 文档密集 —— 工作时间大头是读文本
- 规则可枚举 —— 风险点 / 检查点能列成清单
- 格式不统一 —— 不写正则也没法处理的那些
三个都满足,基本就能跑。
然后是两条最重要的原则:
原则一:先让它分类,再让它总结。
让模型做穷举分类,它能给你一致的口径和完整的覆盖;让它做综合判断,它会给你一句正确的废话。
原则二:约束比提示更有效。
「找不到就写未找到」「必须标注页码」「不要推测」这几句话,比「请认真仔细地分析」有用一百倍。
最后,想问问大家:
你们所在行业里,有没有类似「文档密集 + 规则可枚举」的环节?
我很想知道这套方法在别的领域能跑通多少,以及会遇到什么新的坑。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号