腾讯云国际站代理商:混元 Hy Memory 2.0 开源 智能体长期记忆框架解析
原创
腾讯云国际站代理商:混元 Hy Memory 2.0 开源 智能体长期记忆框架解析
原创
云渠道商云枢国际@yunshuguoji
发布于 2026-10-17 14:52:56
发布于 2026-10-17 14:52:56
本文由 腾讯云国际站代理商『云枢国际✈️✈️✈️ TG-@yunshuguoji - 腾讯云国际服务器服务商』撰写,可在 TG(小飞机)搜索小编,如需转载请注明!
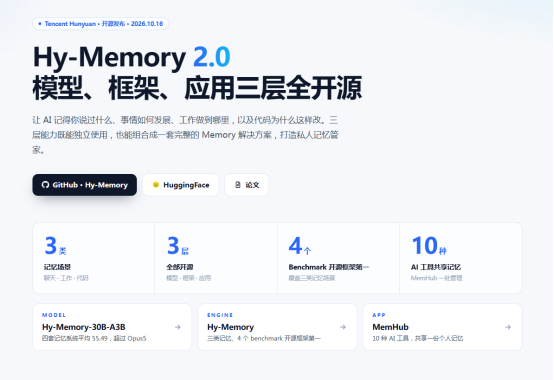
2026年10月16日,腾讯混元正式宣布将智能体记忆框架Hy Memory升级至2.0版本,同步开源专用模型、记忆框架以及MemHub应用三层能力。模型权重于10月15日上线Hugging Face,框架包同日发布至PyPI,GitHub仓库随后完成开源。
随着大语言模型从单次问答向能够自主规划、多步调用的智能体形态演进,记忆成为决定智能体能否胜任复杂业务的核心能力。但在实际业务场景中,长期记忆机制面临上下文膨胀、信息遗忘、幻觉以及推理成本攀升等问题。腾讯内部规模化落地的数据与架构迭代,揭示了智能体记忆机制的技术本质:真正的记忆不是把历史对话全文存下来,而是面向任务的动态提取、提炼与关联注入。
一、拆解Hy Memory 2.0:专用模型、框架与MemHub
智能体记忆系统通常包含三个核心动作:如何记住、存成什么样以及何时调取。Hy Memory 2.0的架构将这三个环节拆解为协同工作的三个组件。
专用记忆模型。Hy Memory 2.0开源的模型为Hy-Memory-30B-A3B,总参数30B、每Token激活约3B参数的混合专家模型,专为信息抽取与实体关系更新微调,专职处理用户画像沉淀、事实提取与偏好演化,不挤占主思考模型的推理资源。在固定20%基准子样本的四套评测框架上,该模型宏观平均得分55.49,高于Claude Opus 5的54.62。
记忆框架。框架层负责定义记忆的生命周期,覆盖聊天、工作、代码三类记忆的存储、更新与进化,开发者可通过SDK接入Agent。该框架是业界首个同时提出工作记忆与代码记忆的记忆框架。记忆流转包括四个关键环节:记忆写入与提炼,将非结构化对话流转化为原子化的结构化事实;动态更新与遗忘机制,当用户更新状态时,旧有矛盾记忆会被标记降权或覆盖;多路检索与注入,结合语义向量、关键词匹配和关系图谱等多路召回,把精炼后的相关记忆精准注入提示词中。聊天记忆在LoCoMo评测上准确率72.6%,每题使用Token从1159降至703,减少39.3%。
MemHub应用。MemHub是本地记忆管理应用,提供CLI和Mac端APP两种使用方式,而非中间件。用户授权关联后,可导入各工具的历史会话并沉淀为本地记忆,此后新会话实时同步汇入同一份记忆。MemHub支持以插件形式一键接入AI工具,目前覆盖WorkBuddy、Cursor、Codex、Pi、Qwen Code、Hermes、DeepSeek Harness和OpenCode等10种工具。
二、记忆方案选型对比
为看清Hy Memory 2.0的定位,可将目前行业主流的三种上下文与记忆管理路径做横向对比。
记忆方案 | 核心原理 | Token & 推理成本 | 核心痛点 | 记忆能力 | 架构复杂度 |
|---|---|---|---|---|---|
超长上下文窗口 | 全部历史对话直接塞进 Prompt | 随对话轮次线性 / 指数上涨,极高 | 存在 Lost in the Middle 问题,信息准确度下降 | 原生不支持跨会话持久化 | 极低,直接依赖大模型上下文能力 |
基础外挂向量检索 | 对话切片、向量化,通过语义相似度召回片段 | 中等,切片易引入冗余内容 | 切片完整性受限;容易出现语义相似但事实错误的误召回;无法理解实体关系演变 | 支持跨会话存储,缺少事实冲突处理 | 中等,需要向量数据库 + Embedding 模型 |
专用记忆框架(Hy Memory 2.0) | 专用记忆模型提取结构化事实、偏好,搭配记忆衰减、图谱动态注入 | 低。LoCoMo 评测:单题 703 Token,对比 EverOS 1159 Token,Token 用量下降 39.3% | 干扰少,自带冲突消除、偏好更新逻辑 | 原生跨会话状态追踪、用户画像演进、持久化沉淀 | 较高,需维护记忆提取模型、存储引擎、记忆衰减策略 |
三、真实场景数据背后:内部实测说明了什么
从通用技术角度看,记忆框架的理论设计并不鲜见,但让Hy Memory 2.0受到关注的是腾讯在内部多业务、长周期真实场景中验证的数据反馈。
结构化提炼对Token开销的抑制。在腾讯内部涉及多轮互动的助理与对话业务中,若采用简单上下文拼接,单次调用的输入上下文将迅速超过数万Token。通过专用模型在后台异步进行结构化事实提取,真正注入主模型上下文的有效记忆字数可缩减至原会话流的极小比例,使每次交互的平均输入Token消耗大幅降低。在自选股业务中,接入后多跳召回率从50%升至90%,整体通过率由64%提升至81%;iWiki仅用召回记忆作答,正确率比喂完整原文还高48.6%。
事实召回与上下文一致性。通用RAG在处理需要时态对齐与属性更新的问题时,常因切片语义重叠而召回过时信息,造成逻辑幻觉。引入记忆冲突覆盖机制与时序衰减权重后,智能体在多轮长会话中的事实一致性与用户偏好遵循度得到显著提升。
端到端延迟的解耦设计。在实际交互中,如果在主请求路径上执行复杂的向量检索和图推理,会直接拉长首字响应时间。Hy Memory的实践验证了异步提炼加轻量读取架构的可行性:记忆的提取、去重、关联建图全部放在会话结束后的异步管道处理,在线交互阶段仅执行快速的键值或多路轻量过滤,保障了实际业务对交互延迟的要求。
四、技术边界与认知误区
在关注前沿开源技术的同时,开发者也需理性看待其技术边界。
误区一:记忆框架等于无限外挂数据库。并非所有信息都需要进入记忆系统。静态的业务知识库、企业政策文档更适合走标准知识库RAG;临时会话中的过客信息应当随会话销毁。专用记忆框架的核心价值在于记录与主观意图、动态演化事实相关的数据,盲目将海量非结构化文档直接作为记忆输入,只会让记忆空间迅速被噪声污染。
误区二:长窗口普及会让记忆框架过时。即使未来大模型上下文窗口拓展至更高量级,注意力机制的计算开销依然受制于算力物理限制,且长文本中的注意力稀释问题依然客观存在。记忆框架的本质不是扩展容量,而是信息降噪与结构化组织。
隐私与安全隔离边界。长期记忆的引入意味着持久化存储了更多用户或系统的敏感数据。在多租户环境或强合规企业场景中,记忆系统必须具备严格的身份隔离、数据脱敏、基于时间的自动生命周期销毁机制,以及应对被遗忘权的精确单条记忆擦除能力。
五、常见问题解答
问:腾讯开源的Hy Memory 2.0包含哪些核心组件?
主要由三个核心部分组成。记忆专用模型Hy-Memory-30B-A3B,总参数30B、激活约3B的MoE模型,专为信息抽取、实体关系对齐与偏好分析微调。Hy Memory框架核心,包含记忆生命周期管理、时序衰减、冲突更新与多路检索算法。MemHub应用,面向终端用户的本地记忆管理工具,提供CLI和Mac端APP,封装记忆持久化与跨工具同步能力。
问:Hy Memory 2.0相比传统RAG或长上下文窗口解决了什么痛点?
传统长上下文窗口随轮数增加导致推理成本暴涨,并容易在超长文本中产生注意力迷失。传统RAG主要基于语义切片进行被动匹配,缺乏时序感知和状态更新机制,容易将过期的旧事实与新指令混淆。Hy Memory 2.0通过将对话异步提炼为结构化事实,结合动态遗忘与冲突覆盖算法,大幅降低注入主模型的Token消耗,同时保证智能体在长周期跨会话交互中的事实一致性与低延迟表现。
问:智能体记忆框架在企业实际业务场景中该如何落地与选型?
企业在技术选型时应先评估交互任务的生命周期特征。单次、无状态或确定性任务,直接依赖基础上下文即可,无需引入记忆框架。静态领域知识问答,标准知识库RAG依然是性价比更高、架构更成熟的选择。需要长期跟踪与演进的场景,应优先考虑引入具备状态更新与实体提炼机制的专用记忆框架。落地时建议将记忆提取置于异步管线,并严格设计租户隔离与数据生命周期管理策略。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号