DolphinDB 能耗分析实战:峰谷分时、班次分摊与单位产品单耗
原创
DolphinDB 能耗分析实战:峰谷分时、班次分摊与单位产品单耗
原创
Xxtaoaooo
发布于 2026-10-18 19:46:38
发布于 2026-10-18 19:46:38
摘要
工业时序数据平台做的事,大多在回答"设备会不会坏"——振动、温度、告警、寿命预测。但同一套数据还能回答另一个价值直接的问题:生产到底贵不贵?
月底电费账单来了,财务问:为什么这个月比上月多了 18%?生产问:A 班和B 班谁更费电?管理层问:每件产品的电费成本是多少,哪条产线偏高?这些问题的原材料——电表读数、功率、班次记录——就躺在时序库里,缺的只是把它们算成钱的那几步。
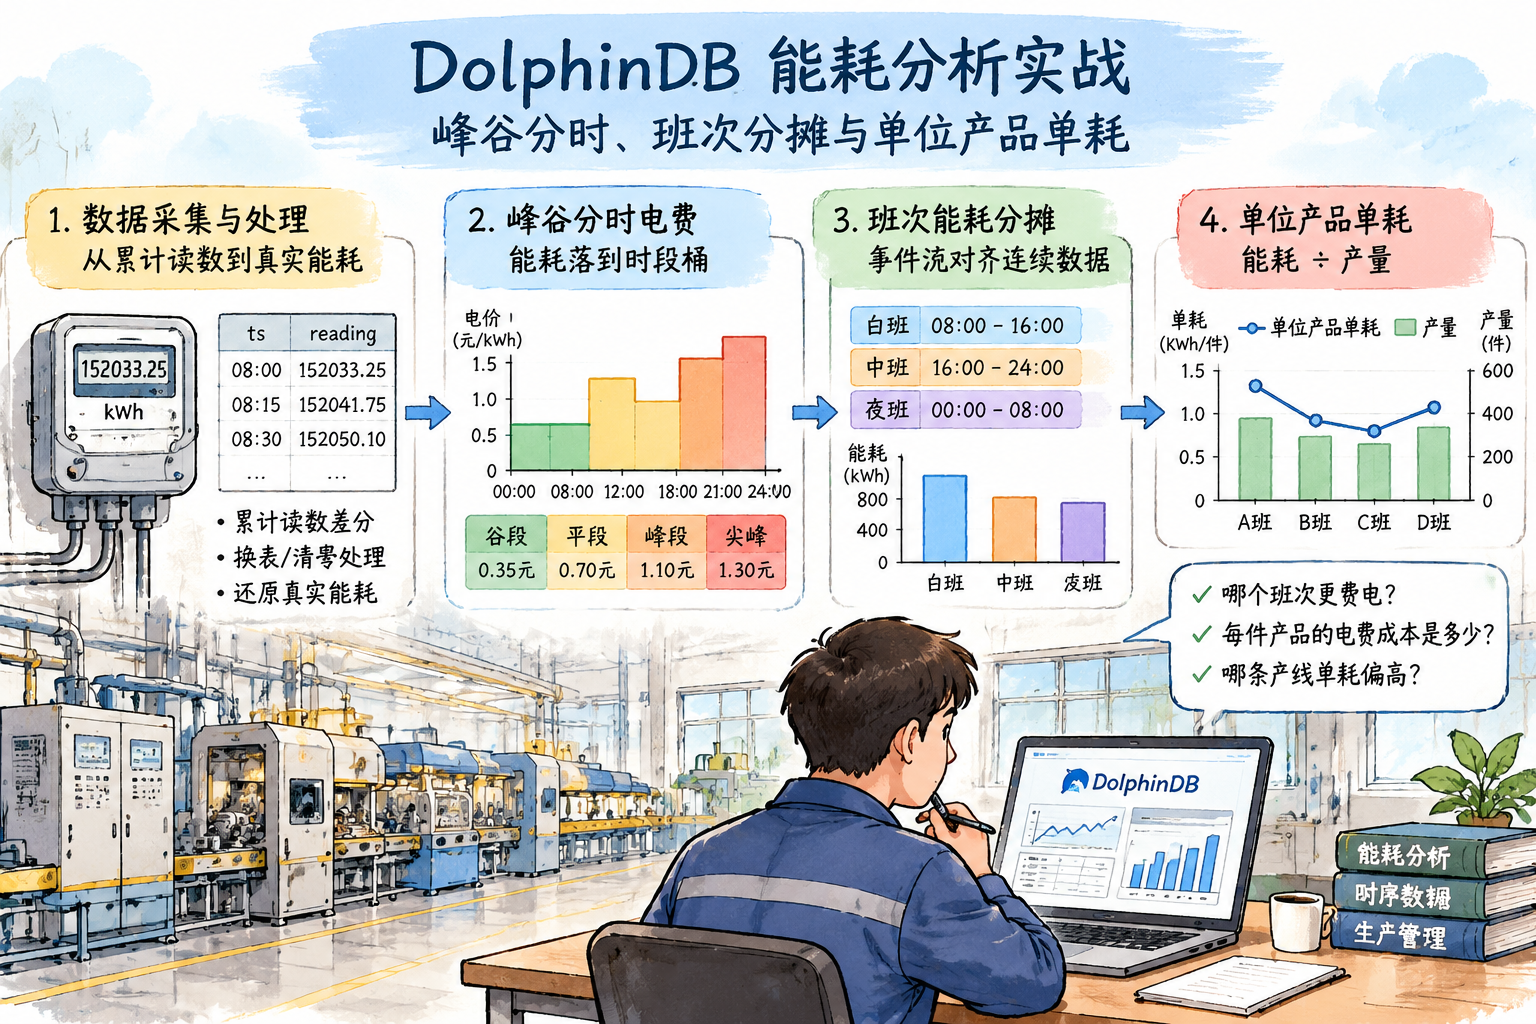
能耗分析听起来是业务问题,拆开看全是时序工程问题:电表读数是单调递增的累计值,真实能耗要靠差分还原,换表清零还要专门处理;峰谷电价按时段计费,能耗要正确落到尖峰平谷的时段桶里;班次和工单是事件流,要和连续的能耗数据按时间对齐;单耗 = 能耗 ÷ 产量,两张来源不同的表要汇到同一行才能算。
本文用 DolphinDB 把这条链路走通:累计读数差分(含换表处理)→ 峰谷分时计费 → 班次能耗分摊 → 单位产品单耗与基线对比,最后整理工程细节与坑。技术不难,难在每一环的语义都想清楚——这正是时序分析的典型手感。
本文基于个人在 IoT 场景下的设计与使用经验,涉及的方法与判断来自有限测试,不代表官方或专业结论。
一、能耗数据的特点与三个业务问题
1.1 先分清两种数据形态
能耗分析的第一颗雷,是没分清两种数据:
- 累计读数(表码):电表上的数字,从装机起单调递增——本期走了 100 kWh,读数加 100。它不是能耗,能耗是相邻两次读数的差
- 瞬时值:功率(kW)、电流、电压、功率因数,是每个时刻的"速度"。想从它得到能耗,需要按时间积分
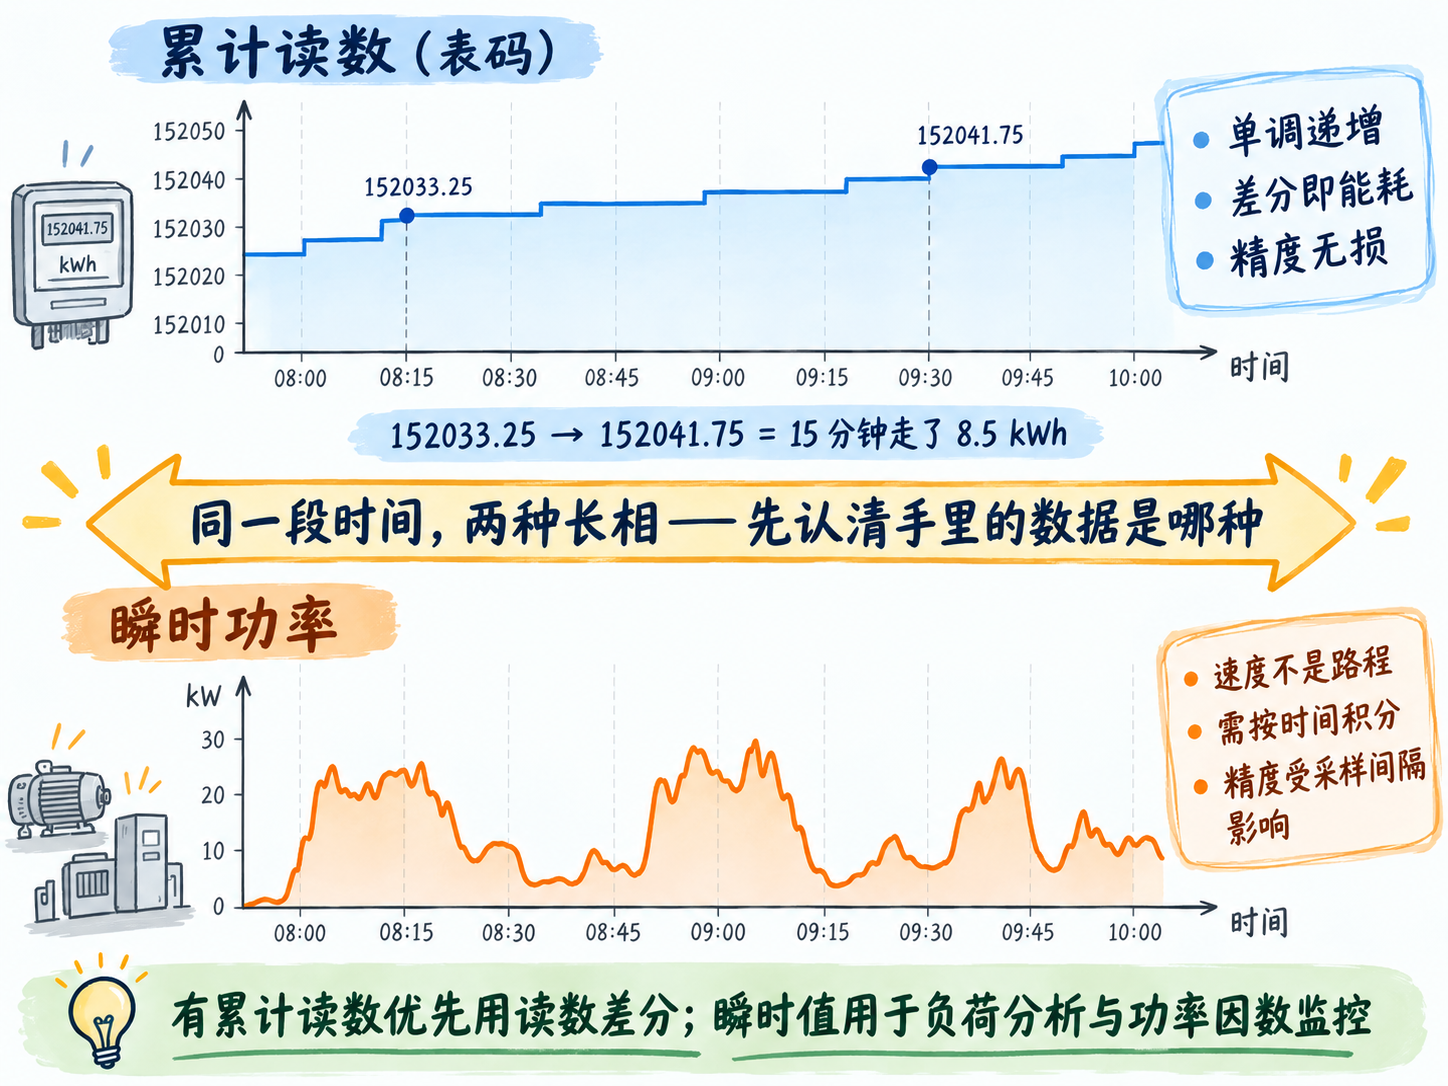
两种形态都常见。累计读数差分即可得能耗,精度无损;瞬时功率积分则受采样间隔影响(15 分钟一个点和 1 秒一个点,积分结果有差异)。本文主线用累计读数,瞬时值在第六节说它们的配合用法。
1.2 三个典型的业务问题
- 峰谷分时电费:电价分尖峰/高峰/平段/谷段,各时段单价不同。哪些设备的耗电集中在峰段?错峰能省多少?
- 班次能耗分摊:同样的产品,白班和中班谁的单位能耗高?差距是设备原因还是操作习惯?
- 单位产品单耗:每件产品摊多少电费?哪条产线、哪个班次、哪种产品的单耗偏离基线?
三个问题层层递进:先把读数变成能耗,再把能耗按时段/班次切开,最后除以产量得到经营指标。
1.3 难点清单
提前把坑列出来,后面对号入座:
难点 | 出现环节 | 后文位置 |
|---|---|---|
累计读数 → 能耗的差分 | 数据处理 | 第二节 |
换表/清零导致的读数跳变 | 数据处理 | 第二节 |
峰谷时段与能耗对齐 | 计费 | 第三节 |
班次(事件)与能耗(连续)对齐 | 分摊 | 第四节 |
班次跨零点 | 分摊 | 第六节 |
电价季节性调整 | 计费 | 第六节 |
二、从累计读数到真实能耗
2.1 差分:一行 SQL 的事
假设电表数据表如下(每 15 分钟一条读数):
meter = table(1:0, `ts`deviceId`reading,
              [DATETIME, SYMBOL, DOUBLE])
// (2026.03.15 08:00:00, METER-L3-01, 152033.25)
// (2026.03.15 08:15:00, METER-L3-01, 152041.75)   ← 15 分钟走了 8.5 kWh
差分求能耗:
// 按设备分组,逐条求读数差
energy = select deviceId, ts,
         reading,
         prev(reading)                            as prevReading,
         reading - prev(reading)                  as kwh
from loadTable("dfs://energy", "meter")
context by deviceId
context by deviceId 保证差分只在同一块表内进行——这块表的读数绝不能和那块表的相减。
2.2 换表:读数不增反降怎么办
电表损坏更换、计数清零,读数会突然掉回小值,差分变成巨大的负数。不做处理,当月能耗直接错一位数。
处理分两步。
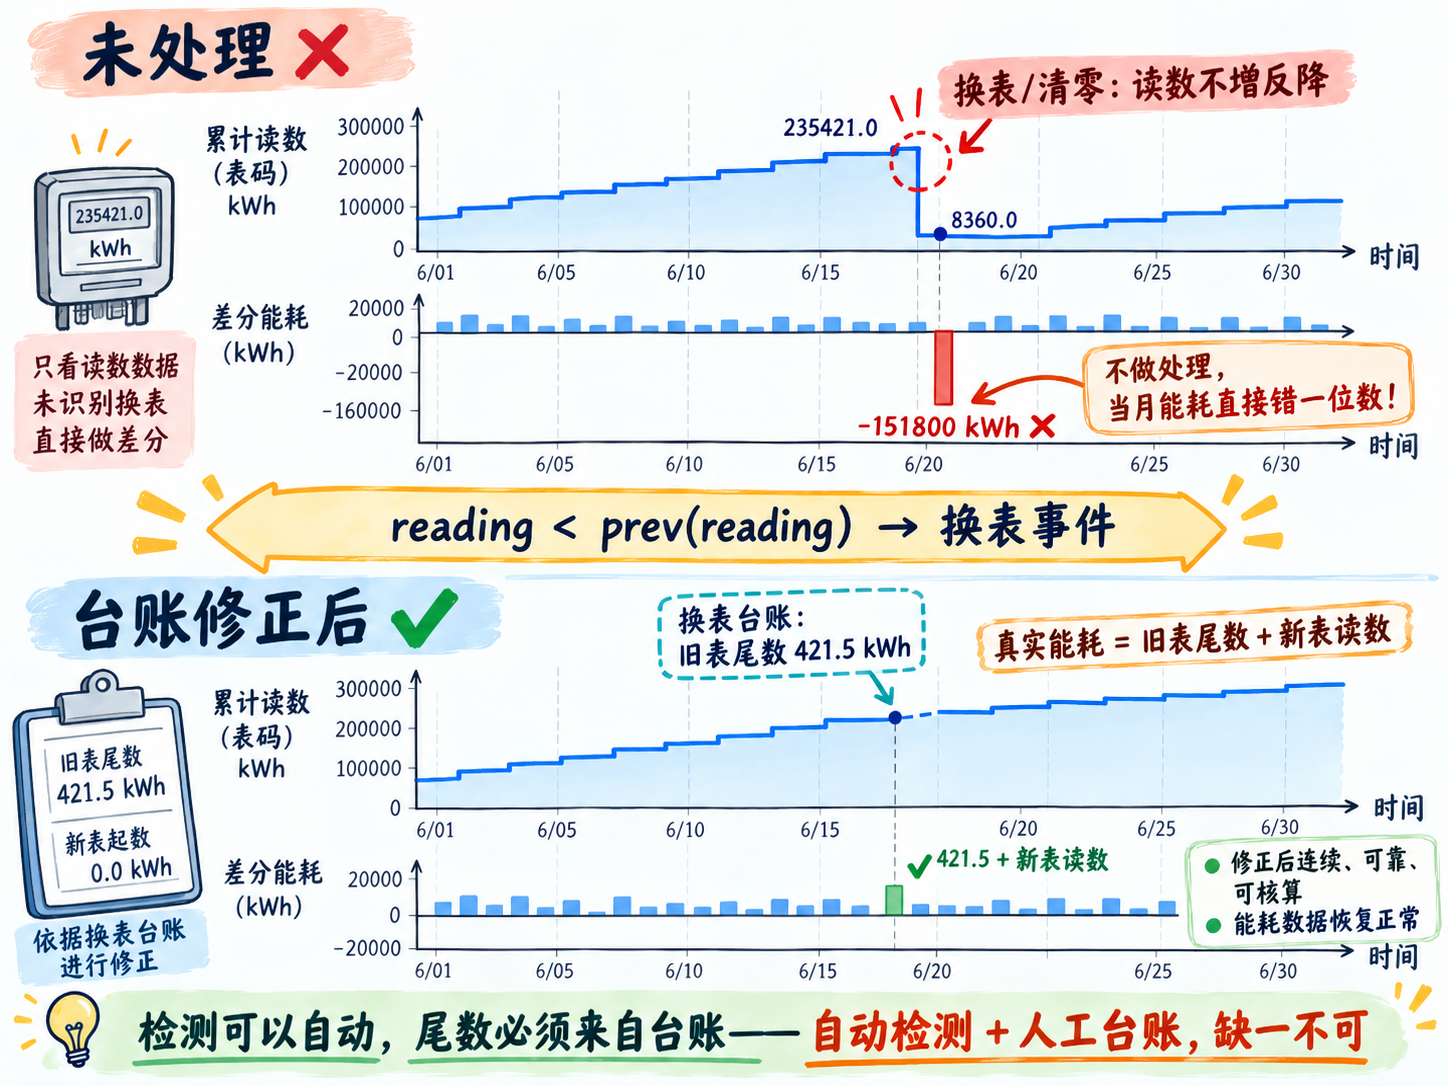
第一步把换表事件找出来:
// 换表检测:读数小于前一条 = 换表/清零事件
swaps = select deviceId, ts,
         reading        as newReading,     // 新表起始读数
         prev(reading)  as oldLastReading  // 旧表最后读数
from loadTable("dfs://energy", "meter")
context by deviceId
having reading < prev(reading)
第二步在差分时修正:换表区间的真实能耗 = 旧表尾数 + 新表读数,其中旧表尾数(旧表止度 − 上次抄见)来自换表台账——这是电仪班组的维修记录,建议也入库成一张事件表:
// 换表台账表:每次换表记一行修正基数
// swapLedger: (deviceId, swapTs, carryOver)
//   carryOver = 旧表止度 - 上次抄见读数

// 差分 + 换表修正
energyFixed = select deviceId, ts,
         iif(reading >= prev(reading),
             reading - prev(reading),      // 正常区间:读数差
             reading + 421.5)              // 换表区间:新读数 + 台账尾数(示意值)
from loadTable("dfs://energy", "meter")
context by deviceId工程纪律:换表事件必须留台账。差分逻辑可以自动检测,但"旧表尾数是多少"只有台账知道——自动检测 + 人工台账,缺一不可。
三、峰谷分时电费:能耗落到时段桶
3.1 时段怎么切
工业电价一般分四段(各地时段不同,以下为常见示例):
谷段 00:00–08:00        单价 0.35 元
平段 12:00–18:00        单价 0.70 元
峰段 08:00–12:00, 18:00–21:00   单价 1.10 元
尖峰 21:00–23:00(夏季)  单价 1.30 元
3.2 能耗按时段落桶
时段简单固定时,iif 按"小时落在哪段"直接分桶:
// 每设备峰平谷能耗与电费
segCost = select deviceId,
    // 峰段(8-11 点、18-20 点整点区间)
    sum(iif(hour(ts) in 8 9 10 11 18 19 20, kwh, 0))    as peak_kwh,
    // 平段(12-17 点)
    sum(iif(hour(ts) in 12 13 14 15 16 17, kwh, 0))     as flat_kwh,
    // 谷段(22-23 点、0-7 点)
    sum(iif(hour(ts) in 22 23 0 1 2 3 4 5 6 7, kwh, 0)) as valley_kwh
from energyFixed
where date(ts) = 2026.03.15
group by deviceId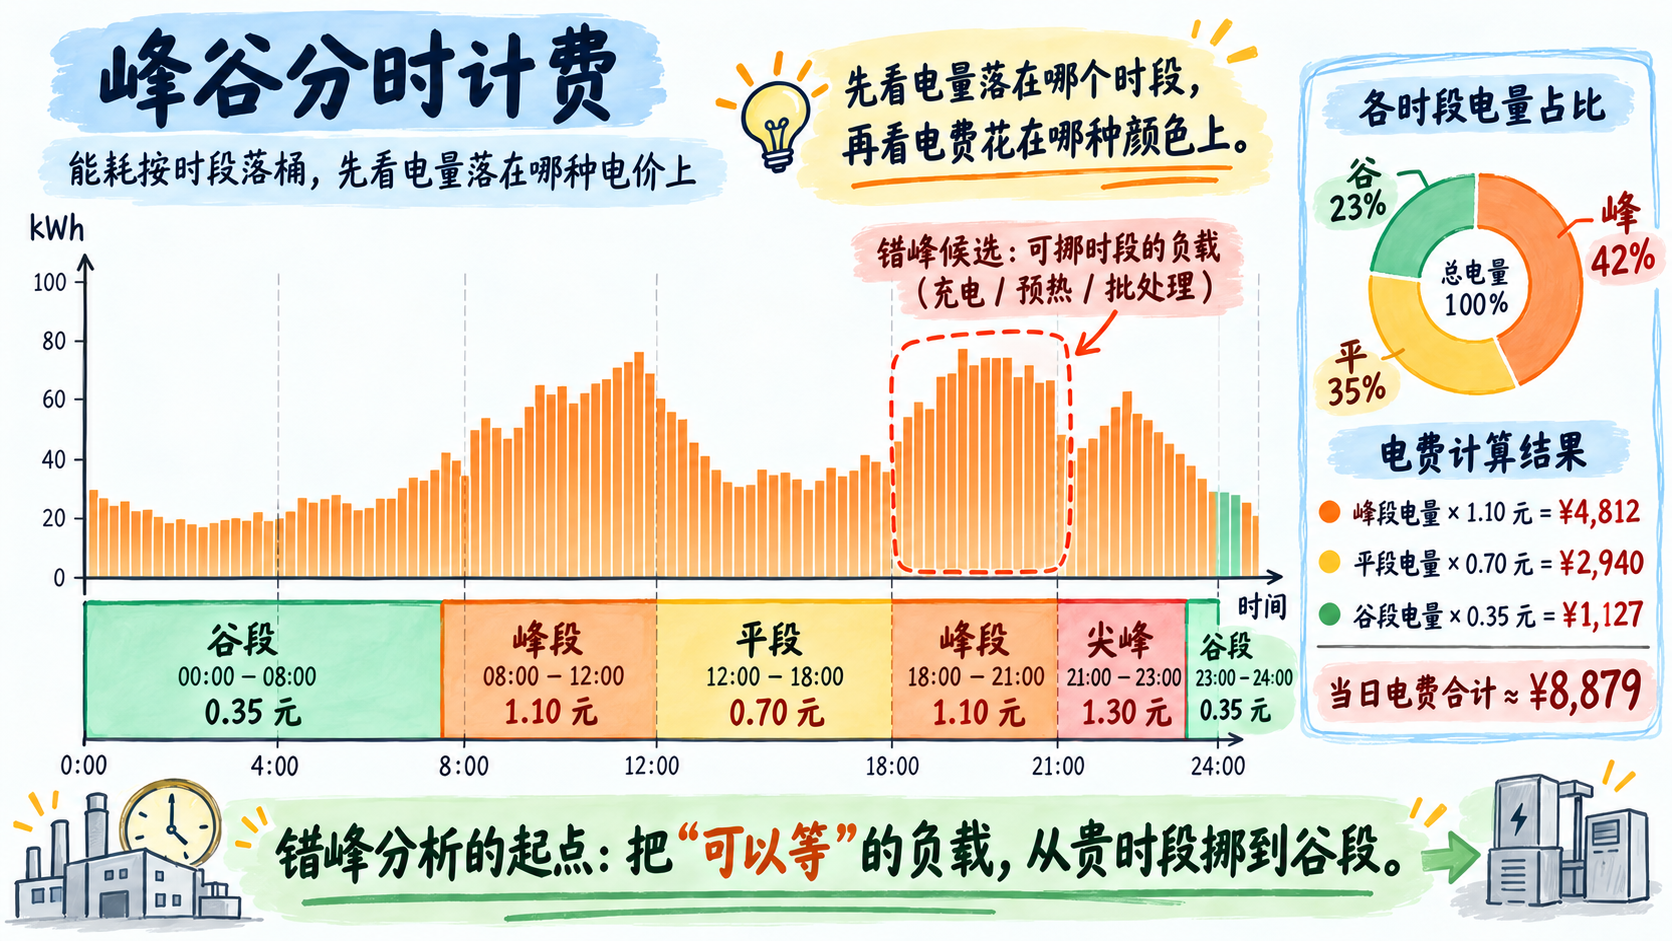
算电费时乘上单价再汇总,并给出峰谷占比——这是错峰分析的起点:
// 峰段占比高的设备 = 错峰候选
select deviceId,
    peak_kwh,
    peak_kwh \ (peak_kwh + flat_kwh + valley_kwh)  as peak_ratio
from segCost
order by peak_ratio desc
3.3 从占比到错峰建议
峰段占比清单出来后,结合工艺判断:哪些高占比耗电是可以挪时段的(充电、预热、蓄冷蓄热、批处理清洗),哪些挪不动(随产线走的工艺负载)。错峰的本质是把"可以等"的负载挪进谷段——时序库给出的不是结论,是按占比排序的候选清单,工艺判断还是人来。
3.4 时段复杂时:日历表替代 iif
季节性尖峰、节假日特殊电价,iif 链会越写越长。此时换成电价日历表:每小时一行、带生效日期,能耗数据按时间等值/临近关联到日历行取价。日历表由电价政策维护,政策调整只改表不改查询——和"点表管配置"是同一个思想:配置是数据,不是代码。
四、班次能耗分摊:事件流对齐连续数据
4.1 对齐问题
班次是事件:8 点白班开始、16 点中班开始、次日 0 点夜班开始。能耗是连续数据:每 15 分钟一条。要把某条能耗记到某个班次头上,就是问:这条能耗的时间戳,落在哪个班次的区间里?
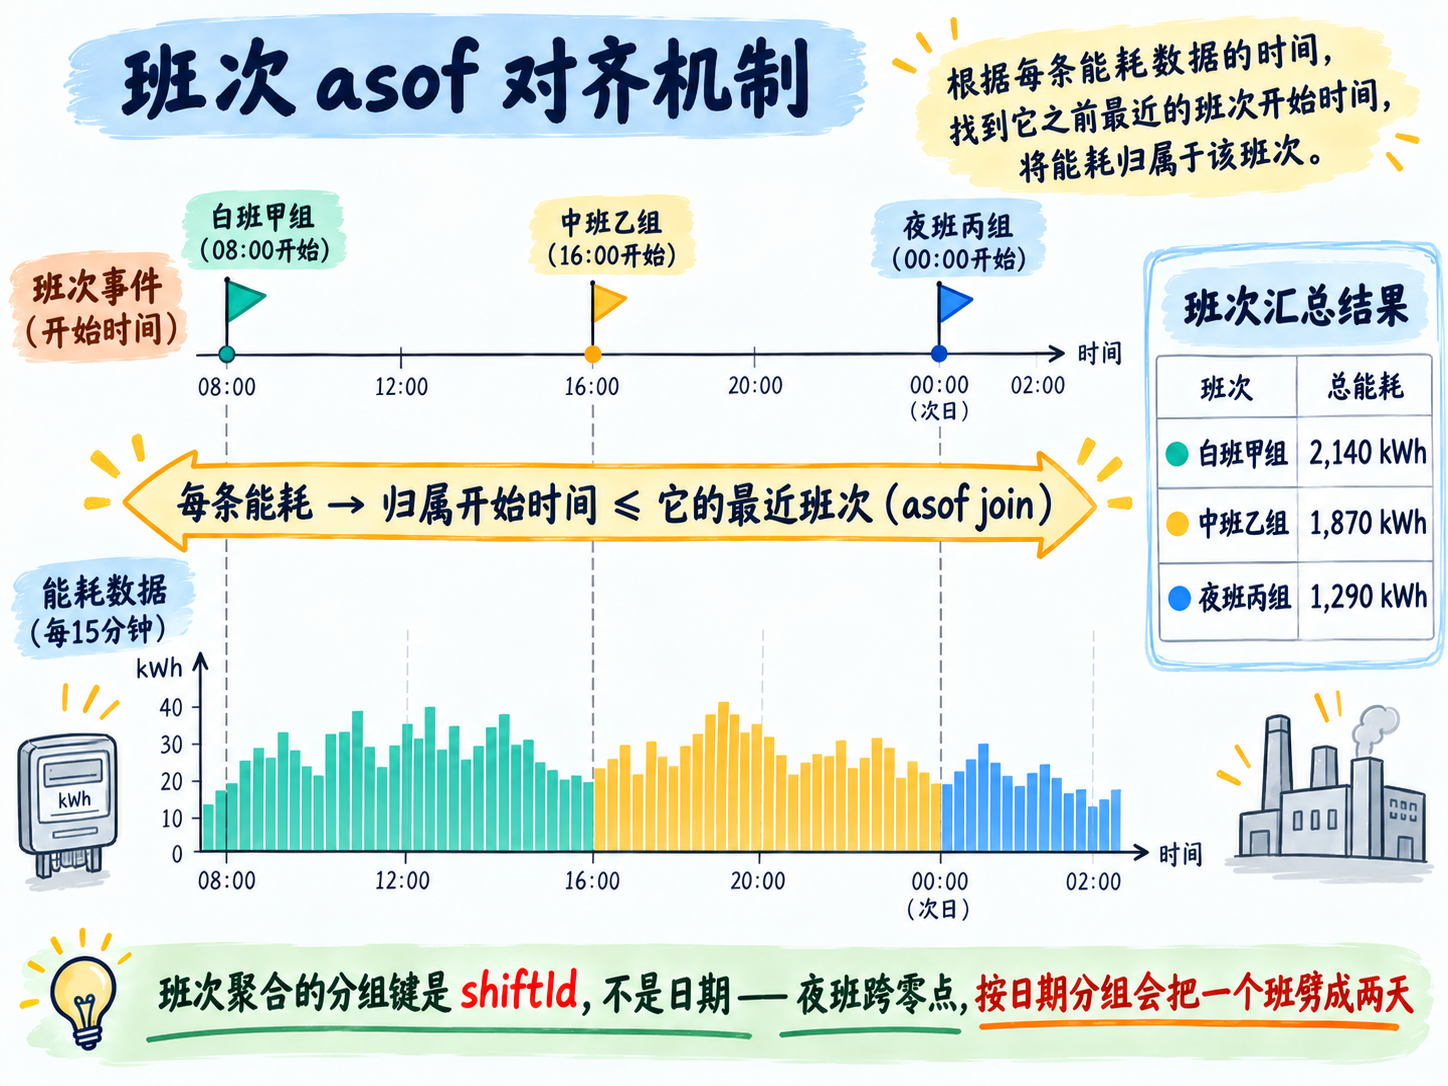
DolphinDB 的 aj(asof join)正适合这件事:对能耗表的每条记录,在班次事件表里找"开始时间不晚于它的最近一个班次":
// 班次事件表:每个班次开始时刻一行(ts 为班次开始时间)
// shiftEvents: (ts, lineId, shiftId, crew)
// (2026.03.15 08:00:00, LINE-3, S0315-A, 白班甲组)
// (2026.03.15 16:00:00, LINE-3, S0315-B, 中班乙组)

// 能耗对齐班次:每条能耗归属最近的班次开始事件
aligned = select s.shiftId, s.crew, e.deviceId,
         e.ts, e.kwh
from aj(energyByLine as e, shiftEvents as s, `lineId`ts)
对齐后按班次聚合,班次能耗就出来了:
// 每班次能耗汇总
shiftEnergy = select shiftId, crew,
         count(distinct deviceId)   as meter_count,
         sum(kwh)                   as total_kwh
from aligned
group by shiftId, crew
4.2 从分摊到对比
班次能耗横向对比要注意归一:夜班产量低、能耗自然低,直接比总量没有意义——这正好引出下一节,把产量拉进来,比"单位产品的能耗"才是同量纲的比较。
五、单位产品单耗:能耗除以产量
5.1 产量从哪来
产量不在电表数据里,而在工单/计数系统里:每个班次结束记一行(班次、产线、产品、产量)。把它和班次能耗汇到同一行:
// 班次产量表:shiftOutput (shiftId, lineId, productId, output)
// 班次单耗 = 班次能耗 ÷ 班次产量
unitCost = select s.shiftId, s.crew, s.lineId,
         se.total_kwh,
         p.productId, p.output,
         se.total_kwh \ p.output      as kwh_per_unit
from shiftEnergy as se
inner join shiftOutput as p on se.shiftId = p.shiftId
kwh_per_unit 就是单耗——每件产品摊多少度电。乘上第三节的分时电价,还能得到每件产品的电费成本,直接进成本核算。
5.2 基线对比:单耗异常检测
单耗数字本身没有好坏,要和同类基线比。基线取同产品、同产线的历史均值:
// 同产品基线(近 90 天均值)
baseline = select productId, lineId,
         avg(kwh_per_unit) as base_kwh
from unitCostHistory
where shiftDate between 2026.01.01 : 2026.03.14
group by productId, lineId

// 偏离基线超过 20% 的班次
outliers = select u.shiftId, u.crew, u.productId,
         u.kwh_per_unit, b.base_kwh,
         u.kwh_per_unit \ b.base_kwh     as ratio
from unitCost as u
inner join baseline as b
        on u.productId = b.productId and u.lineId = b.lineId
where u.kwh_per_unit > b.base_kwh * 1.2超基线的班次,排查方向通常是三类:设备状态(空压机泄漏、轴承磨损导致效率下降)、操作习惯(待机过长、频繁启停)、工况变化(原料批次、环境温度)。单耗异常检测的价值在于把"感觉电费不对"变成"这个班次、这条线、这种产品,单耗超基线 23%"——带着坐标去找原因。
5.3 从指标到看板
把这套计算做成每日定时任务(当天能耗 → 班次分摊 → 单耗 → 基线对比,结果落一张报表表),Grafana 上就是三块图:峰谷占比趋势、班次单耗对比、超基线班次清单。能耗分析从"月底被财务问"变成"每天主动看见"。
六、工程细节与坑
6.1 累计读数与瞬时功率的配合
主线用了累计读数差分。如果现场只有功率(kW)没有表码,能耗 = 功率对时间积分,用时间桶近似:sum(power) × 采样间隔。注意精度随采样间隔下降——1 秒采样和 15 分钟采样,对波动负载的积分结果差异可能到几个百分点。有累计读数优先用读数,瞬时值用于负荷分析和功率因数监控(功率因数低会被力调电费罚款,这也是能耗成本的一部分)。
6.2 班次跨零点
夜班 0 点–8 点横跨两个自然日。按 date(ts) 分组会把同一个班次劈成两天——班次聚合的分组键必须是 shiftId(来自对齐),绝不能是日期。做日粒度报表时,把夜班整体记到它的开始日期上,并在报表口径里写清楚。
6.3 电价调整的生效管理
电价随季节、政策调整。日历表要带生效日期区间,查询时取"生效日期不晚于能耗时刻的最近一版"——和班次对齐是同一个 asof 语义。切忌把电价写成常量,改一次价满库重算。
6.4 表计与时钟
多块表的采样时刻并不严格对齐(这块 08:00:03,那块 08:00:15),跨表汇总前先 bar(ts, 15m) 对齐到统一桶;表计时钟漂移严重的(漂移超过桶宽),先校时或标注,否则时段归属会错。
6.5 口径先行
能耗分析最后的坑不在技术在口径:结算电量(电费账单口径)和抄见电量(表计差分口径)天然有差(含变损线损、结算日与自然日不一致)。上线前和财务对齐口径,报表里注明"本表为表计口径,与账单差异属线损"——否则数字对不上账单时,解释成本比开发成本高。
七、写在最后
设备健康分析回答"会不会坏",能耗分析回答"贵不贵"——后者离经营更近,却是时序平台上常被搁置的一块。因为它的每一步都是"小"问题:差分、换表、时段对齐、班次对齐、除以产量……单看都不难,串起来处处是语义细节。
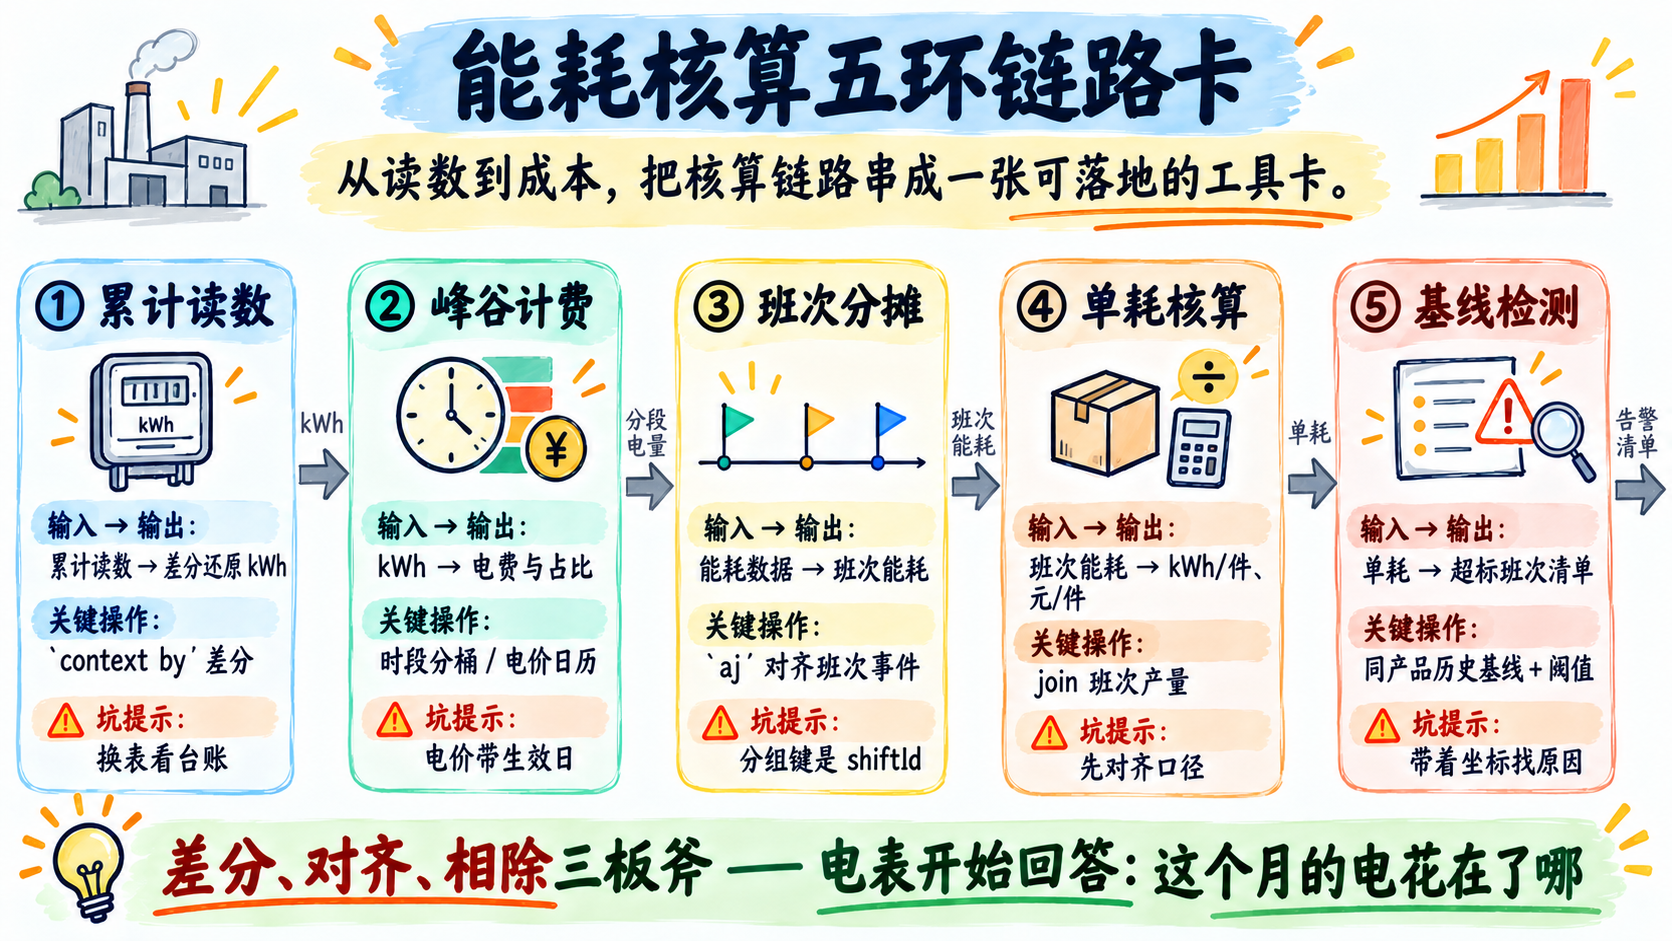
本文的链路收成一张表:
环节 | 输入 → 输出 | 关键操作 |
|---|---|---|
能耗还原 | 累计读数 → kWh | context by + 差分 + 换表台账 |
峰谷计费 | kWh → 电费/占比 | 时段分桶(iif 或电价日历) |
班次分摊 | kWh + 班次事件 → 班次能耗 | aj 对齐 |
单耗核算 | 班次能耗 + 产量 → 单耗/电费成本 | join + 比值 |
异常检测 | 单耗 vs 基线 → 超标班次 | 基线 join + 阈值 |
三个值得留下的判断:
- 换表台账和电价日历都是"配置即数据"——检测可以自动,基数和单价必须有人维护的表
- 事件与连续数据的对齐用 asof 语义——班次、电价版本、工单,凡"生效时刻"型数据都是同一招
- 口径先行——技术算得再准,和财务账单对不上就是白算
时序库里躺着的每一块电表,都是一台记录成本的机器。差分、对齐、相除这三板斧下去,它就开始回答那个最实际的问题:这个月的电,到底花在了哪。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号