小程序 AI 调用的工程实现:模式边界、SKILL 封装粒度与调用链可观测性
原创
小程序 AI 调用的工程实现:模式边界、SKILL 封装粒度与调用链可观测性
原创
newlati
发布于 2026-10-20 09:40:28
发布于 2026-10-20 09:40:28
小程序的入口正在从「用户打开页面」变成「模型调用能力」。微信在 2026-06-08 发布的《关于开发者接入微信 AI 生态的指引》里给了两条技术路径:一条由平台读源码生成可调用能力(自动模式),一条由开发者自己把功能抽象成原子接口、原子组件并封装成 SKILL(开发模式)。两条路径并行,也可以同时开启。
本文只谈工程:模式边界带来的设计差异、SKILL 与原子接口该切到多细、调用链上必须留哪些可观测性。文中规则引自官方接入指南与 SKILL 设计建议,该能力当前处于内测阶段,细则以官方当期文档为准。
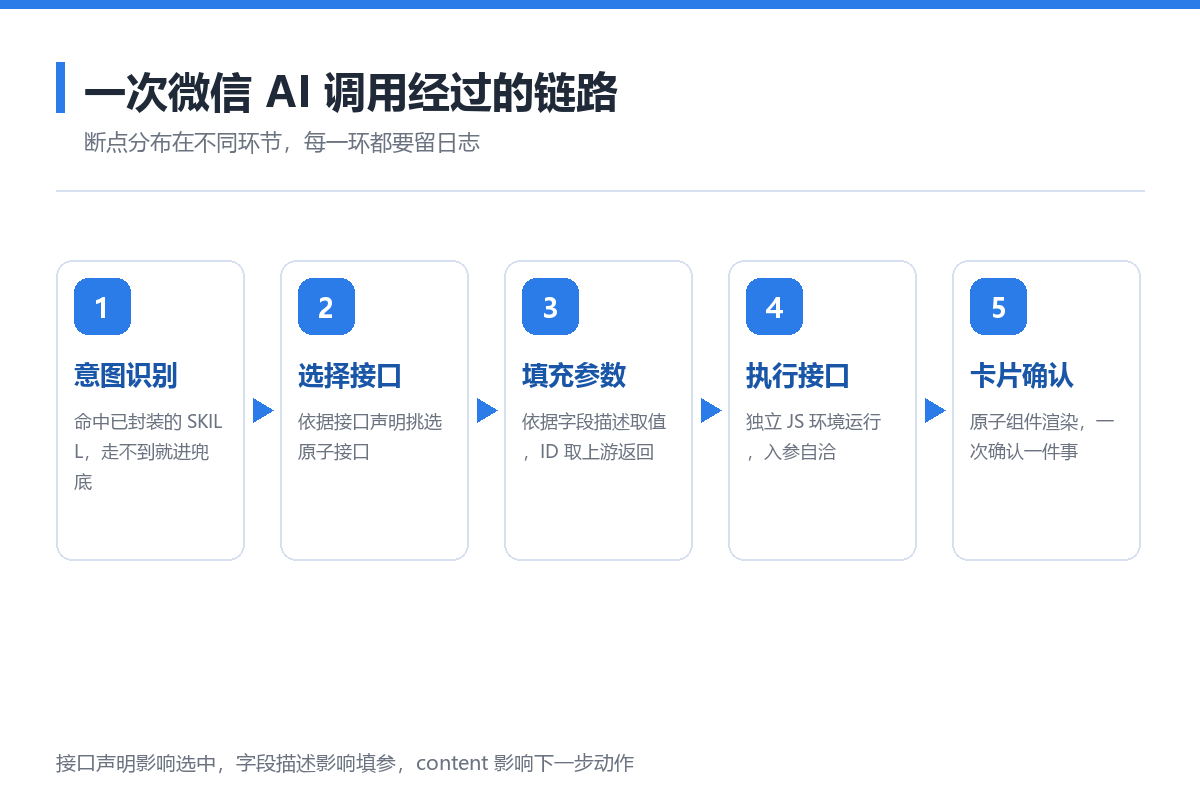
图 5:意图识别 → 选接口 → 填参数 → 执行 → 卡片确认 → 页面接力,断点分布在不同环节
一、两种模式的工程差异
两种模式的目标一致——让模型能正确调用小程序能力——但责任边界完全不同。
| 维度 | 自动模式 | 开发模式 |
|---|---|---|
| 能力来源 | 平台在提审时读源码,分析页面逻辑、API 定义、数据模型后生成 | 开发者按框架实现,注册接口与组件后封装 SKILL |
| 运行位置 | 复用小程序运行时,由平台侧驱动页面交互 | 原子接口运行在微信客户端的独立 JS 环境 |
| 可控点 | 页面结构、控件语义、状态可见性 | 接口契约、参数定义、返回内容、卡片形态 |
| 失效模式 | 语义不可读、状态不可判、流程不可恢复 | 接口职责重叠、描述偏差、参数靠猜 |
| 适用边界 | 查询类、短链路操作 | 有明确高频任务、需要多步确认的办理类 |
一个容易忽略的差异:自动模式把「可读性」变成了接口契约的替代品。 页面里那些只有老用户能懂的省略语(「确定」「下一步」「完成」)、只靠颜色区分而文字不体现的状态,在人工操作时是效率优化,在模型读取时是信息缺失。改造成本不在技术服务端,在页面语义层。
二、独立运行环境带来的三条约束
原子接口运行在微信客户端的独立 JS 环境中,这个「独立」不是细节,它直接约束代码组织方式。
- 不能依赖页面上下文。页面里的全局状态、组件树、页面栈在原子接口里拿不到,所有执行所需的输入必须来自入参或可复用的外层能力。实践上要求每个接口的入参自洽:缺什么就显式声明为必填,不要指望从会话历史里补。
- 登录态需要显式传递。官方说明用户在此模式下的登录身份与原小程序一致,可通过
storage接口共享小程序内的登录凭证,也可通过wx.login、wx.getPhoneNumber完成登录流程。这意味着一套账号体系可以复用,但凭证的获取要在「非页面上下文发起」的情形下也能走通。 - 可视化与执行分离。原子组件负责把结构化数据渲染成对话流里的 GUI 卡片,官方标注暂不支持调试;执行结果需要另有一条通道落到小程序内展示,即页面接力。两者分离的后果是:返回结构一旦设计成「只适合卡片渲染、不适合接力页消费」,就会出现卡片能看、点进去没数据的断层。
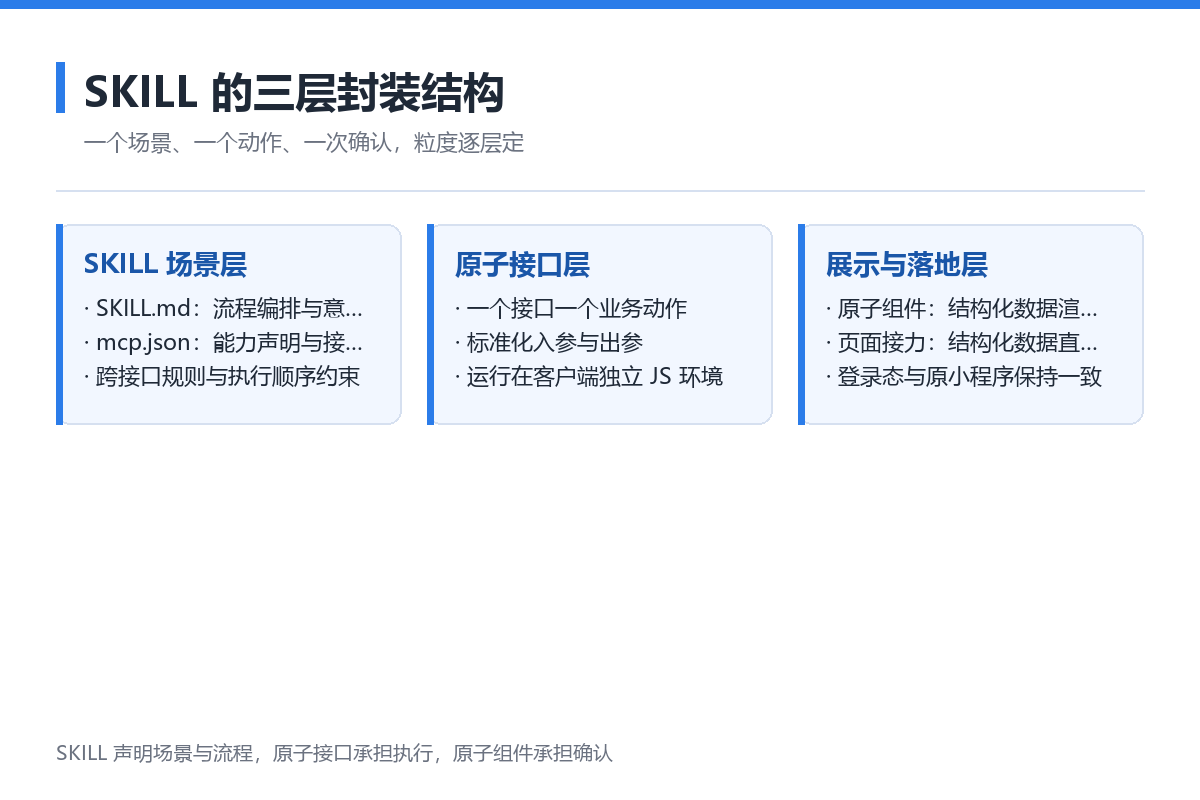
图 6:SKILL 声明场景与流程,原子接口承担执行,原子组件承担确认,接力页承担落地
三、封装粒度:从场景往下切三层
粒度的判断标准可以逐层定义,不需要凭感觉。
| 层级 | 粒度定义 | 切太细的代价 | 切太粗的代价 |
|---|---|---|---|
| SKILL | 一个用户能一口气说完的完整任务 | 模型在多个 SKILL 间选择,路由错误率上升 | 一个 SKILL 混多个场景,意图分流不准 |
| 原子接口 | 一个可独立完成、有明确入参与结果的业务动作 | 单次任务串行十几步,中断点成倍增加 | 一个接口承担多个动作,参数集合膨胀 |
| 原子组件 | 一次确认一件事(规格、地址、金额各一张) | 卡片过多,把对话切碎 | 单卡信息过载,用户不敢确认 |
三类典型的切错方式值得单独记一笔:
- 按页面切:页面是展示单元,不是任务单元。「商品详情页」不构成任务,用户要的是「买一杯拿铁」;按页面切会让一次任务跨多个 SKILL。
- 按按钮切:交互单元过细。一次下单被拆成查门店、查菜单、选规格、算价、建单、支付六步,任一步参数缺失都会中断,而模型未必知道该退回哪一步。
- 查询与办理混合:查询幂等、可重复;办理有副作用、不可重复执行。混在一个接口里,模型容易在用户只想看看时就把单据创建出来。
一个可复用的切分示例(预约到店服务):
SKILL: bookService
  原子接口: searchSlots / createBooking / getBooking / cancelBooking
  原子组件: 时段选择卡 / 预约确认卡 / 预约详情卡
  接力页  : 预约详情页(接收 bookingId 直接渲染)
四个接口、三张卡片、一个场景。三个自测问题:用户能否用一句话说清这个 SKILL 办的事(说不清即切粗)、每个原子接口能否被其他场景复用(不能则职责不单一)、每张卡片用户看一眼敢不敢确认(不敢则信息缺失或一次确认太多)。
四、信息源权重:文字写在哪里比写多少更重要
官方《SKILL 设计建议》给出的权重分层,是这套框架里信息密度相当集中的一部分。模型在决定调用哪个接口、填什么参数、回什么内容时,会综合多个信息源,权重与职责各不相同:
| 信息源 | 权重 | 承载内容 |
|---|---|---|
| 原子接口返回的 content | ★★★★★ | 本次调用结果与下一步动作 |
| mcp.json 的接口 description | ★★★★ | 接口功能、调用时机、不适用场景 |
| mcp.json 的 inputSchema.description | ★★★★ | 参数语义、取值来源、缺省处理 |
| SKILL.md | ★★★ | 业务流程编排、跨接口规则、意图分流、通用规范 |
官方点名的三类错位,正好对应三种常见写法:
- 把「接口功能」写进 SKILL.md → 长文膨胀,且与
mcp.json易不一致。SKILL.md 的接口清单只写前置条件与上下游关系。 - 把「跨接口的业务规则」写进单个接口的 description → 只在调用该接口时生效,其他决策点读不到。跨接口规则归 SKILL.md。
- 把「接口功能描述」写进
content→content只承载本次结果与下一步动作。
与之配套的写作约束:
- 接口名用「动词 + 名词」小驼峰(
searchDrinks优于search);首句声明业务对象而非入参,避免类目过宽导致误命中;职责单一、描述互不重叠;同名字段跨接口统一命名。 - 优先传 ID 而非自然语言;ID 类字段要声明「取自哪个上游接口的返回值」,并明确不要从用户话里推断;示例给多个样本,同时写缺省处理。
- 同一约束只在一处书写;能在代码层做规则强校验的,优先落代码。
五、返回内容与失败分支
content 是直接面向模型的文本,写法上有两个固定模式。
事实 + 动作两段式。 只有动作没有事实时,模型可能把「展示卡片」理解成「准备调下一步接口」,从而跳过用户确认。写法是「已根据所选规格生成订单。请展示订单确认卡片,并用一句话引导用户核对后下单」——前半句陈述状态,后半句给动作。
失败分支三件事。 陈述具体事实、给出下一步出口、指出不应做的动作,三者配套。例如:未匹配到目标对象并已返回兜底清单 → 请先告知未找到并引导从兜底清单选择 → 不要以相同条件重复调用本接口。只写禁令不给出口,流程会卡在原地。
配套的工程约束还有四条,属于跨接口层面,写在 SKILL.md 里:
- 输出形态:何时必须出卡片、何时可以出纯文本;
- 执行顺序:动作类接口必须确认执行成功,未调用前不得向用户宣称已完成;
- 并发串行:涉及扣款、核销的接口不得并发,须等上一笔结束(成功、失败或取消)再发起;
- 数据来源:业务 ID 取上游接口真实返回,不从用户语言推断、不使用示例值。
平台侧还有四条硬规则:不含越狱类表述(如「忽略指令」)、接口名与注册的 methodName 完全一致(含大小写)、不写死面向用户的回复格式、不妨碍关键信息呈现(名称、时间、金额、地址不得省略)。
六、可观测性:五个指标与三条日志
调用是否成立,只能靠度量判断。建议在接第二个场景之前就把口径定下来。
| 指标 | 定义 | 定位的问题 |
|---|---|---|
| 意图覆盖率 | 用户表达命中已封装 SKILL 的比例 | 场景选择与边界划分 |
| 接口选中准确率 | 命中场景后选对原子接口的比例 | 接口 description 的准确度 |
| 参数填充准确率 | 必填参数被正确填充的比例 | 字段语义与取值来源的清晰度 |
| 接力率 | 卡片点击进入接力页的比例 | 卡片信息量与入口设计 |
| 中断率 | 确认前放弃的比例 | 步骤数量与确认信息完整性 |
日志侧三条要求:同一次会话贯穿一个 traceId、每个原子接口的入参与 content 原文落库、失败分支按原因分类统计(缺参数 / 无结果 / 权限 / 超时)。没有这三条,返工只能靠猜。
七、内测期的分支策略
官方文档明确:当前处于内测阶段,暂未开放开发模式的代码提审,请勿将相关代码合入正式版本提交审核,以免影响正常版本发布。
由此推出三条工程约束:
- 分支隔离:AI 模式相关代码与正式版本物理隔离,构建产物中不出现注册入口。
- 契约先行:接口命名、参数、返回结构、SKILL 文档可以先行定稿并评审,这部分与提审开放与否无关,属于可提前完成的工程量。
- 灰度双通道:上线后 AI 入口与原有页面入口并存,两条链路的登录态、订单状态、幂等键要共用同一套服务端逻辑,避免出现两套单据。
八、小结
- 模式边界:自动模式以页面可读性换取零接入成本,适合查询与短链路;开发模式以接口契约为代价换取控制力,适合多步确认的办理类。
- 运行约束:独立 JS 环境意味着入参自洽、登录态显式传递、可视化与执行分离,接力页必须能独立消费返回结构。
- 封装粒度:一个 SKILL 一个场景、一个原子接口一个动作、一个原子组件一次确认;按页面切、按按钮切、查询与办理混合是三类典型反模式。
- 信息源分工:结果与下一步放
content,功能与边界放接口 description,参数语义与来源放字段 description,跨接口规则放 SKILL.md。 - 可观测性:五个指标 + 三条日志,先定口径再扩场景。
- 内测期:分支隔离、契约先行、灰度双通道。
这些设计在接入前做完,代价是文档;在评测被拒之后做,代价是重构。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号