#WorkBuddy# 200 MiB 大文件切成 64 片,合并后只剩 6.13% 是对的:一次流式切分与校验的完整实测
原创
#WorkBuddy# 200 MiB 大文件切成 64 片,合并后只剩 6.13% 是对的:一次流式切分与校验的完整实测
原创
用户12784192
发布于 2026-10-20 10:34:14
发布于 2026-10-20 10:34:14
上周我用 WorkBuddy 处理一个 200 MiB 的服务日志,任务是「切成 64 片、逐片上传、失败重试」。脚本三十秒跑完,日志一行报错都没有,我也就认为它成功了。直到运维同学问了一句「合并回来的文件为什么打不开」,我才去做了逐字节对比——209,716,782 字节里,有 196,870,630 字节是错位的,占 93.87%。换句话说,整个流程里唯一"正确"的部分是文件大小:分毫不差。
这件事让我把「大文件切分与校验」当成一个独立课题重做了一遍。下面所有数字都来自本机一次真实运行,语料、脚本、损坏注入方式全部可复现。
一、问题不在"切",而在三个被忽略的前提
我把那次失败拆开复盘,发现三个错误是叠加的,任何一个单独出现都足以毁掉结果。
第一,定长切分与字符编码不兼容。 我用的是 size // 64 的定长切分,切点必然随机落在 UTF-8 多字节序列中间。200 MiB 语料里有 2,207 万个 3 字节汉字字符,切点撞上它们的概率远高于直觉。
第二,文件名没做零填充,排序即错序。 part_0.log 到 part_63.log 用 sorted() 排出来是 part_0, part_1, part_10, part_11 ... part_2。这一步不会报错,只会让合并结果变成一锅乱序。
第三,校验只比了 os.path.getsize**。** 只比大小意味着:只要字节数对,内容错成什么样都算"通过"。而现实里的磁盘位翻转、传输截断、代理改写,恰恰大量是等长的。
三者叠加的结果就是:体积校验 100% 通过,内容 6.13% 正确。
二、先量化,再动手
我合成了一份与真实业务无关的测试语料,避免拿老板的真实数据说事:
项目 | 实测值 |
|---|---|
主文件 |
|
行数 | 1,615,552 行,平均行长 128.81 字节 |
最长单行 | 7.58 MiB(无换行的堆栈 dump / base64 载荷) |
多字节字符 | 22,073,240 个(3 字节 22,057,033 / 4 字节 16,207) |
陪跑文件 |
|
基线指纹 | SHA-256 与 MD5 均已记录在 |
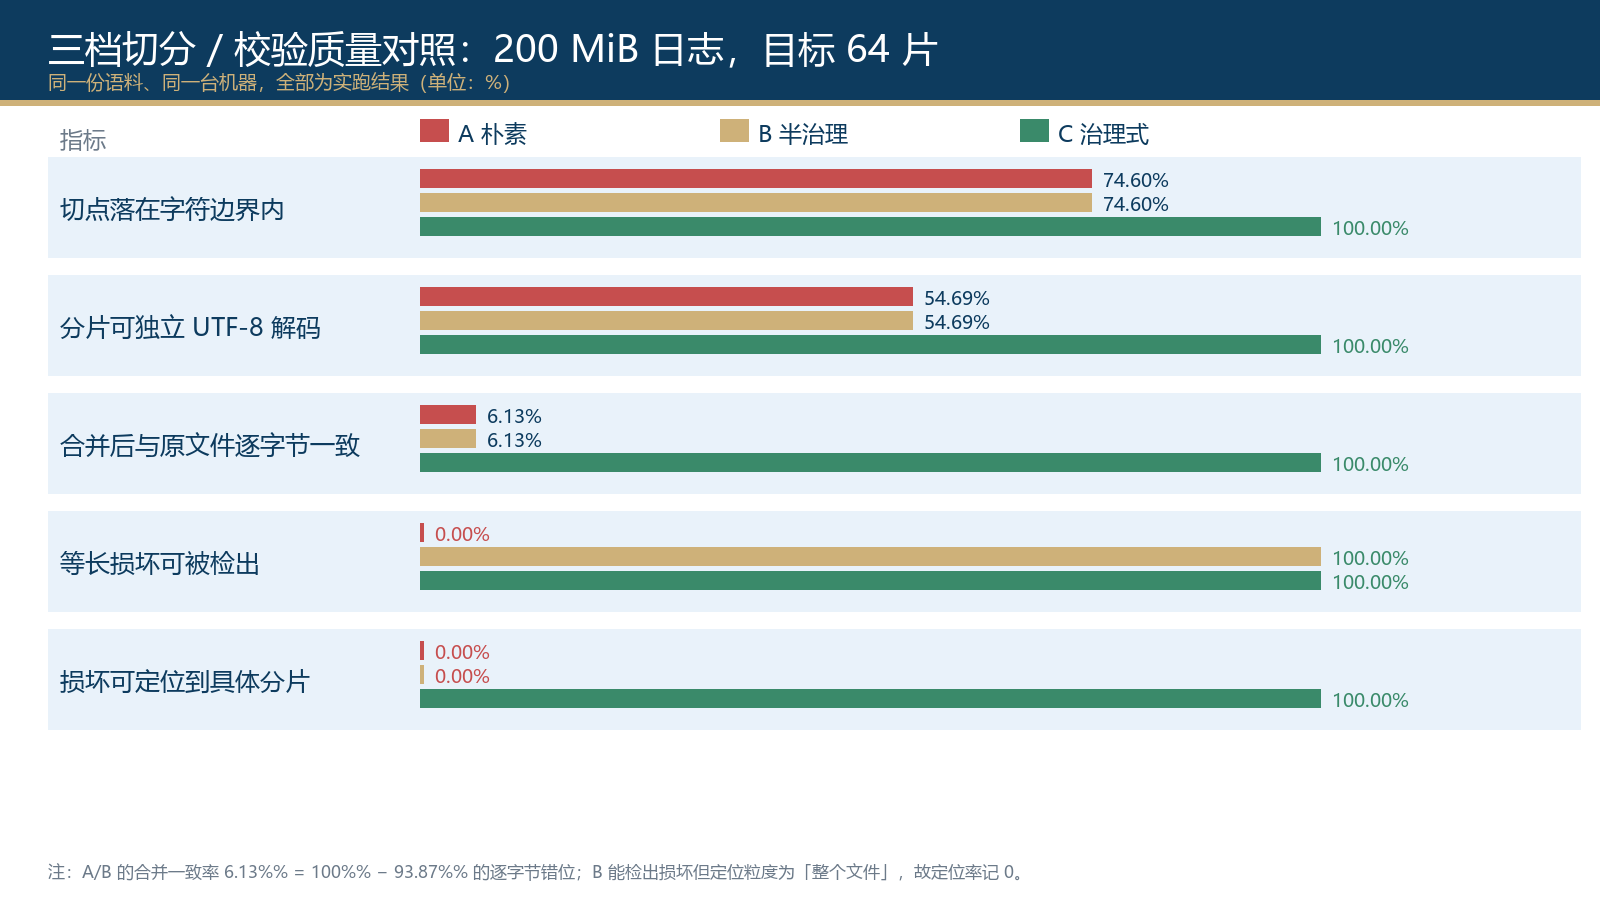
图上五行指标,就是这次要守住的五条线:字符边界、分片可独立解码、合并逐字节一致、损坏可检出、损坏可定位。
三、三档实现,同一份语料跑出来的真实差距
我写了两套切分器、三种校验策略,让它们在完全相同的语料上跑。
A 档:朴素写法
f.seek(i*chunk) + 定长读 → 每片直接 write_bytes;校验只比 getsize。
B 档:半治理
保留了定长切分,只把校验换成流式哈希(4 MiB 分块喂 hashlib)。很多人以为"换成流式就对了",这是最常见的认知偏差。
C 档:治理式
三件事一起做:
- 行边界对齐切分:优先向前对齐到下一个换行,对齐后超出单片硬上限则回退到片内最后一个换行;
- UTF-8 字符边界兜底:硬上限强切时,若切点落在续字节(
10xxxxxx)上,向前回退最多 3 字节; - 分片清单(manifest):每片记录
offset / bytes / sha256 / continued,校验与续传都基于清单。
核心切分逻辑只有二十来行:
def split_aligned(path, out, parts, hard_cap, target=None):
    """行边界对齐切分:向前对齐 -> 回退到片内行尾 -> 硬上限强切并回退字符边界"""
    size = os.path.getsize(path)
    if target is None:
        target = max(1, (size + parts - 1) // parts)
    man = []
    with open(path, "rb") as f:
        start, idx = 0, 0
        while start < size:
            pref = min(start + target, size)
            if pref >= size:
                end, cont = size, False
            else:
                f.seek(pref)
                win = f.read(65536)
                nl = win.find(b"\n")
                if nl >= 0 and (pref + nl + 1 - start) <= hard_cap:
                    end, cont = pref + nl + 1, False          # 向前对齐成功
                else:
                    f.seek(start)
                    nb = f.read(pref - start).rfind(b"\n")
                    if nb > 0 and (nb + 1) <= hard_cap:
                        end, cont = start + nb + 1, False      # 回退到片内最后一个行尾
                    else:
                        end, cont = min(start + hard_cap, size), True   # 硬上限强切
                        step = 0
                        while end > start + 1 and step < 3:    # 回退到 UTF-8 字符边界
                            f.seek(end)
                            c = f.read(1)
                            if c and (c[0] & 0xC0) == 0x80:
                                end -= 1; step += 1
                            else:
                                break
            f.seek(start)
            blob = f.read(end - start)
            name = "part_%03d.log" % idx                        # 零填充,字典序即顺序
            (out / name).write_bytes(blob)
            man.append({"offset": start, "bytes": len(blob),
                        "sha256": hashlib.sha256(blob).hexdigest(),
                        "continued": cont})
            idx += 1
            start = end
    return man
校验侧用流式哈希,块大小取 256 KiB——这不是拍脑袋,第四节的实测数据会说为什么。
def sha256_file(p, chunk=256 * 1024):
    h = hashlib.sha256()
    with open(p, "rb") as f:
        for b in iter(lambda: f.read(chunk), b""):
            h.update(b)
    return h.hexdigest()
真实结果:五条线,全部命中
指标 | A 朴素 | B 半治理 | C 治理式 |
|---|---|---|---|
切点落在字符边界内 | 74.60% | 74.60% | 100.00% |
分片可独立 UTF-8 解码 | 54.69%(35/64) | 54.69%(35/64) | 100.00%(69/69) |
合并后与原文件逐字节一致 | 6.13% | 6.13% | 100.00%(差异 0 字节) |
等长损坏可被检出 | 0 / 8 | 8 / 8 | 8 / 8 |
损坏可定位到具体分片 | 0 / 8 | 0 / 8 | 8 / 8(100%) |
几处容易被忽略的细节,都是实测出来的:
- A 档 63 个切点里有 16 个(25.40%)落在多字节序列中间,直接导致 29/64 片无法用严格 UTF-8 解码;
- A 档定长切分还静默丢了末尾 46 字节余数,而只比大小的校验对此完全无感;
- A 档的文件名无零填充,65 个分片里 63 个位置错位(96.92%),合并后大小分毫不差,
size校验"通过",但逐字节差异 93.87%——这就是我第一次失败的全部原因; - C 档因为行对齐,实际切出 69 片而不是 64 片,单片 min 0.487 / max 3.125 / mean 2.899 MiB,8 处续接标记对应 12 条超长行的强切,全部合并后 SHA-256 与基线一致、逐字节差异 0。
四、分块大小不是越大越好,也不是越小越好
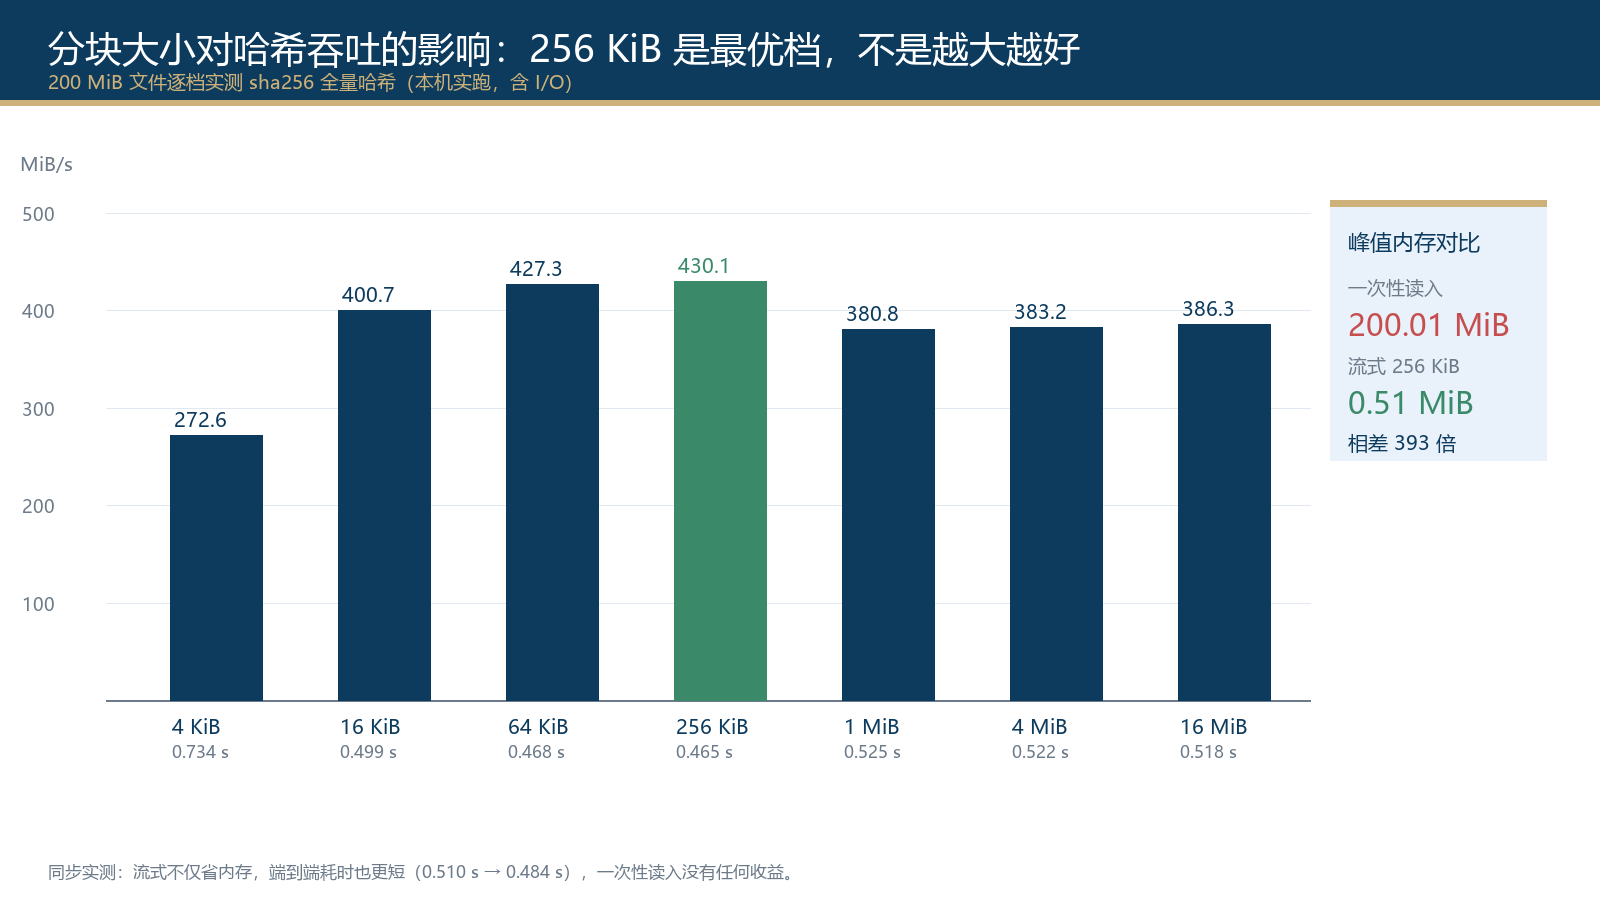
「流式」这个词经常被简化成"随便设个 8 KB 就行"。我把 4 KiB 到 16 MiB 七档逐一跑了一遍全量 SHA-256:
分块 | 读次数 | 耗时 | 吞吐 |
|---|---|---|---|
4 KiB | 51,201 | 0.734 s | 272.6 MiB/s |
16 KiB | 12,801 | 0.499 s | 400.7 MiB/s |
64 KiB | 3,201 | 0.468 s | 427.3 MiB/s |
256 KiB | 801 | 0.465 s | 430.1 MiB/s |
1 MiB | 201 | 0.525 s | 380.8 MiB/s |
4 MiB | 51 | 0.522 s | 383.2 MiB/s |
16 MiB | 13 | 0.518 s | 386.3 MiB/s |
结论是钟形曲线:256 KiB 是本机最优档(430.1 MiB/s),而 4 KiB 只有 272.6 MiB/s,慢了 36.6%。原因是 4 KiB 时系统调用次数暴涨到 51,201 次,开销全花在进出内核态;而超过 1 MiB 之后,缓冲区超出 CPU 缓存容量,吞吐反而回落到 380 MiB/s 上下。
同一批测试里还有两个数字值得记住:
- 一次性
f.read()的峰值内存是 200.01 MiB,RSS 直接涨 200.03 MiB;改成 256 KiB 流式后峰值 0.51 MiB,相差 393 倍; - 更反直觉的是,流式在速度上也更快:端到端 0.510 s → 0.484 s。一次性读入并没有换来任何性能收益,它只是把内存压力堆到了峰值。
还有一个坑:用 for line in f 逐行读看起来最省内存,但遇到 12 条无换行的超长行时,Python 必须把整行攒完才交付——实测峰值 30.38 MiB,而且 1,615,552 行耗时 37.75 秒,比流式哈希慢了近 78 倍。按行读适合做内容解析,绝不适合做完整性校验。
五、校验的取舍:多花 0.080 秒,少传 175 MiB
损坏注入方式:在 8 个不同分片的中点,把一个 ASCII 数字替换成另一个数字。体积完全不变,且仍是合法 UTF-8——这是最贴近真实磁盘位翻转的损坏形态。
策略 | 检出 | 定位粒度 | 修复需重传 | 耗时 |
|---|---|---|---|---|
只比 | 0 / 8 | 无 | 200.00 MiB(100%) | 0.0001 s |
全文件 MD5 | 8 / 8 | 整个文件 | 200.00 MiB(100%) | 0.444 s |
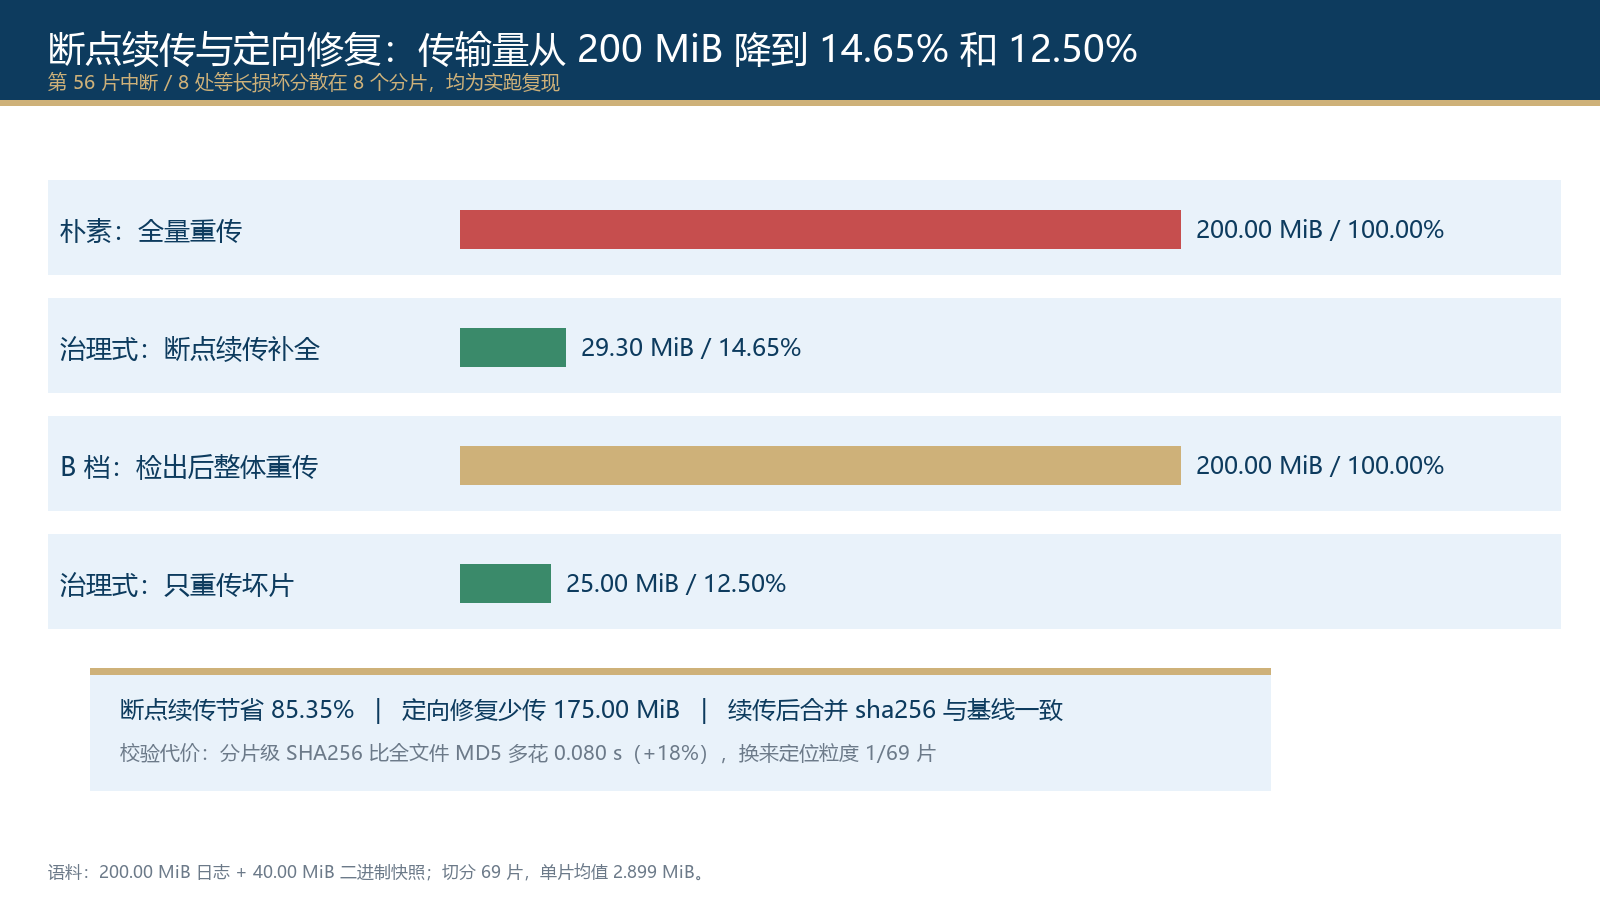
分片 SHA-256 | 8 / 8 | 1 / 69 片 | 25.00 MiB(12.50%) | 0.524 s |
分片级校验比全文件 MD5 多花 0.080 秒(+18%),换来的是修复传输量从 100% 降到 12.50%——在弱网或跨机房场景下,这笔交易几乎没有犹豫的余地。
断点续传同理。我模拟在第 56 片中断:已落盘 56/69 片、170.70 MiB(85.35%),恢复时逐片比对清单、只补 13 片 29.30 MiB(14.65%),耗时 0.521 秒,续传后合并的 SHA-256 与基线一致。相比全量重传,省下 85.35% 的传输量。
六、踩坑清单(都是我这次真踩的)
- 合成语料自己先坏了。 第一版生成器按字节长度截断 UTF-8 字符串,产生了一个非法字符,
for line in f直接抛UnicodeDecodeError。教训:造测试数据前先自检strict解码,否则你测的是自己的 bug,不是被测对象的 bug。 - 硬上限强切会切断字符。 我在补测「目标片 6.25 MiB > 硬上限 4 MiB」时,强切后 19/52 片解不开。加了"回退到 UTF-8 字符边界"的循环后,同一场景 52/52 全部可解码,合并 SHA-256 一致。
- 末片天然超限。 同一场景下末片 4.211 MiB 大于 4 MiB 的硬上限——因为末片吸收全部余数。判断"是否严格执行上限"时必须排除末片,否则会误判实现有 bug。
- 行对齐后片数一定多于目标片数。 我要求 64 片,实际得到 69 片。调用方如果强依赖"片数 == N",会挂。正确做法是只保证片数上界与单片上限,片数由内容决定。
size // N会丢余数。 46 字节在 200 MiB 里看似无所谓,但它丢掉的是文件末尾,可能是最后一条日志、可能是 zip 的中央目录。用min(chunk, size - pos)读最后一片。sorted()不等于自然序。 文件名必须part_%03d零填充,或用 manifest 的offset排序,不要依赖文件系统返回顺序。- 等长损坏是校验设计的试金石。 只比 size 的脚本对截断有效、对等长篡改完全失明。设计任何"校验"前,先问一句:我的校验器能不能发现一个字节变了但没有变长?
七、给 WorkBuddy 的提示词模板
我把这次的流程固化成了可复用的提示词,直接贴给 WorkBuddy 即可:
# 角色:文件流水线工程师。禁止用"看起来成功"代替校验。
# 任务:把 <输入路径> 切成 <= <单片上限> 的片,写入 <输出目录>,生成 manifest.json。
# 硬性要求:
# 1) 全程流式,单次缓冲 256 KiB,禁止 f.read() 无参读取;
# 2) 切分按行边界对齐;触达硬上限时强切,但必须回退到 UTF-8 字符边界;
#    (续字节判定: (b & 0xC0) == 0x80)
# 3) 文件名零填充 part_%03d;manifest 记录 offset/bytes/sha256/continued;
# 4) 合并后必须与源文件逐字节比对(分块比较, 计数差异字节),并输出 sha256;
# 5) 自检:每片单独 utf-8 strict 解码,报告成功/失败片数;
# 6) 输出真实指标:片数、min/max/mean 片大小、切点落在字符中间的数量。
# 交付:先给指标表,再给结论一句话。不要臆造数字,所有数必须来自本次实跑。关键在第 4、6 条:要求它输出「差异字节数」而不是"校验通过",要求它输出「切点落在字符中间的个数」——一旦这个数不是 0,问题就暴露了。模棱两可的验收标准,只会养出模棱两可的结果。
八、这套东西真正省下的时间
回到最初那 200 MiB 日志:A 档方案 0.47 秒切完,看起来漂亮;但它产出的 64 个分片里有 29 片无法解码、合并后 93.87% 错位,你还得从头排查、重做、再对一遍哈希。C 档多花了 0.39 秒的切分时间(0.47 → 0.86 s),却让后续所有环节——校验、定位、续传、修复——都变成确定性的。
在文件流水线里,"快"从来不是切分速度,而是"一次就对"的概率。
对每天要处理几十上百个导出文件的人来说,这套清单的价值不在代码本身,而在于四个动作:流式读、按行切、逐个哈希、合并再比一遍。四个动作加起来不到 40 行代码,挡住的是那 93.87%。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号