【科普】100 万块 GPU 一起干活,怎么才能不“罢工”?
原创
【科普】100 万块 GPU 一起干活,怎么才能不“罢工”?
原创
了不起的云计算
发布于 2026-10-20 11:39:26
发布于 2026-10-20 11:39:26
各位小伙伴,好哈!
好久不写技术文章了,最近有点时间,想跟大家聊聊AI超算集群中GPU是如何协作分工合作的。
我们就以Meta Prometheus数据中心为例,来聊聊这个数据中心中100万块GPU是怎么工作的。
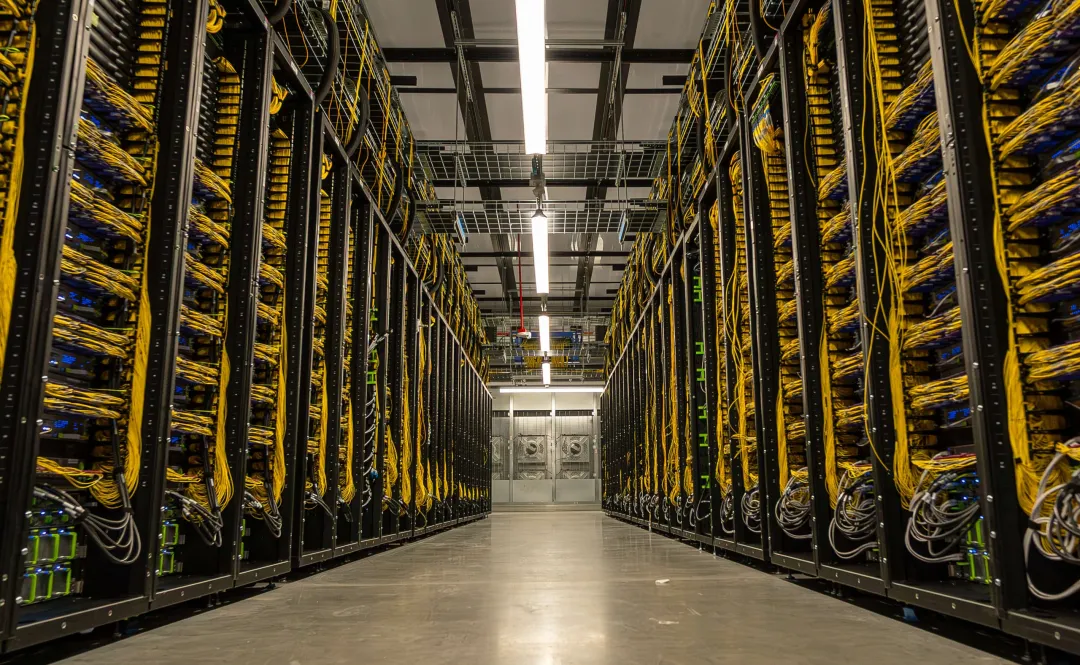
Meta Prometheus supercluster cold aisle in New Albany, Ohio, with racks of yellow fiber cabling on both sides
好的,下面我们就正式开始。
一、持续工作是AI超级集群的核心挑战
首先,我们来了解下Meta Prometheus集群!
Prometheus是Meta在俄亥俄州纽奥尔巴尼(New Albany)建设的吉瓦级 AI 超算集群。目前,该集群的第一阶段已完工,并已用于训练Muse系列基础模型(包括 Muse Wonder 模型)。Meta表示,该站点正朝着约100万块GPU的规模扩展。
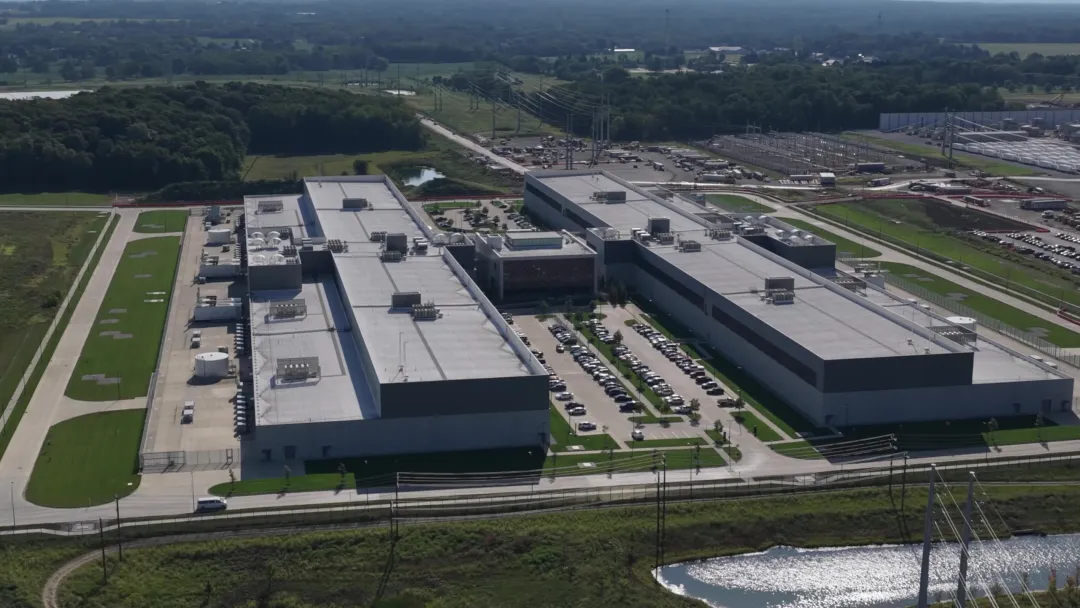
Aerial view of Meta's New Albany, Ohio data center campus that houses the Prometheus supercluster
想象一下,100万块GPU同时工作,这个复杂程度可想而知。就像你雇了100万个工人同时做一道数学题,要求他们每秒钟都要同步交换计算结果。但只要其中一个人打瞌睡、算错数,或者传纸条时手抖了一下,整个项目就得推倒重来。这是Prometheus超算集群每天都在面对的挑战。
因此,在这里,硬件堆砌只是最基础的部分——真正的技术难关,在于如何让这100万块“娇气”的芯片24小时不间断地协同工作。
二、为了算力,需要把72块GPU装进一个“超级大脑”
传统服务器像是一个个独立的小房间,每间房住8块GPU,彼此用网线连接。但现代AI模型太大,8块GPU根本不够用,数据传输的“网线”反而成了瓶颈。
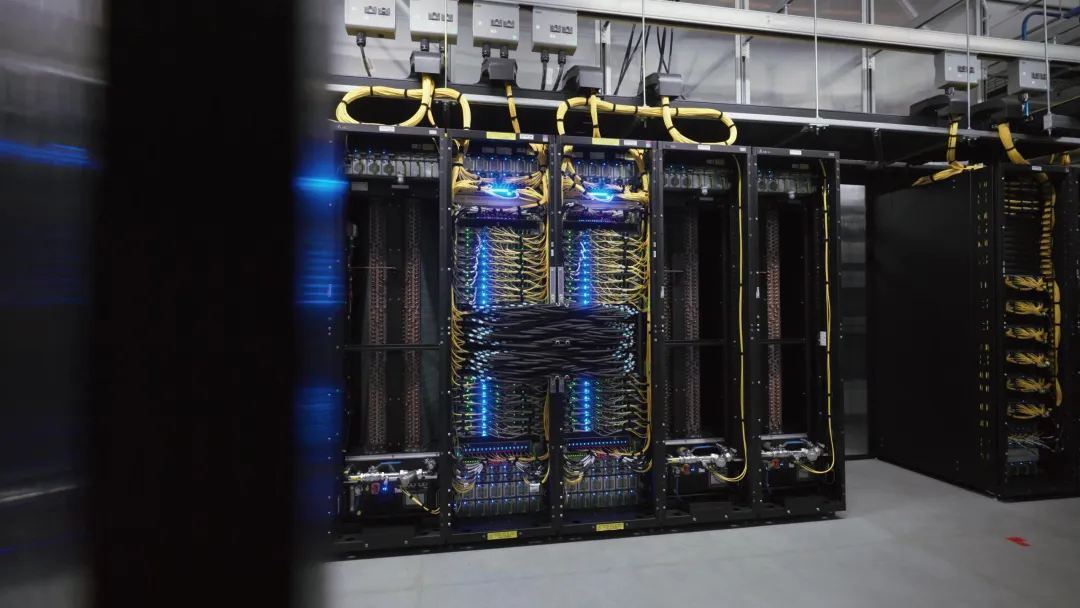
Meta Prometheus Catalina platform: a two-rack NVIDIA GB200 NVL72 Ariel pair with NVLink cable spine between the racks
最新的解决方案叫做NVL72架构,相当于把72块GPU装进一个“超级大脑”。这些GPU不再通过外部网线,而是通过一种叫做NVLink的“高速神经束”直接相连,带宽达到130TB/s——相当于每秒能传完3万部高清电影。在这个架构里,72块GPU就像一块巨大的芯片一样协同工作。
目前Meta这个集群里正跑着两代“超级大脑”:
第一代叫Catalina,使用GB200芯片,每块GPU配备192GB高速显存(HBM3e),两个机架组成一组,功耗高达120千瓦(相当于120台家用空调同时制热)。每块GPU还搭配了一颗Grace CPU和两块ConnectX-7 400G网卡,确保数据进出顺畅。
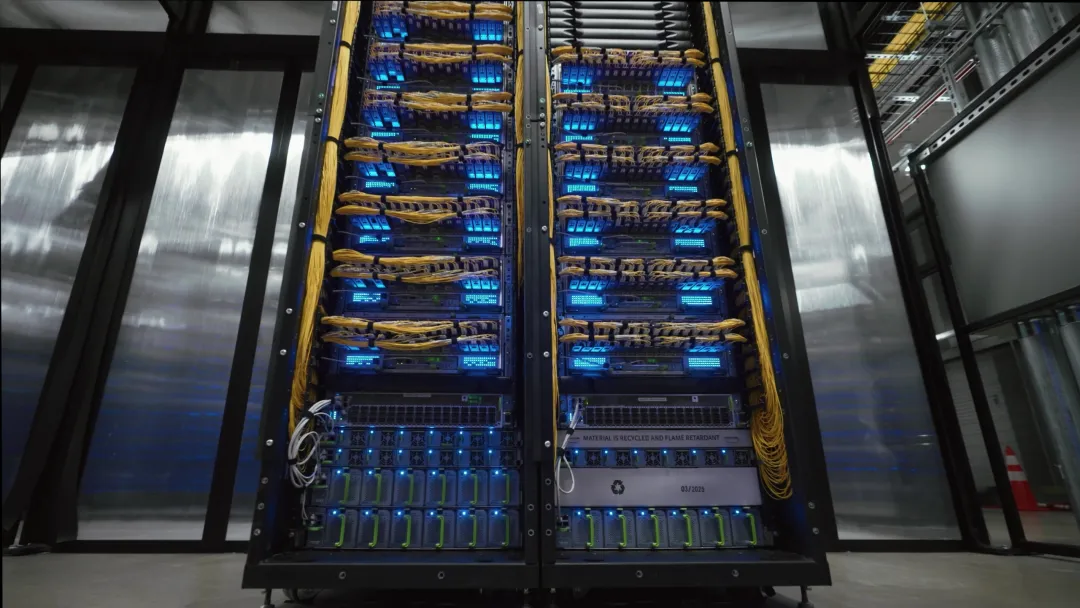
Meta Prometheus Clemente platform: a single-rack NVIDIA GB300 NVL72 with 72 GPUs in one NVLink domain
第二代叫Clemente,升级到GB300芯片,显存增至288GB,性能提升10%,而且72块GPU能塞进一个机架。它采用了更新的ConnectX-8 SuperNIC网卡,原生支持800G高速网络。
明年还将接入第三代San Miguel,使用更新的Vera Rubin芯片,单架功耗将突破170千瓦,显存带宽和计算能力将再翻一倍。
但把这么多芯片绑在一起也有副作用:一旦其中一块坏了,影响的不是8块,而是整个72块的“超级大脑”。这就像把鸡蛋放在同一个篮子里,篮子越大,摔一次的损失越惨重。
三、为了稳定,每72块GPU,只让64块干活
面对这个难题,工程师想出了一个反直觉的策略:故意让8块GPU“偷懒”。
在每个72块的“超级大脑”里,实际上只有64块GPU承担计算任务,剩下8块作为“替补队员”随时待命。一旦某块GPU出现故障,替补立即顶上,训练任务从最近的“存档点”继续,而不需要停机维修。这种设计叫做“64/72切片策略”,虽然看起来浪费了11%的算力,但实际上大幅减少了停机时间。
对于整个机架都损坏的极端情况,Meta还额外准备了2%的备用机架。如果要启动一个需要32,768块GPU的训练任务,实际上要占用523个机架(共37,656块GPU),多出来的13%就是用来“兜底”的。
四、不仅如此,还要给100万块GPU做“心电图”
即使有了替补机制,故障依然会发生。
最棘手的是信号问题:一个NVL72“超级大脑”内部有5,184条高速信号线,每条线以200Gbps的速度传输数据。哪怕只有一条线接触不良,整个系统就会频繁“卡壳”。
为了解决这个问题,工程师给集群装上了“心电图监测仪”——持续收集每一条链路的信号质量数据。一旦发现某条链路“心律不齐”(信号衰减),就在它彻底罢工前主动更换。芯片的固件(内置软件)也可以像手机系统更新一样,在几小时内推送到10万块GPU上,快速修复已知的bug。
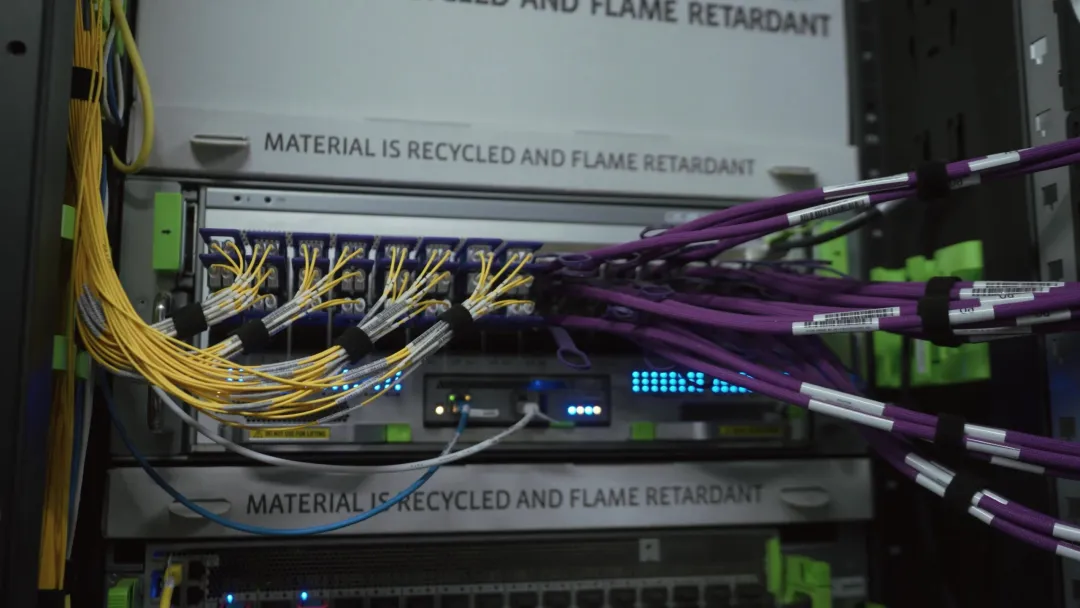
Close-up of a Meta Prometheus switch with yellow fiber and purple cable bundles
这些措施的效果惊人:2025年中期,这个集群每天每8000块GPU要发生近1000次故障;一年后,故障率下降了99%。现在,平均每10万个GPU小时才会发生一次中断,训练效率从85%提升到了90%以上。
五、跨越楼房的“信息高速公路”
100万块GPU不可能装在同一个房间里,它们分布在多栋建筑中。这就带来了另一个物理难题:光纤速度是有限的。电信号在光纤中传输,每公里需要5微秒,对于需要频繁同步的AI训练来说,这个延迟不可忽视。
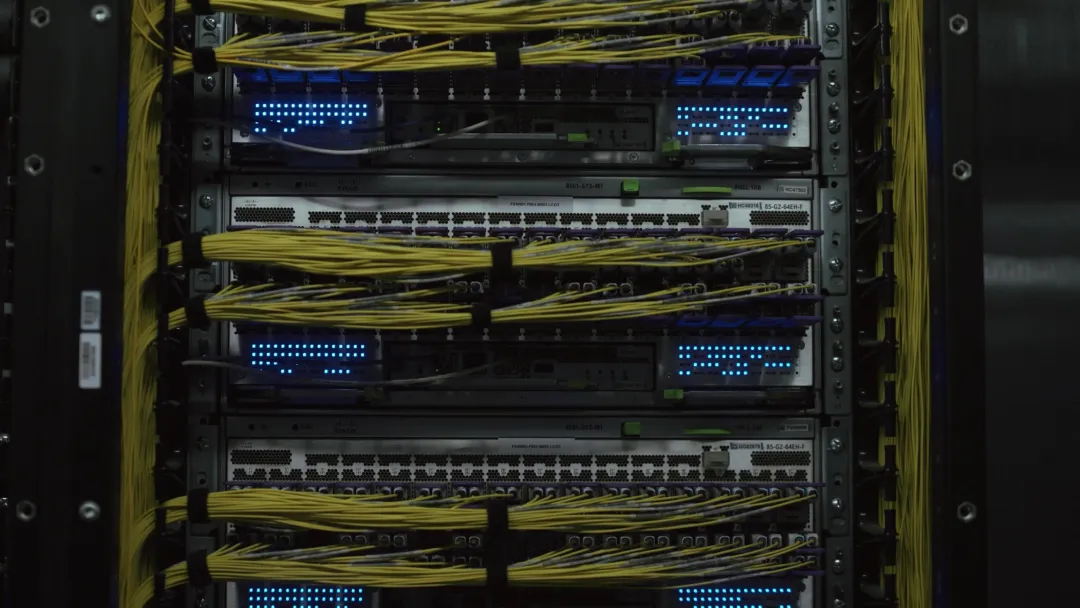
Ethernet fabric switches in a Meta Prometheus network rack with fiber bundles to each port
Meta的解决方案是“分层交通系统”:
楼内高速:每栋建筑容纳约2万块GPU,内部使用短距离光纤,保证延迟极低,处理需要频繁同步的计算任务。
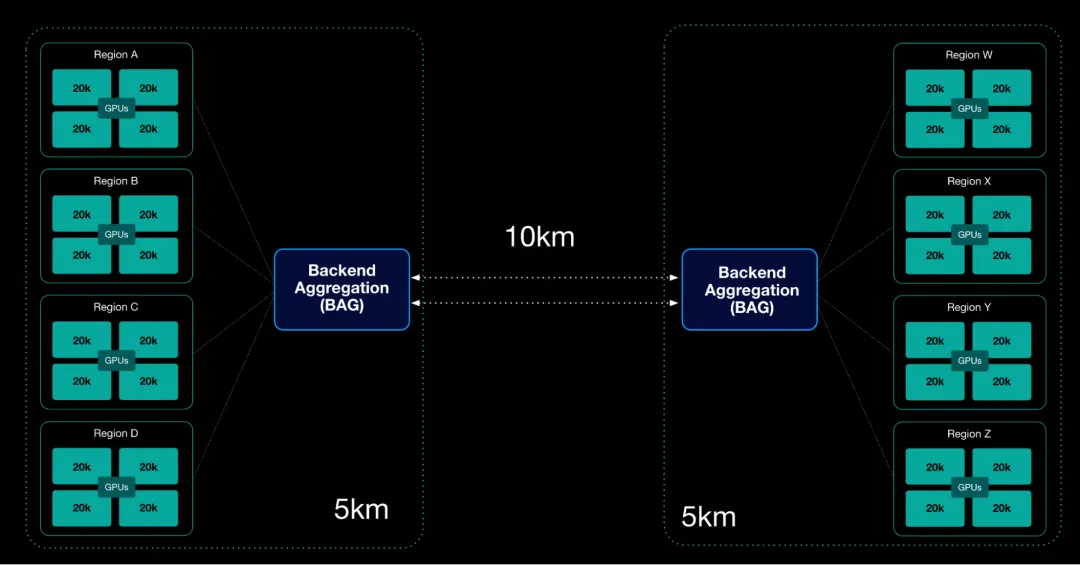
Meta diagram of the Prometheus Backend Aggregation (BAG) network linking 20K-GPU regions across 5km and 10km spans
城际干线:楼与楼之间通过专用“Backend Aggregation”网络连接,使用800G-ZR相干光模块,跨越2公里到100公里的距离,传输对延迟不敏感的数据。
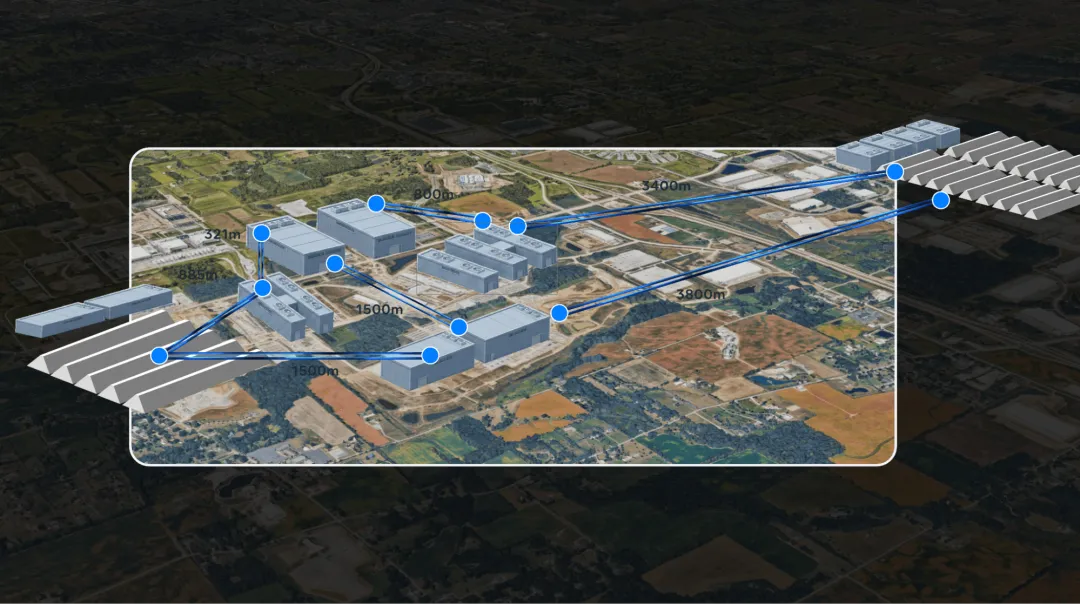
Meta map of the New Albany campus showing fiber runs between Prometheus buildings from 321m to 3,800m
这就像城市规划:市区内修地铁(高速低延迟),城市间修高铁(大容量但稍慢)。整个园区铺设了数百万英里的光纤,使用了数万台交换机和数百万个光模块。
六、驯服“电力巨兽”
最危险的时刻往往发生在“开始”和“停止”的瞬间。当数万块GPU同时从休眠状态切换到全速计算状态时,功耗会在几秒内飙升30%-40%,相当于瞬间多出几十兆瓦的电力需求——足以让电网过载跳闸。
为了平滑这种波动,Meta开发了一套叫做Dynamo Dimmer的“电力油门”系统。当集群接近供电上限时,系统会自动降低GPU的功率,就像开车时松开油门一样。同时,每个机架都配备了电池组,像“电力海绵”一样吸收瞬间的功率尖峰;整个园区还有大规模的储能电站作为后盾。
散热也是个大问题。老建筑使用“风冷+液冷”混合模式,新建筑则采用全液冷——把服务器直接泡在冷却液里。Meta甚至开源了他们的液冷机架设计,供整个行业参考。
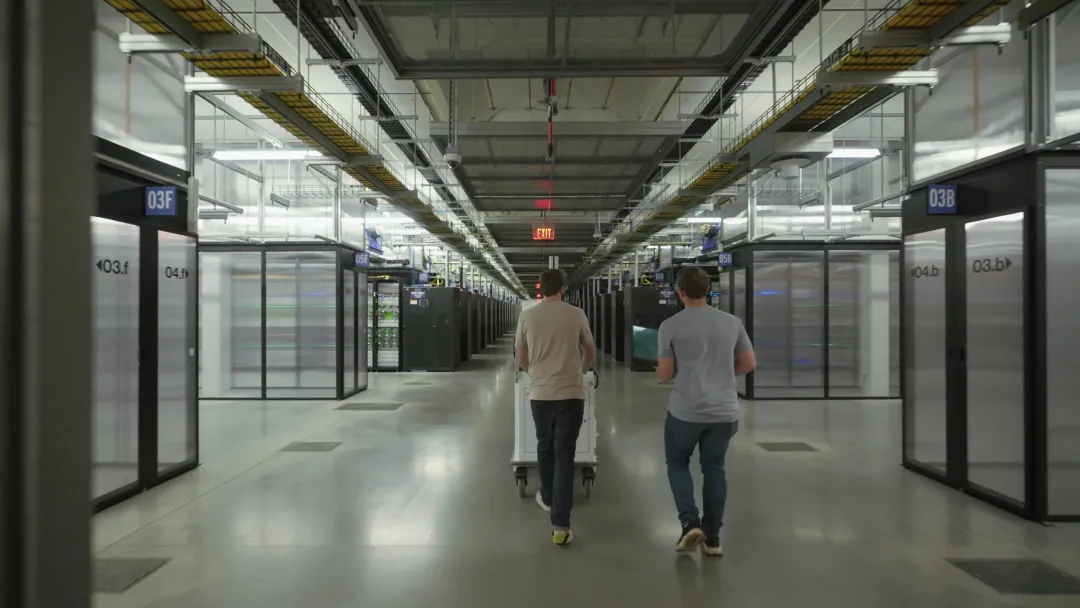
Technicians walking a corridor between data halls at Meta's Prometheus site in New Albany
七、下一代:从零开始设计“完美集群”
Prometheus的成功经验正在被应用到Meta的下一代集群Hyperion中。这个项目位于路易斯安那州里奇兰教区(Richland Parish),将从零开始设计,采用全液冷散热、与电网深度耦合,并针对百万卡规模优化网络架构。
从Prometheus的实践可以看出,未来的AI竞争不只是芯片数量的比拼,更是系统工程能力的较量。当GPU数量达到百万级,真正的技术壁垒在于:如何设计一个能自我诊断、自我修复、且不会把电网拖垮的庞大系统。
这100万块GPU背后,藏着的是一整套精密的工程哲学——不是如何让机器跑得更快,而是如何让它永不停歇。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号