REWS核心模块(二):检索、回溯与审计分析
原创
REWS核心模块(二):检索、回溯与审计分析
原创
慧贝行
发布于 2026-10-20 14:20:54
发布于 2026-10-20 14:20:54
一、上线之后要回答的问题
近期一所高校的运维工程师提到:一台终端被上级通报异常外联,用原有设备查阅两天日志才勉强圈出大致范围。他随即问,换成网络流量审计与分析系统(REWS),定位同一问题要多久?
这背后实际上有三个考量:
1、是否留存:留的是网络行为,不是告警结果。很多全流量产品只是拿规则库去匹配,命中才记一条。规则没覆盖的、当时没告警的行为就丢了。事后审计、溯源、排查,缺的往往正是这些“没告警”的数据。所以该留的是会话、DNS、TLS 等完整行为记录,而不是筛选后的告警。
2、是否存得下:靠元数据,不靠原始报文。原始报文全量存最全,但存储、备份、迁移成本高,人少很难长期维护。把五元组、时间、流量大小、域名、TLS 指纹等结构化字段存下来,既够查,也能把留存周期真正做扎实。
3、是否方便检索:要能多条件组合查,不是看固定报表。实际排查通常要按时间、IP、协议、域名、端口等条件逐步收窄。如果只能看固定表格,或者导出后人工翻,效率和翻日志差不多。能组合检索,才能快速定位到具体会话。
这样三个考量对应的就不是设备参数,而是数据全不全、扛不扛得住、查不查得动。
REWS的检索、回溯与审计分析模块,解决的正是数据落盘之后如何用的问题。
REWS核心模块(二):检索、回溯与审计分析
二、检索:数据按字段查
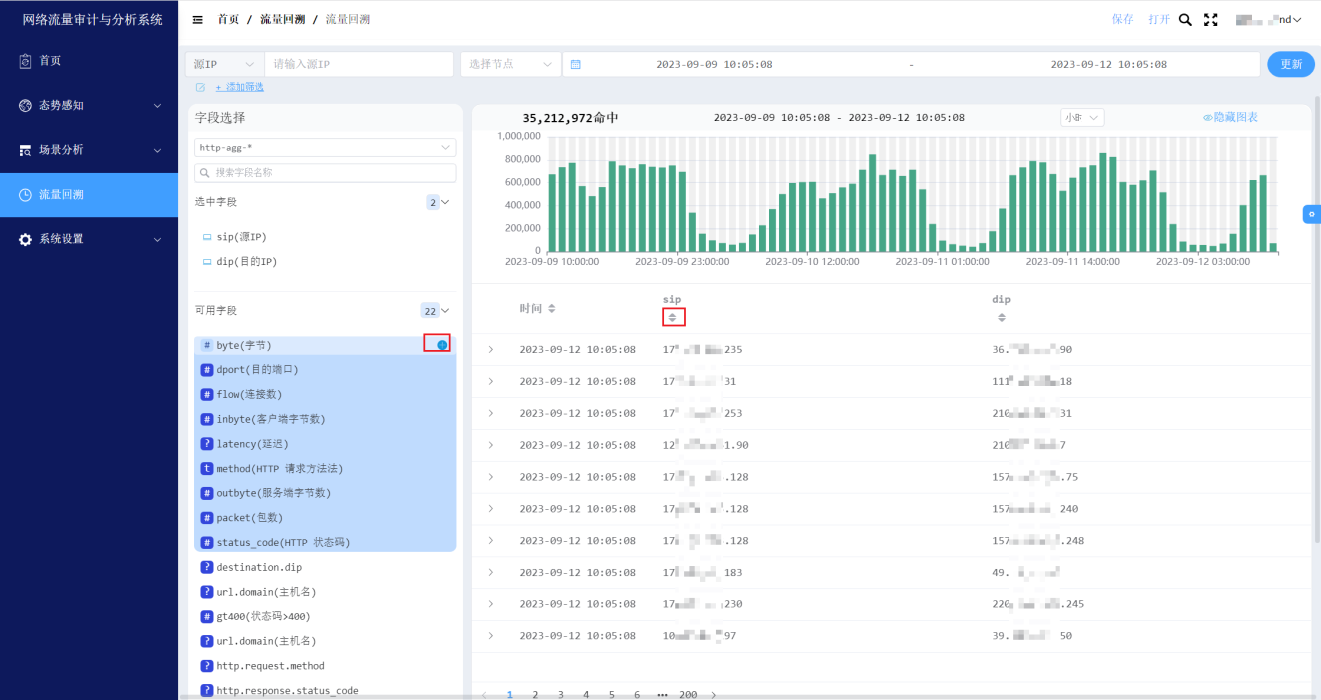
REWS在采集入口完成二至七层协议解析,落盘按维度切分的聚合索引,索引名即业务含义:TCP会话归入tcp-agg-,HTTP会话归入http-agg-,告警事件归入alert-*(agg即aggregate)。查询时选定索引与字段,多条件以AND、OR、NOT组合。查主机访问过的443端口写sip:192.168.1.92 AND dport:443;查网段用区间写法如sip:10.40.2.0 TO 10.40.2.255;确认是否访问某域名则切到http-agg-*按url.domain过滤。
REWS核心模块(二):检索、回溯与审计分析
这类检索与多数现有方案的差别在数据形态。报文级检索需按顺序扫描报文文件再解析,如同逐帧翻查录像;元数据检索按字段索引匹配,命中即返回会话记录,不触碰原始报文。REWS在10Gbps流量下满足六个月留存的磁盘不超过20T,存储可控。
三、回溯:把分散阶段串成一条时间线
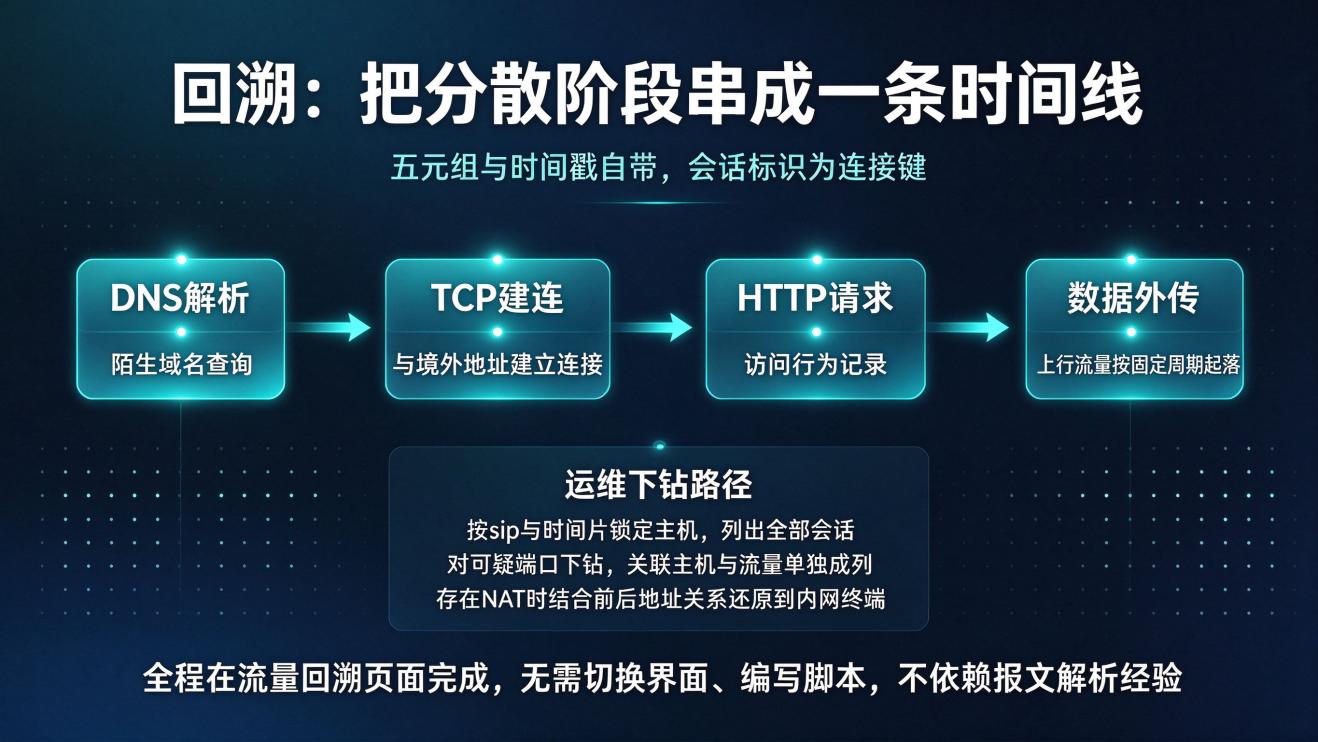
一次入侵往往在多个协议留下痕迹。DNS解析、TCP建连、HTTP请求、数据外传分属不同协议,传统方式各自独立,还原攻击链依赖人工比对时间戳。REWS的每条元数据记录自带五元组与时间戳,以会话标识为连接键,各阶段在时间轴上自动对齐。
运维的操作路径是:按sip与时间片锁定主机,列出该时段全部会话,逐行呈现对端地址、目的端口、上下行字节数;对可疑端口继续下钻,将该端口关联主机与流量单独成列;存在NAT时结合NAT前后地址关系把连接还原到内网终端。整个过程在流量回溯页面完成,无需切换界面、编写脚本,也不依赖报文解析经验。
REWS核心模块(二):检索、回溯与审计分析
四、审计分析:五个视角与统一口径
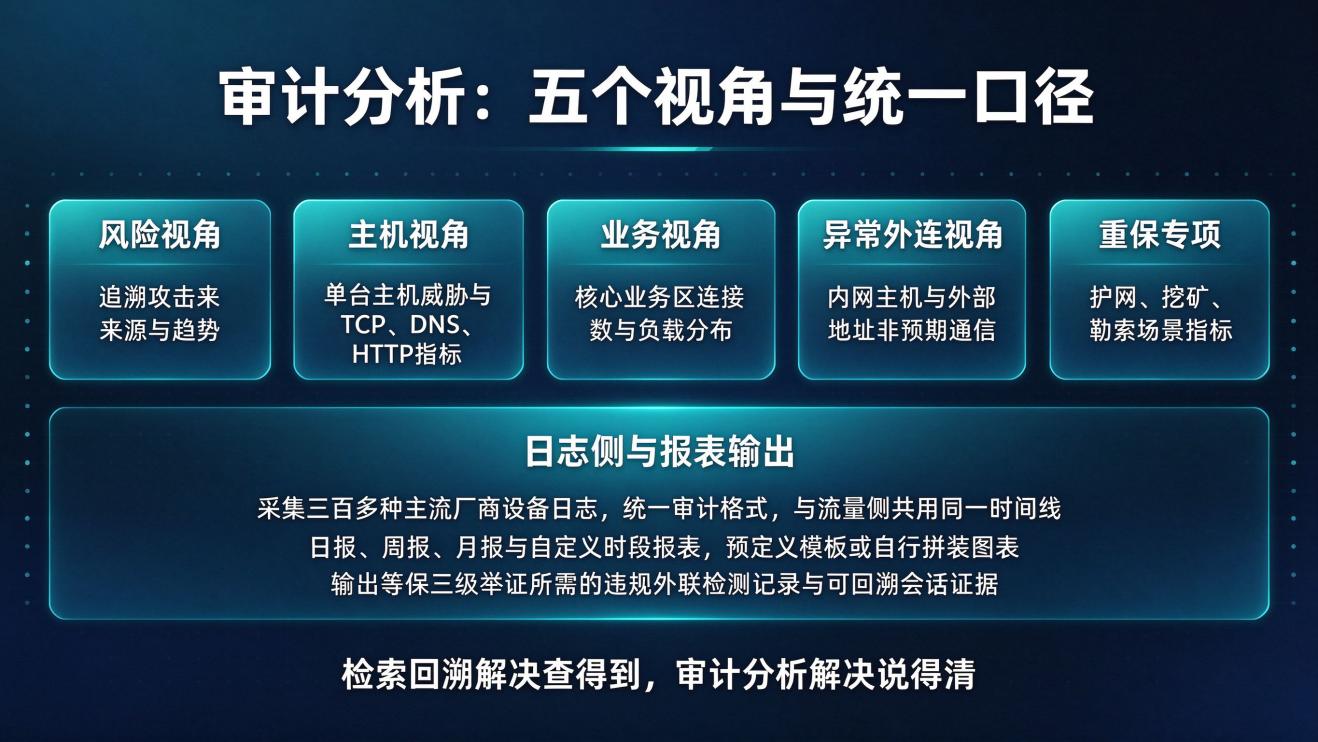
检索与回溯解决“查得到”,审计分析解决“说得清”。可视化分析分五个视角:风险视角追溯攻击来源与趋势;主机视角展开单台主机的威胁、TCP、DNS、HTTP指标;业务视角观察核心业务区连接数与负载分布;异常外连视角聚焦内网主机与外部地址的非预期通信;重保专项按护网、挖矿、勒索等场景配置指标。
日志侧补齐流量之外的口径:采集三百余种主流厂商设备日志,统一为一套审计格式,与流量侧共用同一时间线。输出侧支持日报、周报、月报与自定义时段报表,可用预定义模板或自行拼装图表,排查结果可导出留存,并输出等保三级举证所需的违规外联检测记录与可回溯会话证据。
REWS核心模块(二):检索、回溯与审计分析
五、现场验证:一次挖矿告警的回溯
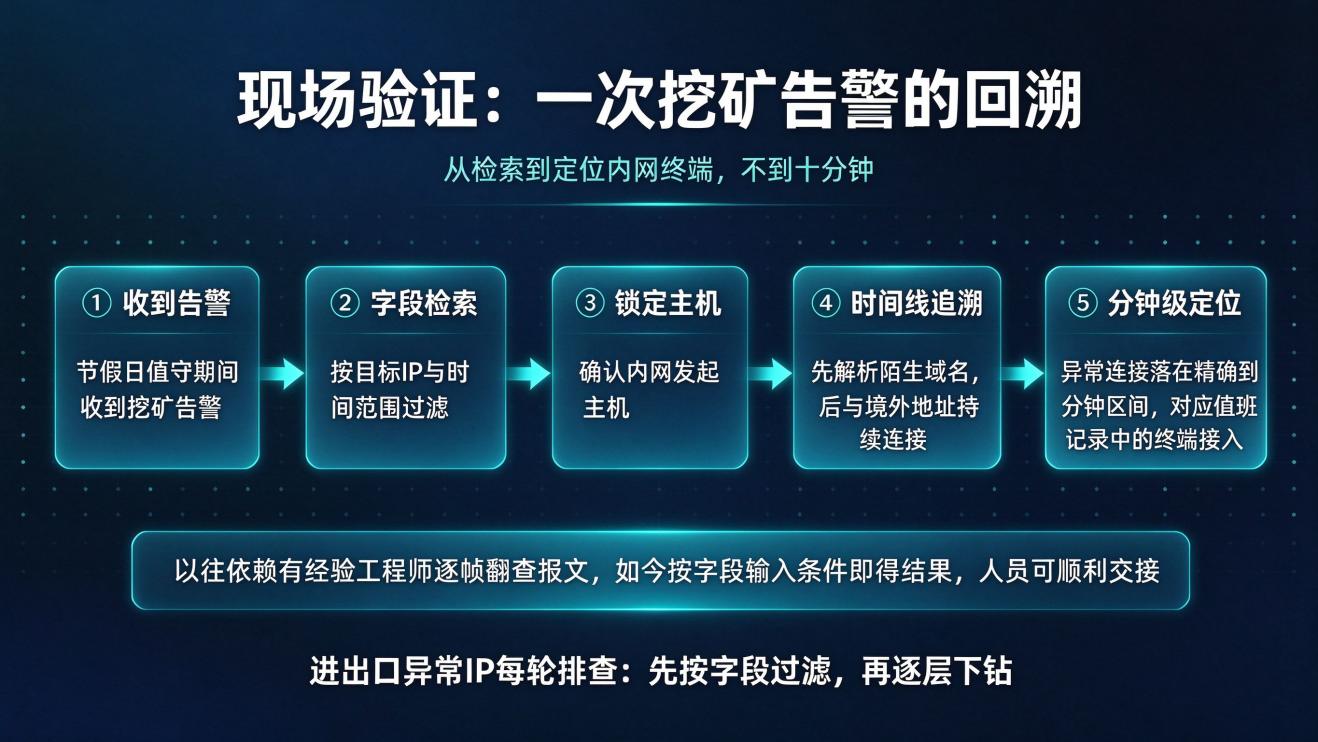
某地市政务单位在节假日值守期间收到一条挖矿告警。运维按目标IP与时间范围检索,确认内网发起主机,再沿时间线向前追溯,发现该主机先解析一个陌生域名,随后与境外地址建立持续连接,上行流量按固定周期起落。按时间片切分会话后,异常连接的建立时间落在精确到分钟的区间,对应值班记录中的一次终端接入。从检索到定位终端,不到十分钟。
该单位随后把同类查询固化为例行动作,出入口异常IP每轮排查先按字段过滤再逐层下钻。运维工程师反馈,以往排查同类问题依赖有经验的工程师逐帧翻查报文,如今按字段输入条件即可得到结果,人员也能顺利交接。
REWS核心模块(二):检索、回溯与审计分析
六、能力边界与适配说明
元数据存储路线聚焦事件审计、溯源分析,不保存完整原始报文。对于APT深度取证、司法案件需要完整报文原件存证等场景,需要完整原始报文。适配对象上,方案面向自建机房、有等保三级合规要求、IT团队精简的中等规模政企,高校、医院、地市政务、国央企分支是主要落地场景。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号