机房温湿度监控系统可靠性设计:以太网节点断线容错方案
原创
机房温湿度监控系统可靠性设计:以太网节点断线容错方案
原创
BJ盛世宏博小程
发布于 2026-10-22 10:15:53
发布于 2026-10-22 10:15:53
机房温湿度监控系统可靠性设计:以太网节点断线容错方案
物联网 · 盛世宏博 · 动环可靠性
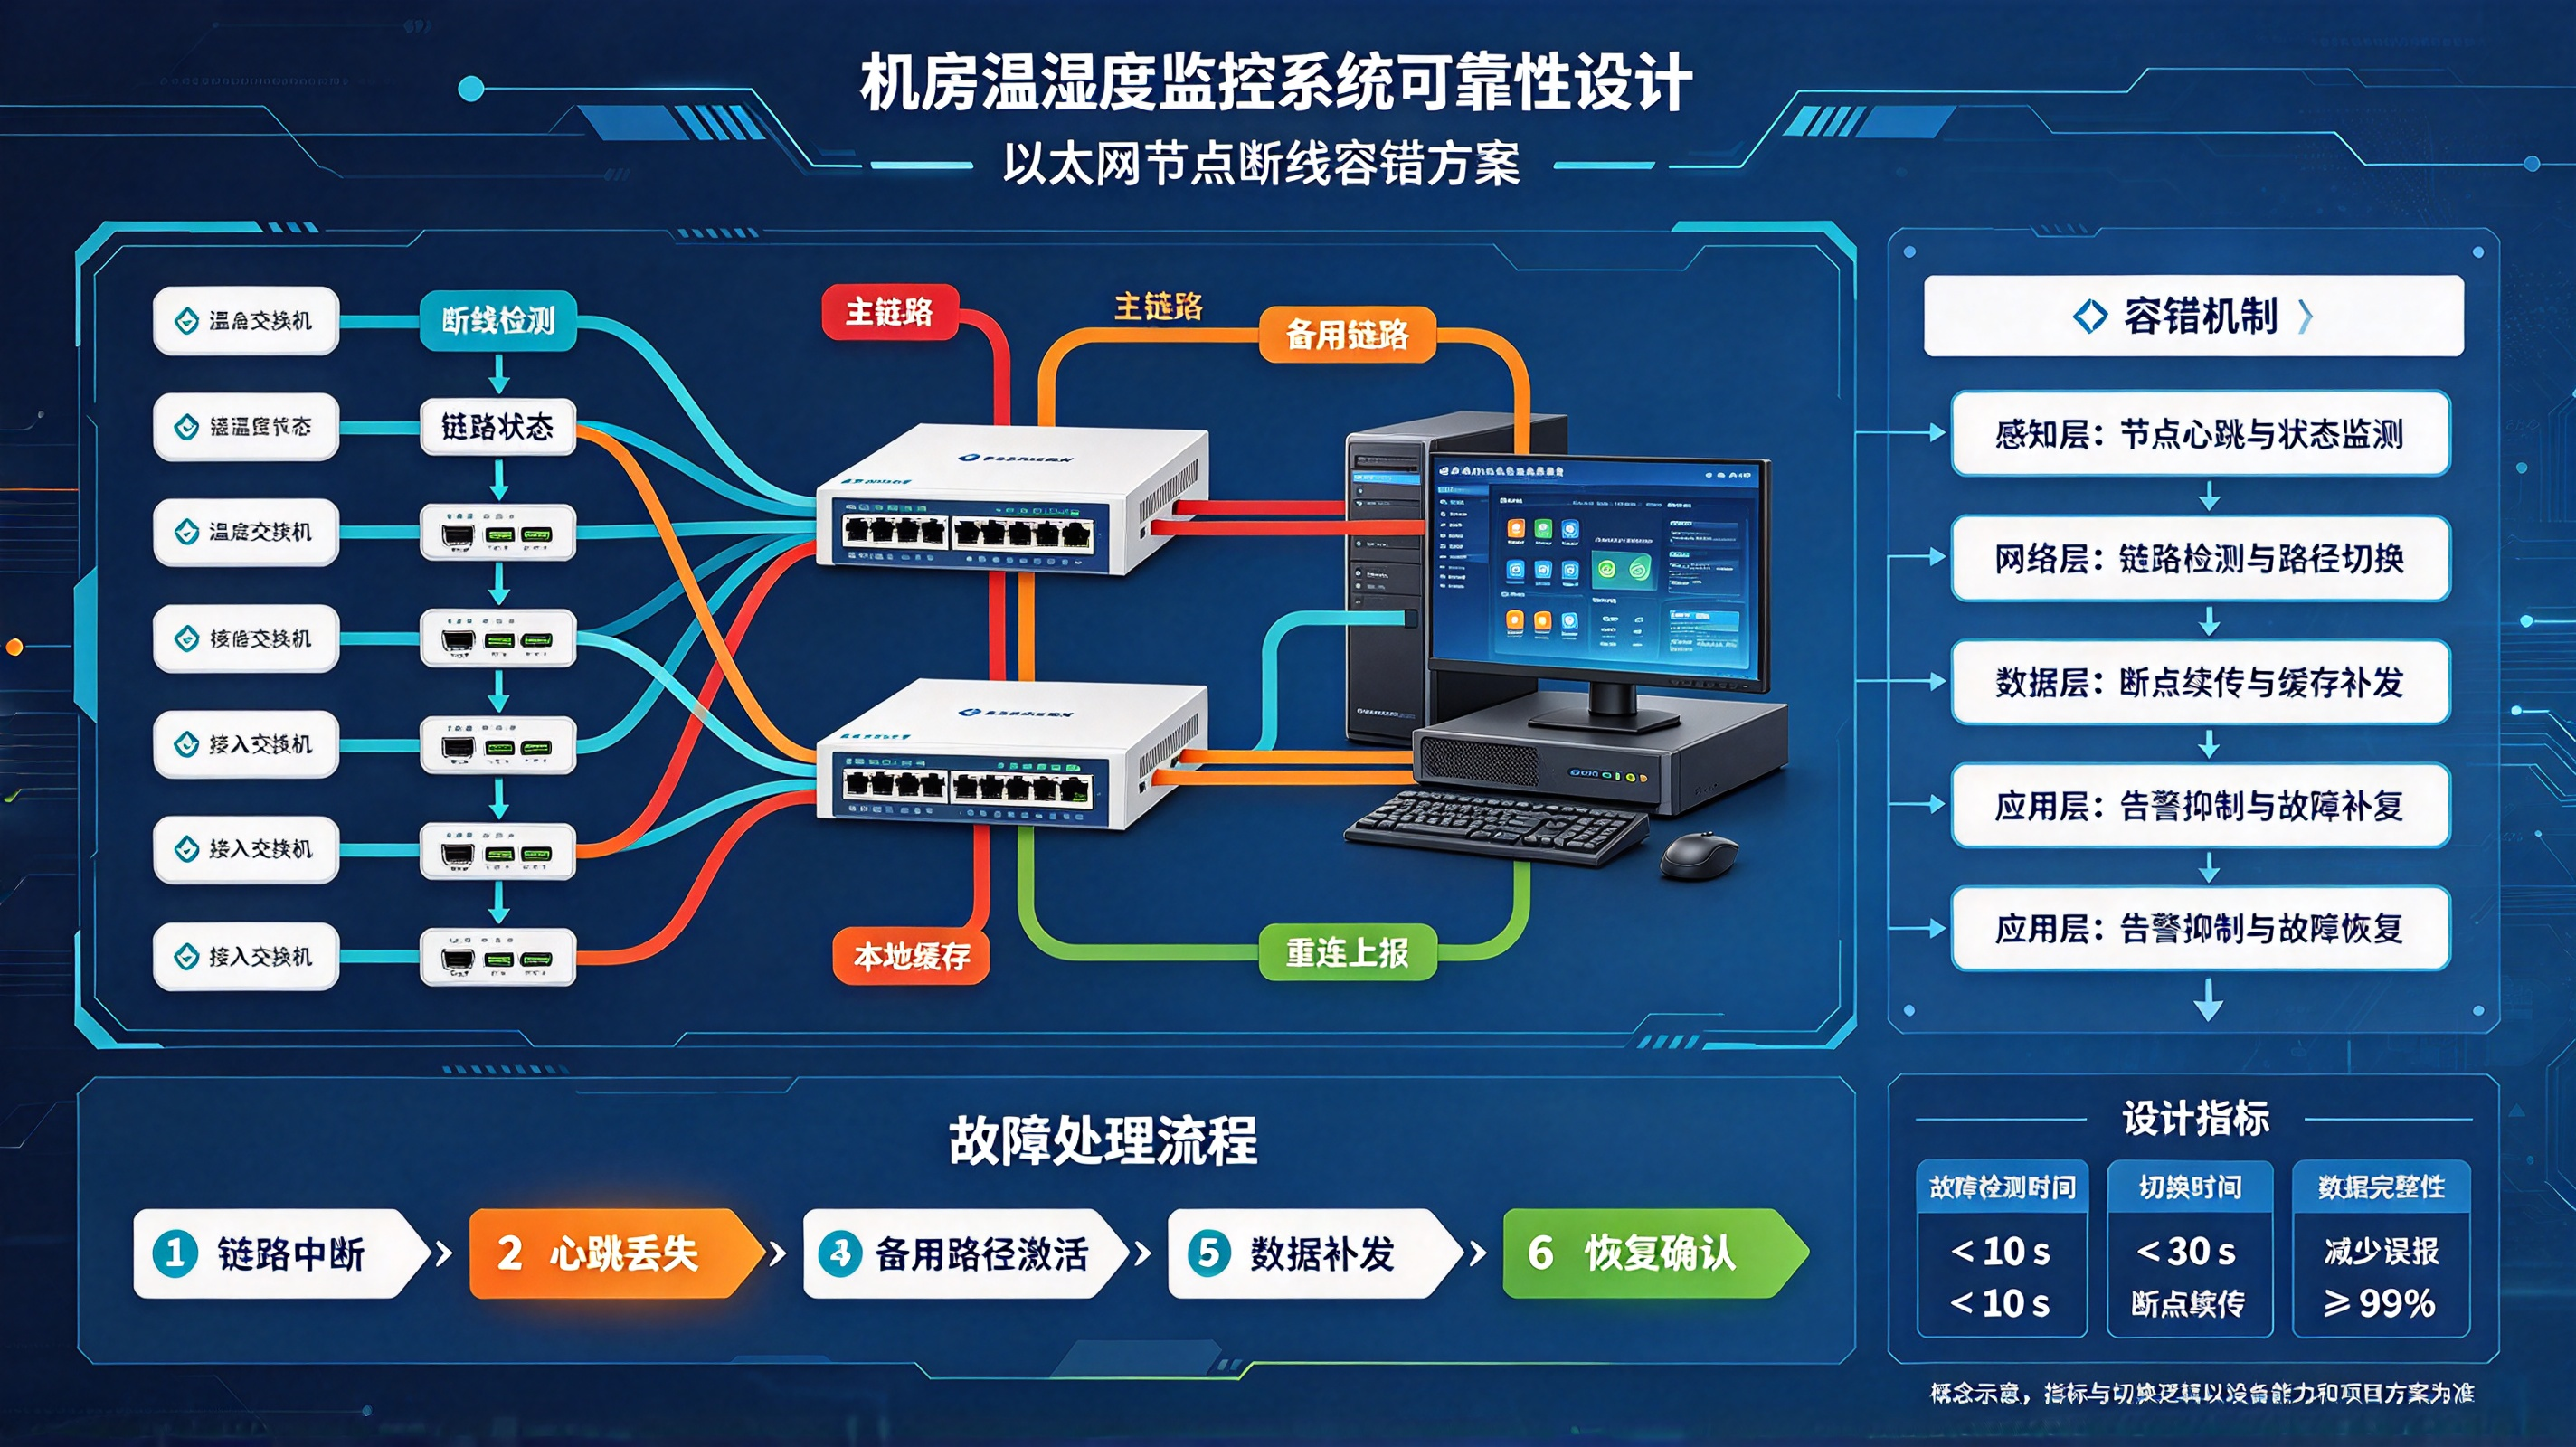
一、先说清:节点断线不是"离线告警"这么简单
机房温湿度监控最常见的设计失误,是把"节点断线"当成单一故障来处理——发现 Ping 不通,弹个告警,完事。
真实故障链远比这复杂:
单节点断线 → 该区域温度数据缺失 → 平台继续用最后值控制空调
         → 空调误动作(该制冷不制冷/不该加湿在加湿)
→ 局部热点累积 → 设备过热宕机 / 湿度超标 → 凝露 → 短路所以断线容错的核心不是"知道断了",而是断了之后系统还能不能继续做出正确决策。
监控系统的可靠性,不看"正常运行时多漂亮",看"故障发生时有多不蠢"。
二、断线故障分类:先分清是哪种"断"
故障类型 | 表现 | 根因 | 影响 |
|---|---|---|---|
物理断线 | 端口 Down,Ping 不通 | 网线断/交换机端口坏/PoE 死 | 完全无数据 |
应用层假死 | Ping 通,Modbus 无响应 | 传感器 TCP 栈卡死/连接池满 | 数据冻结 |
数据卡死 | 有响应,值不变 | 传感器采样停/固件 Bug | 假数据更危险 |
网络分区 | 部分节点可达,部分不可达 | 交换机故障/VLAN 阻断 | 局部盲区 |
间歇性丢包 | 时通时断,延迟抖动大 | EMI/网线劣质/PoE 欠压 | 控制抖动 |
平台侧断 | 设备正常,平台收不到 | 平台进程挂/数据库锁 | 全馆"被断线" |
关键认知:这六种故障的容错策略完全不同,用一套"超时告警"打天下,必出事。
三、分层容错架构
┌─────────────────────────────────────────────────────────────┐
│ 平台层容错                                                 │
│  多节点交叉验证 · 缺失数据不驱动控制 · 降级策略             │
├─────────────────────────────────────────────────────────────┤
│ 网关层容错                                                 │
│  本地缓存 · 断线接管 · 健康检查 · 自动恢复                 │
├─────────────────────────────────────────────────────────────┤
│ 网络层容错                                                 │
│  PoE 看门狗 · 链路聚合 · 双归属 · STP/RSTP                 │
├─────────────────────────────────────────────────────────────┤
│ 设备层容错                                                 │
│  看门狗复位 · 本地自治 · 双采样 · 数据合理性校验           │
└─────────────────────────────────────────────────────────────┘
四层各管一段,任何一层失效,其他层能兜底。
四、设备层容错:传感器自己不能"死得无声无息"
1. 内部看门狗
传感器 MCU 内建独立看门狗(WDT):
  - 喂狗周期 2s
  - 主循环卡死 / TCP 栈死锁 → WDT 溢出 → 硬件复位
  - 复位后:保持原配置,按最后有效目标值继续运行
- 上报"Watchdog Reset"事件,平台记录"设备自恢复"采购要点:问清有没有独立硬件看门狗,软件喂狗等于没做。
2. 采样自检
每 60s 执行一次自检:
  - 温度传感器开路/短路检测(返回值 0x7FFF / 0x8000)
  - 湿度电容式探头老化检测(响应时间变慢 = 老化)
  - ADC 参考电压漂移检测
  - 自检失败 → 该点标 SUSPECT,不继续参与联动控制
3. 数据合理性校验(设备侧)
// 设备固件内
#define MAX_TEMP_DELTA 3.0f  // 单次最大变化
#define MIN_TEMP        -40.0f
#define MAX_TEMP        85.0f

float last_temp = 25.0f;

bool is_valid(float new_temp) {
    // 物理范围检查
    if (new_temp < MIN_TEMP || new_temp > MAX_TEMP)
        return false;
    // 突变检查(排除探头故障)
    if (fabs(new_temp - last_temp) > MAX_TEMP_DELTA)
        return false;  // 不更新,保持上次有效值
    last_temp = new_temp;
    return true;
}
五、网络层容错:别让一根网线成单点
1. PoE 链路保活
交换机端:
  - PoE 端口开启 "PoE Guard" / "PoE Watchdog"
  - 持续检测 PD 功耗,低于阈值 30s → 端口断电重启(间隔 30s)
  - 目的:传感器固件假死时,交换机端硬重启

传感器端:
  - 网络心跳包:每 5s 发一次(ICMP + 应用层心跳双通道)
  - 连续 3 次无响应 → 判定断线
2. 链路冗余(关键机房)
方案A:链路聚合(LACP)
  传感器双网口 → 2 口聚合 → 单网线断不影响

方案B:双归属(推荐)
  传感器双网口 → 两台交换机(堆叠/VSS/vPC)
  主链路 Down → <1s 切备链路

方案C:单臂旁路(成本最低)
  普通交换机 + 光纤收发器,断纤不影响电口侧
关键机房(金融/通信枢纽)建议双归属;普通企业机房链路聚合够用。
3. 网络分区隔离
核心交换机 ──┬── VLAN 100 动环监测(温湿度/水浸/门禁)
             ├── VLAN 200 业务服务器
             └── VLAN 300 办公网

STP/RSTP 开启,避免环路
每个 VLAN 独立 STP 实例,故障域隔离
六、网关层容错:边缘不能"一死全瘫"
1. 多节点健康状态机
# gateway_health.py
"""网关侧节点健康检查与接管逻辑"""

import time
from enum import Enum

class NodeState(Enum):
    ONLINE = "online"
    SUSPECT = "suspect"      # 偶发丢包,降级观察
    STALE = "stale"          # 数据过期但未超时
    OFFLINE = "offline"      # 确认断线
    RECOVERING = "recovering" # 恢复中

class NodeHealthMonitor:
    def __init__(self):
        self.nodes = {}          # {ip: NodeState}
        self.last_seen = {}
        self.missed_count = {}
        self.quality_window = {}  # 最近 N 次通讯质量
        self.TIMEOUT = 10.0       # 10s 无数据 = 超时
        self.SUSPECT_THRESHOLD = 0.3  # 丢包率 >30% = 降级

    def feed(self, ip: str, data_valid: bool, rtt_ms: float):
        now = time.time()
        self.last_seen[ip] = now

        # 更新质量窗口
        self.quality_window.setdefault(ip, []).append(data_valid)
        if len(self.quality_window[ip]) > 20:
            self.quality_window[ip].pop(0)

        good_rate = sum(self.quality_window[ip]) / len(self.quality_window[ip])

        # 状态机转换
        if not data_valid:
            self.missed_count[ip] = self.missed_count.get(ip, 0) + 1
            if self.missed_count[ip] >= 3:
                self.nodes[ip] = NodeState.OFFLINE
        else:
            self.missed_count[ip] = 0
            if good_rate < self.SUSPECT_THRESHOLD:
                self.nodes[ip] = NodeState.SUSPECT
            elif self.nodes.get(ip) == NodeState.OFFLINE:
                self.nodes[ip] = NodeState.RECOVERING
                # 触发恢复流程
                self._handle_recovery(ip)
            else:
                self.nodes[ip] = NodeState.ONLINE

    def _handle_recovery(self, ip: str):
        """恢复流程:重新校准 + 数据补传"""
        # 1. 重新读取设备配置,确认未复位
        config_ok = self._verify_config(ip)
        if not config_ok:
            self._reapply_config(ip)  # 重新下发配置

        # 2. 触发数据补传(如果设备支持历史读取)
        self._request_history(ip)

        # 3. 标记状态
        self.nodes[ip] = NodeState.ONLINE
        self._audit_log(ip, "node_recovered")

    def get_control_value(self, ip: str) -> tuple:
        """获取可用于控制的值,断线时返回安全策略"""
        state = self.nodes.get(ip)

        if state == NodeState.ONLINE:
            return (self._last_valid_value(ip), "GOOD")
        elif state == NodeState.SUSPECT:
            return (self._last_valid_value(ip), "SUSPECT")
        elif state == NodeState.STALE:
            return (None, "STALE")  # 不驱动控制
        elif state == NodeState.OFFLINE:
            return (None, "OFFLINE")  # 冻结联动
        elif state == NodeState.RECOVERING:
            return (self._last_valid_value(ip), "RECOVERING")
2. 网关本地缓存
断网时:
  - 传感器数据存本地环形缓冲(≥24h)
  - 每条带设备采样时间戳
恢复后:
  - 按时间戳顺序补传
  - 平台去重(slave_id + timestamp 主键)
  - 不拿最后值插值造假
3. 网关自身高可用
方案A:双网关热备(VRRP/Keepalived)
  - 虚拟 IP 对外,主挂备接管 <3s
  - 共享配置库(Redis + 持久化)

方案B:单网关 + 看门狗
  - 网关进程死 → 系统级 watchdog 重启
  - 交换机 PoE 断电重启兜底
七、平台层容错:断线后控制策略不能"瞎"
1. 数据质量驱动控制(核心)
# platform_control.py
"""平台侧:断线数据不驱动控制"""

def should_actuate(node_ip: str, current_value: float,
                   quality: str, last_valid_age: float) -> dict:
    """
    决定是否能基于该节点数据做控制决策
    """

    # 规则1:断线/过期数据绝对不控制
    if quality in ("STALE", "OFFLINE", "COMM_LOST"):
        return {
            "actuate": False,
            "reason": f"数据质量 {quality},冻结该点联动",
            "fallback": "use_zone_median"  # 用同区其他节点中位数
        }

    # 规则2:SUSPECT 数据只告警不控制
    if quality == "SUSPECT":
        return {
            "actuate": False,
            "reason": "数据可疑,仅告警不控制",
            "fallback": "use_last_good_value"
        }

    # 规则3:数据太老(>3个采集周期)也不控制
    if last_valid_age > 3 * COLLECTION_PERIOD:
        return {
            "actuate": False,
            "reason": "数据过旧",
            "fallback": "use_zone_median"
        }

    # 规则4:数据合理性检查
    if not is_physically_valid(current_value):
        return {
            "actuate": False,
            "reason": "值超物理范围",
            "fallback": "mark_sensor_fault"
        }

    return {"actuate": True, "reason": "数据可信"}
2. 多节点交叉验证(同区域冗余)
同一机房分区内 N 个节点(N≥3):
  中位数法:控制值 = median(T1, T2, ..., Tn)
  异常检测:|Ti - median| > 3℃ 且持续 5min → 标 SUSPECT

单节点断线:
  → 用剩余节点中位数继续控制
  → 不降低控制精度(3 节点剩 2 个仍可用)

全部断线(极端):
  → 空调/加湿保持最后有效状态,不启不停止
  → 平台红警 + 人工介入
3. 降级策略分级
级别 | 条件 | 控制策略 |
|---|---|---|
正常 | 所有节点 GOOD | 正常 PID 控制 |
降级1 | 1 个节点 SUSPECT | 剔除该节点,其余正常控制 |
降级2 | 1 个节点 OFFLINE | 中位数控制 + 告警 |
降级3 | >50% 节点 OFFLINE | 保守模式:空调适度制冷,不加湿不除湿 |
紧急 | 全部 OFFLINE | 保持现状 + 声光告警 + 人工 |
八、断线检测精度优化:别把"抖动"当"断线"
1. 多级超时
T1 = 3 × 采集周期     → SUSPECT(可疑)
T2 = 10s              → STALE(数据过期)
T3 = 30s              → OFFLINE(确认断线)
T4 = 5min             → 触发工单派发
为什么不能直接 10s 判 OFFLINE?
以太网偶尔丢一个包太正常(EMI/交换机队列满),直接判 OFFLINE 会导致"告警抖动"。
2. 双通道探测
通道1:ICMP Ping(网络层)
通道2:Modbus 读寄存器(应用层)

判定矩阵:
  Ping 通 + Modbus 通  → ONLINE
  Ping 通 + Modbus 不通 → SUSPECT(应用层假死)
  Ping 不通 + Modbus 不通 → OFFLINE
  Ping 不通 + Modbus 通  → 不可能(排除逻辑错误)
3. RTT 趋势预警
连续记录每次 Modbus 响应时间 RTT:
  P50 < 50ms  正常
  P99 > 500ms 预警(网络拥塞/交换机老化)
  RTT 持续上涨趋势 → 提前告警"链路质量劣化"
九、恢复流程:断线恢复不是"重新连上"就完了
完整恢复链
1. 网络层恢复(Ping 通)
   ↓
2. 应用层恢复(Modbus 握手成功)
   ↓
3. 配置校验(读回设备配置,与缓存比对)
   ├─ 一致 → 继续
   └─ 不一致(设备被复位)→ 重新下发全量配置
   ↓
4. 数据校准(与同区节点比对,确认未漂移)
   ↓
5. 数据补传(按时间戳补历史,平台去重)
   ↓
6. 状态标记 ONLINE,恢复参与控制
   ↓
7. 审计日志:断线时刻 / 恢复时刻 / 断线原因 / 补传条数
漏掉第 3 步的惨案:设备复位后目标湿度变回出厂值 60%RH,平台不知道,库房实际已经 68%RH 三天了。
十、工程验收测试项
测试 | 方法 | 合格线 |
|---|---|---|
单节点拔网线 | 拔传感器网线 | 10s 内标 OFFLINE,联动冻结 |
单节点假死 | 阻断 Modbus 端口(iptables) | SUSPECT → 不驱动控制 |
交换机端口故障 | 关交换机端口 | 节点 OFFLINE,同区中位数接管 |
网关进程挂 | kill 网关进程 | 传感器本地自治,重启后补传 |
平台进程挂 | 停平台服务 | 网关缓存继续,恢复后补传 |
PoE 断电重启 | 拔传感器 PoE | 重连后配置校验通过 |
间歇性丢包 | tc netem loss 10% | 不误判 OFFLINE,标 SUSPECT |
全部节点断 | 断动环 VLAN | 空调保持现状 + 声光红警 |
数据补传 | 断网 10min 恢复 | 补传数据时间戳连续,无空洞 |
恢复配置校验 | 设备复位后重连 | 配置自动下发,不用人干预 |
交叉验证 | 拔 1 个节点 | 中位数控制,精度不降 |
72h 连续 | 正常运行 | 零误告警,零漏告警 |
十一、配置清单(交付必附)
- [ ] 看门狗配置:设备 WDT 周期 + 喂狗方式
- [ ] 心跳间隔 + 超时阈值(T1/T2/T3/T4)
- [ ] 数据质量戳定义与处理策略
- [ ] 同区节点数量 + 中位数算法确认
- [ ] 降级策略各级触发条件
- [ ] 网关缓存容量 + 补传机制
- [ ] 双归属/链路聚合拓扑图
- [ ] 交换机 PoE Watchdog 配置
- [ ] 断线告警分级 + 通知方式
- [ ] 恢复流程 + 配置校验机制
- [ ] 审计日志字段定义
- [ × ] 72h 故障注入测试报告
十二、收口
以太网温湿度节点断线容错,不是"Ping 不通就告警"这么简单。完整的可靠性设计是四层兜底:
设备层:看门狗自复位 + 采样自检 + 数据合理性校验,别死得无声无息。
网络层:PoE Watchdog + 链路冗余 + 网络分区,别让一根网线成单点。
网关层:健康状态机 + 本地缓存 + 断线接管,别一死全瘫。
平台层:质量戳驱动控制 + 多节点交叉验证 + 分级降级,断线数据绝不驱动空调。
最后一条是底线中的底线:
节点断了,系统宁可"什么都不做",也不能"做错"。
空调该制冷时不制冷,是事故;不该加湿时在加湿,也是事故。
监控系统的可靠性,就在于故障时"知道自己在故障"。
关键词:以太网温湿度,节点断线,容错设计,看门狗,数据质量戳,多节点交叉验证,降级策略,断线恢复,配置校验,故障注入
标签:#以太网温湿度 #断线容错 #看门狗 #数据质量 #交叉验证 #降级策略 #故障注入 #动环可靠性 #智慧机房 #PoEWatchdog
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号