【征文】实战:用 WorkBuddy 把 4 小时播客自动变成结构化学习笔记(附音频直链获取方法)
原创
【征文】实战:用 WorkBuddy 把 4 小时播客自动变成结构化学习笔记(附音频直链获取方法)
原创
用户12835912
修改于 2026-10-23 10:48:08
修改于 2026-10-23 10:48:08
我是个重度播客听众,但一直有个痛点:好的播客动辄两三个小时,听完就忘,想记笔记又没时间回听。上周听一期 4 小时的商业访谈节目,试着让 WorkBuddy 全流程帮我处理,从"一个链接"到"一份结构化笔记",全程不到 20 分钟。这篇文章记录完整过程,包括几个关键坑位。
整体思路
播客平台(如小宇宙)的网页上只有节目简介和章节,没有文字稿。所以要分四步走:
- 从节目页面的网页源代码里把音频直链挖出来
- 把音频文件下载到本地
- 让 WorkBuddy 调用语音转写能力,把 4 小时音频变成全文
- 让 WorkBuddy 按我的习惯整理成结构化笔记
第一步:拿到音频直链
很多人卡在这一步。播客网页上右键"检查"找 mp3,往往一无所获,因为播放器是动态加载的。
我的做法(用 WorkBuddy 直接完成):
把节目链接发给 WorkBuddy,说:"帮我找到这个页面里音频文件的真实下载地址。"
它会用网页抓取工具拿到页面 HTML,然后在源代码里检索 media.xyzcdn.net 这样的 CDN 域名,直接给出 .m4a 后缀的完整直链。
踩坑 1:不要让 AI "打开网页听听内容"——它没法直接听。必须先转成文件。如果你自己手动操作,方法也很简单:浏览器打开节目页 → 右键"查看网页源代码" → Ctrl+F 搜索 "xyzcdn",那串
.m4a链接就是。
第二步:下载音频
直接让 WorkBuddy 下载即可。我这一期节目 247 分钟,音频文件 229MB,下载用了不到半分钟。
踩坑 2:长音频体积大,建议让 WorkBuddy 把文件存到工作区目录里(比如我建了个 podcast 文件夹),方便后续管理,也避免散落在系统临时目录里被误删。
第三步:全量转写
把本地文件路径交给 WorkBuddy,让它调用语音转写。转写工具支持 m4a/mp3/wav 等常见格式,上限 5 小时——我的 4 小时刚好在范围内。
转写完成后会得到带时间轴的全文,精确到秒,还区分了说话人。
踩坑 3:4 小时音频转写出来约 12 万字、1612 个片段,超出单次对话的处理上限。WorkBuddy 会自动把完整结果落盘成文件,这一步不要慌,转写没失败,只是结果被存到文件里了。接下来的整理步骤,让 AI 读文件而不是读对话记录。
第四步:结构化整理(真正的价值所在)
这一步决定了你是得到"一堆文字"还是"一份能用的笔记"。我给 WorkBuddy 的指令是:
读这份转写稿,整理成结构化笔记:按内容的逻辑主线分章节;每个章节给出核心框架(能用表格就用表格);单独摘出金句;最后给我"可以直接执行的三条建议"。
产出效果(真实摘录):
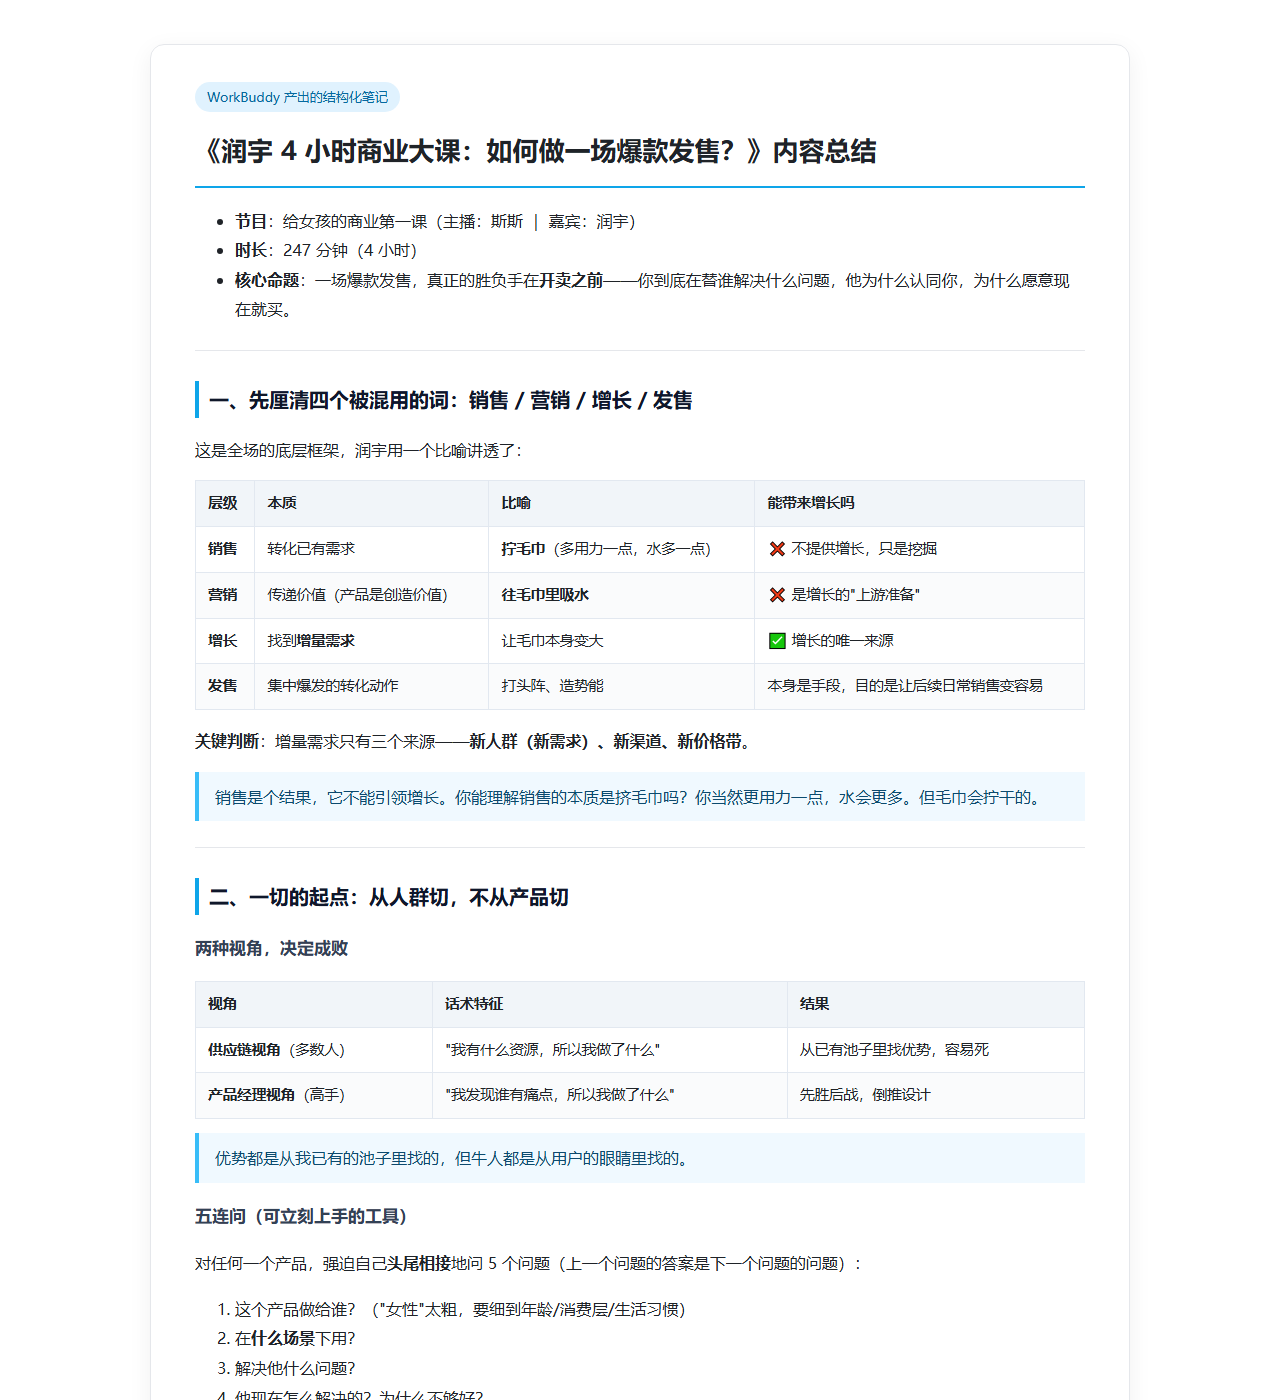
- 四层框架:销售=拧毛巾 / 营销=吸水 / 增长=把毛巾做大 / 发售=集中爆发——原节目里这组比喻散落在前 40 分钟的闲聊里,AI 把它们拎出来做成了对照表
- 金句提取:自动从 12 万字里筛出"卖点得先是用户的买点""流量不等于传播,传播不等于成交"这类可转发的句子
- 可执行建议:结合我的实际场景(我做内容创作)给出落地动作,而不是空泛的"要多思考"
踩坑汇总
坑 | 现象 | 解法 |
|---|---|---|
找不到音频直链 | 页面上没有下载按钮,播放器动态加载 | 让 AI 抓页面源代码检索 CDN 域名 |
转写结果"消失" | 超长音频的转写输出被折叠 | 结果会落盘为文件,下一步让 AI 读文件 |
整理后仍是流水账 | 直接说"帮我总结"效果差 | 指令要给结构:分章节+表格+金句+行动项 |
长文件占上下文 | 后续对话变慢、积分消耗增加 | 整理完及时开新对话,别在同窗口继续聊 |
积分消耗参考
这次全流程(抓直链 + 下载 229MB + 转写 4 小时 + 结构化整理)消耗在个位数 Credits 量级,对比一个月 500 的免费额度非常划算。同一个任务用付费语音转写服务大概要几十块。
总结
以前处理一期长播客的完整成本:听 4 小时 + 记 1 小时笔记。现在:发一个链接 + 等几分钟 + 检查产出。
对我来说更重要的变化是:播客从"消费内容"变成了"生产素材"——整理出来的笔记可以直接变成公众号文章、可以喂给自己的知识库,一鱼多吃。
有 WorkBuddy 使用问题欢迎评论区交流。
过程记录
图 1:节目原始页面,时长 247 分钟(音频来源)
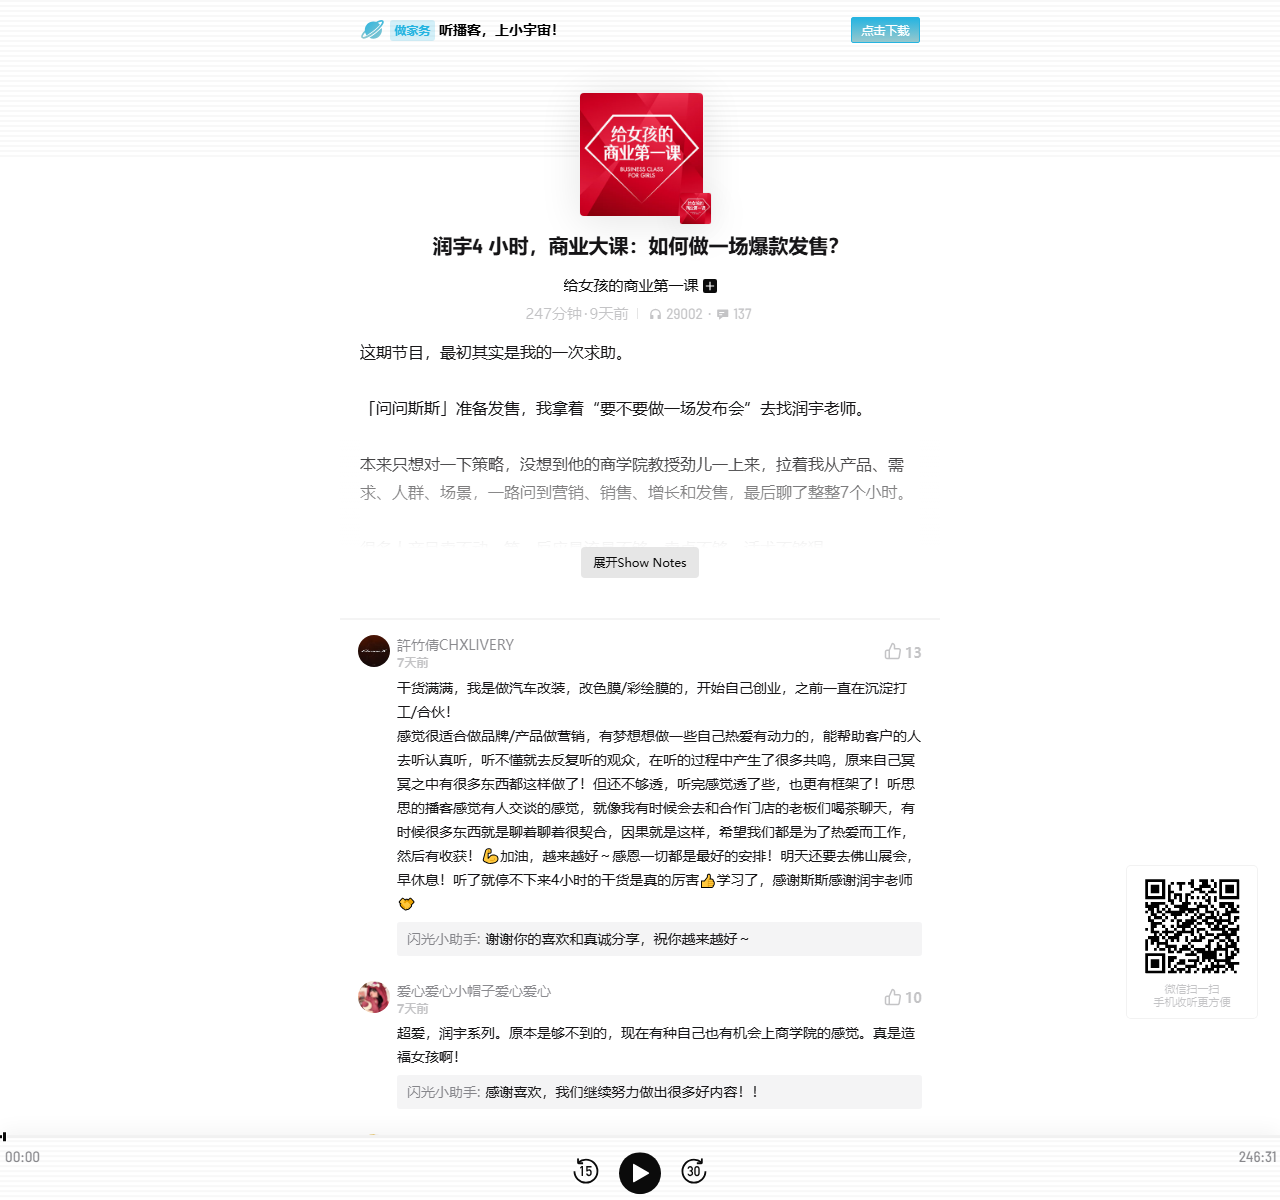
图 2:WorkBuddy 全量转写结果(摘录),逐句时间轴,全文共 1612 段
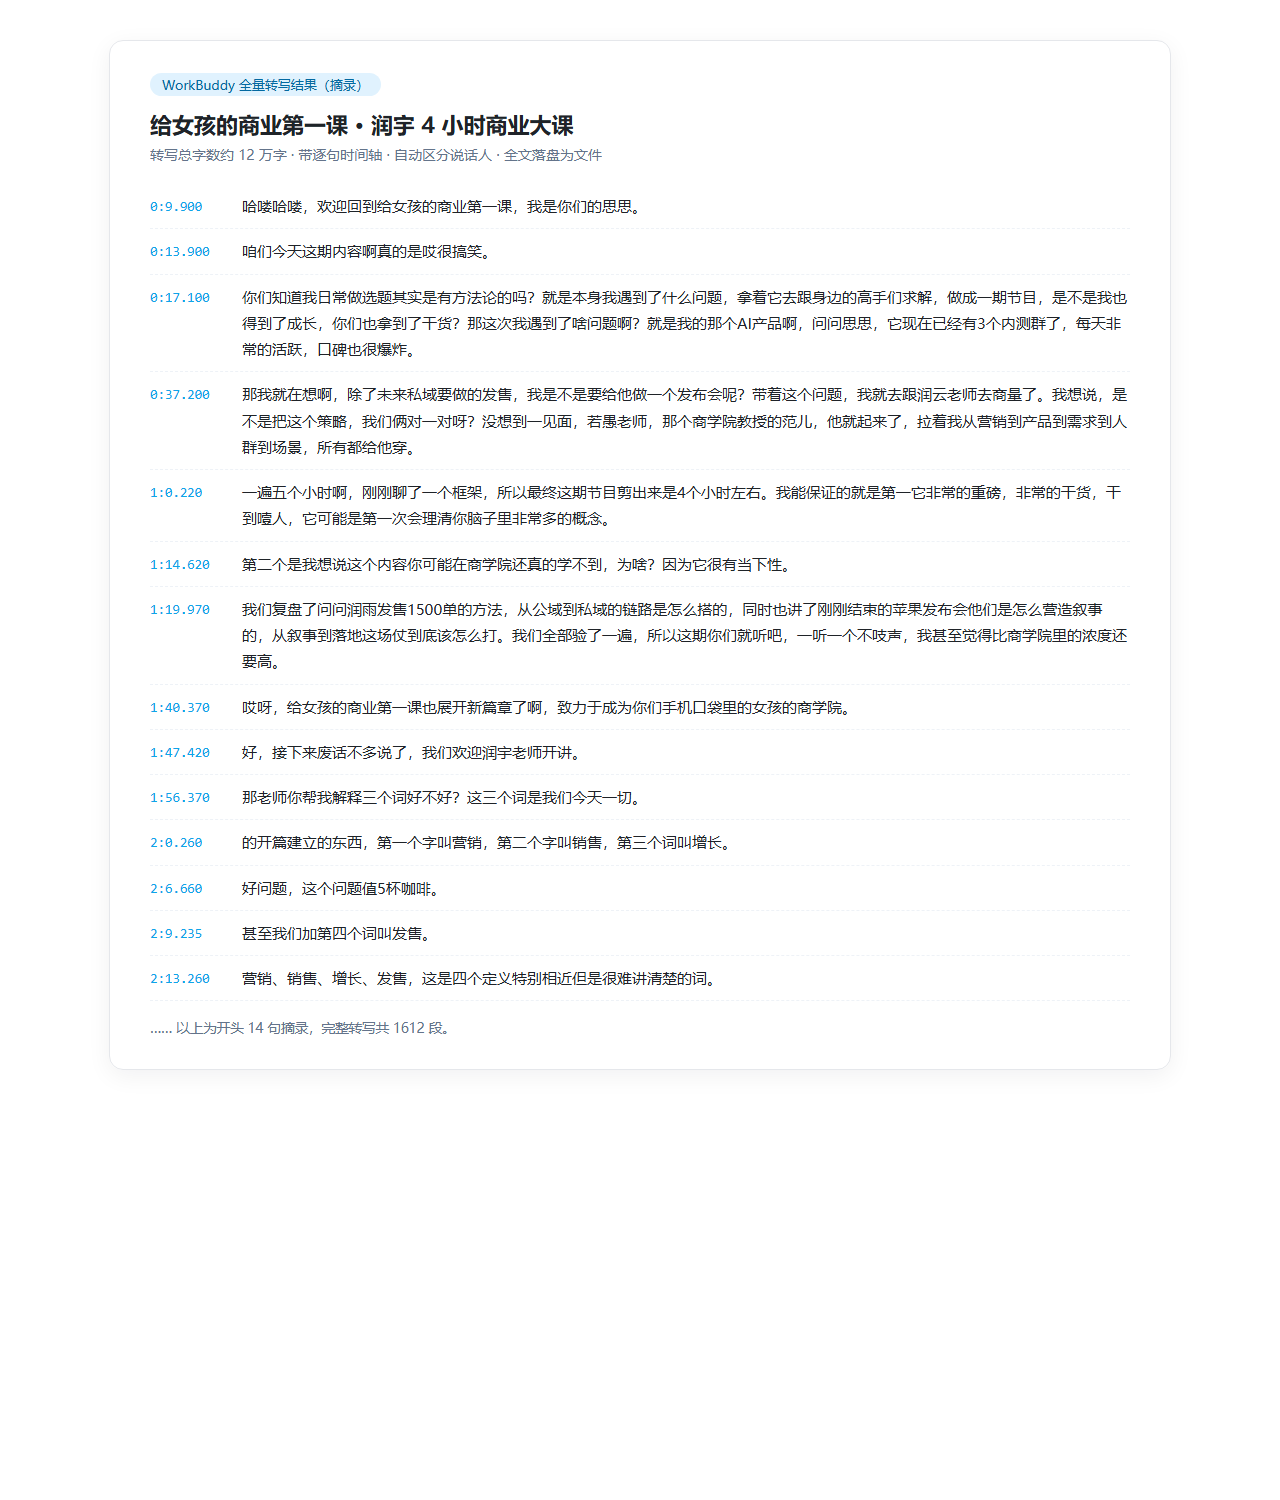
图 3:整理出的结构化笔记成品
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号