#WorkBuddy# 146,882 条定时任务执行记录对账:朴素解析误报 85%,治理式流水线六项指标全 100%
原创
#WorkBuddy# 146,882 条定时任务执行记录对账:朴素解析误报 85%,治理式流水线六项指标全 100%
原创
用户12784192
发布于 2026-10-23 10:33:24
发布于 2026-10-23 10:33:24
#WorkBuddy# 146,882 条定时任务执行记录对账:朴素解析误报 85%,治理式流水线六项指标全 100%
一、痛点开场:对账报告看着挺全,一查全是冤案
凡是跑过一批定时任务的人,几乎都做过这件事:把排程定义和执行日志拉到一起,数一数"该跑的跑了没有"。听起来是件很机械的活,写个脚本一晚上搞定。
我们就是在真实环境里被这种"机械活"打了脸。把一份朴素的解析脚本跑出来的对账报告拿去人工抽查,发现两个方向都在出事:报告说漏跑的,去机器上一查任务明明跑过;报告说正常的,回头一翻日志,同一次运行被记到了另一个排程点上。误报多到没人再敢信这份报告,最后只能退回人工核对——按 20 条/分钟的速度,14.7 万条记录要 122.4 个小时,也就是五天半的工作日。
这次我们用 WorkBuddy 把这件事彻底重做了一遍:自建一套带标准答案的语料,把"朴素脚本、换个库、换库加时区、治理式流水线"四种做法放在同一份数据上跑,用精确率、召回率、F1 把差距量出来。所有数字都是真实跑出来的,脚本和数据都留在本地,可复现。
二、实验设计:先造一份有标准答案的语料
要量出差距,必须先有标准答案(Ground Truth)。语料全部为合成数据,与任何真实业务无关:
项目 | 数值 |
|---|---|
任务数 | 180 个 |
排程窗口 | 2026-01-01 ~ 2026-07-01,共 181 天 |
时区种类 | 5 个(UTC / 上海 / 纽约 / 柏林 / 悉尼) |
排程总次数 | 145,382 次 |
执行记录 | 146,882 条 |
春季跳变空洞 | 24 次(该跑但本地时刻不存在的排程) |
表达式刻意覆盖了容易翻车的形态:*/10、0 9 * * 1-5(区间)、15 3 * * 6,0(列表)、0 4 1,15 * *(多值日期)、0 0 L * *(月末)、0 0 15W * *(最近工作日)、0 0 * * 1#2(第二个周一)、0 0 29 2 *(闰日陷阱,2026 年不是闰年,一次都不会跑)。
真值由一套独立编写的参考引擎生成:逐任务在本地墙钟上展开排程点,再用 IANA 时区规则折算成 UTC——本地时刻不存在(春季跳变)就跳过,歧义时刻(秋季回拨)取首次。为了自证引擎没错,我们拿第三方库 croniter 做外部交叉验证:在标准五字段任务上,croniter 与真值的一致率 UTC 99.99%、带时区 99.99%。
然后向执行日志里注入六类真实世界常见的异常:漏跑 1,500 次、重复触发 1,400 次、漂移运行 500 次(偏 7~23 分钟)、幽灵运行 900 条(排程上根本不存在的时刻)、并发重叠 700 对、时区错配 18 个任务(日志把本地墙钟当 UTC 记了)。
三、根因分析:三个层面,一层都躲不掉
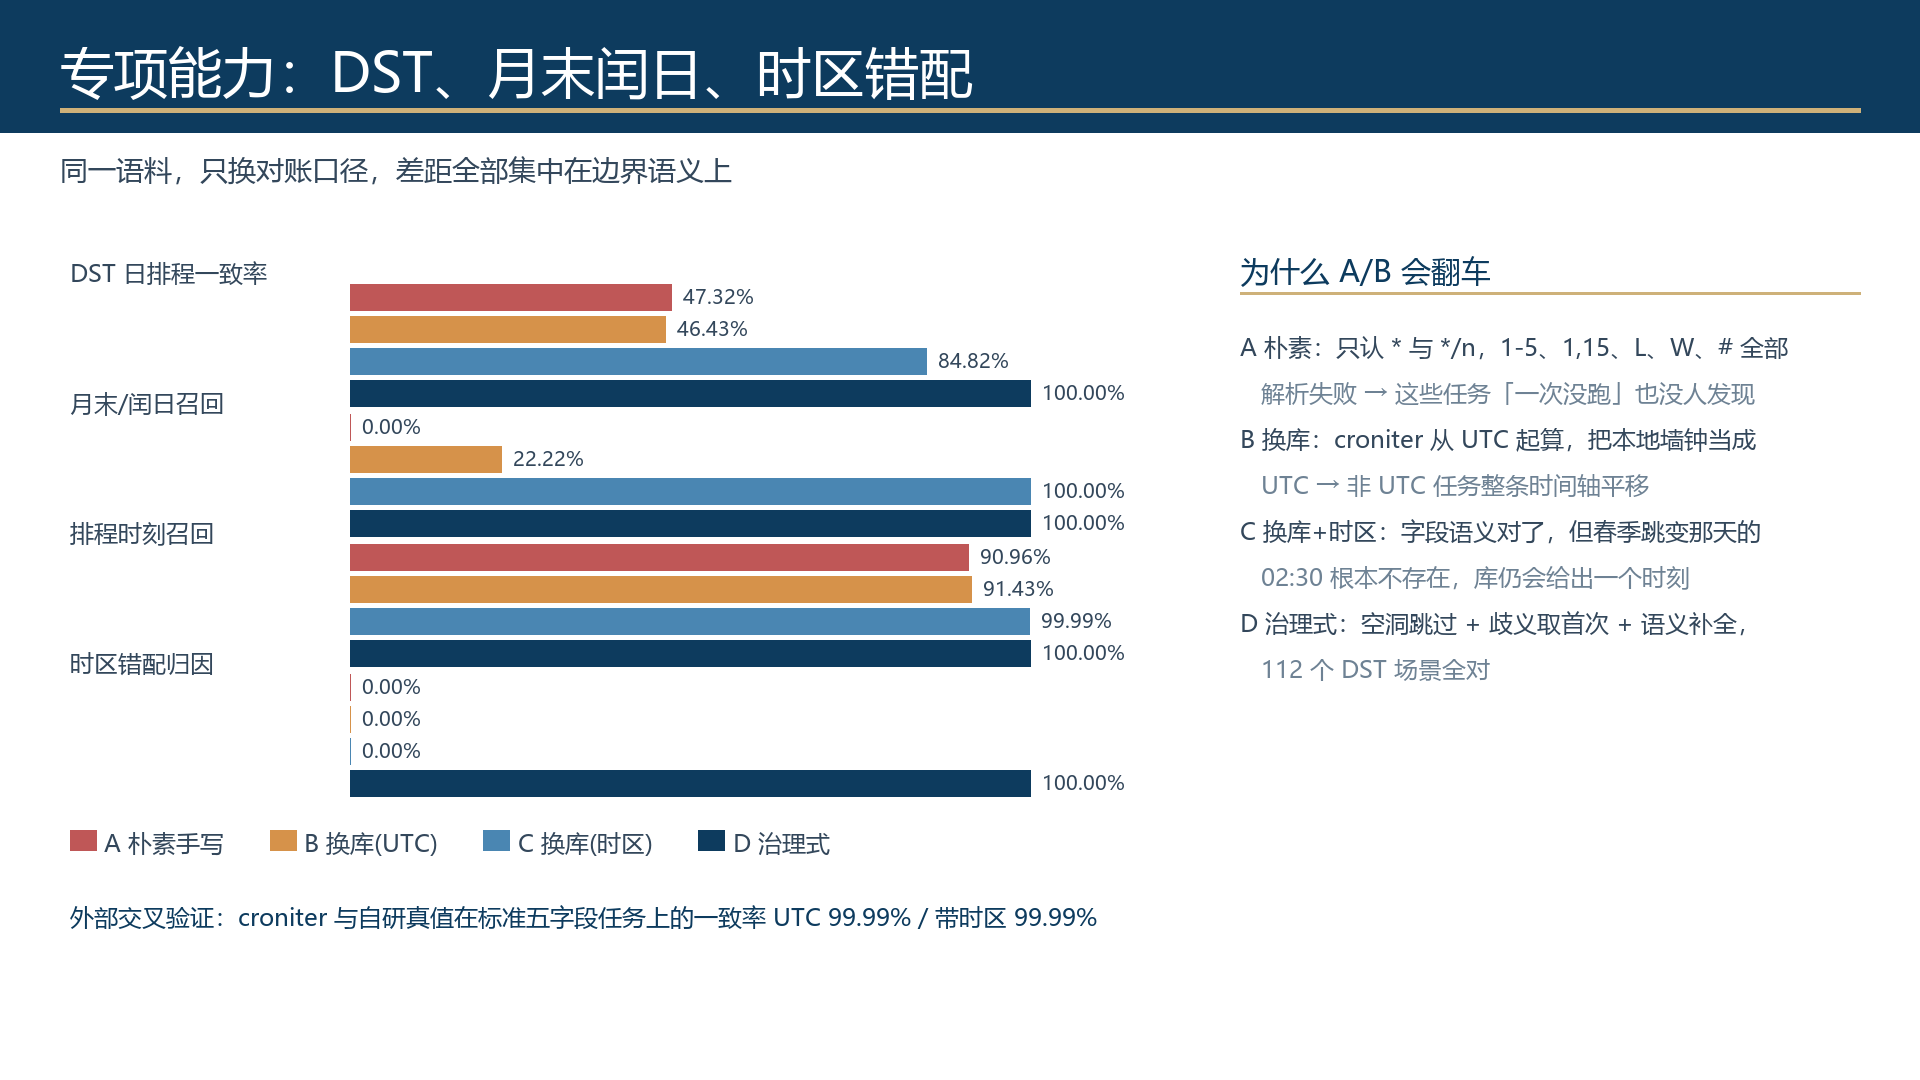
第一层:字段语义。 0 9 * * 1-5 里的 1-5 是区间,15 3 * * 6,0 里的 6,0 是"周六或周日",L、W、# 是扩展语义。朴素解析器只认 *、*/n 和单个整数,遇到区间直接判 False——后果不是报错,而是这些任务在审计里"一次都没跑过",漏跑的根因被死死埋住。更隐蔽的是"日与周几"的关系:cron 标准是两者都被限定时取"或",朴素实现写成"与",排出来的日子就全错了。
第二层:时区与 DST。 cron 表达式描述的是本地墙钟。纽约任务的 30 2 * * *,标准答案是 UTC 07:30;但每年 3 月第二个周日 02:00 时钟直接跳到 03:00,那一天的 02:30 根本不存在。换库看似解决了语义,但如果从 UTC 起算,非 UTC 任务整条时间轴平移 5~11 个小时;就算传了时区,春季跳变那天的空洞和秋季回拨的歧义时刻,多数库也不会替你处理。实测中 C 档(croniter 加时区)的 DST 日一致率只有 84.82%,17 个场景仍然错,缺口全部集中在澳洲回拨日的歧义时刻。
第三层:日志侧。 排程算对了只解决了一半,对账还要把日志挂回排程点。落库抖动、重复上报、手动补跑、上游时钟漂了,都会让"最近邻匹配"失效。最阴险的一类:18 个任务的日志整体平移了 1~11 个小时,朴素方法会把这几千条记录同时报成"漏跑"和"幽灵运行"——两个指标一起爆炸,报告彻底不可信。
四、真实数据对比
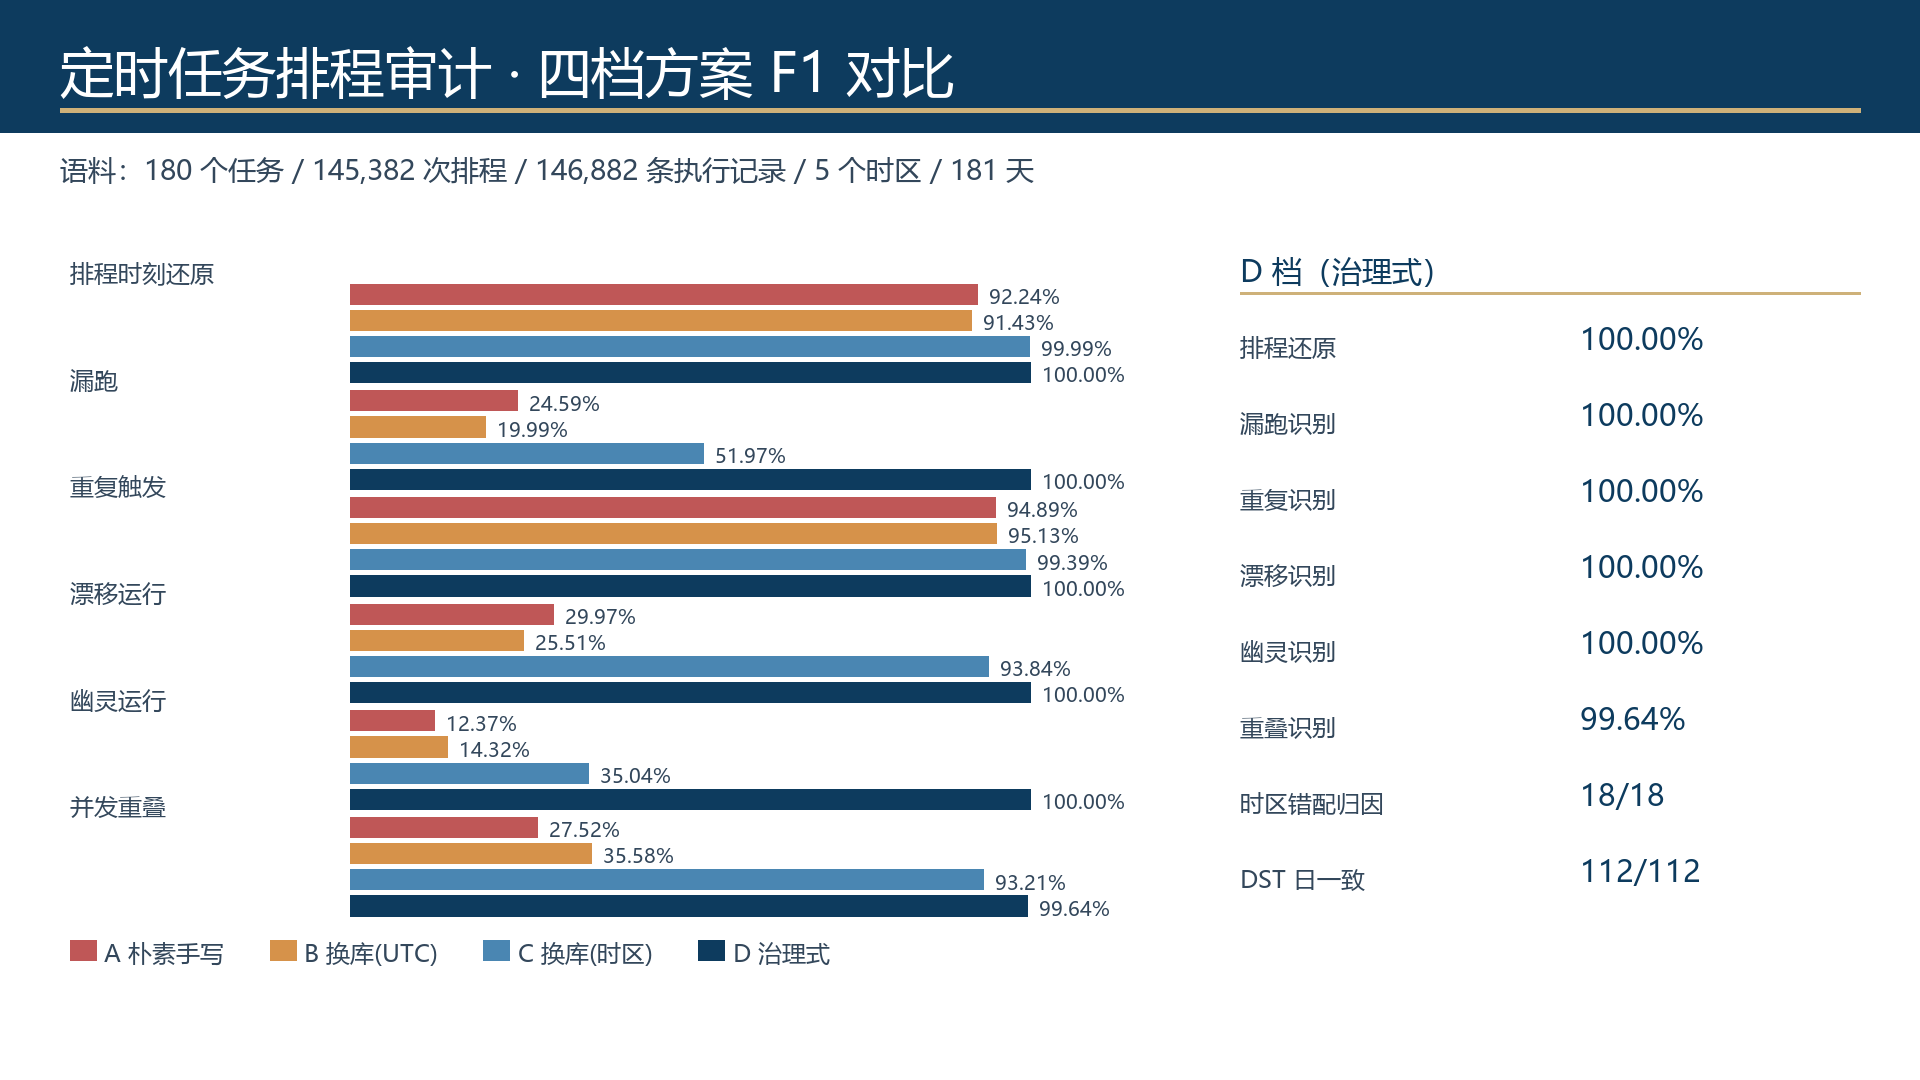
四档方案,同一语料,同一对账口径:
指标(F1,%) | A 朴素手写 | B 换库(UTC) | C 换库(时区) | D 治理式 |
|---|---|---|---|---|
排程时刻还原 | 92.24 | 91.43 | 99.99 | 100.00 |
漏跑 | 24.59 | 19.99 | 51.97 | 100.00 |
重复触发 | 94.89 | 95.13 | 99.39 | 100.00 |
漂移运行 | 29.97 | 25.51 | 93.84 | 100.00 |
幽灵运行 | 12.37 | 14.32 | 35.04 | 100.00 |
并发重叠 | 27.52 | 35.58 | 93.21 | 99.64 |
时区错配归因(任务级) | 0/18 | 0/18 | 0/18 | 18/18 |
DST 日排程一致率 | 47.32% | 46.43% | 84.82% | 112/112 |
月末/闰日召回 | 0% | 22.22% | 100% | 100% |
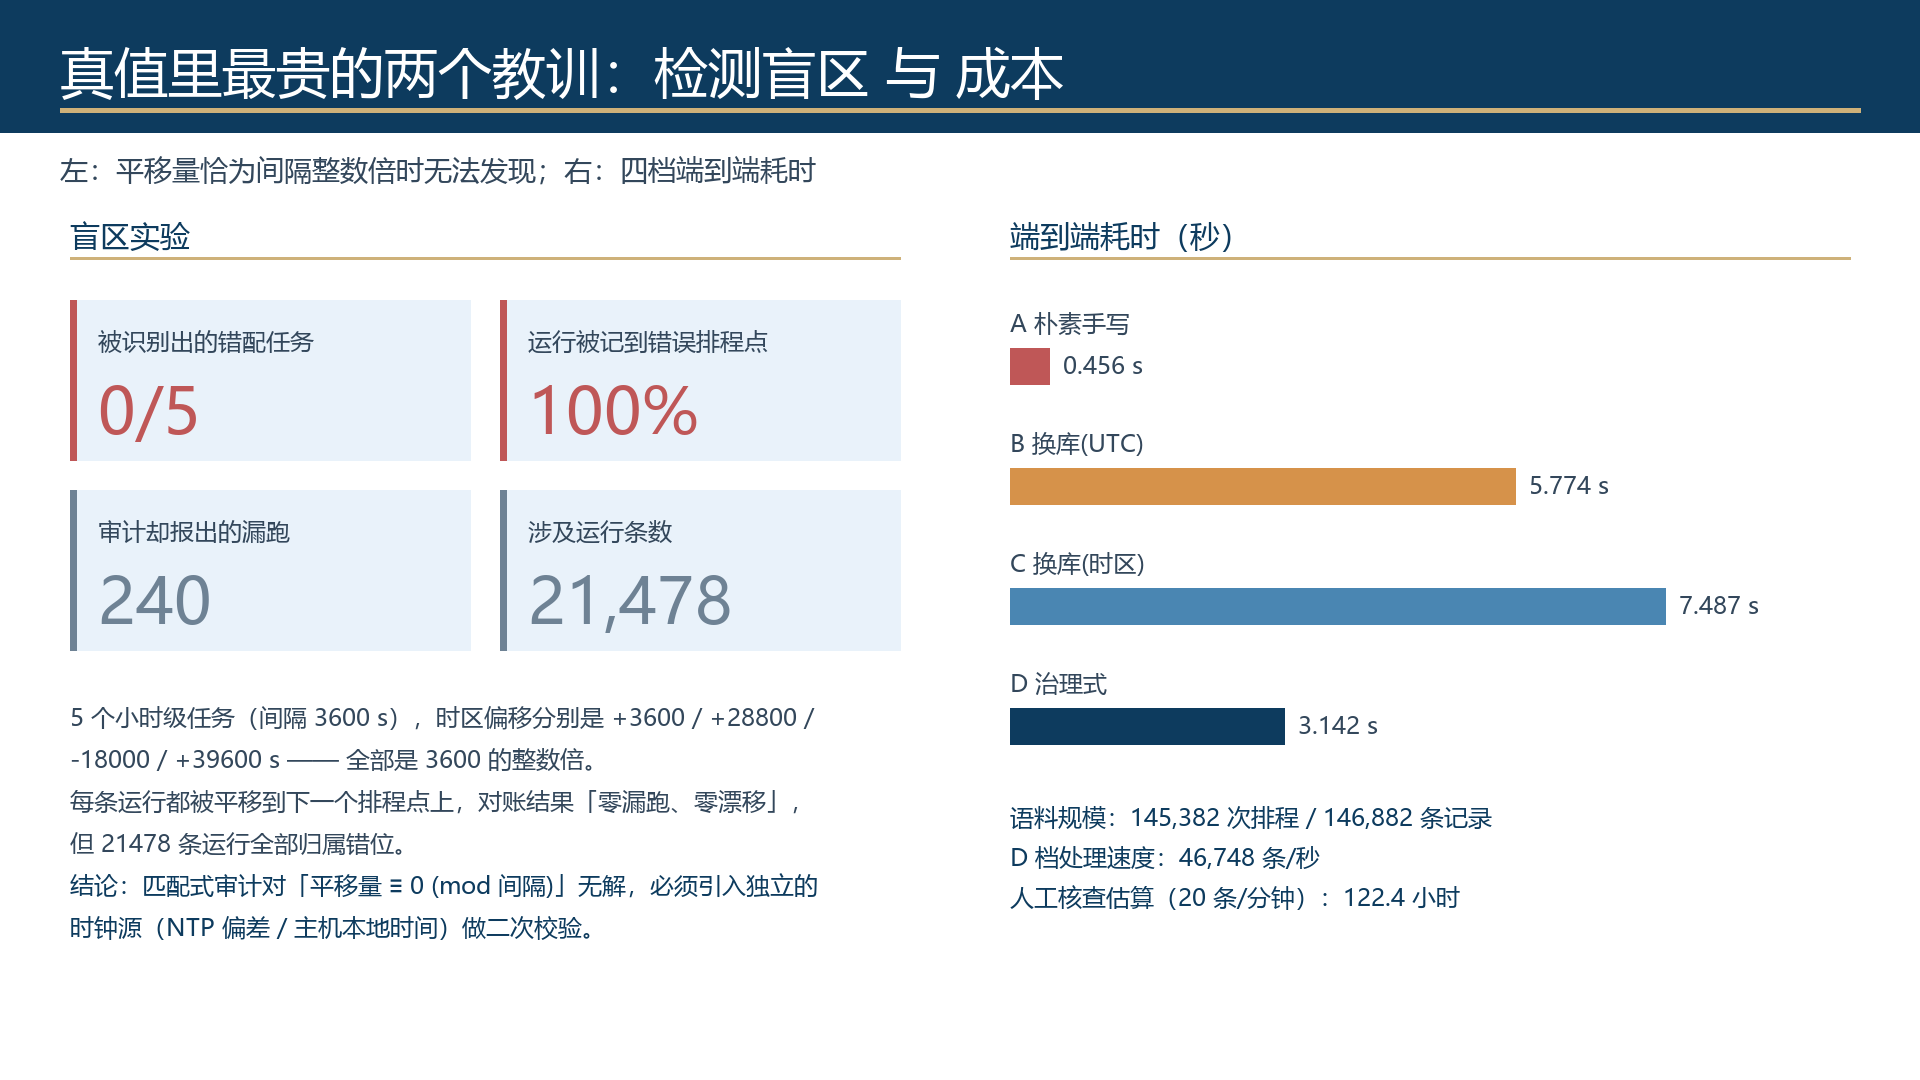
端到端耗时 | 0.456 s | 5.774 s | 7.487 s | 3.142 s |
几个值得停下来看的数字:
- A 档漏跑精确率只有 14.23%:报告里每 7 条"漏跑",6 条是冤案。根源就是第三层的时区错配——它把 18 个任务几千条"只是记错了时间"的运行,同时算成了漏跑和幽灵。
- B 档比 A 档还差:换库把字段语义修好了一点,但"从 UTC 起算"这个集成错误把时区全毁了。换库不等于治理,这是整篇最想强调的一句。
- C 档漏跑 F1 51.97:排程算对了(99.99%),但日志侧没有归因能力,几千条错配记录照样把精确率拖到 35.11%。
- D 档重叠识别 99.64%:700 对重叠检出 695 对、0 误报。剩下 5 对全部是同一个原因——上一个排程点本身有重复记录,检测器取到了未延长时长的那条副本。精确率优先,漏掉的 0.7% 如实报告。
- D 档吞吐 46,748 条/秒,全程 3.142 秒,比人工快 14 万倍。
五、可复制代码
治理式流水线的核心三段,脱敏后可直接改参数使用。
第一段,带语义补全的字段解析(区间、列表、步长、月末、最近工作日、第 N 个周几):
from datetime import date, timedelta

def parse_field(spec, lo, hi, names=None):
    spec = spec.strip().lower()
    if any(ch in spec for ch in "lw#"):
        raise Unsupported(spec)
    out = set()
    for part in spec.split(","):
        step = 1
        if "/" in part:
            part, s = part.split("/", 1)
            step = int(s)
        if part in ("*", "?"):
            base = list(range(lo, hi + 1))
        elif "-" in part:
            a, b = part.split("-", 1)
            a = names.get(a, a) if names else int(a)
            b = names.get(b, b) if names else int(b)
            base = list(range(int(a), int(b) + 1))
        else:
            base = [int(names.get(part, part)) if names else int(part)]
        out.update(base[::step])
    return out
第二段,本地墙钟转 UTC,同时处理"不存在的时刻"与"歧义时刻":
from zoneinfo import ZoneInfo
from datetime import datetime, timezone

def wall_to_utc(naive, tzname):
    z = ZoneInfo(tzname)
    for fold in (0, 1):          # 歧义时刻取首次
        aware = naive.replace(tzinfo=z, fold=fold)
        u = aware.astimezone(timezone.utc)
        if u.astimezone(z).replace(tzinfo=None) == naive:
            return u
    return None                  # 春季跳变空洞:跳过该次排程
第三段,对账:先识别日志整体平移(时区错配归因),再按"排程点为主键"匹配,最后分类五类异常:
def tz_infer(sched_list, recs, tol=120):
    """日志整体平移检测:±15 小时内取偏移众数"""
    counter = {}
    for start, _dur in recs:
        cand = [s for s in sched_list if abs(s - start) <= 54000]
        if not cand:
            continue
        delta = start - min(cand, key=lambda x: abs(x - start))
        if abs(delta) > max(tol, 600):
            key = round(delta / 600) * 600
            counter[key] = counter.get(key, 0) + 1
    if not counter:
        return 0
    off, cnt = max(counter.items(), key=lambda kv: kv[1])
    return off if cnt >= max(3, int(0.5 * len(recs))) else 0
匹配阈值有两个,都不是拍脑袋:落库抖动容忍 120 秒(本语料抖动上限 110 秒);漂移窗口取 min(3600, 间隔×0.45)——窗口一旦超过半个间隔,"这次运行到底属于哪个排程点"就不再有唯一答案,漂移和幽灵会互相污染。
六、踩坑清单
- 换库不等于治理。 B 档引了成熟库,F1 反而比 A 档更差。库解决字段语义,解决不了"你从哪个时区起算"。
- 日与周几同限时取"或"。 这是 POSIX/Vixie cron 的标准行为,写成"与"会静默错位,且不报任何错。
- 春季跳变那天的排程会凭空消失。 纽约 3 月 8 日、柏林 3 月 29 日的 02:00~03:00 不存在,参考引擎和审计引擎必须用同一套"空洞跳过"规则,否则这 24 次排程会被当成漏跑。
- 漂移窗口不能超过半个间隔。 窗口太大,漂移记录会被吸到邻近的排程点上,指标全部失真。
- 平移量恰为间隔整数倍时,匹配式审计无解。 这是本次最贵的发现,单独立了实验(见下)。
- 重叠注入要越过最大抖动。 前一跑的结束时间必须大于下一次排程加最大抖动,否则真值自身就是错的。
- 闰日表达式
0 0 29 2 *在非闰年合法且零执行。 审计不应把它报成异常,2026 年它就该一次都不跑。
七、盲区实验:21,478 条运行被记错位置,报告却是全绿
上面第 5 条值得单独一节。我们另取 5 个小时级任务(间隔 3600 秒),把它们的日志整体平移 +39600 / +28800 / -18000 / +3600 秒——全部是 3600 的整数倍。
结果:偏移识别 0/5,21,478 条运行 100% 被记到错误的排程点上,但对账报告只报了 240 条漏跑,其余全绿。因为每条平移后的记录都恰好落在下一个排程点上,"最近邻匹配"完美命中——只是全部命中在了错误的目标上。
结论很冷:基于匹配的对账,对"平移量 ≡ 0 (mod 间隔)"这类错位在数学上无解。工程上只有两条路:审计系统必须接入独立的时钟源(NTP 偏差、主机本地时间)做二次校验;或者在日志里强制写入调度器下发的"计划执行时刻"字段,而不是靠反推。
八、给 WorkBuddy 的提示词模板
把这段话直接丢给 WorkBuddy,就能复现这套审计:
请帮我做一次定时任务排程审计,要求: 1. 输入:排程定义(cron 表达式 + IANA 时区)和执行日志(时间戳+时长); 2. 先用独立参考引擎展开每个任务在窗口内的全部排程点, 本地时刻不存在(DST 空洞)跳过、歧义时刻取首次,并统计空洞次数; 3. 对账前先做日志整体平移检测(±15 小时偏移众数), 命中则先归因时区错配再修正,输出命中的任务清单; 4. 匹配阈值:抖动 120 秒,漂移窗口 min(3600, 间隔×0.45); 5. 输出五类异常清单(漏跑/重复/漂移/幽灵/并发重叠), 每类给精确率、召回率、F1,并给出前 20 条明细; 6. 全部结论必须给出可复现的中间数据,不允许估算。
九、收尾
这次的结论可以压缩成三句话:字段语义决定排程算得对不对,时区语义决定它对在哪个时区,日志归因决定审计报告可不可信。三层里任何一层偷懒,最终的报告都会以"看起来很全"的方式骗你——A 档那份 92 分的报告里,藏着 85% 的漏跑误报和 21,478 条记错位置的运行。
治理式流水线不是更复杂的算法,而是把三层的规则一个个补齐:语义补全、时区感知、以排程点为主键的对账,加上一句"识别不了的,如实说识别不了"。180 个任务、14.6 万条记录,3.1 秒跑完,六个指标里五个满分、一个 99.64%,连没做满的 0.36% 的原因都能指到具体的重复副本上——这才是一份敢拿去用的审计报告。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号