ACK 不是“收到”:实时数据接入系统中的成功语义
原创
ACK 不是“收到”:实时数据接入系统中的成功语义
原创
LeoCrawls
发布于 2026-10-23 10:55:03
发布于 2026-10-23 10:55:03
很多接入系统一出数据丢失,排查到最后,日志里通常都能看到一行很刺眼的话:
ACK 已返回。
发送端看到 ACK,以为数据进来了;接收端也觉得自己“处理成功”了。可隔半小时去查消息队列、查数据库、翻磁盘目录,数据就是没了。
问题恰恰出在这儿:ACK 从来不等于“收到”,它只等于“对方承诺到了某个状态”。
这个“某个状态”如果没有提前定义,系统量一上来,丢数据、重数据、延迟飙升,基本总得撞上一样。
我做数据管线这些年,见过太多系统把确认时机写成一句很轻飘的话——“处理完成后返回 ACK”。这句话放在 PRD 里没毛病,落到代码里就麻烦了:什么算处理完成?数据进了内存算不算?写入操作系统页缓存算不算?Kafka leader 收到算不算?数据库 INSERT 返回算不算?
每一层的答案都不一样。
先把四种“收到”分开
先说一个容易混淆的点:TCP 层的 ACK,不是应用层的 ACK。
TCP ACK 只说明一件事:对端内核已经收到了这个网络包,并且按序放进了接收缓冲区。它不说明业务程序已经 read(),更不说明数据写进了磁盘、消息队列或数据库。
所以你看到发送端的 TCP 连接稳定、重传率很低,最多只能证明网络传输这一段没出大问题。后面那几十行业务逻辑,TCP 根本管不着。
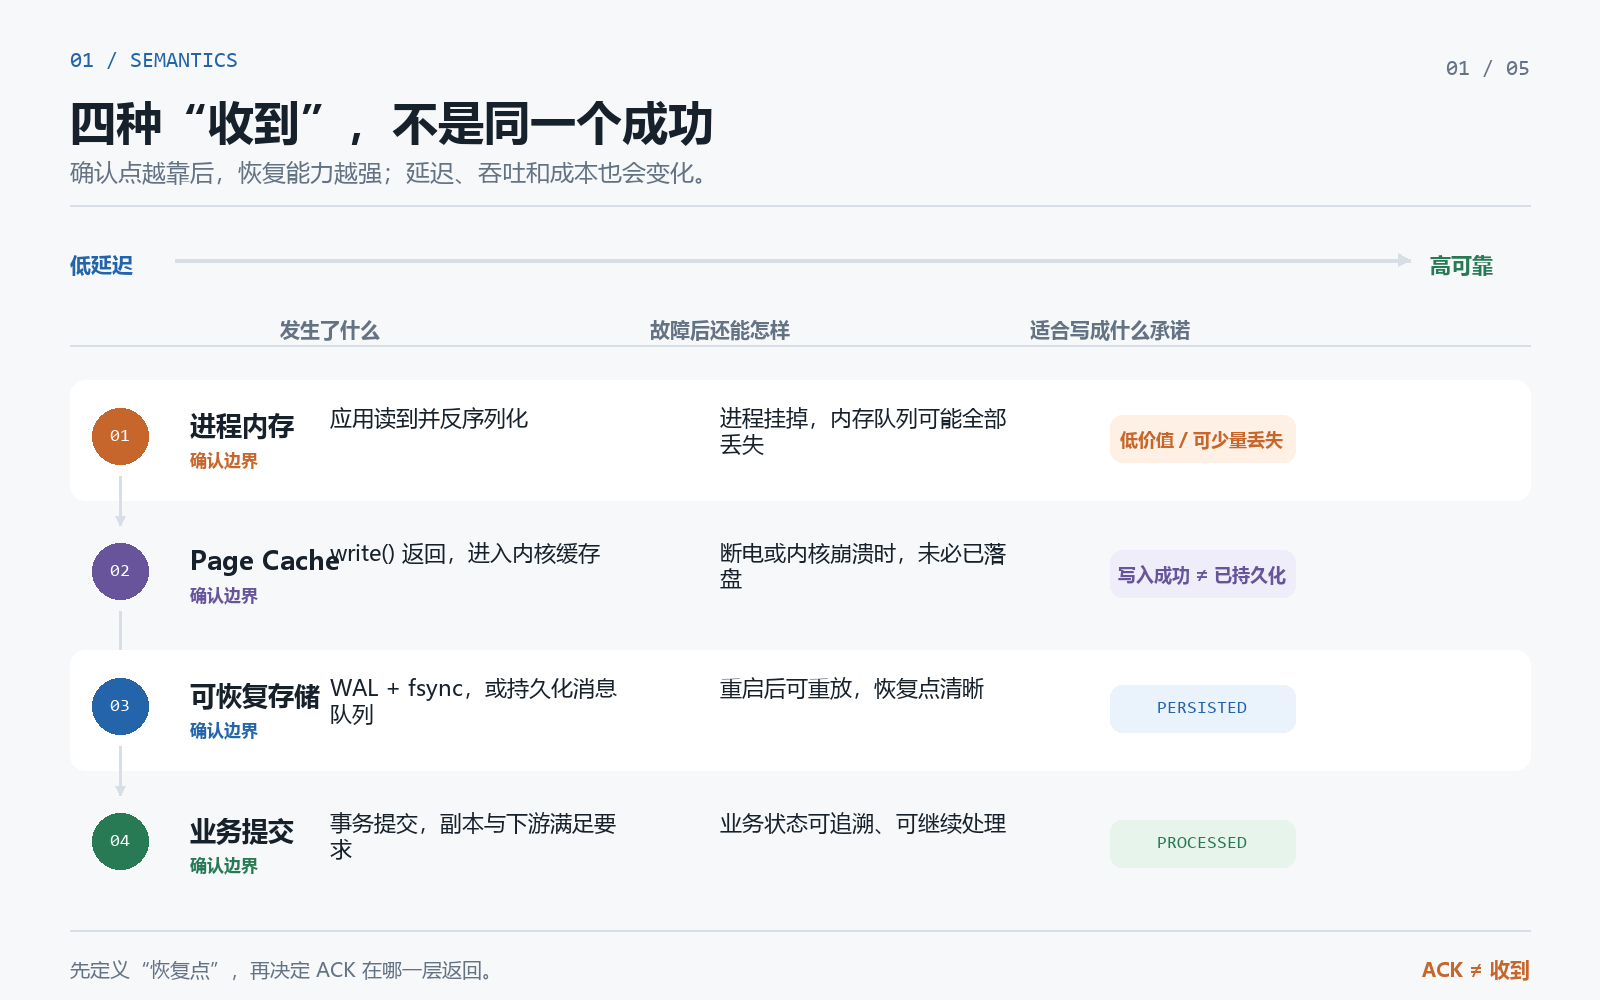
往下拆一层看,一个实时数据接入系统里,常见的“收到”至少有四种:
- 数据到了服务进程内存 应用程序从 Socket、HTTP 请求或 RPC 流里读到了数据,反序列化完成,准备处理。
- 数据写入了操作系统缓存 程序调用
write()成功,内核把数据放进 Page Cache。这个阶段通常很快,但机器断电或内核崩溃时,数据不一定已经落盘。 - 数据进入了可恢复存储 例如调用
fsync()后写入本地磁盘,或者写进具有持久化能力的消息队列日志。 - 数据完成了业务提交 例如数据库事务提交成功,且必要的副本、索引、下游事件都处在符合业务要求的状态。
这四个状态,延迟和可靠性差得不是一点半点。
只要 ACK 的含义没写清,发送端和接收端其实是在拿不同的尺子量“成功”。
最危险的确认:数据刚进内存就回 ACK
最常见的实现是这样的:
 接收数据
 → 放入内存队列
 → 返回 ACK
 → 异步写 Kafka / 磁盘 / 数据库
它的优点很明显:快。网络一到,马上确认,发送端不用堵着等,接收端的吞吐也能拉高。
问题也很明显:内存不是恢复点。
假设服务刚返回 ACK,数据还躺在内存队列里,进程 OOM 了、机器重启了、容器被调度走了,或者部署时有人手快滚了一版,这批数据就没了。发送端因为已经收到了 ACK,不会再重发。
完了。
2022 年我还在做数据平台时,接过一类典型的新闻信源接入:上游通过长连接推送增量内容,接收端先把消息塞进本地内存 Channel,再由消费者批量写入 Kafka。正常情况下跑得飞快,压测曲线也很好看。
后来有一次消费者卡住,内存堆积,服务被 OOM Killer 干掉。上游那边早就拿到了 ACK,重连之后从最新 offset 继续推,中间那一段消息没人补得回来。
桌上那杯美式已经凉了,工单系统红点还在往上跳。
这类设计不是不能用,只不过它适合的场景很窄:允许少量丢失,且更看重低延迟和高吞吐。比如部分监控指标、点击流采样、调试日志。你得先承认它会丢,再谈怎么把丢失控制在可接受范围内。
不能一边说“实时”,一边默认“可靠”。
写进本地磁盘,也不一定真落盘
很多人意识到内存不可靠后,会改成:
 接收数据
 → 写本地文件
 → 返回 ACK
→ 异步上传或消费这比纯内存强,但这里还有一个坑:write() 成功,不代表数据已经写到了物理磁盘。
在 Linux 里,普通文件写入通常先进 Page Cache。内核会择机把脏页刷到磁盘,时间取决于系统状态、参数和负载。程序拿到“写成功”的返回值,实际上只是把数据交给了操作系统。
如果你的确认语义是“机器掉电后也必须能恢复”,那就需要更强的边界:
 写入本地 WAL / Append-only Log
 → fsync 或 fdatasync
 → 返回 ACK
这时 ACK 的含义才可以写成:
该记录已持久化到本机可恢复日志中,即使进程重启,可以通过日志重放恢复。
代价也很实在:fsync 会拖高尾延迟,还可能把磁盘 IOPS 打满。单条数据来一条刷一次盘,吞吐通常很难看;按时间窗口或按批次 group commit,吞吐会好很多,但每条消息要多等一个批次窗口。
这就是确认策略的第一条原则:
ACK 不能脱离恢复点谈。你准备从哪里恢复,ACK 就至少要晚于哪里。
消息队列确认:别只看“写进去了”
接入层用消息队列做缓冲很常见,尤其是 Kafka、Pulsar 这类可持久化日志系统。常见链路会变成:
 发送端
 → 接入服务
 → 消息队列
 → 消费者
 → 数据库 / 检索系统 / 对象存储
这时要先问清楚:ACK 是由谁返回的?
如果接入服务把消息交给 Producer 就立刻确认,Producer 还没拿到 Broker 的响应,那只是“准备发送”,不算持久化。
如果 Broker leader 收到数据后就确认,那么 leader 宕机、而副本还没同步完成时,已经返回 ACK 的消息仍可能丢。
如果等 ISR 副本集合满足要求后再确认,可靠性上来了,延迟也会上去,吞吐还会受副本同步速度影响。
所以队列层的 ACK,通常要拆成两层看:
- Producer ACK:消息是否已经按设定的副本策略写入 Broker;
- Consumer ACK / Offset Commit:消费者是否已经把这条消息处理到可以安全跳过的程度。
第二层更容易写错。
消费者从 Kafka 拿到一条消息后,如果先提交 offset,再写数据库:
 消费消息
 → 提交 offset
 → 写数据库
中间只要数据库写失败或进程崩溃,消息在队列看来已经消费过了,数据就丢了。
反过来,如果先写数据库,再提交 offset:
 消费消息
 → 写数据库
 → 提交 offset
中间如果数据库写成功、offset 还没提交,进程崩了,重启后会重复消费。
这地方很多人踩坑——先提交容易丢,后提交容易重。二选一时,绝大多数业务宁愿接受重复,也不该接受悄悄丢失。
原因不复杂:重复是可以设计处理掉的,丢失往往连补都没法补。
At-least-once 不高级,但往往更诚实
很多系统设计文档喜欢写“Exactly-once”,看上去很稳。实际工程里,端到端的 Exactly-once 比想象中难得多。
你想想,一条数据可能经过接入服务、消息队列、多个消费者、数据库、对象存储和下游回调。只要其中两个系统没有共享事务,就会遇到经典问题:
数据库提交成功了,但消息确认没发出去,算成功还是失败?
这不是多加一个 try-catch 就能解决的。
实际工程里,更常见、也更靠谱的路线是:
传输层做到 at-least-once,业务层通过幂等把重复收敛掉。
也就是允许发送端因为超时、断连、重试而重复发;允许消费者因为崩溃恢复而重复处理;但保证同一条业务事件重复到达时,最终状态不被重复污染。
幂等不是一句“数据库加唯一索引”就结束了,不过唯一索引确实是最常用的底座。
一条进入系统的数据,最好从源头就带上稳定的事件 ID,例如:
event_id = source_id + source_sequence或者由发送方生成全局唯一 ID。关键不在于 UUID 长什么样,而在于:同一个业务事件重试十次,ID 必须还是同一个。
数据库侧可以这样处理:
 INSERT INTO ingest_event (
   event_id,
   source_id,
   payload,
   received_at
 )
 VALUES (?, ?, ?, NOW())
 ON CONFLICT (event_id) DO NOTHING;
如果重复写入,数据库不新增记录;如果后续还有聚合、计费、状态流转,也要保证这些操作基于同一个幂等键,而不是每收到一次就加一次。
这里有个常被忽略的问题:有些业务的“重复”不是完全相同的数据。
比如同一个订单 ID 先推送“已创建”,后推送“已支付”,再因为网络重试把“已创建”重发一次。你不能只按订单 ID 去重,否则会把合法状态更新一起吞掉。
这种场景更适合用:
- 业务主键 + 事件版本号;
- 业务主键 + 单调递增序列;
- 业务主键 + 状态机约束;
- 业务主键 + 更新时间与条件更新。
说白了,幂等的对象不是“这条 JSON”,而是“这次业务状态变化”。
崩溃恢复,才是 ACK 语义的验收题
一个确认策略靠不靠谱,不要只看压测吞吐,拿下面几个问题过一遍更有用:
- ACK 返回后,进程立刻崩溃,数据还能找到吗?
- ACK 返回后,机器掉电,数据还能恢复吗?
- 消费者处理成功但没提交位点,重复执行会怎样?
- 数据库事务提交成功、回执丢失,发送端重试会怎样?
- 同一条消息在不同分区、不同节点乱序到达,会不会覆盖正确状态?
- 灰度发布时,老版本和新版本对同一事件的解析规则不一致,会不会制造重复或丢失?
这几道题过不去,文档里写再多“高可用”“最终一致性”都没意义。
我自己更偏向把接入系统拆成两个明确阶段:
阶段一:可恢复接收
接收数据
→ 写入持久化日志或可靠消息队列
→ 返回接收 ACK
阶段二:业务处理
消费持久化事件
→ 幂等写入业务存储
→ 提交消费进度 / 返回处理 ACK第一阶段只承诺“我不会把这条数据弄丢”;第二阶段才承诺“它已经被业务系统正确处理”。
这两个 ACK 不要混。
尤其是对外接口,最好把状态名称写得直白一点:
ACCEPTED:已被接收,等待处理;PERSISTED:已写入可恢复存储;PROCESSED:业务处理完成;FAILED_RETRYABLE:暂时失败,可重试;FAILED_FINAL:不可恢复失败,需要人工或业务侧处理。
别全都叫 success=true。后面排障时,你会感谢当初多写的这几个字。
不同业务,确认点应该不一样
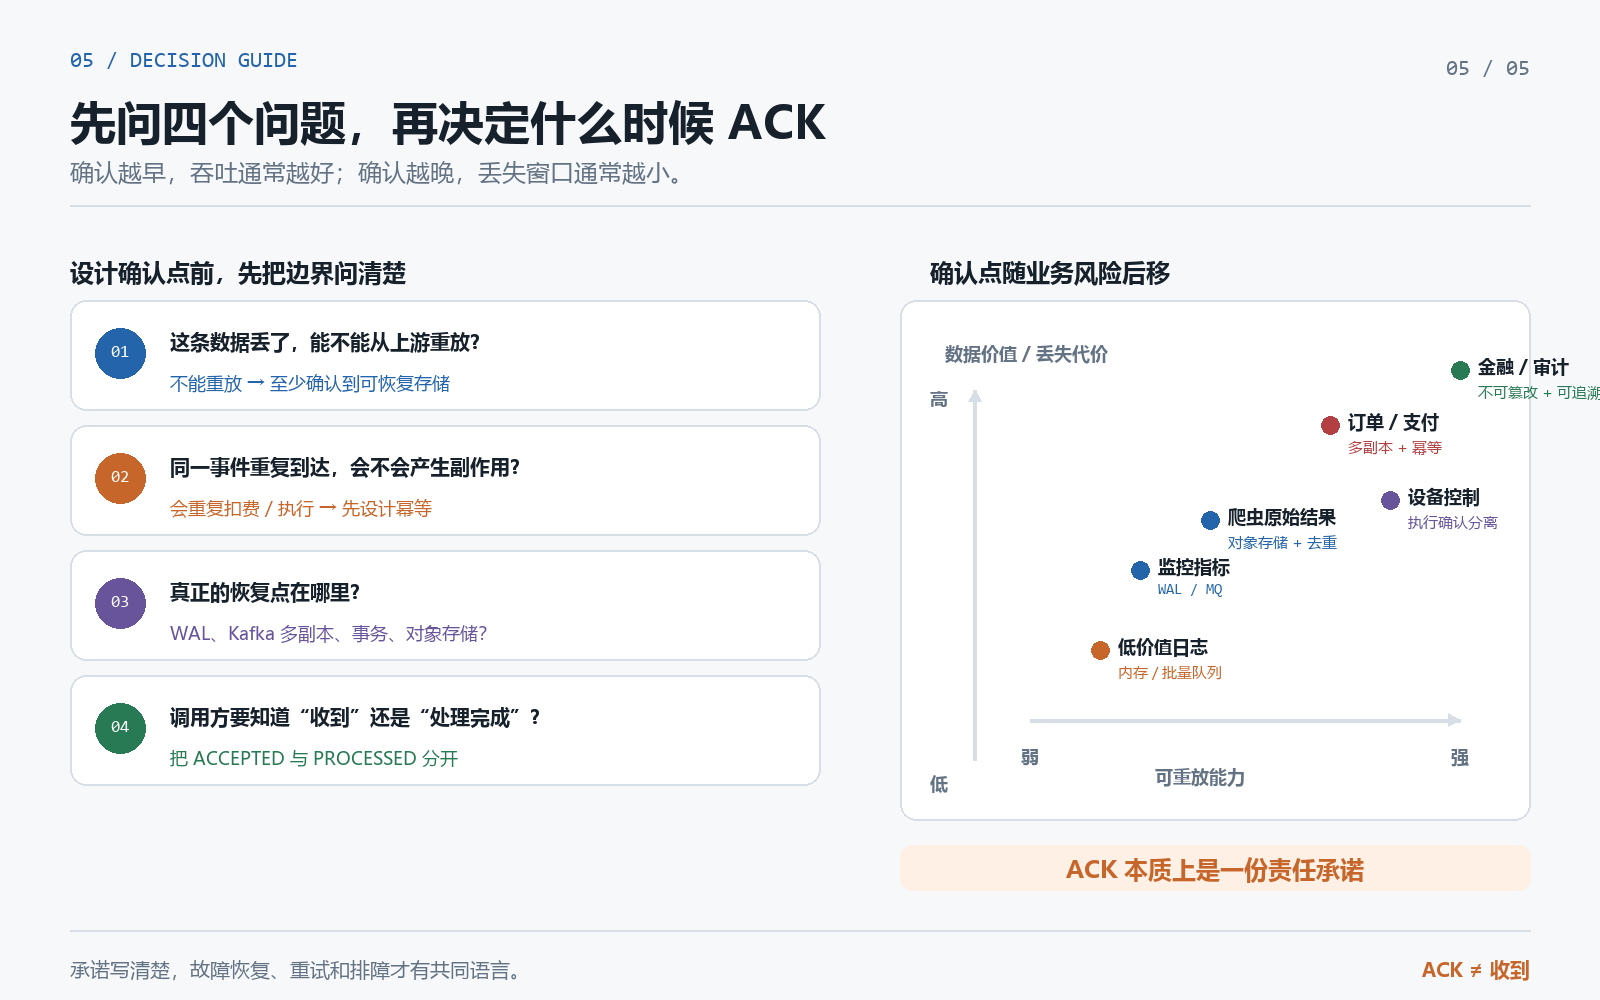
没有一个放之四海而皆准的 ACK 时机。确认得越早,吞吐通常越好;确认得越晚,丢失窗口越小。该怎么选,得看数据价值、可重放能力、时延预算和重复成本。
场景 | 推荐确认点 | 可接受语义 | 重点防什么 |
|---|---|---|---|
调试日志、低价值埋点 | 入内存队列或批量写队列后 | 可少量丢失 | 防止队列无限堆积 |
监控指标、时序数据 | 本地 WAL 或消息队列持久化后 | At-least-once | 防止批量丢失和时间乱序 |
爬虫原始抓取结果 | 对象存储或消息队列持久化后 | At-least-once + 去重 | 防止重复抓取、重复落库 |
订单、支付、计费事件 | 多副本持久化后,业务侧幂等提交 | 强 at-least-once | 防止静默丢单 |
设备控制、任务下发 | 设备明确执行并回传状态后 | 命令确认与执行确认分离 | 防止“已接收但未执行” |
金融、审计、合规记录 | 不可篡改日志持久化并完成必要副本后 | 可追溯、可重放 | 防止数据缺口与证据链断裂 |
表里最容易被忽略的是“设备控制、任务下发”。
比如你给某个采集节点下了一条“停止任务”的命令,节点 TCP 收到了,不代表任务已经停;节点把命令写进本地队列,也不代表执行器已经消费;执行器消费了,还不代表相关资源已经释放。
这种场景至少要区分:
 命令已接收
 → 命令已持久化
 → 命令已开始执行
 → 命令执行完成
把第一个状态当成最后一个状态,生产环境迟早要还债。
最后给一套能落地的判断方法
如果你正在设计一个新的数据接入接口,我建议别先问“什么时候返回 ACK”,先按下面四件事把边界写出来:
- 这条数据丢了,能不能补? 能从上游重放,就可以接受较早 ACK;不能补,就至少确认到可恢复存储。
- 这条数据重复了,业务会不会出事? 会重复扣费、重复通知、重复执行的,必须把幂等键、状态机或去重窗口设计在确认逻辑前面。
- 真正的恢复点在哪里? 是本地 WAL、Kafka 多副本、数据库事务,还是对象存储?不要把“进入内存”误当成恢复点。
- 调用方到底需要知道什么? 它需要的是“系统已收到”,还是“业务已处理完成”?这两个承诺不能用一个模糊的 ACK 混过去。
ACK 本质上不是网络报文,也不是一个 HTTP 200。
它是一份承诺:从这个时刻开始,这条数据的责任由谁承担,出了故障以后,靠什么恢复,重复来了又怎么处理。
把这份承诺写清楚,系统才算真的接住了数据。
否则,“收到”两个字,很多时候只是把数据丢失的时间往后推了几分钟。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号