面向 AIOps 的Skills 架构设计 --让企业 Know-How 可被 Agent 复用、组合与治理
原创
面向 AIOps 的Skills 架构设计 --让企业 Know-How 可被 Agent 复用、组合与治理
原创
用户12018079
发布于 2026-10-23 14:45:03
发布于 2026-10-23 14:45:03
导读
大部分 AIOps 项目卡住的地方,并不是模型不够聪明,而是一线运维的经验从来没有被「变成机器能用的东西」。
本文基于企业实践,把运维 Runbook 抽象为 Skill,用 L0–L4 五层架构承载「通用—专业—个人—外部」四类能力,并通过调用约束、派生继承、CI 门禁三道机制,让 Know-How 从「某个老师傅的脑子里」变成「企业能力目录中的资产」。
一、AIOps 真正的瓶颈,不在模型
过去两年,我们见过太多 AIOps 的演示:把告警喂给大模型,几秒钟吐出一段像模像样的分析;把日志丢进去,模型能总结出可疑堆栈。演示很漂亮,但真到了值班现场,几乎都会遇到同样四个问题。
第一,告警过载没有缓解。 监控、日志、链路追踪、CMDB、工单系统分布在不同的平台,值班同学要在五六个界面之间来回切换。AI 只是又多给了一段文字,切换次数并没有减少。
第二,判断依然依赖经验。 一条「接口响应超时」,是先看连接池还是先看下游依赖?先查最近变更还是先看机器负载?这些判断顺序,往往只存在于少数资深工程师的脑子里。模型并不知道你们公司的「排查习惯」。
第三,Runbook 没法直接自动化。 企业里普遍积累了大量 Word、PDF 版的操作手册。它们本质上是「给人看的操作清单」——没有结构化的输入输出,没有前置条件,没有异常分支,更没有权限边界。让 Agent 照着文档一步步点,风险比人工还高。
第四,工具高度碎片化。 每个团队都有自己的脚本、内部接口、小程序。调用方式各不相同,没有统一入口,也就谈不上复用和治理。
把这四点放在一起,结论其实很清楚:
AIOps 的瓶颈不是推理能力,而是企业运维经验尚未被转化为可被 Agent 调用的标准化能力。
模型是通用的,经验是企业独有的。谁先把经验「资产化」,谁才可能真正把 AIOps 跑出生产价值。
二、从 Runbook 到 Skill:一次概念上的迁移
我们对这件事的起点,是把两个词区分清楚。
维度 | Runbook | Skill |
|---|---|---|
定位 | 说明书 | 能力单元 |
面向对象 | 人 | Agent |
描述内容 | 「怎么做」 | 「能做什么」 |
边界 | 靠人理解和把握 | Schema 强约束 |
可复用性 | 复制粘贴 | 注册、编排、复用 |
可治理性 | 几乎为零 | 版本、权限、审计 |
Runbook 是说明书,它假设执行者会理解上下文、会临场判断、会知道什么不能做。
Skill 是能力单元,它必须自带四件事:
• 最小可执行:一件事只做一件事,输入输出边界清晰;
• 结构化 IO:入参出参用 JSON Schema 定义,能被编排器精确串联;
• 可观测:每次调用都有耗时、返回码、关键入参,出了问题能复盘;
• 最小权限:它能访问什么数据、能操作什么系统,是被声明和校验的。
做到这四点,「经验」才第一次具备了被机器安全调用的资格。而真正的价值不在于单个 Skill 有多聪明,而在于它们能像乐高一样被组合成一条完整的处置链路。
三、L0–L4:用分层解决「通用」与「专业」的矛盾
如果只允许一种 Skill 存在,架构立刻会陷入两难:做成通用的,就满足不了部门的专业场景;做成专业的,就到处都是重复实现。我们的解法是分层。五层,各管一段。
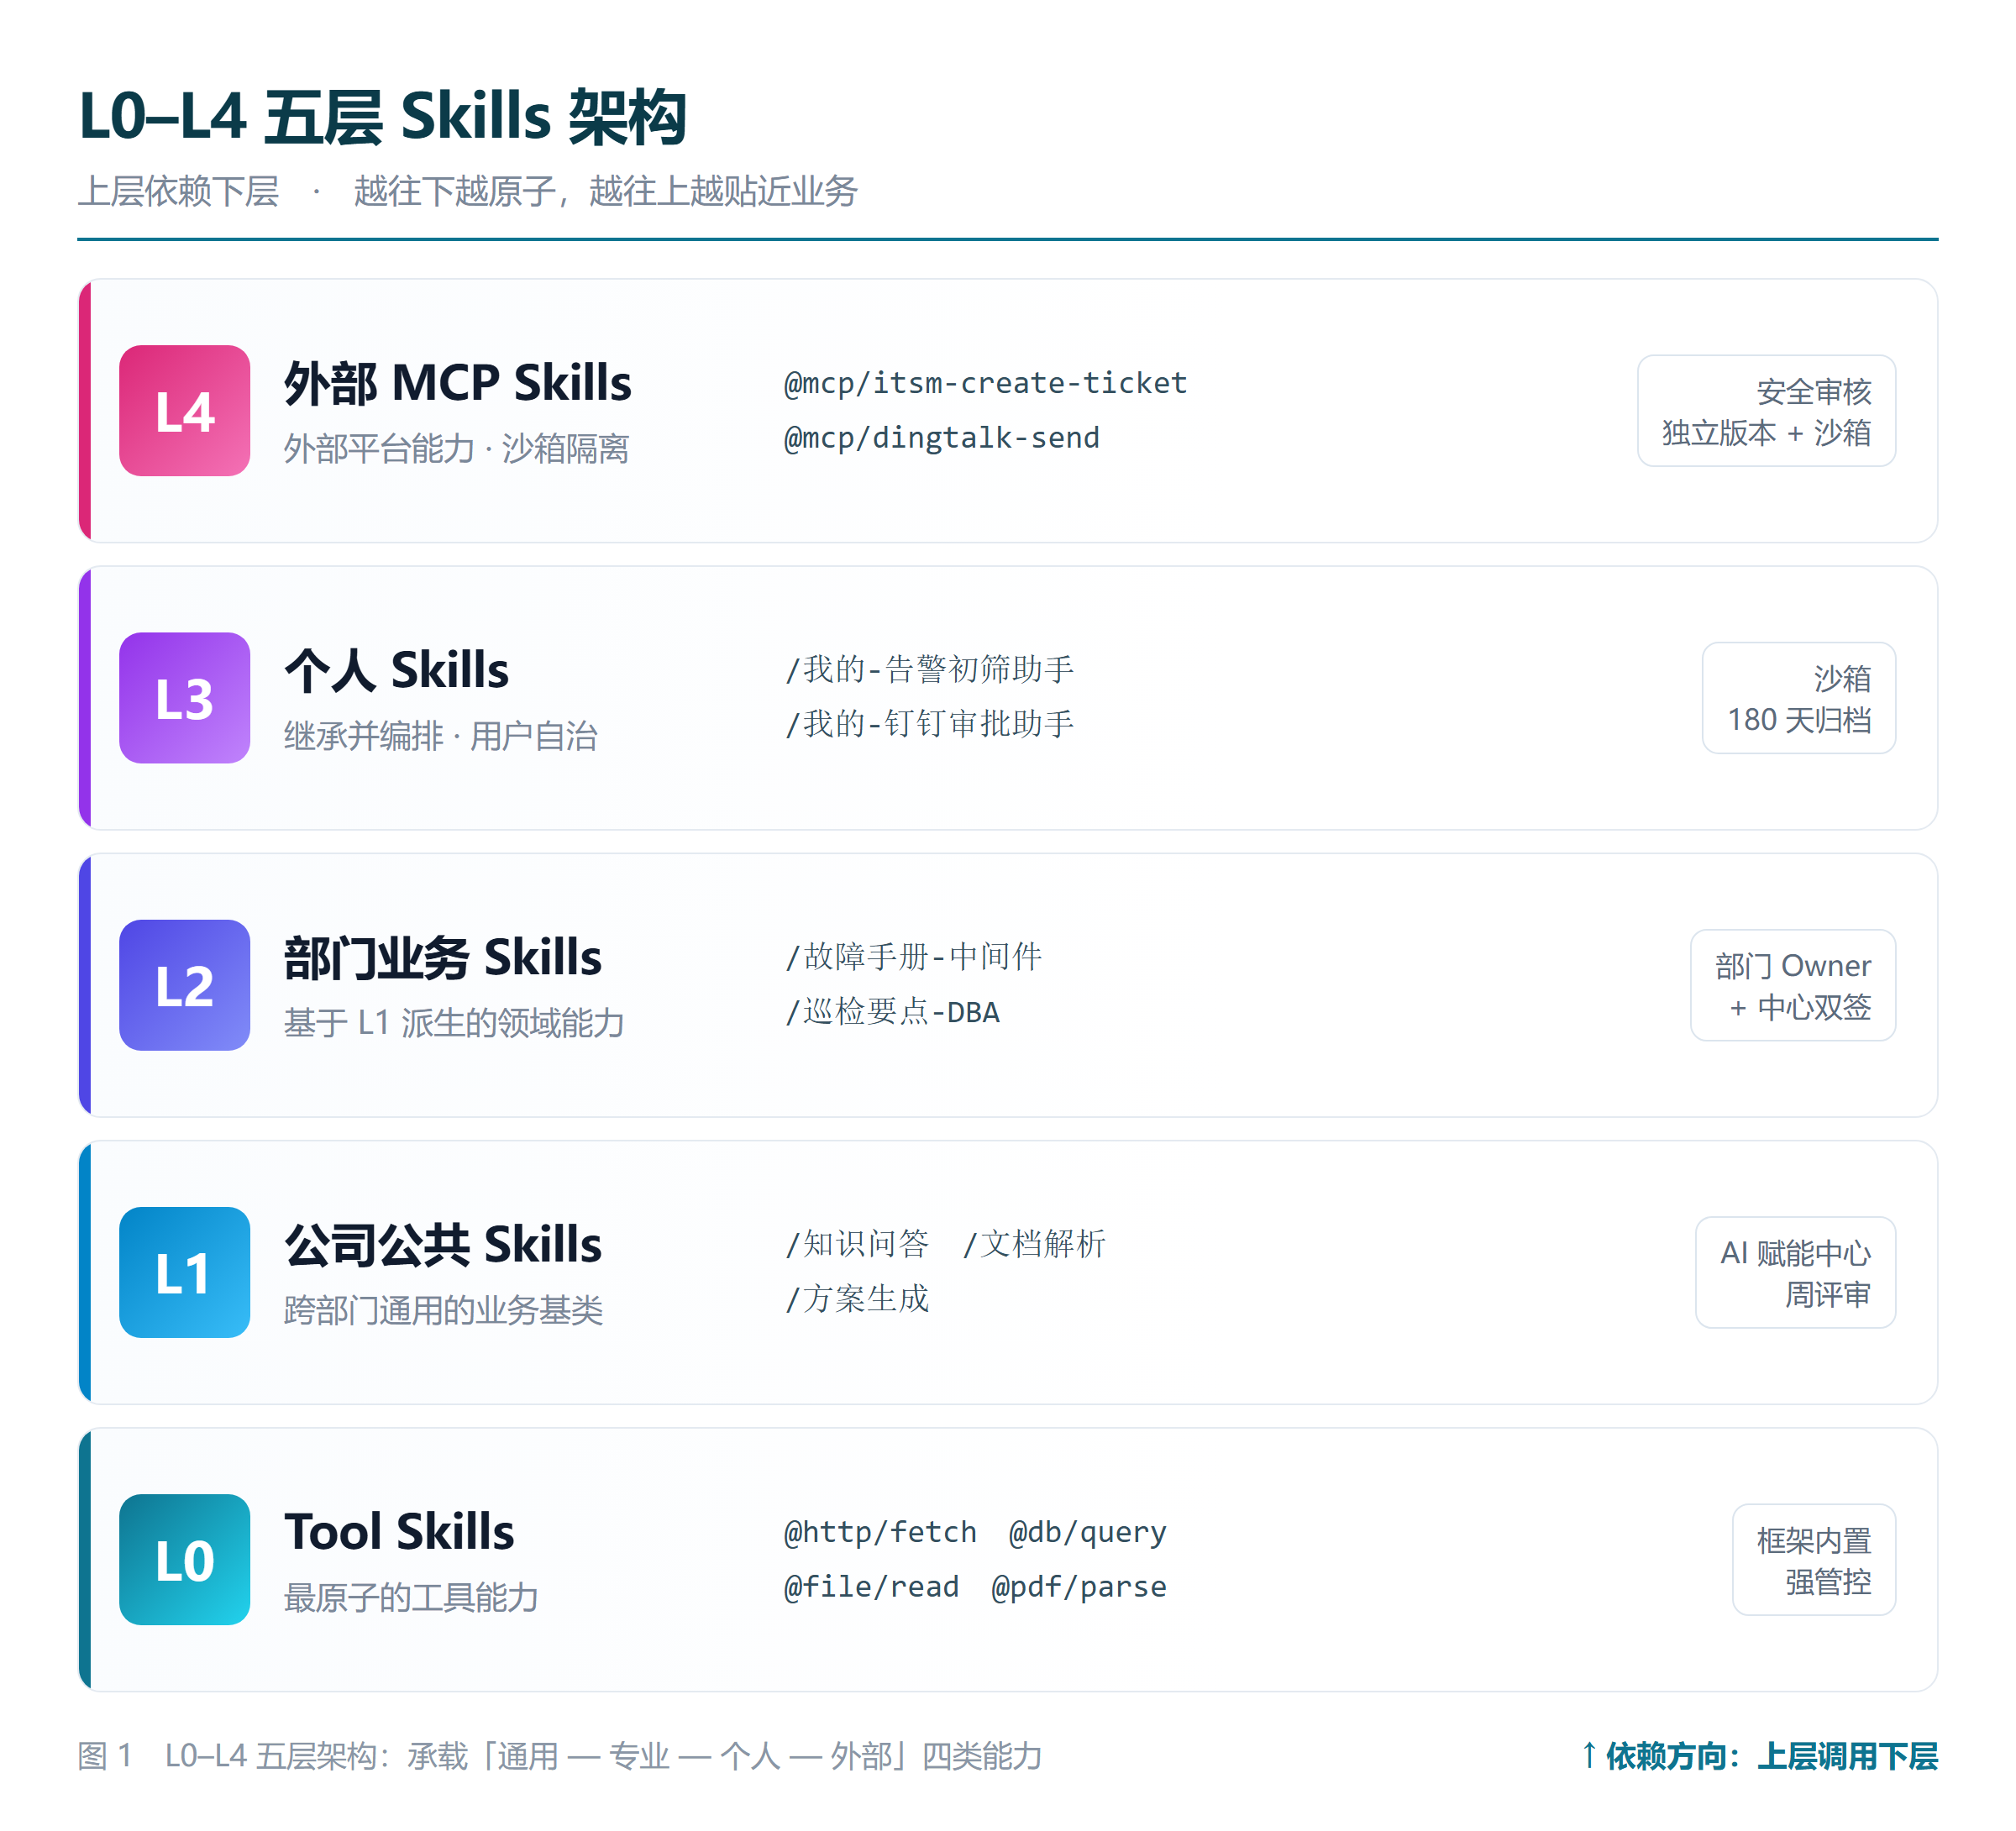
fig1-arch
层级 | 定位 | 典型能力 | 治理方式 |
|---|---|---|---|
L0 Tool | 最原子的工具能力,框架内置 | @http/fetch、@db/query、@file/read、@pdf/parse | 框架强管控,仅中心维护 |
L1 公共 | 跨部门通用的业务基类 | /知识问答、/文档解析、/方案生成 | 中心主导 + 周评审 |
L2 部门 | 基于 L1 派生的领域能力 | /故障手册-中间件、/巡检要点-DBA | 部门 Owner + 中心双签 |
L3 个人 | 继承并编排的个性化能力 | /我的-告警初筛助手 | 用户自治 + 沙箱 + 180 天归档 |
L4 MCP | 外部平台能力 | @mcp/itsm-create-ticket、@mcp/dingtalk-send | 安全审核 + 独立版本 + 沙箱 |
分层的意义不只是「分类」,而是让每一层只解决一类问题:
• L0 追求稳定,一次实现,处处可用;
• L1 追求通用,把跨部门共性的能力抽象出来;
• L2 追求专业,把一个领域的隐性经验固化下来;
• L3 追求灵活,允许值班同学按自己的习惯快速组合验证;
• L4 追求隔离,外部平台再怎么变,也伤不到核心业务。
3.1 真正的关键,是调用约束
分层谁都会画,难的是「不许乱调」。我们在规范里写死了一张调用矩阵:
调用方 \ 被调方 | L0 | L1 | L2 | L3 | L4 |
|---|---|---|---|---|---|
L0 Tool | — | — | — | — | — |
L1 公共 | ✓ | — | — | ✕ | ✕ |
L2 部门 | ✓ | — | — | ✕ | ✕ |
L3 个人 | ✓ | ✓ | ✓ | ✓ | ✓ |
L4 MCP | — | — | — | — | — |
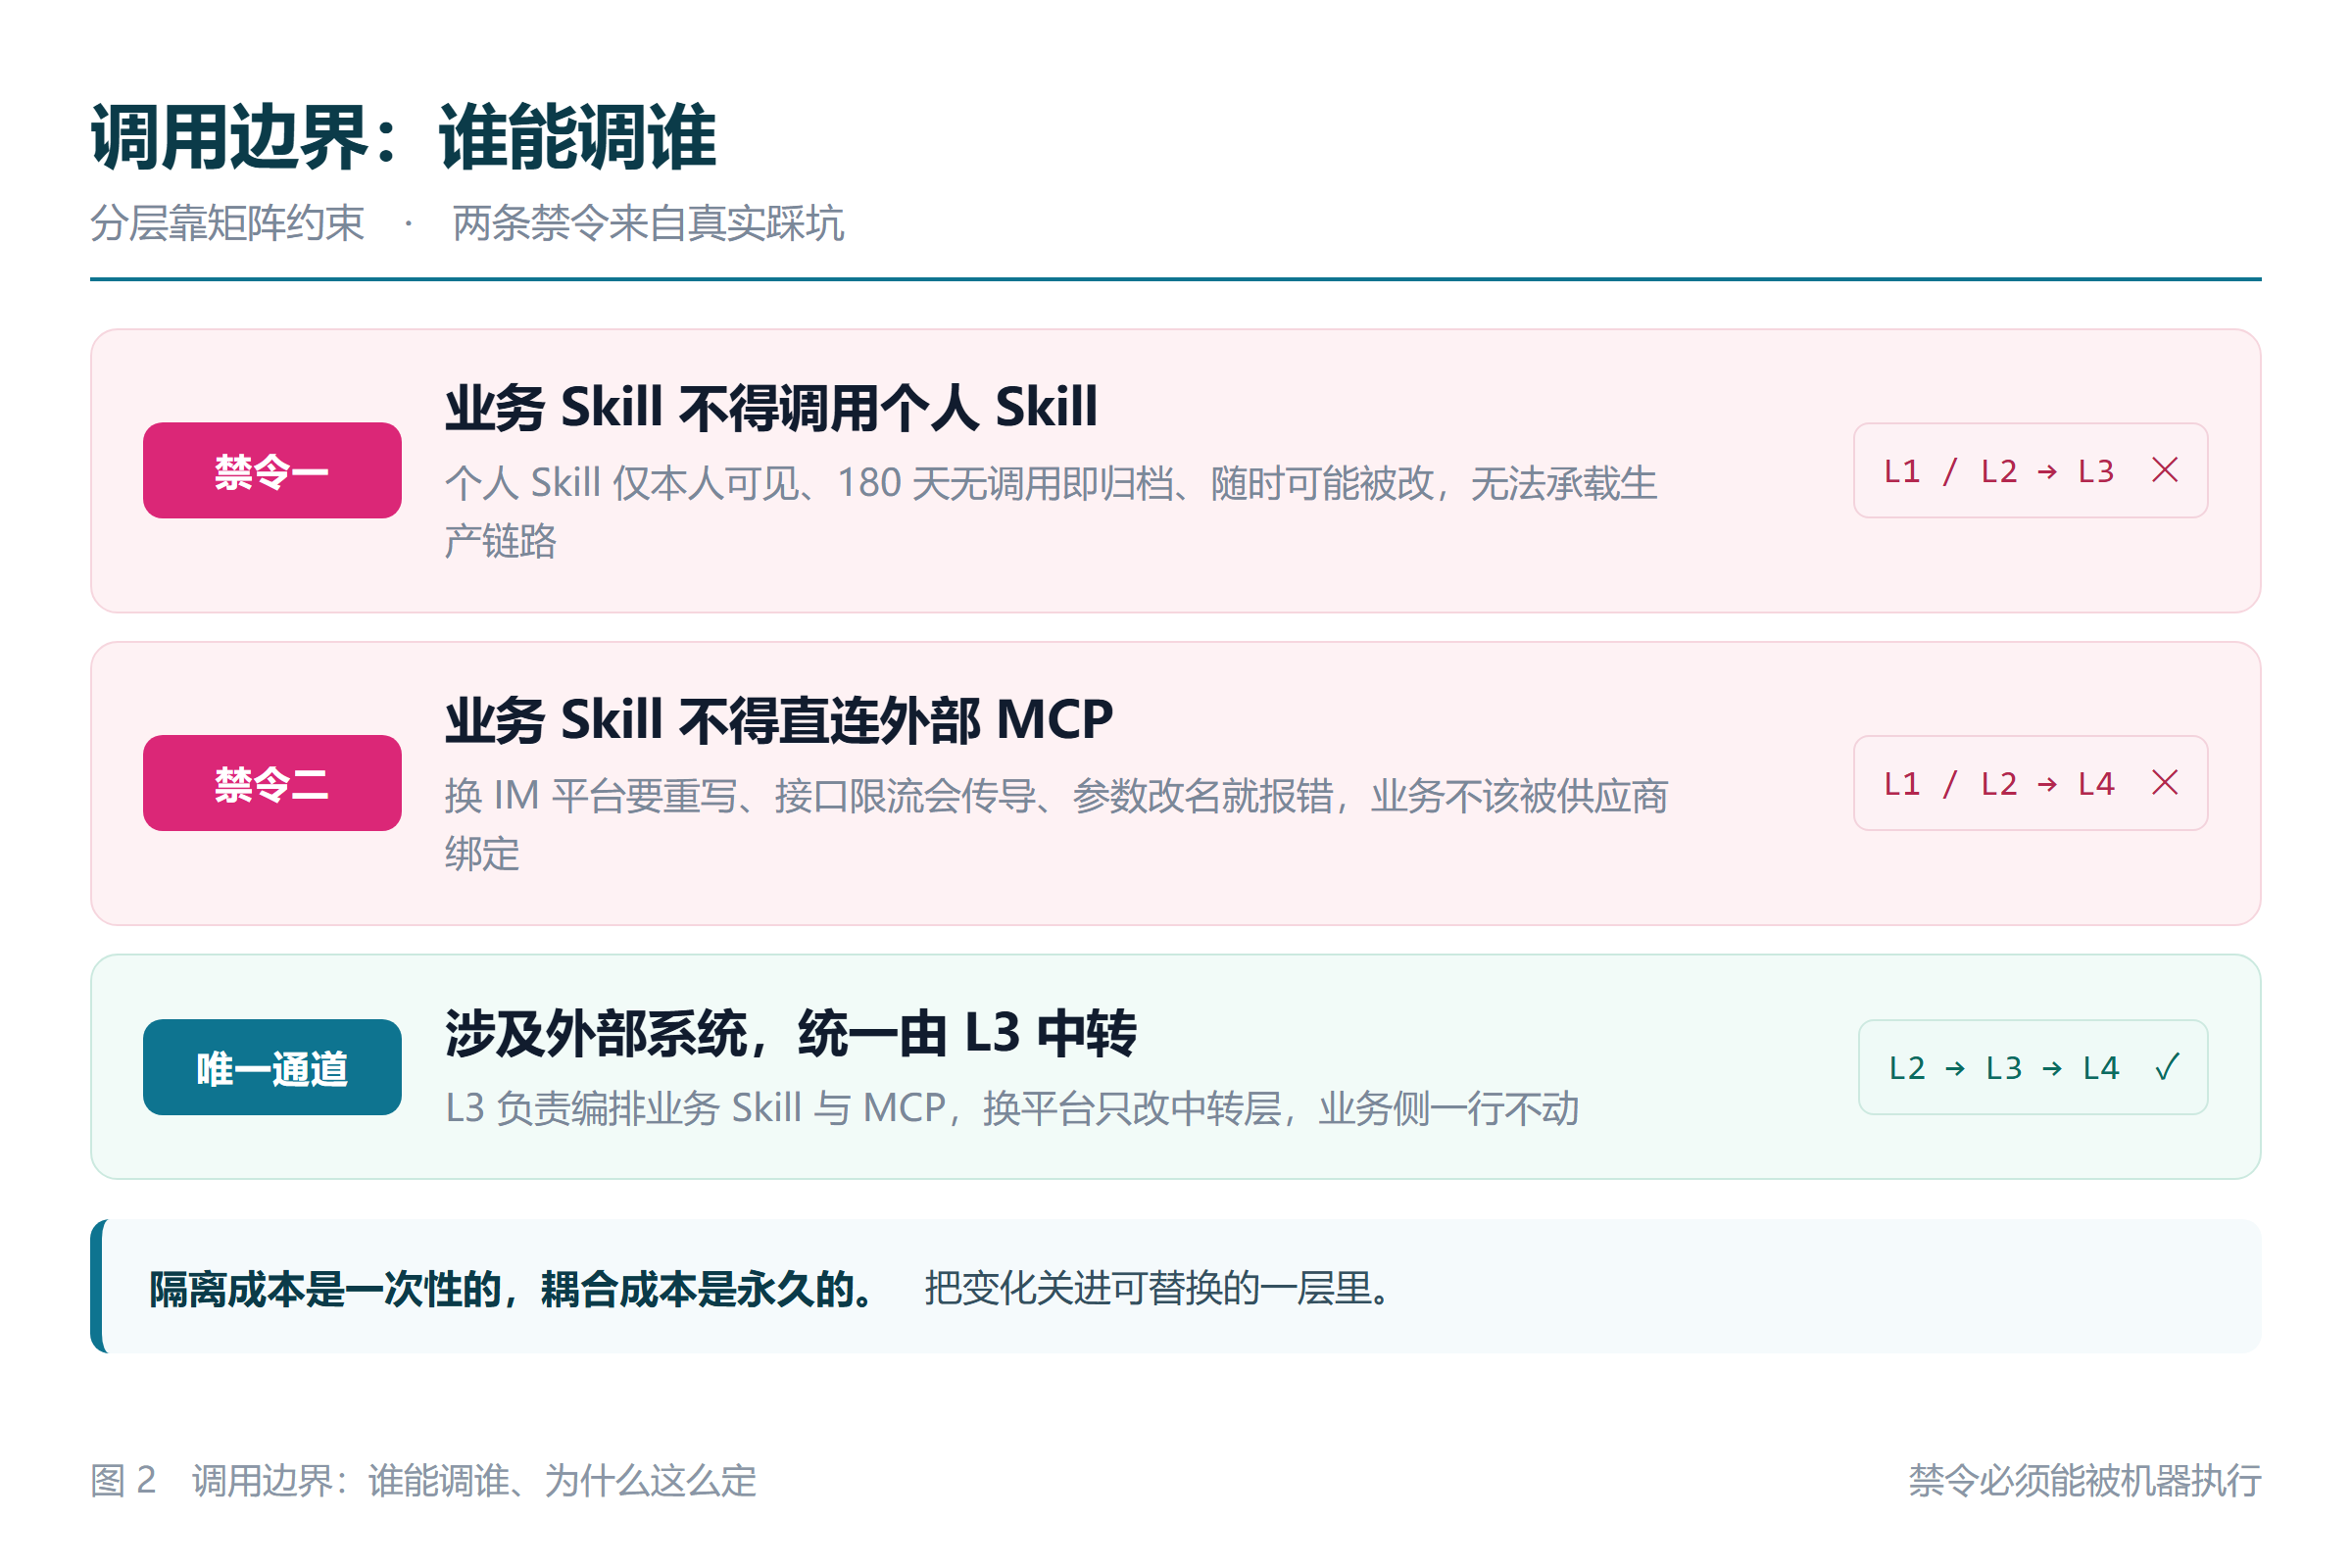
fig2-boundary
两条禁令背后是两次真实踩坑的教训。
禁令一:业务 Skill 不允许调用个人 Skill。 个人 Skill 有三个天然属性:只有本人可见、180 天不调用自动归档、随时可能被改。只要一条生产处置链路依赖了它,就等于把稳定性绑在了某个人的账号和习惯上。今天能跑,明天那个人调岗了就跑不了。
禁令二:业务 Skill 不允许直连外部 MCP。 假设 /合同审核 直接调用了钉钉审批的 MCP。半年后公司换 IM 平台,这条链路要重写;钉钉接口限流,合同审核跟着超时;MCP 的作者改了个参数名,业务侧全线报错。业务不该被外部供应商绑定。
解法是让 L3 做中转层:
L2 /合同审核-gm 纯净业务,不碰外部 ↑ L3 /我的-钉钉审批助手 中转 + 编排 ↓ L4 @mcp/dingtalk-approval
换平台时只改中转层,业务 Skill 一行不动。这个设计在后续反复被验证是值得的:隔离成本是一次性的,耦合成本是永久的。
3.2 派生与继承:只做加法
分层之后,专业化和个性化靠「派生」实现,规则只有一条:只能做加法,不能做减法。
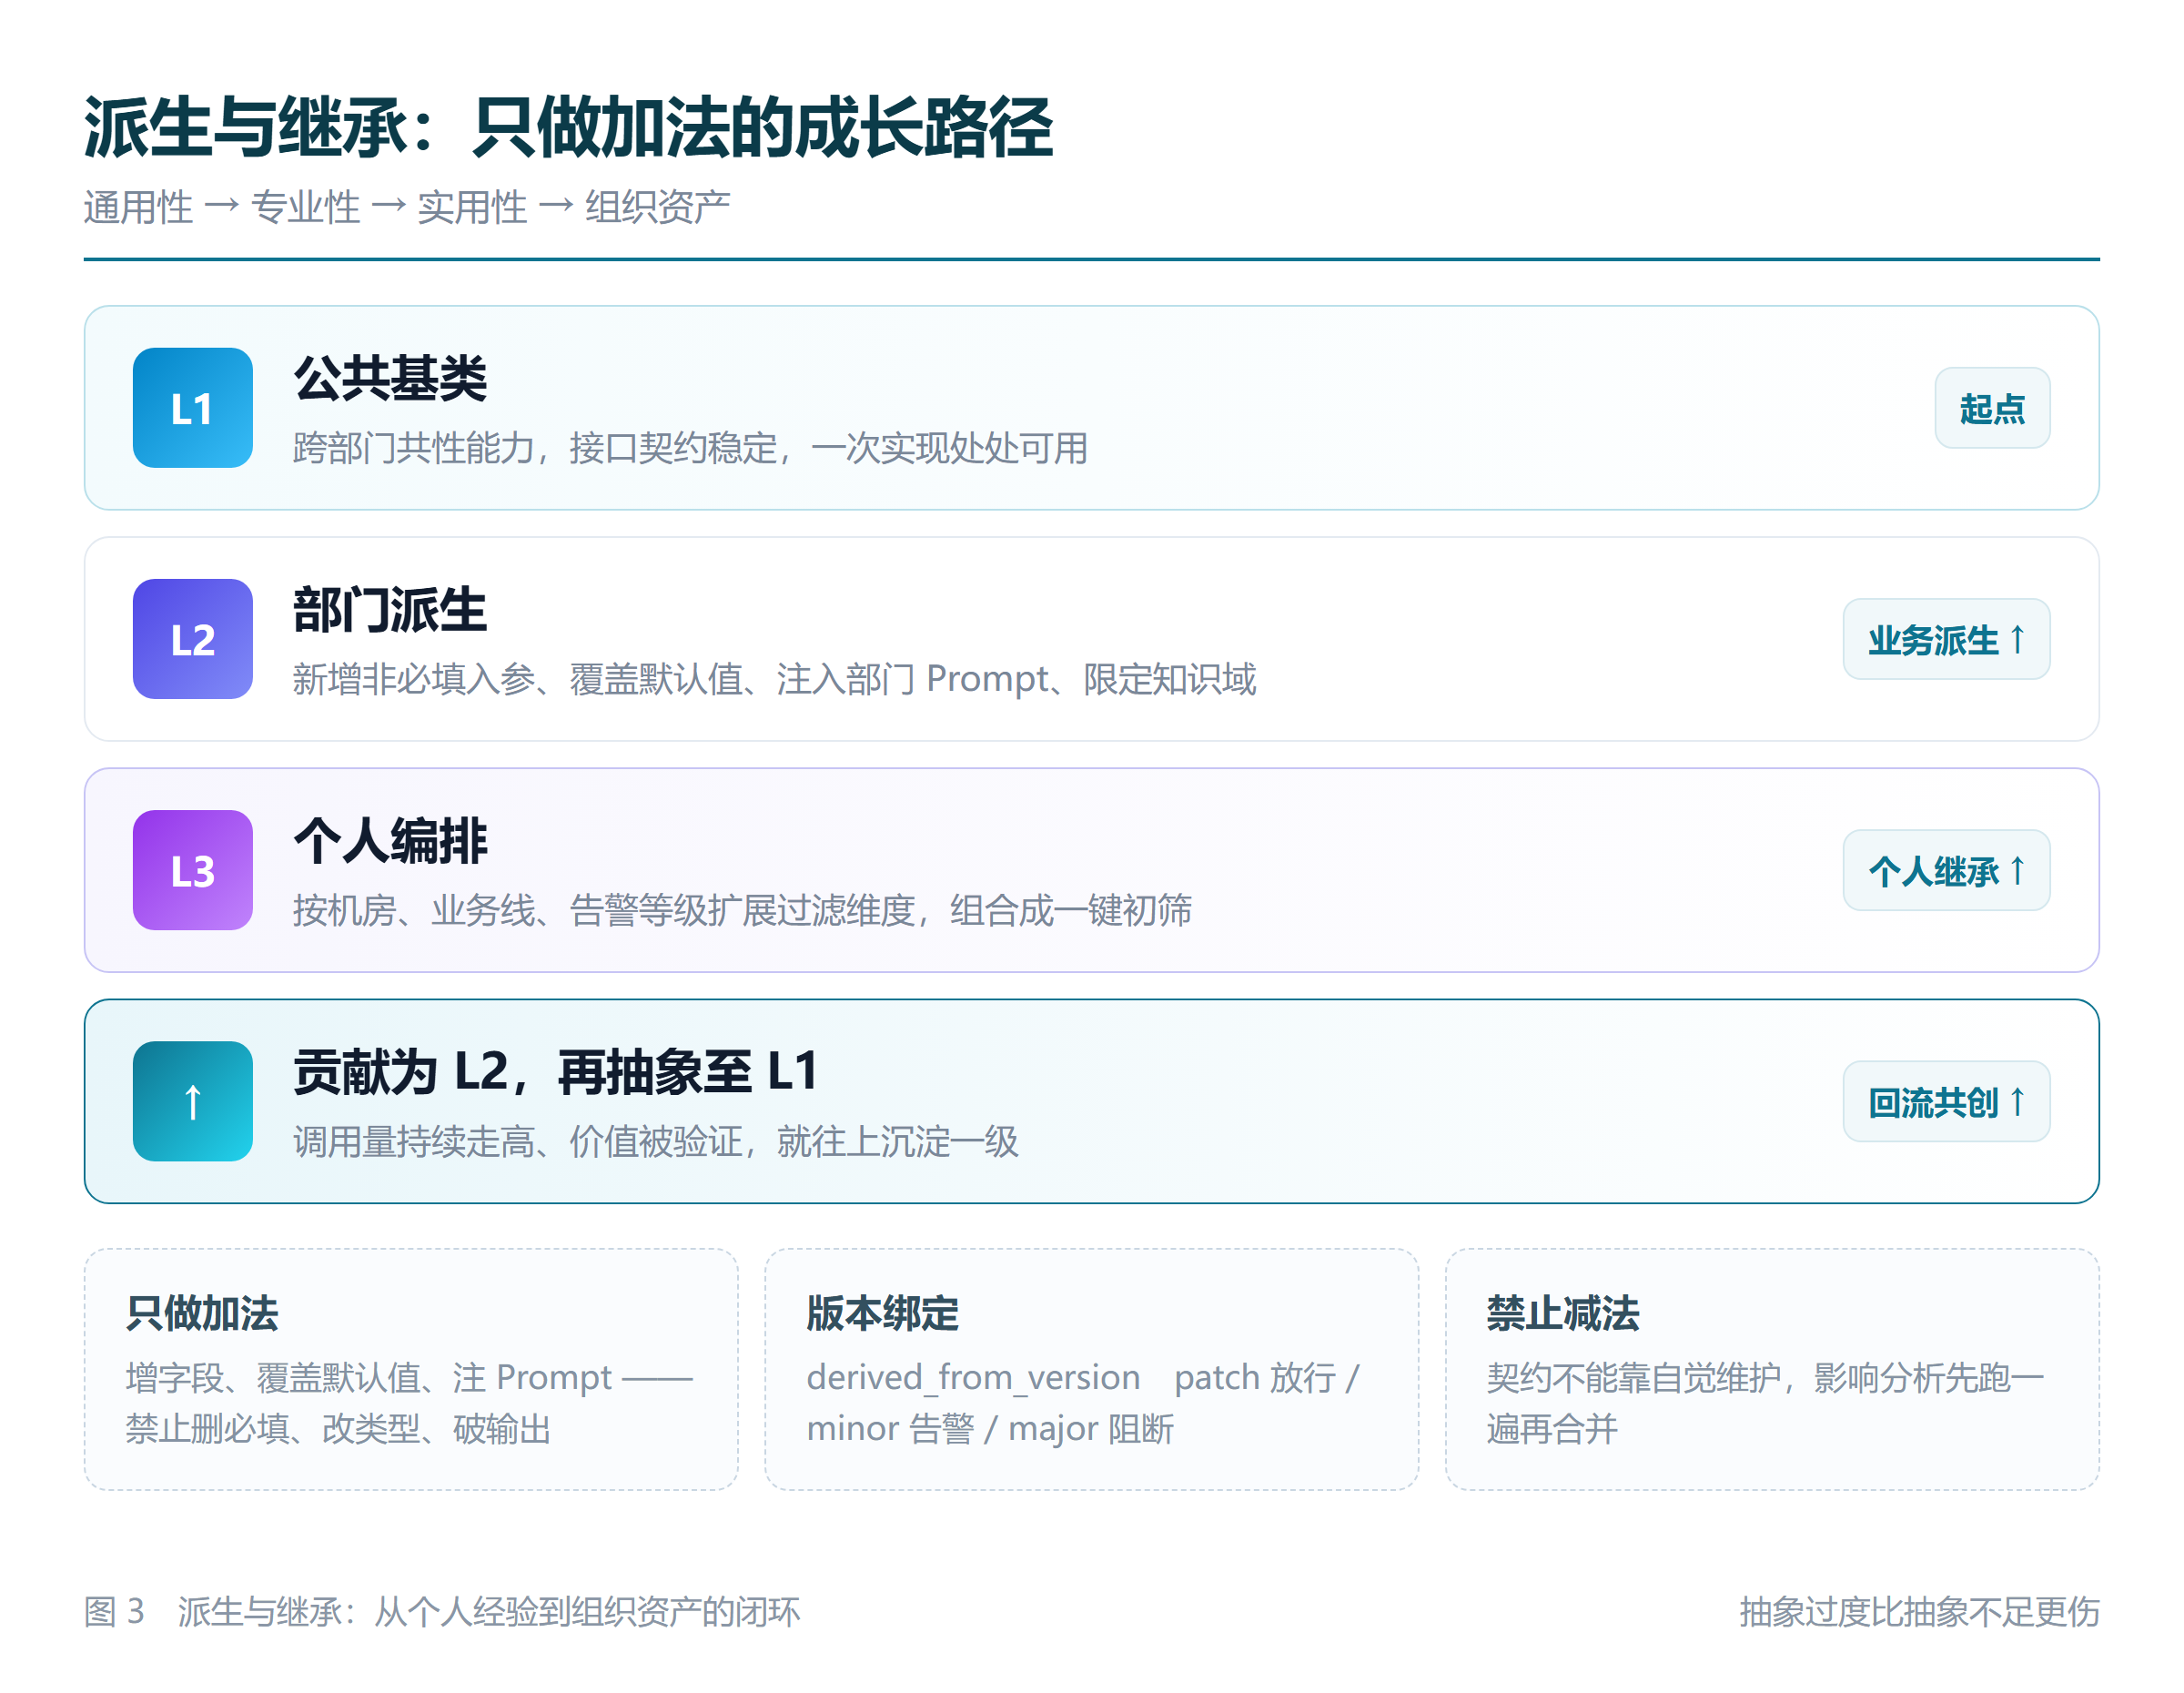
fig3-derive
• 业务派生(L1 → L2):允许新增非必填入参、覆盖非必填默认值、注入部门 Prompt、限定知识域;禁止删除基类必填字段、修改字段类型、破坏输出结构。
• 个人继承(L1/L2 → L3):允许按机房、业务线、告警等级扩展过滤维度,允许把多个 Skill 组合成「一键初筛」。
同时,派生时必须声明 derived_from 和 derived_from_version,运行时做版本兼容检测:patch 直接放行,minor 给警告,major 直接阻断。
这条规则救过我们很多次。当基类需要新增字段时,影响分析会先跑一遍,列出所有派生方;如果发现会影响生产,就退回「先做非必填」的方案,六个月后再收紧。契约不能靠自觉维护,得靠机制。
四、复用、组合、治理:三件事做好,架构才成立
4.1 复用:抽象与契约
复用不是「多写几个通用函数」,而是把高频共性上提到 L1,并把接口固定下来。我们的做法是:所有 Skill 强制提供 input.schema.json 与 output.schema.json,用 JSON Schema 做校验。调用方只需要认契约,不需要知道里面是大模型推理、规则引擎还是几行脚本。
接口演进按三段走:新增非必填 → 引导使用 → 标记弃用(六个月过渡)。永远不做突变的破坏性变更。
4.2 组合:四种模式足矣
AIOps 的价值在闭环,不在单点查询。实践中 90% 的场景,用四种组合模式就能覆盖:
模式 | 适用场景 | 说明 |
|---|---|---|
顺序串联 | 告警初筛、故障定位 | 前一步输出作为后一步输入,复刻资深工程师的排查路径 |
并行召回 | 跨系统排障 | 监控、日志、链路同时查,聚合后统一研判 |
条件分支 | 风险分级处置 | 低风险给建议,中高风险自动升级 |
个人中转 | 涉及外部系统 | 由 L3 统一编排业务 Skill 与 MCP,闭环且不污染业务 |
其中最后一环最容易出问题。很多团队一开始就让业务 Skill 直接调工单、直接发消息,图省事;等到要换平台、要做审计、要控权限时,才发现改动范围是全网。中转层的价值,就是把「变化」关在一个笼子里。
4.3 治理:把约束前置到 CI
治理最怕两件事:一是靠人记,二是靠会后补。我们的做法是把所有能被机器判断的规则,全部前置成 CI 门禁:
• 命名与目录:/<业务名>、/<业务名>-<部门简码>、/我的-<自定义>、@mcp/<服务>-<动作>,四级命名一眼可辨;
• 结构与 Schema:目录缺文件、Schema 不合法,直接拒绝合并;
• 派生影响:改基类前自动跑影响分析,列出全部派生方;
• 调用关系:扫描 dependencies 与 mcp_calls,发现 L1/L2 依赖 L3 或 L4,直接拒绝。
再加上分级评审:L1/L2 走周评审双签,L3 沙箱内即时发布,L0 跟框架版本,L4 走安全审核。让该快的快,该慢的慢。
生命周期同样要管:draft → review → staging → active → deprecated → archived。L1/L2 保留六个月弃用过渡期,L3 一百八十天无调用自动归档。这样能力池不会越堆越脏。
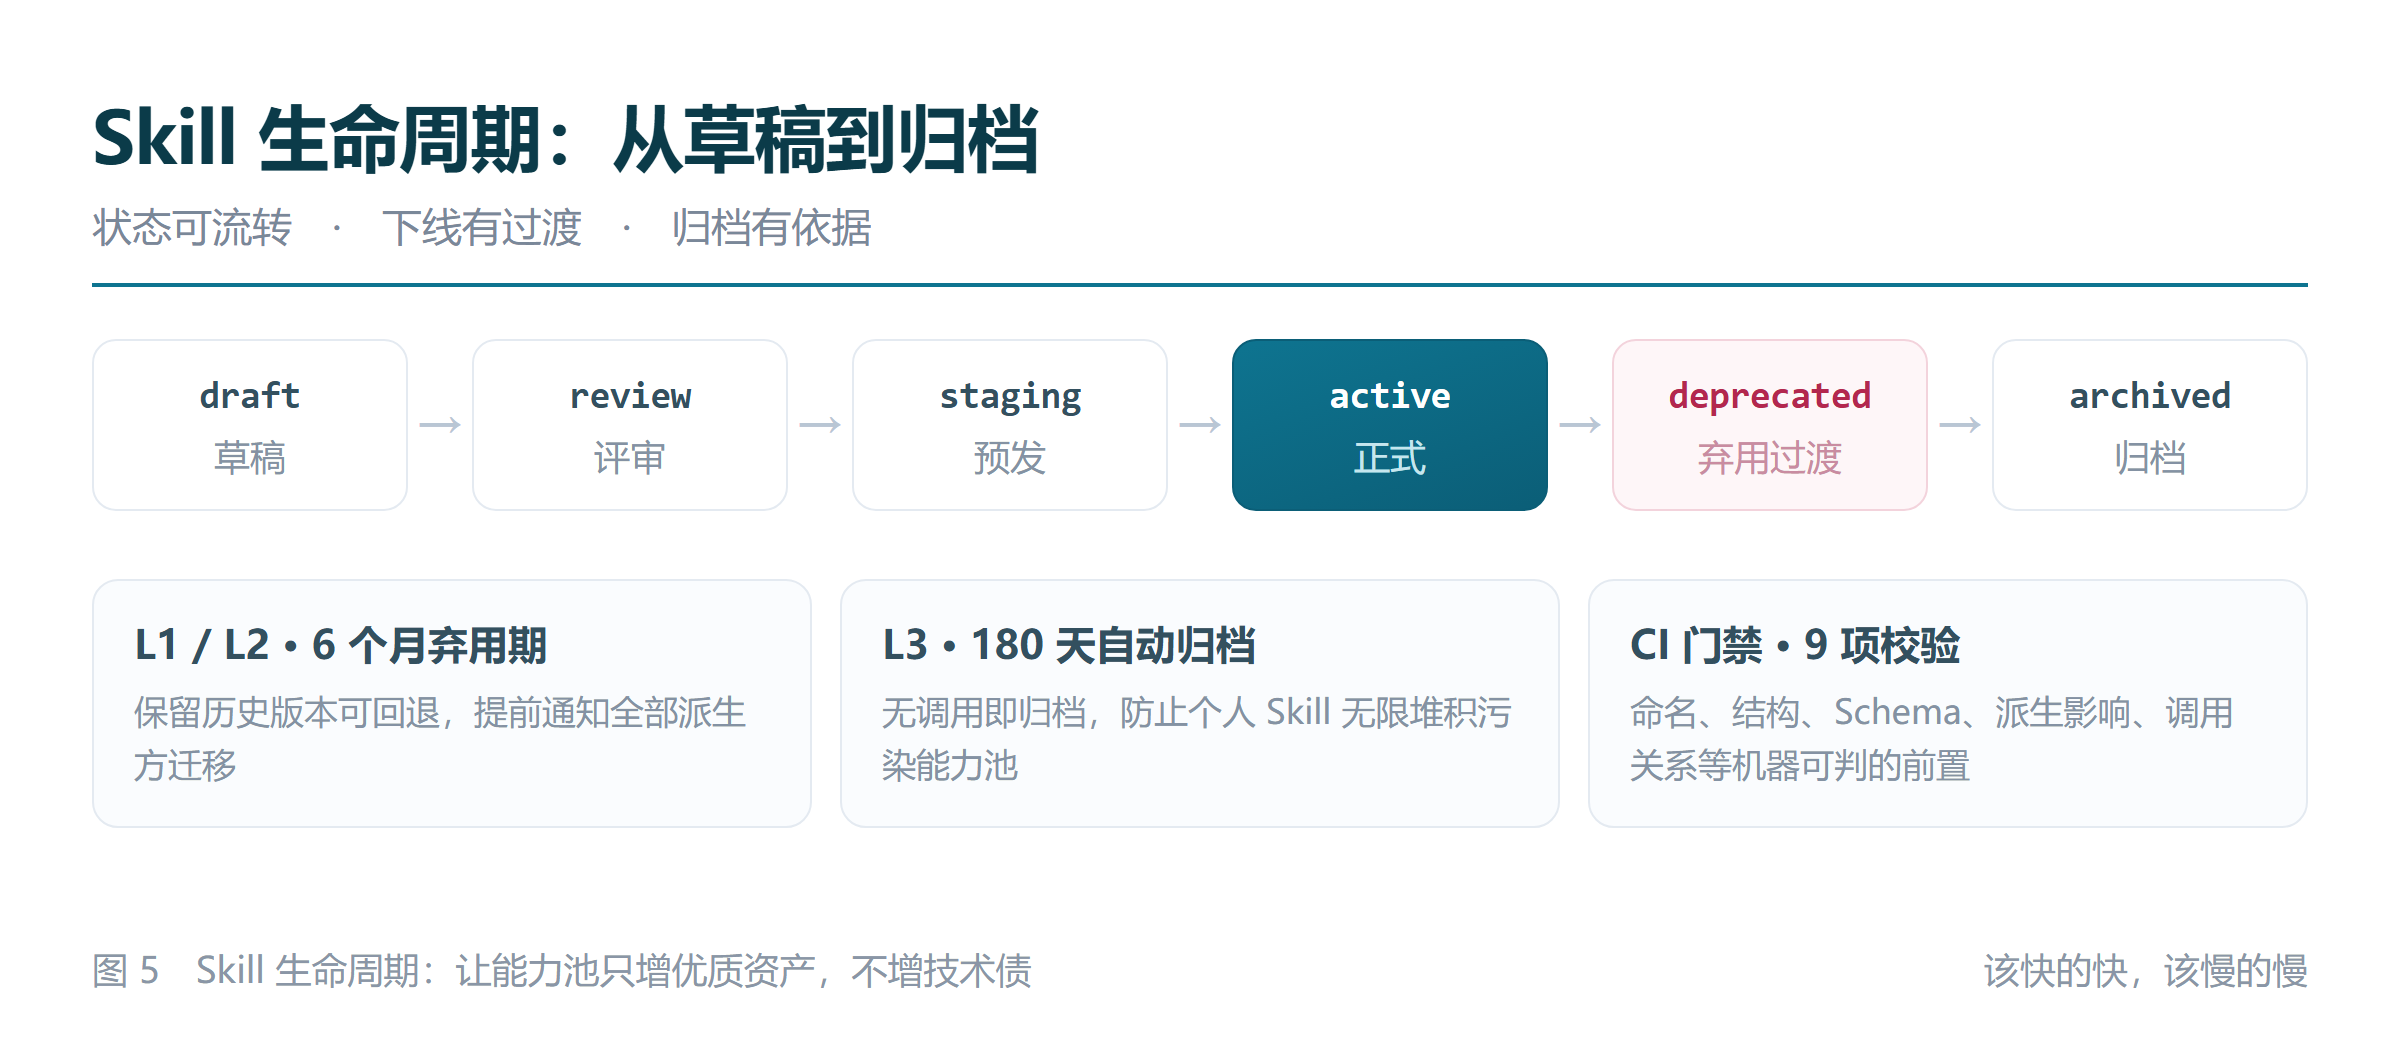
fig5-lifecycle
五、一个真实场景:告警降噪与初筛
说得再多,不如看一条链路。
某天夜里,监控推来一条「XX 应用接口响应超时」的告警。传统流程是:打开监控大盘看曲线 → 切到日志平台查近十五分钟日志 → 翻 CMDB 找责任人 → 查最近变更 → 凭经验判断要不要拉群升级。平均耗时 15 到 25 分钟,而且换个新人来做,结果可能完全不同。
用 Skills 架构重写之后,链路变成了这样:
步骤 | 所在层与 Skill | 做什么 |
|---|---|---|
1 告警解析 | L0 @http/fetch | 从告警平台拉取结构化字段:应用名、影响范围、告警等级、首次触发时间 |
2 手册匹配 | L1 /知识问答 | 检索运维手册与历史同类故障处置记录,拿到「通常先查什么」 |
3 日志检索 | L0 @db/query | 按时间窗、应用标识、异常关键词拉关键日志,过滤无关堆栈 |
4 领域过滤 | L2 /故障手册-中间件 | 把中间件组的规则——连接池打满、线程阻塞、超时阈值——固化成部门 Skill |
5 编排闭环 | L3 /我的-告警初筛助手 | 串成「解析 → 匹配 → 检索 → 研判」,输出初筛结论与证据链 |
6 工单与通知 | L4 @mcp/itsm、@mcp/dingtalk | 结论为「建议升级」时,经 L3 中转调用工单与消息 MCP |
落地后的三个变化:
• 耗时:夜间初筛从 15–25 分钟压到 2–4 分钟,争取到的其实是故障响应的黄金窗口。
• 沉淀:中间件组的排查清单从「口口相传」变成了可调用的 L2 资产,新人第一周就能用上老师傅的判断逻辑。
• 可控:建工单、发通知这类高危动作全部走 L3 中转,全量留审计日志,权限最小化且可溯源。
更重要的变化发生在流程之后:每一次真实处置中有效的判断、漏掉的排查项,都会被回补到对应的 Skill 里。用得越久,能力池越厚——这才是「资产」和「脚本」最本质的区别。
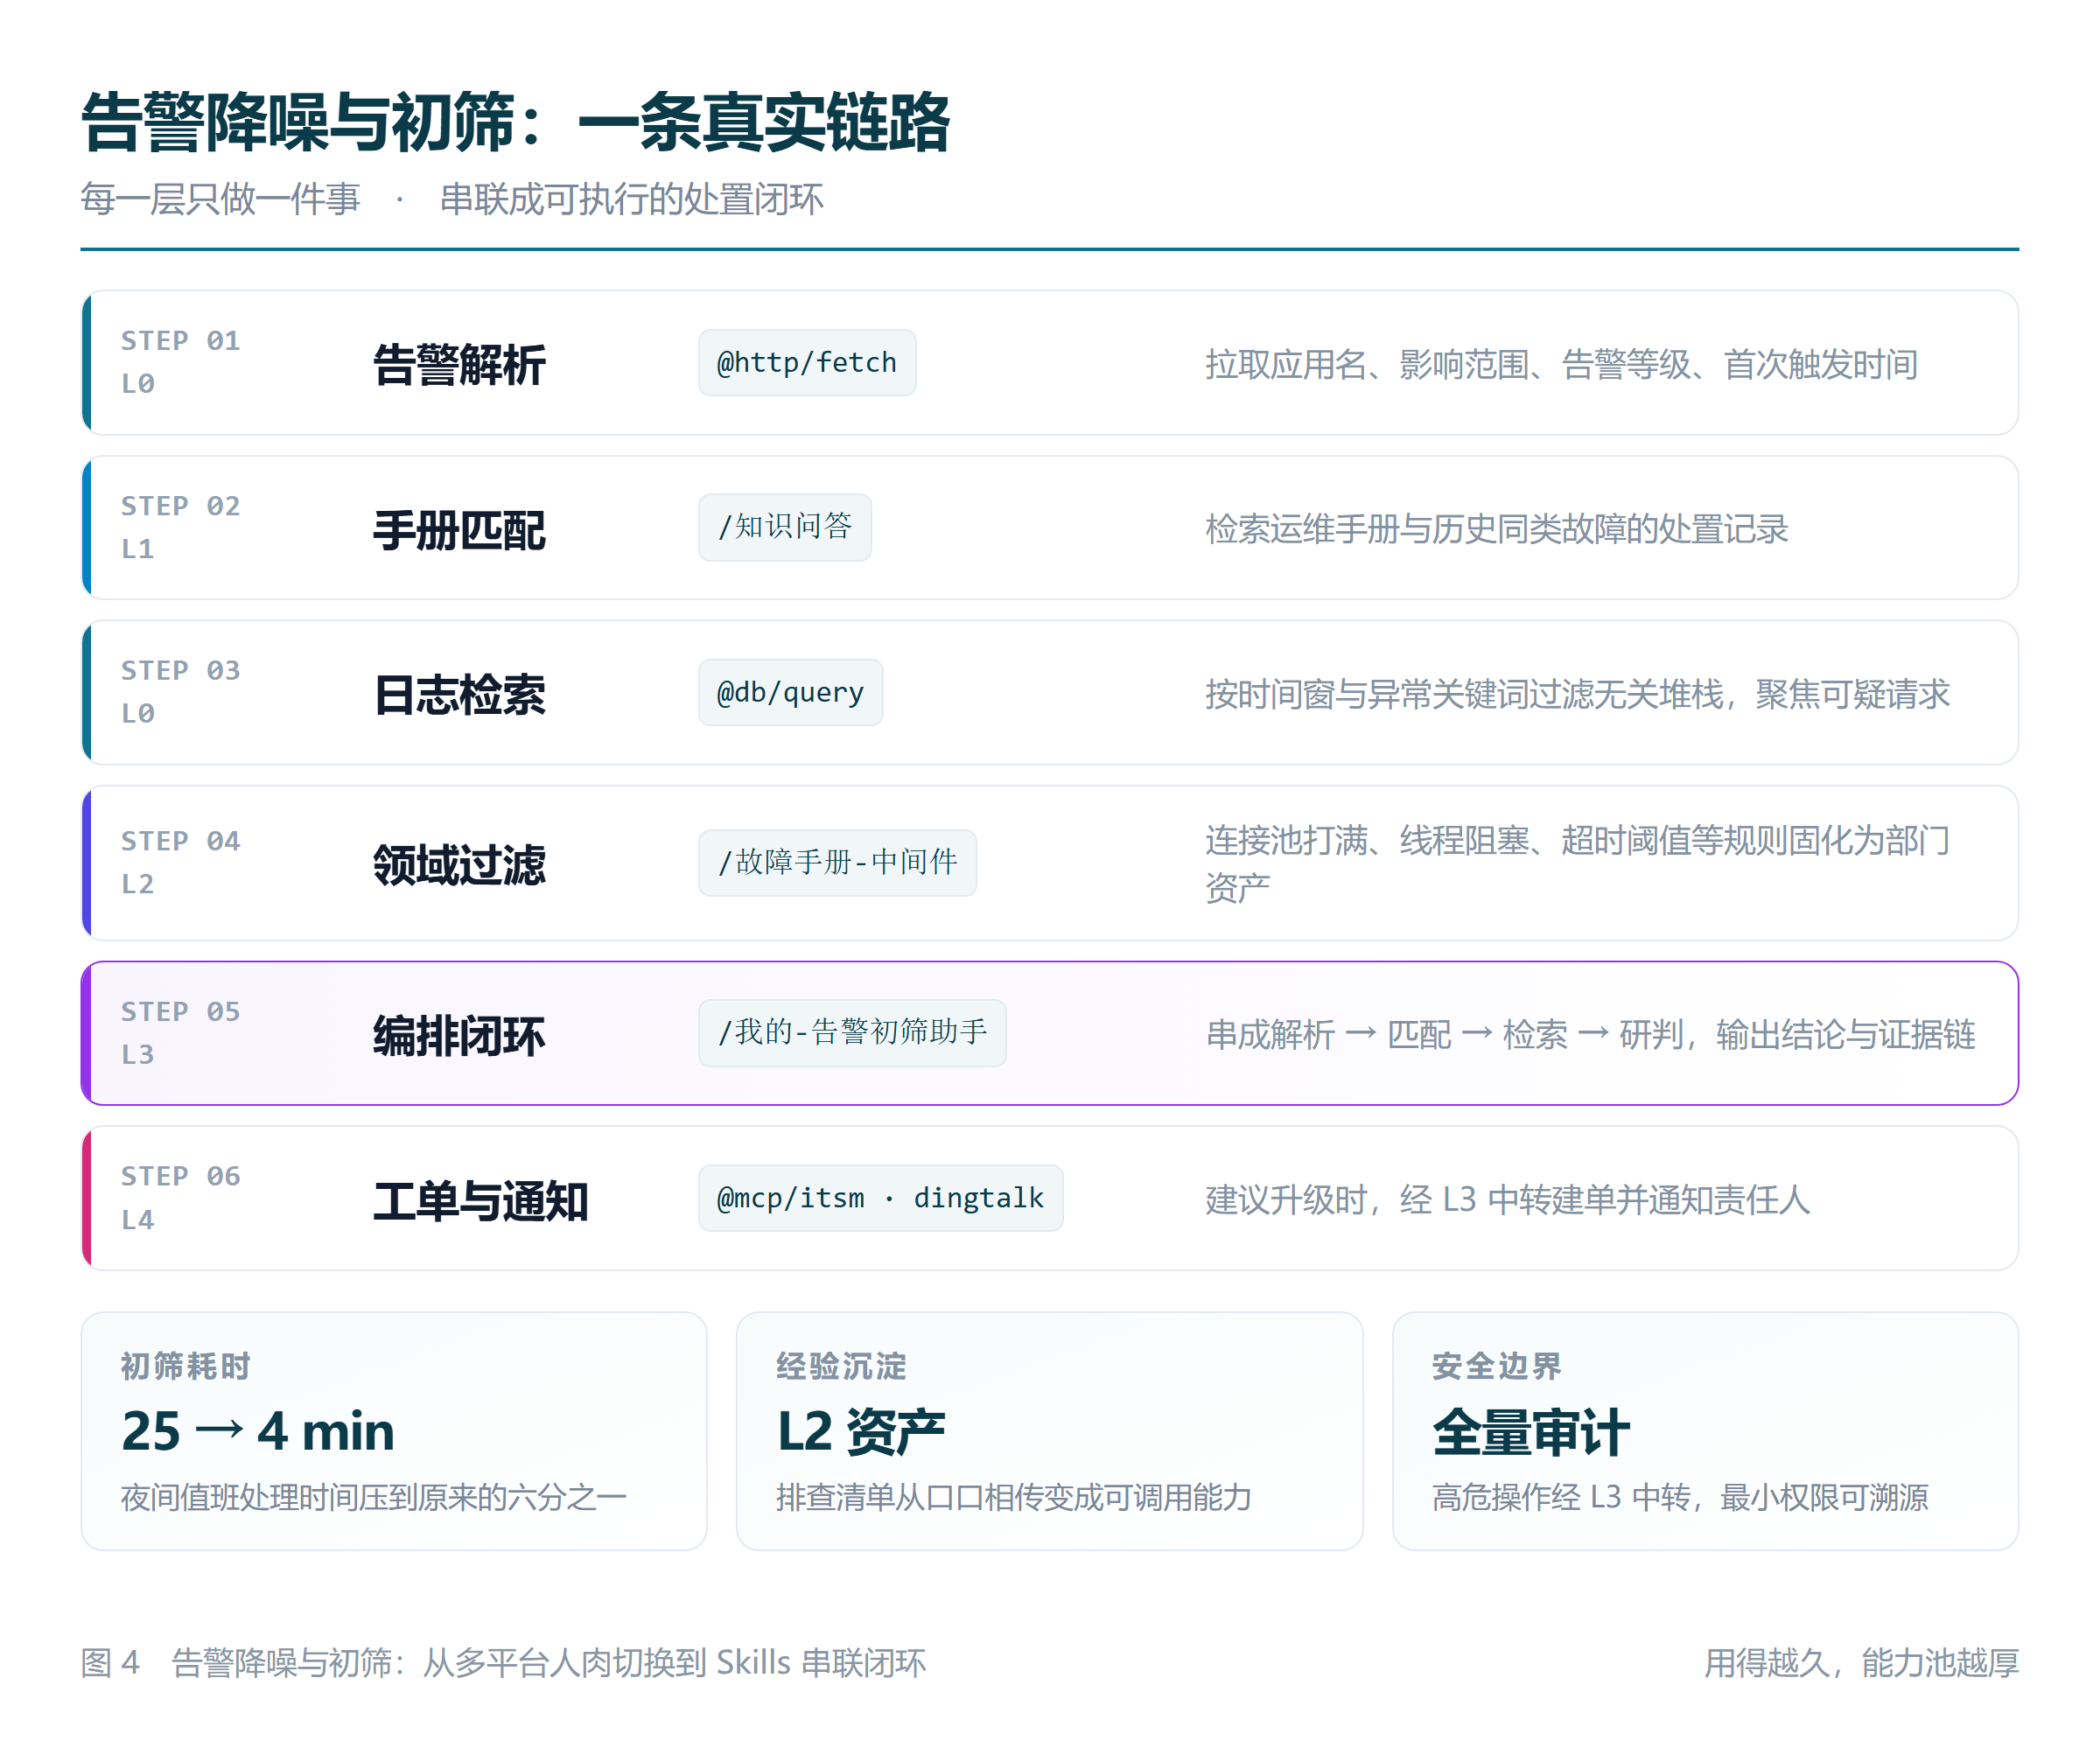
fig4-case
六、四条我们踩出来的设计取舍
回头看,这套架构真正的价值不在图有多完整,而在下面四个取舍。
取舍一:宁可多一层,也不让业务被外部绑定。 L3 中转看起来「多绕了一步」,但它把供应商变更、接口限流、协议升级这些外部不确定性,全部关在了一个可替换的层里。
取舍二:宁可禁得死,也不留模糊地带。 「业务不能调个人」「业务不能直连 MCP」这两条,起初有同事觉得太严。但正是这两条硬规则,让架构在扩张到几十个 Skill 之后依然清晰。架构的生命力,取决于禁令能不能被机器执行。
取舍三:宁可先做通用,再做专业。 L1 不做大而全的「全能助手」,只做被两个以上部门真正用起来的能力。抽象过度比抽象不足更伤——前者没人用,后者还能长。
取舍四:宁可慢一步发布,也要有弃用过渡。 六个月弃用期看起来拖节奏,但它换来的是「基类升级不会引发大面积故障」这个确定性。对生产系统来说,确定性比速度值钱。
七、下一步:从可调用,到可验证
这套架构目前跑通了「告警 → 初筛 → 升级」这条最高频的链路,但还有三件事必须往前走。
第一,Skills 应该和 API 同等地位。 未来企业的 Agent 底座,不该是一堆提示词的堆叠,而应该是一个统一注册、统一鉴权、统一计量、统一监控的能力目录。只有被当成基础设施来经营,Skill 才配叫资产。
第二,从「可调用」走向「可验证」。 Schema 只保证格式对不对,不保证结果好不好。真正需要的是场景指标:告警初筛的有效率(建议升级的是否命中真实故障)、误升级率(是否制造了不必要的打扰)。用数据驱动迭代,比开会讨论有用得多。
第三,让「定制」变成「自助」。 最了解痛点的人永远在一线。当某个 L3 编排被反复验证、调用量持续上升,就应该有一条清晰的通道,把它贡献成 L2、甚至抽象到 L1。共创不是口号,是升级路径要足够短。
再往后,这条链路可以自然延伸到变更风险预判、容量预警、故障复盘,最终覆盖「感知—研判—处置—复盘」的完整生命周期。
结语
AIOps 的终局,从来不是用 AI 替代值班同学。
它真正要做的,是把一代代运维人积累下来的判断力——那些写在文档里、更多藏在脑子里的 Know-How——固化下来、传承下去、并规模化复用。
Runbook 是给人看的,Skill 是给 Agent 用的。当企业每一条有效的排障思路都能沉淀为受治理、可组合、可复用的能力单元时,AIOps 才真正告别 Demo,成为支撑业务稳定运行的基础能力。
而这,也正是在「Skill 资产共创」这件事上,值得整个行业一起往前走的原因。
本文参与「AIOps 最佳实践 · CloudQ 共创计划」征文(赛道三:Skill 资产共创)。如需引用,请注明作者与出处。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号