拆完一本书我才明白,Context Engineering 到底在工程什么 #WorkBuddy#
原创
拆完一本书我才明白,Context Engineering 到底在工程什么 #WorkBuddy#
原创
用户12824395
发布于 2026-10-24 11:07:18
发布于 2026-10-24 11:07:18
先说结论:上下文工程的四个核心问题,不是从哪篇文章看来的,是我把一本 14 万字的书拆成 4 个技能包的过程中,一个一个撞上的。
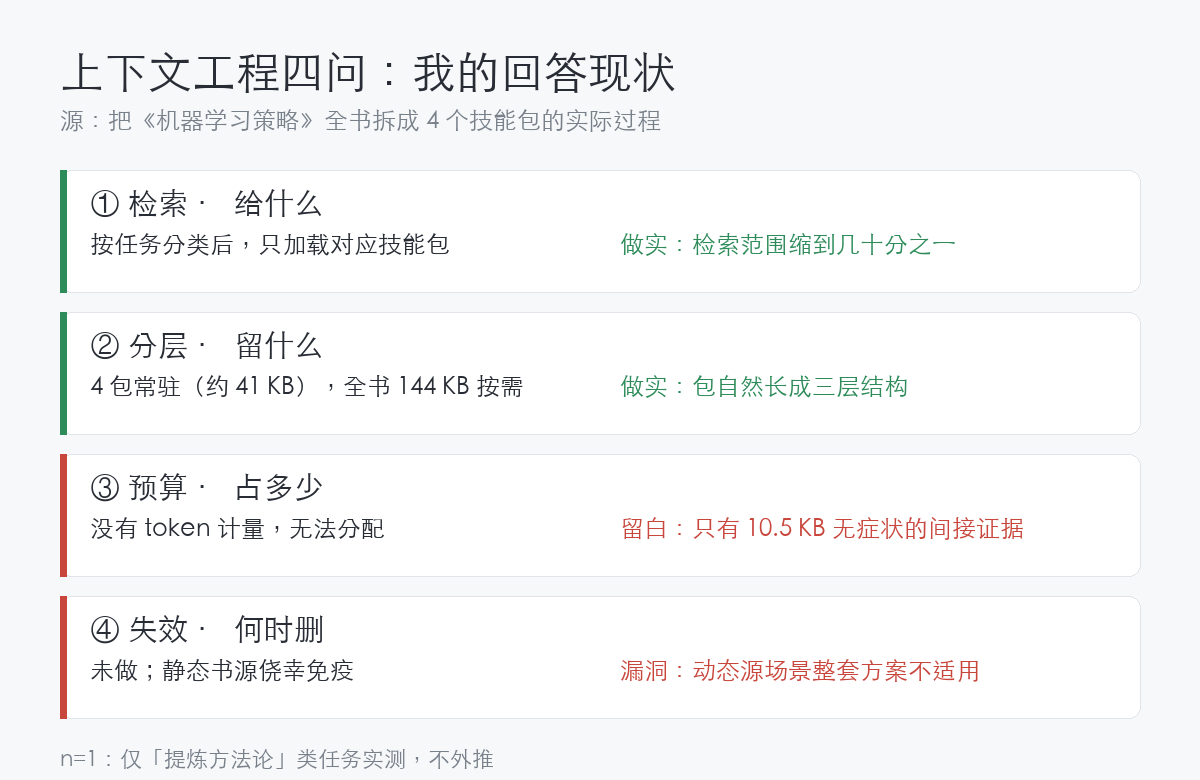
撞完我回头看,所谓 Context Engineering,工程的就是四件事:给什么、留什么、占多少、何时删。我做了前两件,第三件没算清,第四件压根没做。这篇文章把这四个问题摊开讲,也把我没做的那部分老老实实写出来。
先交代背景:那次翻车
那本书是吴恩达的《机器学习策略》,免费公开,全文 144,407 字节,12 个篇章,英文原版按 58 章编排。我的第一反应是把全文整个丢给 AI,让它帮我梳理方法论。
前几分钟挺美妙。再往后,它开始讲书里根本没有的话。
我起初以为是幻觉,后来才想明白:输入远超任务所需时,模型会做隐式取舍,14 万字一次进来,它必须挑重点,事实就在挑选的过程里漂了。这个教训我在之前那篇《一本书变成 4 个技能包》里写过,今天不重复细节,只讲它逼出来的四个工程问题。
第一问:检索——给什么
答案听起来朴素:按当前任务需要的那一章给,不是给全书。
但要害在"怎么知道当前任务是哪一章"。我的做法是把书拆成 4 个技能包,每个包对应一类问题:数据怎么切、是欠拟合还是过拟合、我还剩多少提升空间、下一步先修哪个。任务来了,先判断它属于哪一类,再加载对应的包。
这一步做完我才意识到,检索的本质不是搜索,是分类。你没分类之前,每次都是全书检索;分类之后,检索范围天然缩小到几十分之一。
说"缩小到几十分之一"是有依据的:全书 58 章,我实际会问的问题全部落在四个包覆盖的章节范围内,每次真正进上下文的内容,就是那 10 KB 出头。
分层不只发生在"包和全书"之间
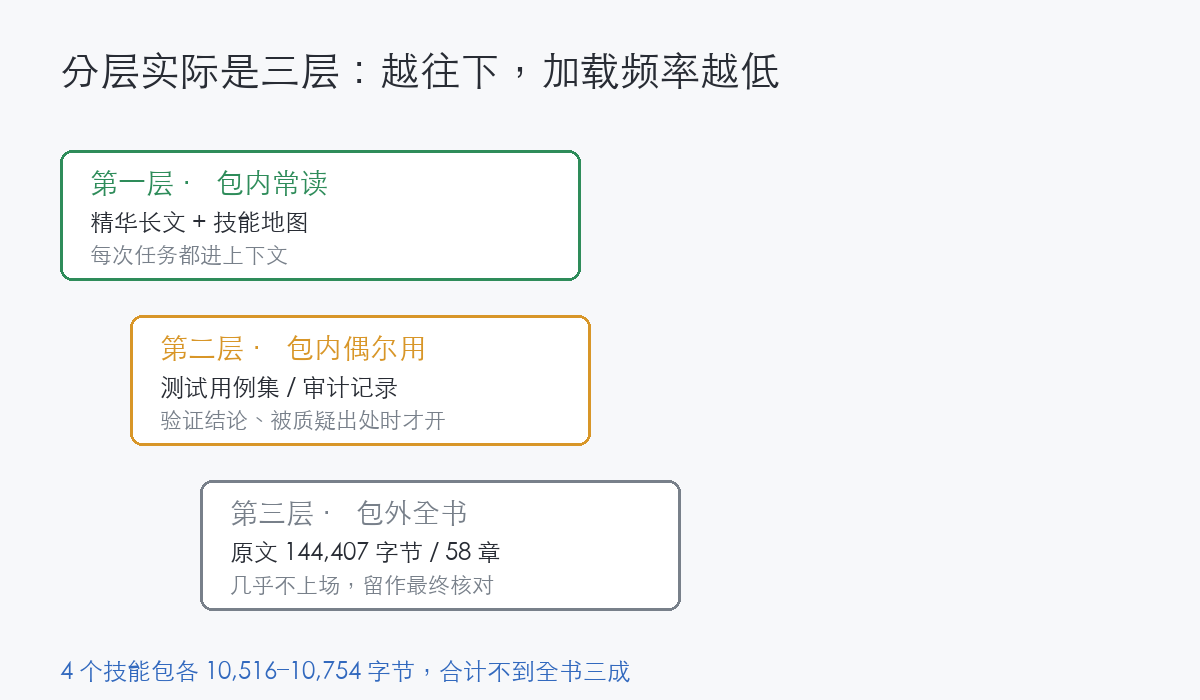
包和全书之间有一层,包内部还有一层。每个技能包解压后有五样东西:精华长文、术语表、技能地图、审计记录、测试用例集。
用的时候这五样的待遇不一样。长文和技能地图是常驻读的;测试用例集只在验证结论时翻;审计记录平时根本不进上下文,只在有人问"这个结论到底是书里说的还是你加的"时才打开。
所以分层实际是三层:包内最常用的、包内偶尔用的、包外全书。每往下一层,加载频率低一个量级,占的上下文也该低一个量级。这个形状不是我预先设计的,是拆完回头看才认出来的。
一次真实的加载流程
拿最近一次举例。我怀疑某个模型的输出有方差问题,想判断该不该加数据。
流程是这样:先判类别,这属于"偏差方差诊断",开 bias-variance-diagnosis 这个包;包里的技能地图给出判定顺序,先看训练和开发错误率的差值;需要引用原文判据时,包里的长文直接给了那句"添加更多的训练数据,对偏差通常没有明显的影响";要确认这句话没被我在蒸馏时改写过,翻审计记录,里面写着它是原文引用、出处是哪一章。
整个过程,144,407 字节的书一次都没整体上场。这就是我理解的检索加分层:上下文里永远只有当前任务需要的那一小块,其余的留在架子上。
得说明一点:这个"判类别、开包"的路由动作,现在是我人肉做的。我没有写任何自动路由工具,所以这套流程的可复现性取决于我本人的判断,换个人来路由,结果可能不一样。这是诚实账,不能算进方案优点里。
第二问:分层——哪些常驻
4 个技能包,每个解压后约 10.5 KB(实测 10,516–10,754 字节),加起来 40 多 KB,常驻;全书 144,407 字节,按需。
这个比例值得停一下。常驻部分是全书的三成不到,却覆盖了我实际会问的全部四类问题。剩下七成是引例、推导、边缘章节,一年用不上一次,留在按需区。
分层的原则就这么一条:高频问题常驻,低频内容按需。不是我发明的,是我拆完发现自己的包自然长成了这个形状。
第三问:预算——各占多少 token
这一问我没有答案。
理想状态是给每类内容定 token 预算:技能包占多少、对话历史占多少、当前任务描述占多少,超了就裁。我没做,因为当时没有观测手段,我不知道自己每次请求实际花了多少 token,也就谈不上分配。
我能给的只有一条间接证据:4 个包各自 10.5 KB 左右,中文约五千字,喂进去后模型的回答没有再出现"讲书里没有的话"的症状。说明这个量级在这类任务上是安全的。但"安全"和"最优"是两回事,预算这题我留白,谁有现成的计量方案欢迎在评论区教我。
第四问:失效——旧的何时过期
这一问我没做,是整套方案里最大的洞。
我的侥幸在于源是静态的:一本书,写完就不会变,拆一次管到天荒地老。所以"旧上下文何时失效"这个问题在我的场景里不存在。
但只要把源换成任何会变的东西——一份每天更新的文档、一个版本在进的代码库、一组会过期的数据——失效问题立刻变成头号问题。旧的技能包里存着过时的结论,你不去删它,它就一直以"权威资料"的身份混在上下文里,比没有它更糟。
我现在的处理是诚实标注:每个技能包的审计文件里写着拆解日期和源版本。书不会变,这条记录够用。会变的源,这套方案直接不适用,我不装它能用。
这四个问题合起来看
回到开头。Context Engineering 这个词听起来玄,拆开就是四个可以逐条回答的问题:
给什么,答"按任务分类后按需检索";留什么,答"高频常驻、低频按需";占多少,答"我还没做,只有间接证据";何时删,答"静态源不存在这个问题,动态源我这套方案不适用"。
四个答案里两个是实的,两个是空的。我觉得这个比例很真实——网上多数讲上下文工程的文章四个问题都答得满满当当,反而让人看不出哪部分是被验证过的。
边界声明
三条,都是必须说的。
第一,n=1。全部经验来自拆一本书这一件事,任务类型是"提炼方法论",不能外推到写代码、写论文、数据分析。
第二,我的"技能包"本质是人工做的上下文编译,不是完整的 Context Engineering 框架。检索、分层这两步是我手工判断的结果,没有工具链保证一致性。
第三,第三问的间接证据(10.5 KB 无症状)不构成量化结论,我没有做对照实验,也没有 token 级的计量数据。
文中数字均来自本机实测:全书 144,407 字节 / 58 章抓取成功、4 个技能包解压后 10,516–10,754 字节、7 条引用回原文逐条比对零编造。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号