20 万个工具里挑对的那个:一个 80 亿参数小模型干翻了 4000 亿大模型
原创
20 万个工具里挑对的那个:一个 80 亿参数小模型干翻了 4000 亿大模型
原创
用户10911842
发布于 2026-10-26 12:05:45
发布于 2026-10-26 12:05:45
20 万个工具里挑对的那个:一个 80 亿参数小模型干翻了 4000 亿大模型
一句话版本:当智能体能调用的工具超过一万个,把工具说明书全塞进上下文已经不可能,检索器又只会排「相关」不会判断「需要」。这篇论文用强化学习训练一个 80 亿参数的开源小模型来驱动检索:先分解任务、再按子步骤取候选、最后自己判断选哪些——在 ToolBench 上超过了 4000 亿参数的闭源大模型,还直接迁移到没见过的检索器和工具库。
工具多了,反而不会选了
给智能体接工具不稀奇——发邮件、订机票、查数据,都是调 API。但真实企业环境里,可调用的工具已经超过一万个:每个工具一段说明书,全部塞进上下文窗口直接溢出。
经典解法是检索器:把用户指令和每条工具说明做相似度打分,取前几名给智能体挑。问题在于——检索器只会告诉你「哪个相关」,不会告诉你「哪个是任务真正需要的」。用户说「订纽约的酒店和旧金山飞纽约的机票」,这是两个子步骤、至少两个工具;相关度排序把酒店评论、机场信息、航班动态全排上来,但哪些真的要调用,排序函数不知道。
近来的做法是让闭源大模型坐镇中间,把检索器降级成随取随用的元工具:模型先分解指令成子步骤,每个子步骤发起一次检索,再从候选里挑出真正需要的,循环到任务覆盖。效果不错,但代价是每次选择都要请求一次闭源大模型——贵、慢、数据出域。
小模型的三段式训练
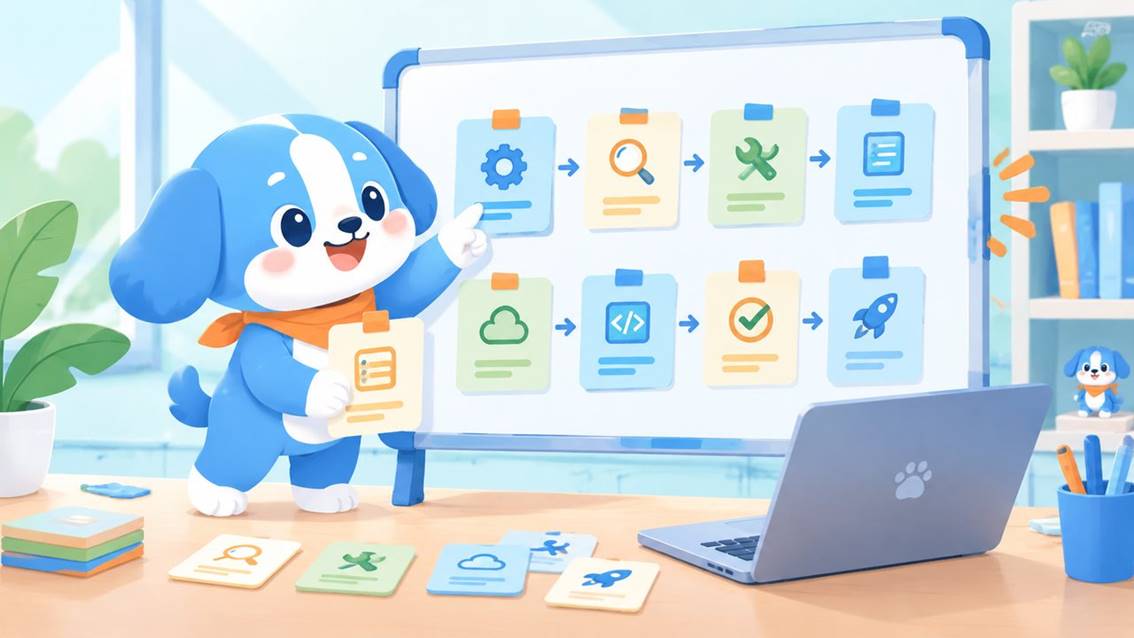
论文的核心动作:把这套「分解-检索-选择」的循环流程,用强化学习教给一个 80 亿参数的小模型。
· **Plan**:把用户指令拆成有序子步骤(订酒店、订机票各自独立成步);
· **Retrieve**:每个子步骤生成一条查询,调外部检索器取回候选工具集;
· **Select**:从候选中判断哪些是任务真正需要的,选错扣分选对加分,模型在试错中学出判断力。
训练完成后出现两个超出预期的性质:
迁移性:换个完全没见过的检索器(从稠密向量换成词法检索),模型照样能用——它学的是「怎么用检索器」而不是「绑定某个检索器」。
泛化性:换一个领域的全新工具库,不做任何微调直接上阵,选择质量不掉——因为判断「这个工具是否被任务需要」的能力是跨领域通用的。
在 ToolBench 基准上,这个 8B 模型的工具选择表现超过了 4000 亿参数的闭源大模型。
为什么小模型能赢
直觉上「选工具」该是越大越强的推理任务,论文给出的答案是:这不是开放推理,是可枚举的决策问题。
· 候选集就几十个工具,判断「需要/不需要」是二分类,不需要海量世界知识;
· 奖励信号清晰(选对了任务能完成),强化学习的回报路径短;
· 流程本身是固定模板循环,小模型要学的只有每一步里的判断力。
大模型的参数优势在这个受限任务里用不上,而小模型的响应速度和部署成本优势全兑现——训练一次,私有化部署,工具库随便换。
对我们的启发
· **别一上来就上最大的模型**。任务结构受限(候选少、判断二元、流程固定)时,小模型+强化学习能以百分之一的参数量做到同等甚至更好的事——选型先分析任务结构,再挑模型档位。
· **教流程不如教判断**。把流程骨架(分解-检索-选择循环)写死在架构里,只让模型学「哪一步怎么判断」,训练目标和奖励都干净,效果比让模型自己摸索整套流程稳得多。
· **工具生态是资产**。一万+工具的选择能力可以训练出来,意味着工具库越丰富、沉淀越厚的企业,智能体的可迁移能力护城河越深。
构建这类会自己选工具的智能体工作流,可以试试 BuddyMe——每日免费 4500 万 Token。
---
· 论文:Training Small Language Models for Transferable Tool Selection(arXiv:2610.31483)
buddyme 个人智能体工作平台,每日免费4500万token。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号