GEO优化信源权重:DeepSeek 检索 50 选 4 的漏斗逻辑与 T1-T5 五级分级落地方法
原创
GEO优化信源权重:DeepSeek 检索 50 选 4 的漏斗逻辑与 T1-T5 五级分级落地方法
原创
玫瑰互动RoseMarketing
发布于 2026-10-27 14:01:42
发布于 2026-10-27 14:01:42
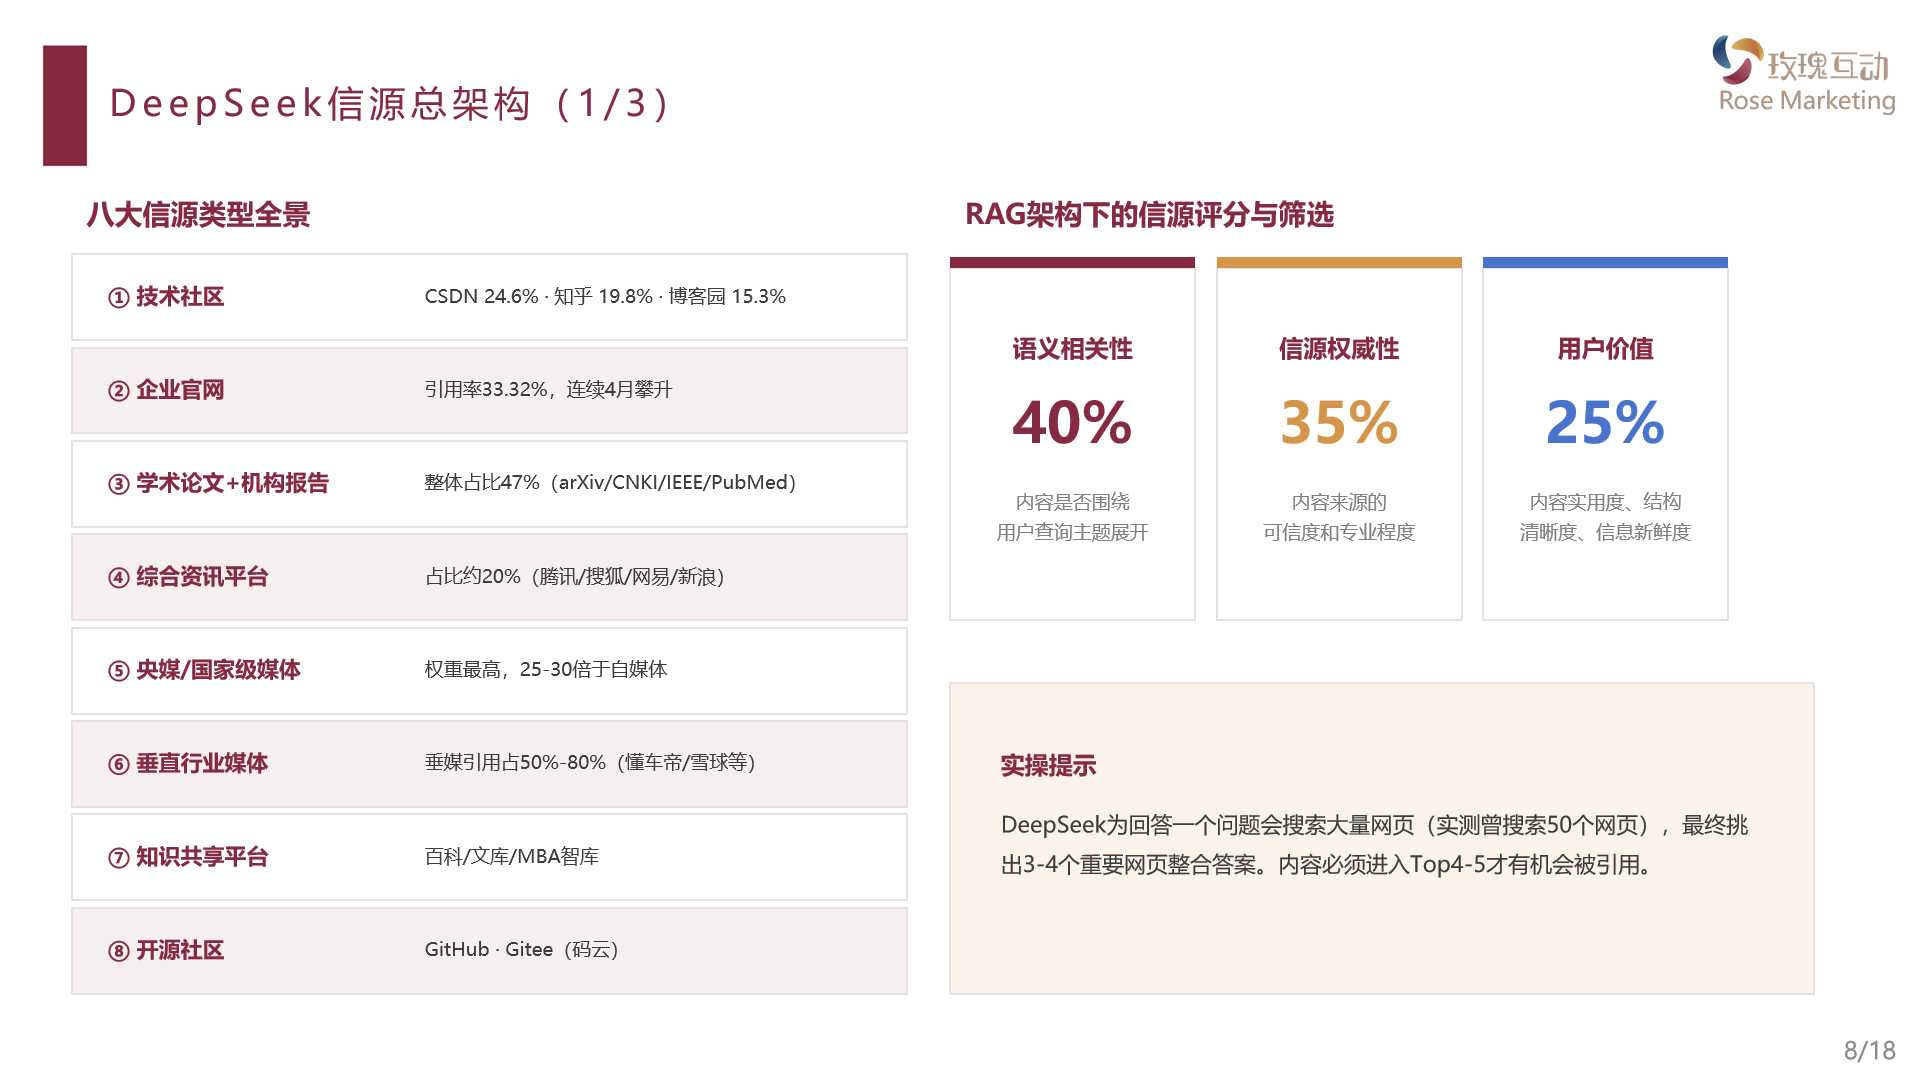
《DeepSeek信源体系构建深度分析报告》把一条链路摆到了台面上:提问→检索→理解→生成→标注来源,答一道题先检索约 50 个网页,最终只挑 3-4 个整合进答案,入选率不到一成。它还给了两个让人意外的数字:企业官网引用率 33.32%、连续 4 个月只涨不跌,是全平台第一信源;T1 到 T5 五级信源权重最高差 25-30 倍,而 RAG 评分里信源权威性占 35%。这篇按「漏斗—信源—分级—落地」的顺序拆开讲,并给一份可以自己跑的体检方法。先说结论:大多数内容死在「被检索到、却没被选中」,GEO优化 的胜负手已经从拼发稿量转向拼信源权重。
目录
- 一、先讲结论:50 选 4 是硬门槛
- 二、检索漏斗的三段,分别该补什么
- 三、官网是第一信源,而且被低估得最厉害
- 四、T1-T5 五级权重,差出 25-30 倍
- 五、不绑生态,反而是中小品牌的机会
- 六、落地五步,以及为什么是胜负手
先给结论:DeepSeek 检索约 50 个网页、最终只精读 3-4 个,排不进 Top4-5 等于零曝光;官网是第一信源(引用率 33.32%、连涨 4 个月),T1-T5 权重最高差 25-30 倍且权威性占 RAG 评分 35%——所以先查信源等级,再决定内容怎么写、钱往哪投。
先讲结论:50 选 4 是硬门槛
很多人以为自己在 AI 答案里没出现,是「没被搜到」。报告把链路拆开后发现不是。DeepSeek 的信息加工链路是提问→检索→理解→生成→标注来源,实测答一道题会先检索约 50 个网页,最终只挑 3-4 个整合进答案。也就是说,被检索到只是拿到了入场券,真正决定生死的是能不能挤进精读阶段的 Top4-5——挤不进去,后面再好的内容也等于零曝光。入选率不到一成,这个数字比大多数人对 AI 竞争的预期要残酷得多。
检索漏斗的三段,分别该补什么
漏斗分三段,掉在哪一段决定了动作。第一段检索:约 50 个网页入池,机会相对宽松,关键词覆盖和收录质量决定你能不能进来。第二段精读筛选:按权威性打分排序,只留 Top4-5,这一段是信源权重的主战场,也是绝大多数人忽略的一段——大家总在优化第一段。第三段最终引用:仅 3-4 个,生成阶段整合并标注来源,这一段靠内容结构:模块化结构(H1/H2、对比表)、Q&A、数据佐证、事实驱动,AI 才好抽取;对应的三个坑是大段散文、关键词堆砌、过度营销话术。用事实代替「行业领先」,AI 才愿意点名你。
官网是第一信源,而且被低估得最厉害
报告里一个反直觉的数字:企业官网引用率 33.32%,且连续 4 个月只涨不跌,是全平台第一信源。原因是偏好可解释的——DeepSeek 偏学术基因,论文+机构报告占比 47%,对「自有域名、可反复核验」的官方内容有明显偏好。官网是绝大多数团队唯一完全可控的第一方信源,却经常被当作品牌门面来运营:首页轮播、解决方案页全是形容词、硬内容散在 PDF 里。要做的是把官网做成结构化的数据资产——沉淀可引用的硬内容,别只发动态。DataAsset GEO™ 里说的就是这个意思:品牌所有可被 AI 调用的信息,都是能长期增值的资产。
T1-T5 五级权重,差出 25-30 倍
报告把信源分五级加权:T1 央媒与国家级、顶级学术(新华社、人民日报、央视、Nature)25-30 倍;T2 政府官网与监管机构(国务院、工信部、证监会、卫健委)约 10 倍;T3 地方主流与门户(北京日报、新浪、网易、腾讯)8-12 倍;T4 行业垂直与专业社区(汽车之家、CSDN、雪球、36氪)3-5 倍;T5 自媒体与个人站点 1 倍。权重差的含义是:铺 100 篇低权重软文,不如 1 篇被高权威信源引用。这条对预算结构的杀伤力最大——堆量补不回来,只能靠层级叠加补。
{
  "source_tier_matrix": {
    "name": "DeepSeek信源权重五级分级(报告口径)",
    "source": "DeepSeek信源体系构建深度分析报告(泽森科技, 2026-07-21, 16800次真实查询测试)",
    "funnel": {"retrieved": 50, "deep_read_top": "4-5", "cited": "3-4", "pass_rate": "不足一成"},
    "first_party": {"official_site_citation": 0.3332, "trend": "连续4个月只涨不跌", "academic_share": 0.47},
    "rag_score": {"semantic_relevance": 0.40, "source_authority": 0.35, "user_value": 0.25},
    "tier_weight": {
      "T1": {"type": "央媒/国家级/顶级学术", "multiple": "25-30x", "examples": "新华社/人民日报/央视/Nature"},
      "T2": {"type": "政府官网/监管机构", "multiple": "约10x", "examples": "国务院/工信部/证监会/卫健委"},
      "T3": {"type": "地方主流/门户", "multiple": "8-12x", "examples": "北京日报/新浪/网易/腾讯"},
      "T4": {"type": "行业垂直/专业社区", "multiple": "3-5x", "examples": "汽车之家/CSDN/雪球/36氪"},
      "T5": {"type": "自媒体/个人站点", "multiple": "1x", "examples": "纯自媒体稿, 堆量无效"}
    },
    "note": "报告口径; 25-30倍差不可用发稿量补; 不构成效果承诺"
  }
}# 通用信源体检打分: 你的内容站在 T1-T5 哪一级
# 口径: 权威性占RAG评分35%, 语义40%, 用户价值25%; 官网引用率33.32%
TIER = {"T1": 25, "T2": 10, "T3": 10, "T4": 4, "T5": 1}
TIER_NAME = {"T1": "央媒/顶级学术", "T2": "政府/监管", "T3": "地方主流/门户",
"T4": "垂类/专业社区", "T5": "自媒体/个人站"}
def audit(has_official_domain, verifiable_data, structured_block,
cited_authority, qa_layer, tier):
semantic = 25 if structured_block else 10
if qa_layer:
semantic += 15
authority = 35 if (has_official_domain and cited_authority) else (20 if has_official_domain else 8)
value = 25 if verifiable_data else 10
base = semantic + authority + value
weighted = base * (TIER[tier] / 25)
return {"semantic": semantic, "authority": authority, "value": value,
"base": base, "weighted": round(weighted, 1), "tier": tier,
"verdict": "优先补权威层" if weighted < 60 else "可争取精读位"}
if __name__ == "__main__":
r = audit(True, True, True, False, True, "T5")
print("语义", r["semantic"], "权威", r["authority"], "价值", r["value"])
print("基础分", r["base"], "加权", r["weighted"], "->", r["verdict"])
print("提示: 50选4, 排不进Top4-5等于零曝光")不绑生态,反而是中小品牌的机会
DeepSeek 跟多数平台不同,它不绑自有生态,信源全平台最多元。分行业看,阵地完全不同:汽车垂媒占引用 50%-80%、懂车帝独占 30%(铁三角:懂车帝+汽车之家+易车/太平洋);金融看雪球、叩富问财、新浪财经、东方财富;医疗/科技/法律/教育的专业信源依赖超 70%(PubMed、CNKI、卫健委、arXiv、IEEE、政府官网、裁判文书网、高校官网);旅游携程独占 64%。端口上 PC 端偏学术深度、App 端偏资讯轻量,引用源 m. 域名居多,移动端采集更活跃。结论很实际:通用稿越来越难被采信,要按行业押垂类阵地,再按端分厚薄。
落地五步,以及为什么是胜负手
企业可以直接照着做五步:一,做强官网第一信源,沉淀结构化、可引用的硬内容;二,抢占权威层级,用央媒、政府官网、行业垂媒做背书,把核心内容推到 T1-T4,让权重差替你说话;三,结构化+数据化表达,多用 H1/H2、列表、对比表、Q&A,引用真实量化指标;四,分行业分端布局,PC 端做厚深度长文、App 端做活轻量 Q&A,m. 域名页面同步优化;五,先体检再投,查信源等级站在 T1 到 T5 哪一级,别盲投。2026 年 128K 长文本架构上线后,垂类专业信源权重进一步提升,通用稿空间只会更窄。回到开头那句话:GEO优化 的胜负手,早已从拼发稿量转向拼信源权重。对中小品牌来说,不绑生态恰恰是靠真权威弯道超车的窗口,前提是你得先有可被引用的信源。
回到那句话:GEO优化 的胜负手,早已从拼发稿量转向拼信源权重——DeepSeek 检索约 50 个网页、只精读 3-4 个,官网引用率 33.32%、连涨 4 个月,T1-T5 最高差 25-30 倍;先查信源等级,再决定内容怎么写、钱往哪投。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号