企业 AI 助手知识库落地:从文档解析到权限隔离的 7 个工程细节
原创
企业 AI 助手知识库落地:从文档解析到权限隔离的 7 个工程细节
原创
用户12808664
修改于 2026-10-28 16:12:16
修改于 2026-10-28 16:12:16
一、为什么"把文档丢给大模型"不可行
企业上线 AI 办公助手后,最常见的三句抱怨是:
- "它答的不是我问的。"
- "它说得有鼻子有眼,但内容是编的。"
- "销售能查到薪酬制度,这不行。"
直接把几百页制度文档上传、然后让模型回答,会撞上四道硬墙:
- 上下文窗口有限:制度手册、产品资料动辄几十万字,塞不进一次提问;
- 幻觉:模型找不到依据时,会用"合理但错误"的内容补齐;
- 权限失控:全员共用一份知识库,等于把 HR、财务、法务的敏感文档对所有人开放;
- 时效滞后:制度更新后,旧版本内容仍在被引用。
所以企业知识库的本质不是"存文档",而是一条完整的处理流水线:原始文档 → 解析清洗 → 切分 → 建索引 → 检索 → 重排 → 生成并附引用。任何一环做糙了,最终答案都会失真。下面逐个拆。
二、环节一:文档解析与清洗
这是最脏、最容易被低估、也最影响效果的一步。企业文档格式极乱:Word、PDF、扫描件、Excel、PPT、内部 Wiki、聊天记录导出……
关键动作:
- 格式归一:统一转成带标题层级的文本。PDF 优先取原生文字层,扫描件走 OCR 识别;
- 表格单独处理:表格转成"字段: 值"的形式,直接当普通文字切分会把行列切乱;
- 去噪:页眉页脚、水印、目录页码、重复的免责声明要剔除,否则大量污染检索结果;
- 补元数据:每段文字都要挂上"来源文件名、页码、所属部门、密级、生效日期"——这是后面权限过滤和溯源的基础。
经验:解析质量决定上限。一份扫描 PDF 如果识别错字率超过 3%,后面再好的检索也救不回来。宁可人工抽检 50 页,也别盲目全量灌库。
三、环节二:切分策略(决定检索准不准)
切分粒度直接决定"搜得准不准"。切太大,一段里混了多个主题,检索精度低;切太小,语义不完整,模型答不全。
推荐做法:先按标题层级切,超长段落再用"滑窗"兜底。 简单说就是:能按小标题拆开的就拆开;拆不开的长段落,再一小段一小段滑动切,段与段留一点重叠,防止语义被切断。
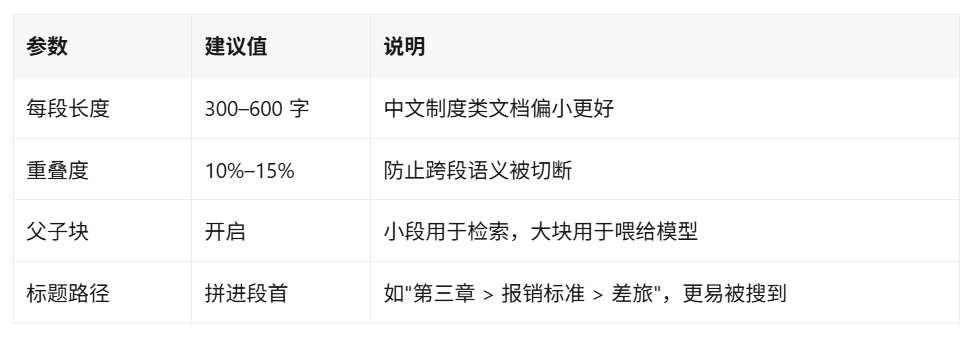
"父子块"是实用技巧:用小粒度段落去匹配问题(精度高),命中后返回它所属的整块给模型(上下文完整)。这样能同时兼顾"搜得准"和"答得全"。
四、环节三:检索与重排(决定答案对不对)
只靠"语义相似"检索,在中文企业场景经常翻车——专有名词、编号、条款号这类"精确匹配"需求,向量反而不如关键词。
推荐"混合检索"四步走:
- 向量检索:按意思找相近内容,处理"用词不同但意思一样"的问题;
- 关键词检索:精确命中条款号、产品型号、人名;
- 结果融合:把两路结果合并去重;
- 重排:对候选结果重新打分排序,只取最相关的几段送进模型。
引用溯源是必做项:把命中的文档名、页码一起返回,前端可点击跳转。这不只是体验问题,更是企业场景的信任基础——"AI 说的每一句,都能点到原文"。
五、环节四:权限隔离(最易踩雷的红线)
知识库一旦跨部门共享,权限就是红线。错误做法是"先检索完再过滤"——模型已经看到了敏感内容,过滤只是掩耳盗铃。
正确姿势:在检索之前就过滤。
- 每个文档/段落入库时就标记权限信息:部门、角色、密级;
- 用户提问时,先根据身份算出"他能看到的文档集合";
- 在检索阶段就只在这个集合里找,从源头杜绝越权。
还要补三件事:
- 密级分层:公开 / 内部 / 机密 / 绝密四档,按用户密级上限过滤;
- 最小可见原则:默认不可见、按需授权,而不是默认全开;
- 审计留痕:谁在什么时候查了什么文档要能查到,合规场景必备。
六、环节五:效果评估(别靠感觉调参)
没有评估的知识库就是"玄学调参"。上线前至少要有套小评测集。
做法:
- 从真实业务问题里抽 100–300 条,人工标注"正确答案 + 依据文档";
- 测三个指标:
- 召回率:正确依据有没有被检索出来;
- 答案准确率:生成答案与标准答案的一致度;
- 幻觉率:无依据生成的比例(最该盯的指标);
- 每次调切分、调检索后都回归测试,避免"改好一个、坏掉三个";
- 建立错误回流:把线上答错的案例定期补进评测集,形成闭环。
反直觉结论:很多团队花大量时间调提示词(prompt),但把切分粒度调小、开启重排后,准确率提升远大于改提示词。
七、环节六:更新、版本与审计
企业制度是活的,知识库也必须是活的。
- 增量更新:文档变了只重建变化部分,避免全量重灌;
- 版本与生效期:同一条制度可能新旧两版并存,标记生效日期,检索优先返回现行版本;
- 过期下架:失效文档要能一键下线,防止旧政策继续被引用;
- 变更审计:谁改了什么、何时生效,留痕可查。
八、环节七:人机协同与兜底
再好的系统也会答不出的时候。设计上要留"体面的退路":
- 置信度阈值:检索相似度低于阈值时,不硬答,而是回复"未找到相关规定,建议咨询 XX 部门";
- 一键转人工:给出对接人或工单入口,把 AI 定位成"第一道筛子"而非"最终裁判";
- 用户反馈:每条回答下加"有用/没用",反馈数据回流到评测集;
- 场景收敛:先聚焦 3–5 个高频、低风险的场景(如制度查询、资料检索、公文起草),跑稳再扩面。
九、结语
企业 AI 助手的差距,往往不在"用了哪个模型",而在这些不起眼的工程细节:解析干不干净、切分合不合理、检索混不混合、权限前置不前置、有没有评测闭环。
把这 7 个环节做扎实,一个中等规模的模型也能答得又准又稳;反过来,只堆模型不做工程,再强的模型也会在企业场景里"翻车"。
如果你的团队正在搭企业知识库,欢迎在评论区交流你踩过的坑——尤其是权限和评估这两块,几乎每个项目都有一段故事。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号