运维超自动化中的性能优化实践
原创
先说关键信息:性能优化的第一步不是"调参",而是"先把瓶颈找出来"
很多团队做性能优化,习惯从"加内存、升配置"开始,却忽略了最关键的一步:定位真正的瓶颈。传统排查方式高度依赖专家经验:专家负荷高、人工分析效率慢,经验与方法还难以积累沉淀 。更要命的是,卡顿的根因往往不在单个设备上——服务器、虚拟化、操作系统、光交换机、存储,任何一个环节都可能"拖后腿",而人工很难把这几个层面串起来看 。超自动化带来的转变,是把性能优化从"专家猜测"变成"数据定位":先让全栈数据说话,再谈怎么优化。
第一步:把性能数据采集做"全"
性能优化的前提,是数据要全、要连续。以超自动化平台的能力为例:机器人每日定时通过SSH或WinRM登录服务器,执行top、df -h等命令采集CPU、内存、磁盘使用率及关键进程状态,对异常指标自动截图,所有数据汇总生成含趋势折线图的Excel报告;一旦资源使用超过阈值(如CPU高于90%持续5分钟),立即触发告警并附截图与主机信息 。采集指标覆盖CPU使用率与核心分布、内存与Swap、磁盘I/O性能(IOPS、延迟、吞吐)、网卡流量与丢包率、系统负载、Top N进程等维度 ——性能优化需要的"证据",第一次被完整地自动攒齐。
第二步:让AI做全栈根因分析
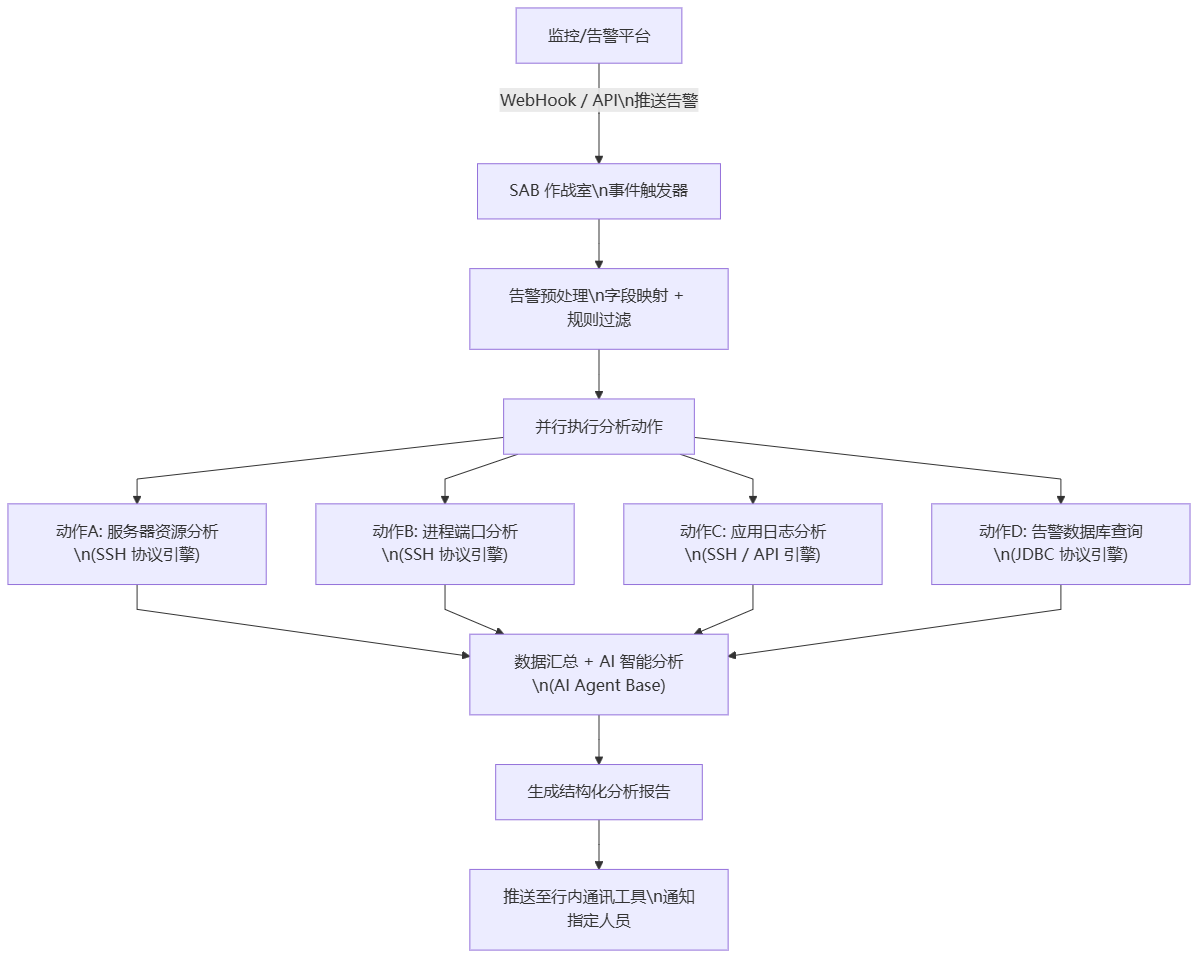
当系统出现卡顿时,平台可对涉及的全栈基础设施进行资源分析:服务器(x86、信创、IBM小型机)、虚拟化(PowerVM、VMware等)、操作系统(AIX、Linux、麒麟)、光交换机(博科、思科)、存储(华为、HDS等),并结合AI智能体进行根因定位、给出决策建议 ;AI Agent Base对全栈采集数据做关联分析,自动定位性能瓶颈所在层级(服务器/虚拟化/SAN/存储),输出包含根因定位和处置建议的结构化分析报告
。
日常的性能异常同样有智能兜底:借助智能算法对CPU、内存、磁盘、网络等性能数据与业务指标做异常检测,快速识别系统异常,辅以关系链路和日志分析完成故障根因分析 ;算法还能与运维人员交互,根据反馈不断调整根因判断,直到找出真正的原因;系统则基于专家反馈自动调参,越用越准 。有实践表明,AI驱动的根因分析能把排查时间从数小时缩短至几分钟 。
第三步:从单点优化走向持续优化
性能优化不是一次性的"救火",而是持续的运营。数据库层面,平台可自动完成AWR、ASH、ADDM报告分析及会话、统计信息等性能检查 ;更进阶的形态是预测性优化——数据库索引性能衰减趋势被AI预判,自动生成最优索引优化方案,在业务低峰期无感执行,同步校验数据一致性、业务可用性与安全权限,全程无人工介入 。而每一次处置完成后,系统还会自动生成复盘报告、沉淀到知识库,让"这次的优化"变成"下次的经验" 。当然,这一切的底座,依旧是巡检数据——它持续为容量规划和性能优化提供数据支撑 。
让优化从"碰运气"变成"有依据"
性能优化的本质,是一场"用数据找瓶颈"的调查:数据更全,判断才更准;回溯更长,趋势才看得清 。下一次系统卡顿再发生时,不妨先别急着加配置,问自己一个问题:我们能拿出完整的全栈性能数据吗?如果答案还不确定,那么把性能数据的自动采集先跑起来,就是最有价值的第一步。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号