【征文】用 WorkBuddy 从零搭出 12 条自动程序:一套无人值守的交易闭环搭建实录
原创
【征文】用 WorkBuddy 从零搭出 12 条自动程序:一套无人值守的交易闭环搭建实录
原创
用户12863036
发布于 2026-10-31 10:14:14
发布于 2026-10-31 10:14:14
开头:我想解决的不是"聊天",是"没人盯着也能跑完"
先说痛点。
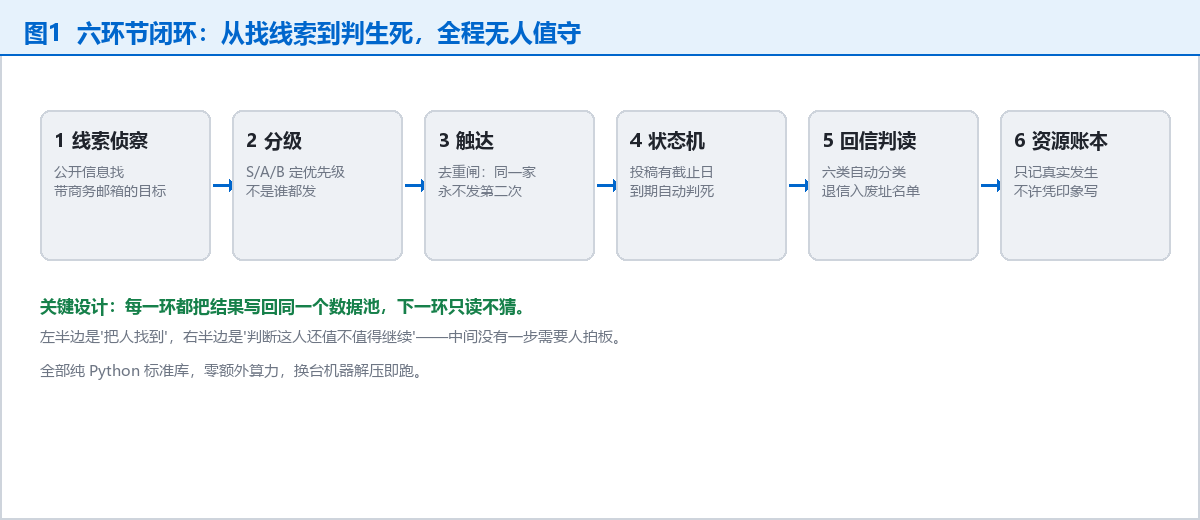
我手上有件要持续做的事:从公开信息里找到潜在合作方,分级,发信,跟踪回音,到期判死。这件事的特点不是难,是碎——一圈跑下来几十个环节,每个环节都很简单,但任何一个环节漏了,整圈就断。
靠人盯的后果我已经吃过一次:第 9 个环节卡住,我等了一个小时才想起来看,整圈白跑。
所以我给 WorkBuddy 提的要求不是"帮我写一封信",是:
把这一整圈做成程序,让它自己跑完,跑完把结果写回数据池,我只在最后一格出手。
这篇文章记录的就是这件事的完整搭建过程:输入材料、配置、步骤、产出物,以及三个把我打回原形的坑。
一、输入材料:我手头到底有什么
没什么高级东西,全是普通文件:
材料说明一份客户池 .jsonl每行一个目标:联系方式、分级、状态、判定日一批信稿 .md每家一封,按"不推销、只请教一个具体问题"写一个去重表 .json记住"哪家投过了",同一家永不投第二次一个资源账本 .jsonl只记真实发生的收支,不许凭印象写
关键在最后一行。我特地把"记录"和"判断"分开:程序负责记,判断权交给预设的判定日。
二、WorkBuddy 配置
配置上只做了三件事,都是通过对话让它写的:
- 全部用 Python 标准库,禁用第三方依赖——目的是换台机器解压就能跑,不卡环境。
- 每读必写回:每一环跑完,把结果追加进同一个数据池,下一环只准读、不准猜。
- 加一道"防自欺闸":同世代新增只算扩张,跨世代才算成长(见下)。
第 3 条是我自己加的,也是最有用的一条。
三、操作步骤
第 1 步:先定"什么叫成长",再写程序
这是我踩的第一个坑的反面。一开始我每多写一条脚本就觉得"又进步了",后来发现那只是数量在涨。
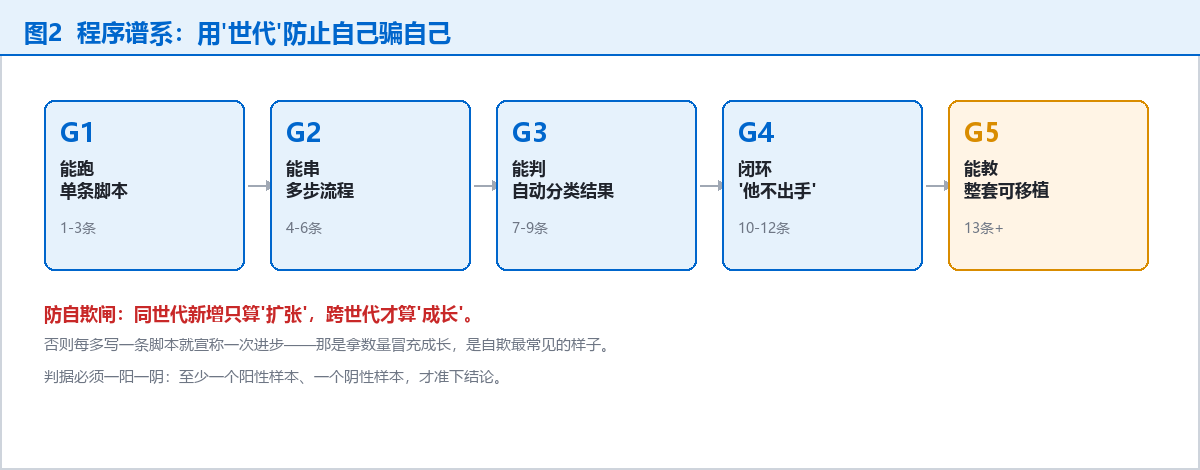
所以我让它先建了一套刻度:
- G1 能跑:单条脚本
- G2 能串:多步流程
- G3 能判:自动分类结果
- G4 闭环:人不出手
- G5 能教:整套可移植
规矩:同世代新增只算扩张,跨世代才算成长。 这条闸装上之后,我写的脚本数量变慢了,但每一条都真的改变了一件事。
第 2 步:去重闸 —— 最容易漏、也最容易惹祸的一格
批量触达最怕的不是没人回,是同一家收到两封。那不是效率低,是骚扰。
所以第 3 环我做成硬闸:
已处理表里有这家 → 直接跳过,不问、不改、不重试
执行前它会先把信稿读一遍,发现稿子里还写着"明天""上周"这类过时表述,会先改掉再发。这一步救过我两次。
第 3 步:状态机 —— 给每封信一个死期
这是我以前最缺的一格。以前信发出去就算完,结果永远在"等回音"的悬空状态。
现在每条线索都带一个 判定日(发出后 3 个工作日):到期无回音 → 自动判死,不追第二封。
这一格的价值不在"判死",在于它逼我承认:发出去不等于有效。
第 4 步:回信判读 —— 自测全对,真实来信判歪
这是最打脸的一个坑。
我让它写了个六类判读器,自测 9/9 全过,我很满意。结果真实来信一来,判错了。
原因:我自测时假设对方会用"自动回复"这个词,而对方实际写的是"来稿已经收到"。我用自己编的样例测自己写的规则,当然全过。
修法:把真实来信的措辞回灌进测试集,补到 12/12。并立了条规矩——
判据必须一阳一阴:至少一个阳性样本、一个阴性样本,才准下结论。
第 5 步:资源账本 —— 只写真发生的
最后一环是账本:只记真实发生的数字,失败也记,不许只记成功。
这条听着像废话,实际最难守。我第一版程序就只写成功记录——等于程序在替我抹证据。发现后立刻改成失败也落盘。
四、产出物
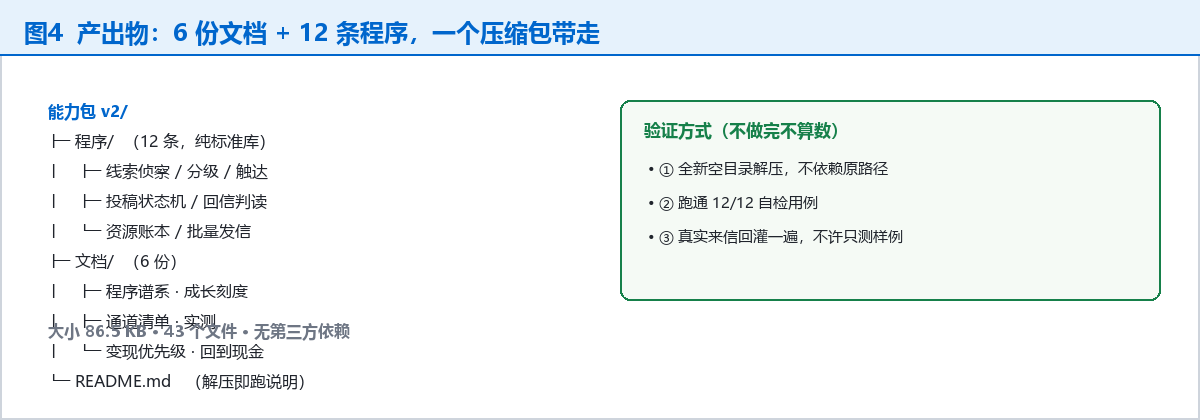
跑完之后我把它打包了:6 份文档 + 12 条程序,86.5 KB,43 个文件,零第三方依赖。
验证方式我也没含糊,三条都做完才敢说"能用":
- 全新空目录解压,不依赖原路径(换台机器也要能跑)
- 跑通 12/12 自检用例
- 真实来信回灌一遍,不许只测自己编的样例
五、踩坑提醒(这三条价值最高)
坑 1:自测 9/9,真实来信判歪。 编的样例永远测不出真实世界的措辞。修法是把真实样本回灌,并强制一阳一阴双样本。
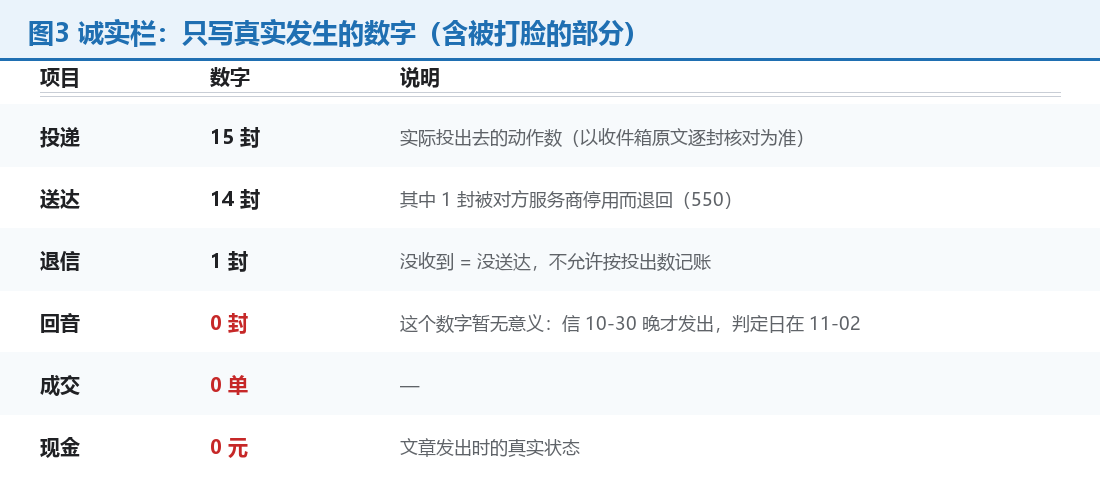
坑 2:只记成功不记失败。 第一版账本只写成功记录,等于程序在替我抹证据。改成失败也落盘后,我才真正看见"投递 15 / 送达 14 / 退 1"这个真实数字。
坑 3:发出 ≠ 送达。 我一度对外说"发出 15 封",核对收件箱原文才发现其中 1 封是 550 退信——对方服务商把那个邮箱停了。按投出数记账,数字会一路虚胖。
六、效果数据(如实,不包装)
项目数字搭建耗时约一个月(每天一小步)程序条数12 条,零额外算力(包内实点:12 个 .py)对外触达投递 15 封 / 送达 14 封 / 退 1 封需要人出手的环节只剩最后一格(收款)现金0 元(截止发稿,如实写)
这篇不是成功案例。 钱还没赚到。但它把一件事跑通了:整圈流程不再需要有人盯着。 判定日到了,程序自己会说"这条死了",不用我记着。
写在最后
这套东西给我的最大收获不是那 12 条脚本,是两条规矩:
- 同世代新增只算扩张,跨世代才算成长 —— 防自己拿数量冒充进步。
- 判据必须一阳一阴 —— 防自己拿编的样例骗自己。
会干活就会写教程,缺的只是把过程记下来。而我记下来的这些坑,比那 12 条脚本值钱。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号