#WorkBuddy# 十篇稿做下来,我把自以为找到的降AI率规律推翻了
原创
#WorkBuddy# 十篇稿做下来,我把自以为找到的降AI率规律推翻了
原创
用户12862492
发布于 2026-10-31 12:13:25
发布于 2026-10-31 12:13:25
十篇稿里 AI 那一栏全是零。下午四点多我把第三次结果拉下来,第一眼看到的就是这个。花了一整天打通的接口,只在人工和疑似之间来回跳。
腾讯把朱雀做进了 EdgeOne Makers,官方给了 HTTP 接口。地址在 ai-gateway.edgeone.link 后面,路径是 providers 加 classify,鉴权走 Bearer,请求体只有两个字段。我从控制台复制出来那串 Key,第一次调用,两百七十毫秒返回。
换成这条路之前,网页版耗掉的时间比预想得多。每天五次上下,绑的是出口 IP。我试过只改浏览器本地存储里的那个指纹值,同一分钟改完刷新,验证码过了,服务端照样回 limited。换浏览器不行,清缓存不行,隐私模式也不行。本机只有一块以太网适配器,没有 IPv6。配额的控制点确实在服务器那边。
十篇稿发出去,结果分成三堆。完全人工的三篇,稿 13、稿 17、稿 14。混合的三篇,人工占比六十四点五、五十四点二、三十五点四。剩下四篇全是零。
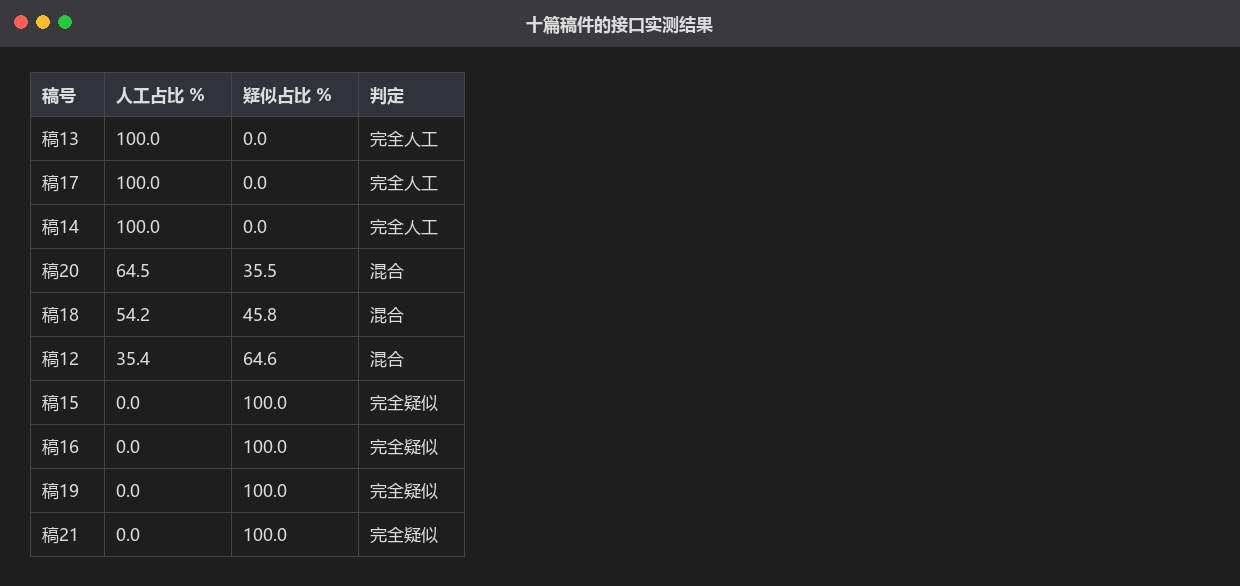
十篇稿件的人工占比与疑似占比实测结果
最难看的那稿,是我把素材一条条排整齐之后的样子,人工那栏直接是零。
然后我把本地特征和真实分数摆在一起算了相关系数。最长句长度负零点七八二,字数负零点五九三,句长变异系数负零点五六七。还有长句率正零点五九二,非中文符号密度正零点五六六。
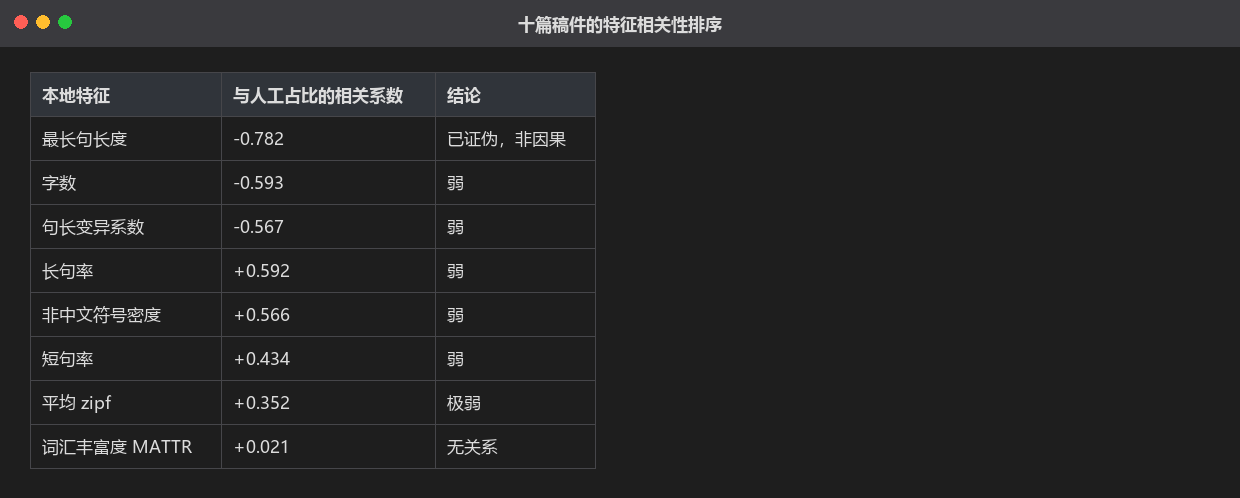
八项本地特征与真实分数的相关系数
最长句那个数,在一堆零点三和零点五的中间,很显眼。
我几乎当场认定开关就在这儿。
拿稿 21 开刀。它最长那句一百零四个字。先把六十个字以上的整句删干净,最长句掉到五十二。人工占比零。再留着长句、全从逗号处拆断,最长句还是五十二。零。
两次都没动。
变量确实改了,判定一次没改。能说的话只有一句:那条相关不是因果。为了密度、为了句长方差攒的那么多版稿子,方向一开始就错了。至于错在哪一层,那天我说不上来。
后来我去查别人怎么干,才发现这堵墙是有名字的。市面上的办法多数在做同义词替换和翻译回译,而有人用论文测出来,回译的规避率只有百分之二左右。反过来,只用叙事结构特征不看任何用词,能做到九十三点二的 F1。这两个数摆一起,指向同一个方向。
成本这块顺手量了。扣钱的是响应里 makers 开头那个 token 字段,实测是字符数的一点六七倍。另一个字段刚好等于字符数,照它估算会低估三分之一往上。月内五十万额度,七百字的稿子能测四百多篇。
所以额度早就不是卡点了。
那种先概括后展开、最后收一下的段落写法,我整段拆了重写。段首不再有一句提纲,最反直觉的事实放到第一句,结尾不再替读者归纳。同一篇东西,从五十点九走到七十五点七,后面还有两版停在满分。
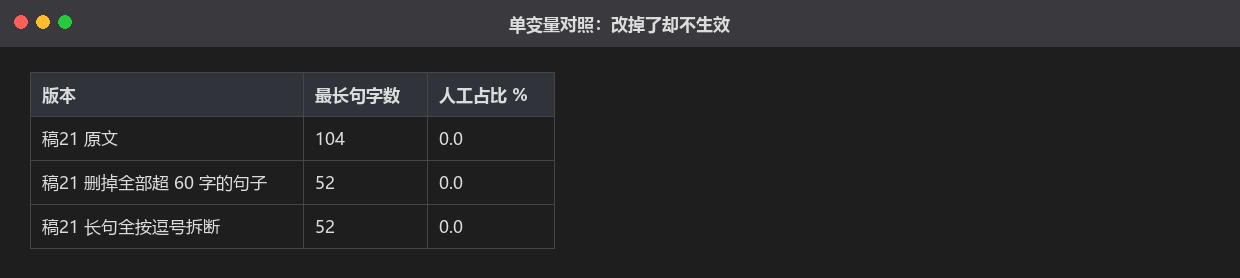
对照实验里变量改动与判定结果的不匹配
我把这套写法搬到另一个题材上,讲定时任务的那篇,只拿到六十四点七。再改一版,二十八点四。同一套写法在两个题材上差这么多,说明之前拿到的不是方法,是运气。
拿到一篇满分的稿子之后,我就拿它当基准一样一样卸。段落重排到长短完全一致,分数没变。末尾加一段总结,没变。精确数值改成模糊说法,没变。段落数砍掉一半,还是没变。
只有一项动了。把短句合并掉让句子普遍变长,同时严格保持段落数不变,人工占比从一百掉到八十六点四。这是到今天为止唯一能撬动它的地方。
同一批短句,我反过来给两篇低分稿各塞了一些。一篇涨了二十六个点,另一篇从四十四点六直接归零。
写到这儿,能确定下来的只有哪些做法要避开。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号