【征文】我用 WorkBuddy 做了个证照录入工具:一单 20 分钟的活,机器跑 141 秒
原创
【征文】我用 WorkBuddy 做了个证照录入工具:一单 20 分钟的活,机器跑 141 秒
原创
王磊-医药信息化
修改于 2026-11-03 07:26:24
修改于 2026-11-03 07:26:24
上个月帮朋友的公司弄了个东西。他们做客户开户,新客户要交一整套证照:营业执照、药品经营许可证、开户许可证、法人身份证、质量调查表、三份授权委托书、质保协议,十几份材料摞起来二十多页。收齐了还得一样样敲进时空 KSOA 的客户资质审核表,三十来个字段,其中十来个是统一社会信用代码、银行账号、注册资金这类长数字。
现在是人工干这活。一单 20 分钟左右,这个数是他们自己掐表算的:手快的 15 分钟,赶上扫描件糊、身份证要翻正反面,能拖到 25 分钟。没什么技术含量,本质是人肉 OCR,但抄错一位就得回头翻材料,返工比第一次填还烦。
我做了个桌面工具替掉敲键盘这一段。选文件,点开始,141 秒后表单填好,附一份核对清单,人核一遍、点保存。连核对带保存,一单五分钟左右。
先把话说清楚:省掉的是抄写和翻页,不是判断。材料缺页、印章压住字、规则本身还在变,这些还是得人看。
先看结果
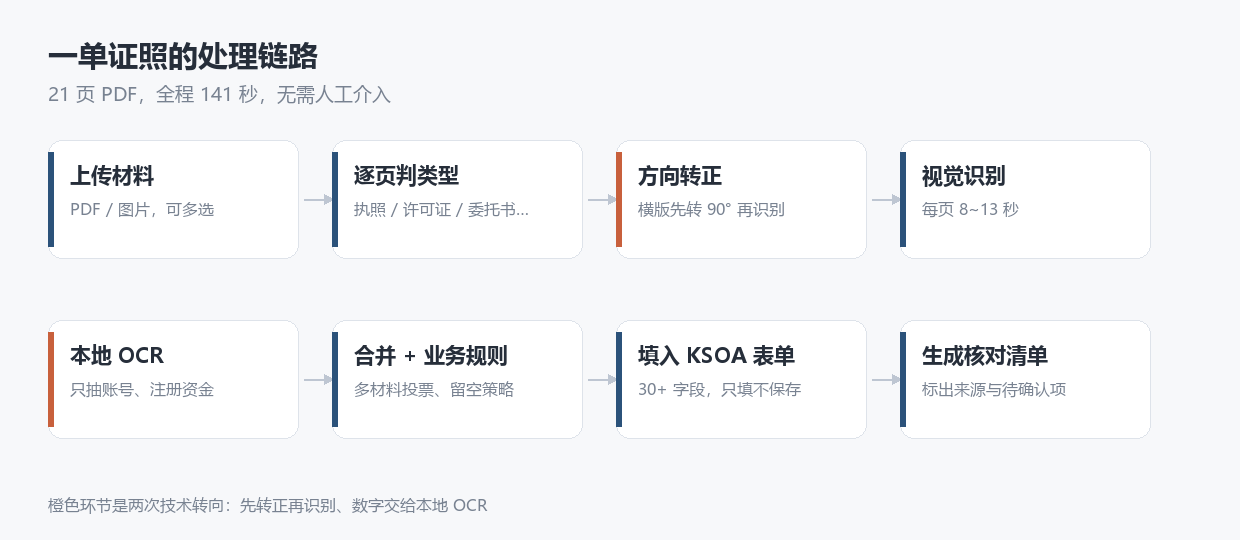
处理链路
输入可以是一个多页 PDF,也可以是十几张手机拍的图。整个流水线分四段:文档分类(判断每一页是执照、许可证、委托书还是别的)、方向校正(横着扫的先转正)、字段抽取、规则合并与填表。分类和"这一栏叫什么"交给视觉模型,方向校正和数字字段交给确定性算法。
21 页的 PDF,141 秒跑完。识别用的是免费模型,OCR 在本地跑,这一单不花钱。
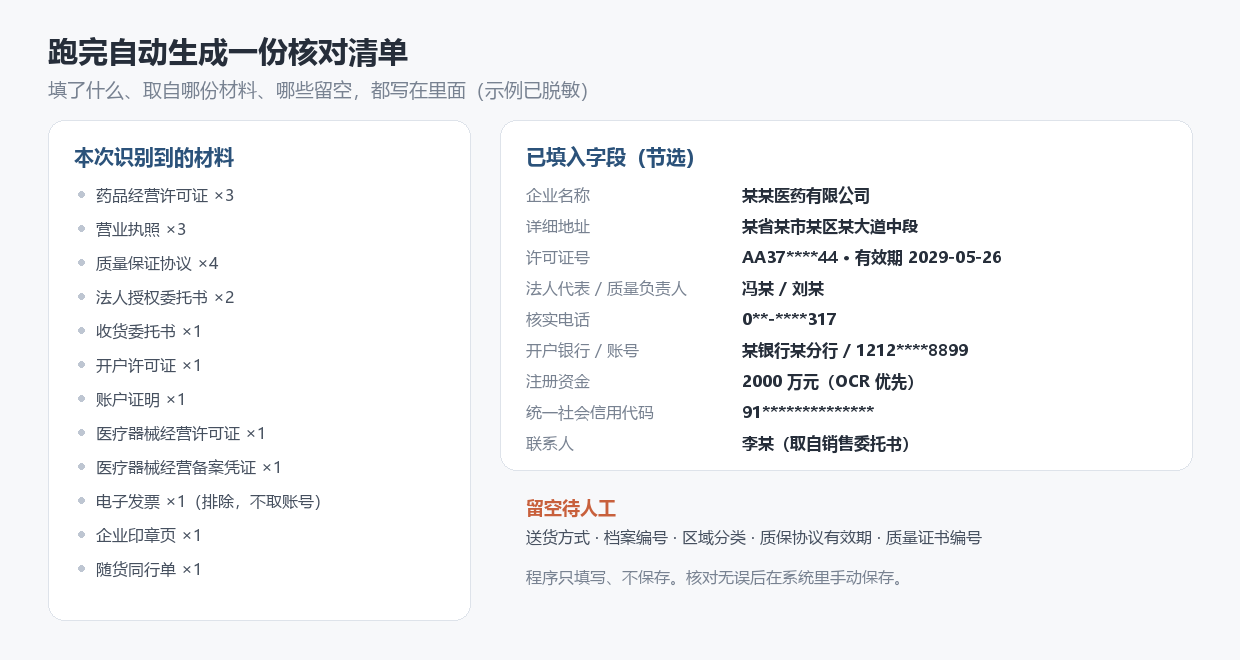
核对清单
跑完落一份清单,写清楚识别到哪些材料、每个字段填了什么、哪些留空需要人工补。上面这份是脱敏后的示例。每个值都带溯源:来自哪一页、由哪个通道(模型还是 OCR)读出。对复核的人来说,溯源信息比准确率数字本身更管用。
有个边界我一开始就定死了:程序只填、不保存。自动化的东西碰业务单据,最后那一下必须是人点。
效率这笔账我想算得老实一点。人工 20 分钟,工具 141 秒加人工核对两三分钟,一单实际省下十五分钟出头。一天十单就是两个多小时,不算惊天动地,但那两个多小时原来是纯手工的重复劳动。错漏率我没数据,不敢吹,能说的是以前填完凭印象,现在清单上写着哪个字段来自哪份材料、哪个留空,漏了什么一眼能看见,复核的人省心不少。
技术栈没什么特别的
环节 | 用了什么 | 为什么 |
|---|---|---|
界面 | PyQt5 | 单文件桌面工具,打包不折腾 |
证照识别 | GLM-4V-Flash | 免费的多模态视觉语言模型,中文证照的版式基本看得懂 |
数字字段 | RapidOCR + onnxruntime | 本地离线的判别式 OCR(PP-OCR 系模型转 ONNX),后面细说为什么非它不可 |
接口调用 | requests + 连接池 | 简单够用 |
填表 | pywinauto | KSOA 是老式 C/S 客户端,没开放接口,只能走 GUI 自动化 |
打包 | PyInstaller | 客户的电脑上不能指望有 Python |
授权 | Ed25519 签名 | 客户端只放公钥,注册码伪造不了 |
五千八百行 Python,主程序占了四千二,剩下是首营品种流程、授权校验和签发工具。
选型上其实只有一条主线:概率性组件和确定性组件分开。凡是逐位抄录的字段走判别式模型,凡是需要"理解"的判断(这是什么文件、这一栏叫什么)走生成式模型。后面几个坑,追到根上都是这两种确定性被混在了一起。
我平时怎么跟它配合
很多人用 AI 写代码的方式是丢一句需求,等它吐一坨东西出来,然后再改。这个项目跑下来,真正省时间的其实是另外几个习惯,每个都能对应到软件工程里现成的说法。
给规则,别给形容词。
"识别准一点"这种话没有任何信息量。"质量负责人只从药品经营许可证里找,其他材料不许取""委托书按标题关键词分类,标题没有才看正文""识别不到就留空,不许编",这些是硬规则,得一条条列出来。说白了就是把隐性领域知识显式化成约束条件:AI 不知道你们质控部门怎么定的规矩,它只能从你给的约束里恢复语义。
出错的时候给证据链。
别说"填错了",说"银行账号填成了 123456789012345,真值是 123456789012,材料里只有一张开户许可证和一张电子发票"。有了输入、输出、可疑来源这三要素,定位问题就是几分钟的事。这就是写缺陷报告的基本功,只不过对象从编译器换成了模型。
让项目自己记事。
这是我觉得最值的一步。把架构、字段映射全表、打包流程,还有一份踩坑记录,都做成项目里的文档,每次开工先读。踩坑记录按"现象、根因、修复"三条写,目前攒了三十九条。形式上接近事后复盘(postmortem)文化,区别是读者不是人,是下一次会话里的 AI。它每次醒来都是白纸,这份文档就是它的组织记忆。
效果说不上神奇,但确实有:第一个坑查了大半天,到第三十几个坑的时候,基本是描述完现象就能改。
改判定逻辑之前,先写反向用例。
我建了一套离线 mock,用合成的识别结果直接调合并函数,不碰模型、不碰网络。关键是反向用例,比如"执照读对的时候不能被误杀"。这是回归测试的常规做法,但容易被忽略的一点是:对带概率性的系统,只测正向用例几乎等于没测,因为生成式组件的失败模式大多不在你设计的正向路径上。这个我吃过两次。
五个坑
一、横着扫的执照,模型会整页编造
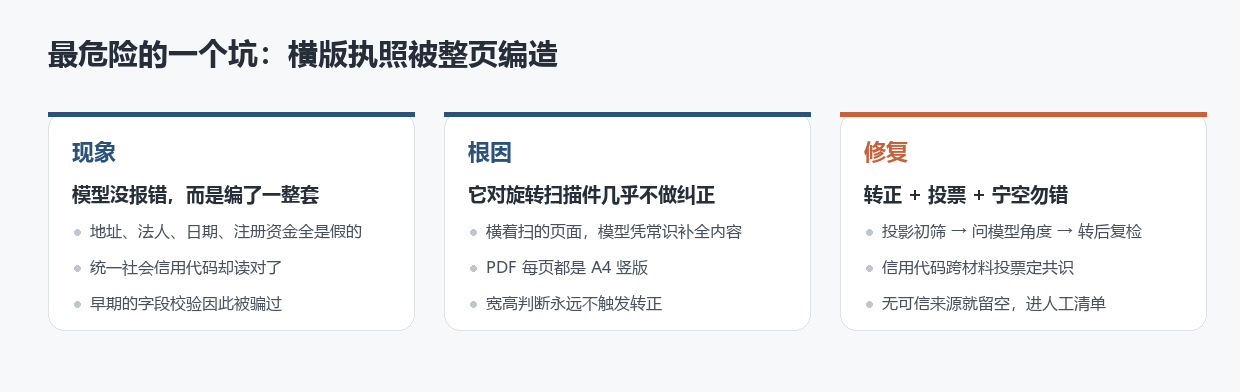
旋转幻觉
这个最吓人。横版扫描的营业执照,模型没报错,也没提示看不清,而是安安静静编了一整套:地址、法人、日期、注册资金全是假的。唯独统一社会信用代码读对了,我早期的校验只看代码格式,就这么被骗过去了。
这在文献里有名字:幻觉(hallucination)。机制上不难理解。自回归模型逐 token 生成,遇到信息量不足的输入(转了 90 度的字对它来说就是噪声),最自然的出路是回到训练分布里最"像"的内容。它不是在说谎,是在补全,只是补的是它见过的别的执照。文档理解任务上这类问题尤其常见,因为证照的版式先验太强了。
更绕的是 PDF 每一页都是 A4 竖版(595×842)。所谓"横版"其实是页面里的扫描内容转了 90 度,靠宽高比判断方向的代码永远不触发。
最后的方案是三层。第一层是本地初筛:对每一页做灰度投影剖面分析(projection profile analysis)。文字行方向变了,垂直投影的方差结构会明显不同,这是文档图像分析里的老办法,零成本,而且宁多勿漏、误报无害。第二层只对可疑页问模型方向,而且只让它回答 0/90/180/270,把开放问题收窄成四选一;输出空间越小,幻觉越难发生。第三层是转后本地复检,转坏了回滚原图。
再加一道业务防线:信用代码跨材料投票定共识,凡与共识不符、或者地址跟共识地址对不上(最长公共子串小于 5)的页面整页弃用。没有可信来源就留空,进人工清单。这个思路是从容错设计里借的朴素版本:不信任任何单一来源,靠独立来源交叉验证。
顺带说一句,模型判方向本身也不靠谱。实测 6 页只对 3 页,正着的协议页它说该转 90 度。两个弱信号串起来用,加个回滚,才勉强够用。弱信号组合加退路,比苦等一个强信号现实得多。
二、让它读数字,等于逐位掷骰子
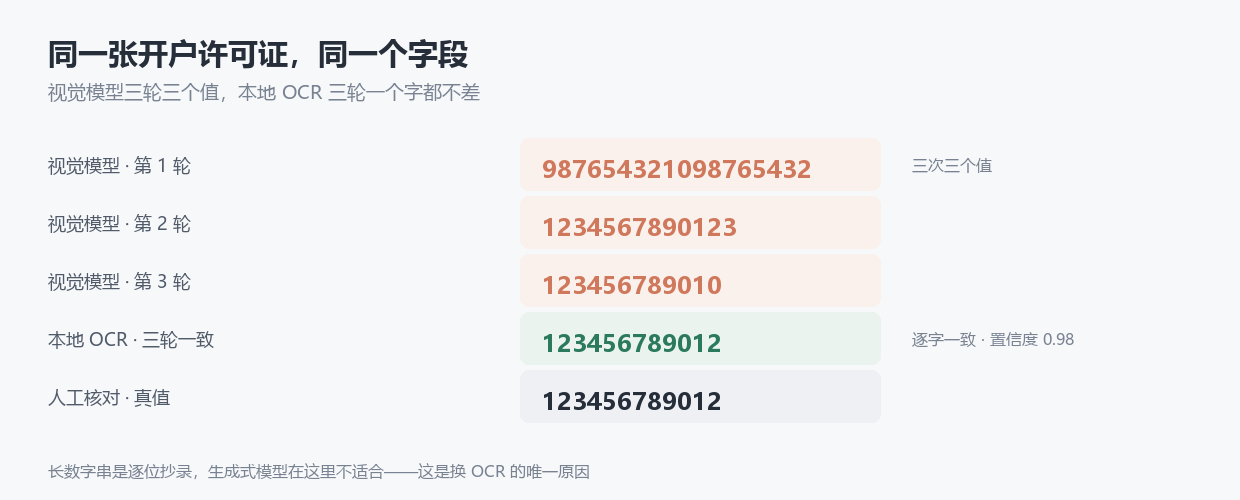
数字对照
同一张开户许可证,三轮读下来三个账号。真值 123456789012,它给我 987654321098765432、1234567890123、123456789010。temperature 调到 0.01 也不收敛。
这件事值得多说两句,因为它解释了为什么调参数没用。生成式模型每个位置输出的是 token 的概率分布,采样就是从这个分布里抽签;temperature 只是把分布削尖或摊平,削得再尖,长数字串相邻候选(比如 5 和 6、52 和 2)之间的概率差距还是很小,抽错是常态。这不是"不够聪明",是架构使然。
我先试的是"共识仲裁":两页材料交叉复核,同页两轮一致才采信。结果是能防错,但读不对。最后经常三个来源全打架,只能清空留给人工。
转折点是换成本地 RapidOCR。同一个 PDF,三轮逐字一致读出 123456789012,置信度 0.98,注册资本"贰仟万圆整"和信用代码也全对。每页 2.5 到 6 秒,比调模型还快,而且完全离线,一分钱不花。
为什么 OCR 行?因为它是判别式模型:检测、分类、识别三段各管各的,识别端用 CTC 解码,输出的就是"这一小块图最像哪个字符",没有生成、没有补全、没有上下文发挥,同一个输入永远同一个输出。OCR 在查表,生成式模型在算下一个 token 的概率。两种确定性,不能混着用。
有点讽刺,这活里最没技术含量的那部分恰恰最可靠。从那以后我定了一条:账号、信用代码、注册资金这类逐位抄录的字段,一律先走本地 OCR,模型只负责判断"这页是什么文件""这一栏叫什么"。
三、兜底逻辑把别人的账号填了进来
有一轮填出来的账号是 123456789012345,15 位、格式完全合规,跟真值完全不搭。
查下来是这么回事:开户许可证那页没读出合格账号,代码的兜底链跑去"其他"类文档里抓账号,而材料里恰好有一张电子发票。发票上本来就印着销货方、购货方的开户行和账号。
单看每一环都没错:兜底链在扩大召回,格式校验也通过了,15 位纯数字,完全合法。错在系统层面缺了一个约束:字段的来源白名单。修法是账号只认开户许可证和账户证明两类页面,而且必须 9 到 25 位纯数字,不合格就留空。
这个教训换个说法就是最小权限原则:一个字段允许从哪里取值,应该白名单枚举,而不是"哪里像就从哪里取"。电子发票、调查表这类材料天然带着账号、税号、电话,任何"从其他材料兜底取数字字段"的写法,都可能抓到别人的信息。这事想想挺后怕的。
四、弹窗怎么点都不出来
客户类别和客商分类是 lookup 字段,要双击弹出选择框。昨天能点,今天点四次都不弹。
两个原因叠在一起。KSOA 单据有浏览态和编辑态两个状态,控件行为跟着状态走,默认浏览态下控件根本不响应,得先点工具栏的"更新"。这本质是状态机问题:GUI 自动化必须显式跟踪应用状态,不能假设"界面长这样就代表能点"。二是 pyautogui 的 doubleClick 只是把鼠标挪过去双击,没先给控件键盘焦点,Windows 消息时序上就有竞争,时好时坏。换成 pywinauto 原生的 click_input(double=True),先 set_focus 再真实双击,之后没再失手。
结论是控件交互尽量用 pywinauto 的原生方法,pyautogui 只用来做不依赖焦点的事,比如滚回顶部、在弹窗里按方向键。
这类老式 C/S 客户端最磨人的地方就是没有文档。哪个按钮要先点、哪个字段要什么顺序,全靠一遍遍试出来,试完还得记下来,不然隔两周又忘。我踩坑记录里 GUI 这一段是最厚的,不是技术多难,是不可见的东西太多。
五、想提速,别去压画质
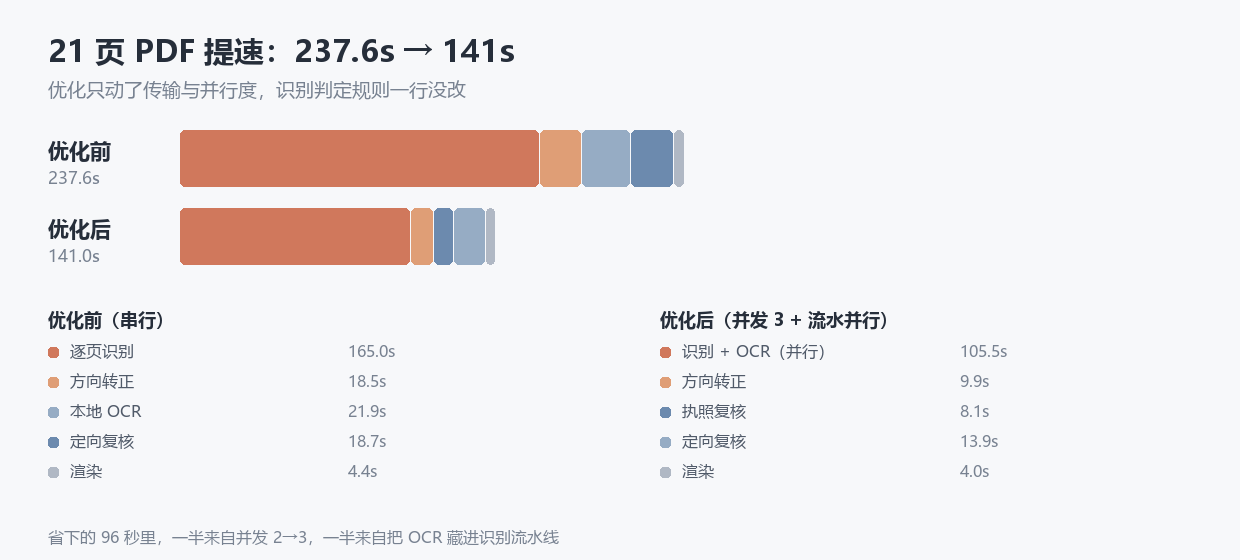
耗时对比
第一版 21 页跑 237.6 秒,其中逐页识别 165 秒。直觉是图片太大,压一压就好,结果发现服务端每页推理 8 到 13 秒,几乎不受图片体积影响。瓶颈在服务端推理,不在传输。先测量再动手,这是性能工程的第一课,我又交了一遍学费。
真正有用的是四件事:上传图转 JPEG q88(PNG 3.1MB 降到 886KB,识别结果完全一致,纯粹降传输成本);用 requests.Session 复用连接(一轮三十次调用,省掉重复握手);并发从 2 提到 3(165 秒降到 105 秒);把本地 OCR 和逐页识别做成流水线(pipelining,不是并行):OCR 那二十秒本来串行等在后面,现在被识别时间吸收掉,顺手还能拿 OCR 的信用代码反证首读有没有错。
237.6 秒到 141 秒,省 40%,一次限流都没有,抽查的账号、注册资金、登记机关、法人、地址跟优化前完全一致。
并发我试过 4 路,也是 0 限流,但只多省 7 秒,留 3 路更稳。收益递减的时候,别为了最后一个 7 秒增加系统性风险。
如果重来一次
先说清"不许编"这条底线。 自动化填业务单据,宁可空着让人补,也不能填个看着合理的假值。所有可疑值都要在清单里标出来源和理由,人一眼能看出该核哪里。翻译成术语:每个字段要么有可信溯源,要么显式置空,不存在"看起来对"这个中间状态。
数字交给 OCR 这件事应该更早做。 我在共识仲裁上耗了差不多两天,才想明白问题不在校验,在源头选错了工具。白忙两天。校验链做得再厚,也救不了上游的随机性。先分清哪一层是概率性的,再谈哪一层需要防错。
踩坑要写下来。 三十九条"现象、根因、修复",下次开新会话,AI 先读完再动手,同一个坑没踩第二次。这一步把一次性的对话变成了能攒下来的东西。
什么场景适合抄这套
要做大量固定格式单据录入的岗位,比如资质审核、客户开户、报销、合同台账、检验报告,都差不多。判断标准其实就两条:格式是否相对固定,以及错填的代价是否远高于漏填。这套"宁空勿错"的设计只为后者划算。
还有一类是被卡住过的:用的是老式 C/S 客户端(各类行业 ERP),厂家不给接口,以为没法自动化。pywinauto 这条路走得通,就是细节烦。
反过来说,如果录入规则本身还在天天变,或者材料质量实在太差(缺页、糊成一团),这东西帮不上太多。它的定位是替人把大部分字段填掉,剩下几个明确标出来请人看。指望它全自动,用不了三天就得关掉。
顺便吐槽一句:这类工具的价值天花板不在 AI,在材料质量。扫描件糊成一片的时候,换什么模型都是猜。
附:延伸阅读
- Ji et al., Survey of Hallucination in Natural Language Generation, ACM Computing Surveys, 2023 —— 幻觉现象的系统综述,坑一、坑二的机制背景。
- Du et al., PP-OCR: A Practical Ultra Lightweight OCR System, arXiv:2009.09941 —— RapidOCR 所用模型的原始工作,检测/分类/识别三段式架构。
- Graves et al., Connectionist Temporal Classification, ICML 2006 —— CTC 解码,解释为什么 OCR 对同一输入是确定性的。
- 微软 UI Automation 官方文档与 pywinauto 文档 —— GUI 自动化的焦点与状态模型。
- 投影剖面分析是文档图像分析的经典方法,相关教材均有覆盖。
文中材料为脱敏测试数据,文中所有账号、证号均为示意值,非真实号码。工具为内部自用,没做推广。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号