线上踩坑|线程数飙到3400+:一次对象存储客户端线程泄漏排查实录
原创
线上踩坑|线程数飙到3400+:一次对象存储客户端线程泄漏排查实录
原创
锡东
发布于 2026-11-04 10:25:01
发布于 2026-11-04 10:25:01
线上稳定性告警里,线程数飙升是非常典型的资源泄漏信号。它不像K8S OOM那样直接让服务挂掉,但会慢慢蚕食系统资源,最终引发卡顿、最后也会OOM导致进程崩溃。本文复盘一次典型的第三方客户端线程泄漏故障,完整还原从告警触发、线程dump分析、代码链路追踪到根因定位的全过程。
一、故障现象:线程数突增触发告警
1.1 告警触发
运维监控系统触发线程数阈值告警:某业务服务线程数超过2000告警阈值,实际峰值达到3498,远超正常服务百级线程的水位。
- 服务本身没有明显的业务流量突增;
- CPU使用率不高,但线程数持续缓慢上涨,服务运行时间越久线程越多;
- 暂时没有触发OOM,但已经接近容器线程数上限,继续增长随时会引发更严重故障。
1.2 初步判断
线程数随运行时间持续增长、流量平稳但只增不减,基本可以判定是线程泄漏——代码中不断创建新线程,但没有正常销毁,越积越多。
二、排查过程:从告警到根因的完整链路
2.1 第一步:抓取线程快照,锁定异常线程类
排查线程问题的标准动作,是使用 JDK 自带的 jstack 命令,导出当前进程的全部线程栈信息。
命令格式:
jstack 123其中 123 为目标 Java 进程的 PID(进程号),执行后会输出该进程内所有线程的名称、状态、调用栈等完整信息,输出到文件后即可做统计分析。
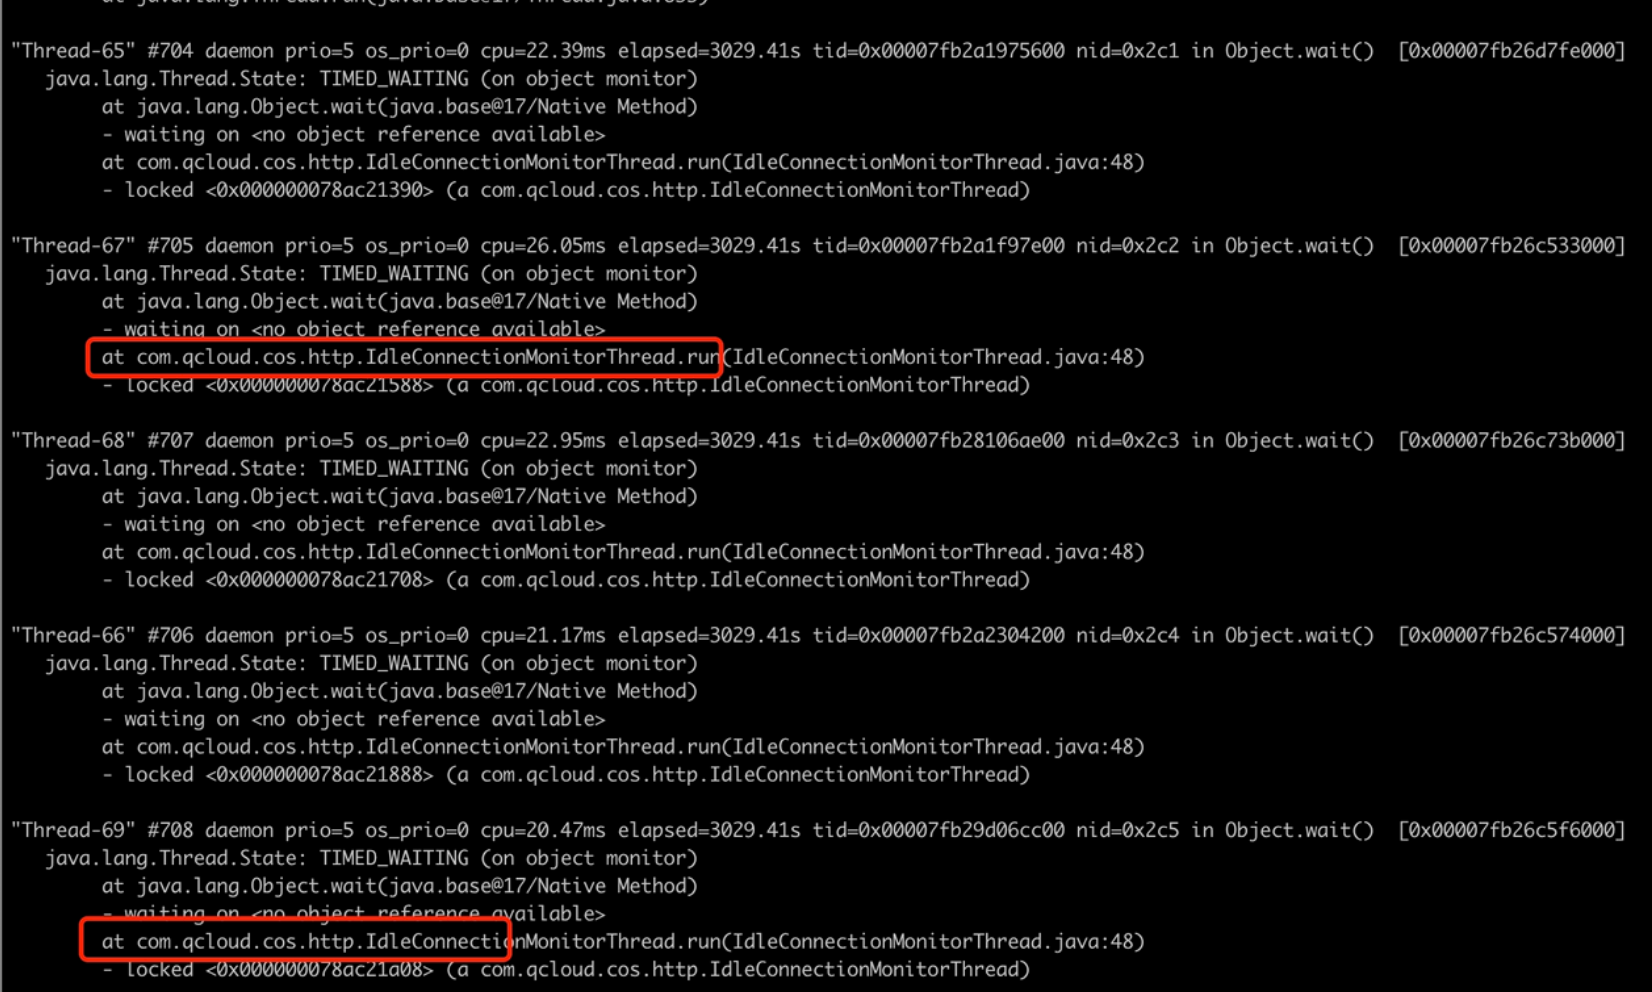
threaddump内容
图简述:jstack 输出的原始线程栈片段,可见大量编号递增的同名线程,均处于 TIMED_WAITING 状态,调用栈统一指向空闲连接监控类。
拿到 dump 文件后,我们对线程名称、状态做批量统计,很快发现了异常特征:
- 存在上千个编号递增的独立线程(
Thread-65、Thread-66、Thread-67……); - 这些线程全部处于
TIMED_WAITING(计时等待)状态,不消耗CPU但常驻内存; - 所有线程的调用栈底部都指向同一个类:
com.qcloud.cos.http.IdleConnectionMonitorThread。
到这里,我们拿到了第一个关键线索:泄漏的线程,全部来自腾讯云COS对象存储SDK的空闲连接监控线程。
2.2 第二步:反向追溯代码,梳理线程生命周期
知道了线程类名,接下来就是在代码库中定位这个类,搞清楚三个问题:这个线程是谁创建的?什么时候启动?谁来负责关闭?
第一步:全局搜索线程类
在项目依赖源码中全局搜索 IdleConnectionMonitorThread,很快定位到它属于 DefaultCosHttpClient 类,是HTTP连接池的配套组件。
查看该类的成员定义:
public class DefaultCosHttpClient implements CosHttpClient {
    private PoolingHttpClientConnectionManager connectionManager;
    private IdleConnectionMonitorThread idleConnectionMonitor;
    // ...
}
可以看到,每个 DefaultCosHttpClient 实例,都会持有一个独立的 IdleConnectionMonitorThread 监控线程。也就是说:有多少个HTTP客户端实例,就会有多少个监控线程。
第二步:确认线程启动与关闭逻辑
继续查看构造方法和 shutdown 方法:
- 构造方法中:客户端初始化时,会自动
new出监控线程并启动,线程内部是一个while(!shutdown)的死循环,定期清理连接池中的空闲连接; - shutdown 方法中:会将
shutdown标记置为 true,终止循环,让监控线程正常退出。
结论很明确:这个线程默认随客户端启动,必须主动调用 shutdown 才会停止,不会自行销毁。
第三步:向上追溯调用链
既然监控线程依附于HTTP客户端,那HTTP客户端又是谁创建的?继续向上追调用链:
DefaultCosHttpClient是底层HTTP实现,它由COSClient构造方法内部创建;- 业务代码要使用对象存储,就需要
new COSClient(credentials, clientConfig)来实例化客户端; - 每 new 一次 COSClient,底层就会 new 一个 HTTP 客户端,同时启动一条新的监控线程。
整条调用链路彻底清晰:
业务方法调用
    ↓
new COSClient(...)
    ↓
new DefaultCosHttpClient(...)
    ↓
启动 IdleConnectionMonitorThread 监控线程
2.3 第三步:核查业务代码,定位泄漏点
调用链梳理清楚后,最后一步就是去业务代码里验证:COSClient 是怎么使用的?有没有调用 shutdown?
查看对应的业务实现类 TencentDocServiceImpl,结果一目了然:
- 每次执行对象存储相关的业务方法,都会在方法内部
new一个全新的COSClient实例; - 方法执行完成后,客户端实例直接被丢弃,全程没有调用任何 shutdown/close 释放资源的逻辑;
- 方法调用一次,就多一个常驻的监控线程;服务运行越久,线程积累得越多。
2.4 最终根因确认
至此根因完全闭环:
业务代码每次调用对象存储接口,都会创建新的客户端实例;客户端底层附带的空闲连接监控线程是死循环常驻线程,必须调用 shutdown 才会终止。由于业务代码用完即抛、从不关闭,导致监控线程只增不减,最终引发线程数泄漏,峰值超过3400。
三、根因深度拆解:为什么泄漏如此隐蔽
3.1 监控线程的运行机制
空闲连接监控线程采用的是典型的守护线程循环设计:
while (!shutdown) {
    // 定期清理空闲连接
    wait(cleanInterval);
    closeIdleConnections();
}- 只要
shutdown标记不置为 true,线程就会一直处于循环等待状态,永远不会自行销毁; TIMED_WAITING状态不会消耗大量 CPU,但会持续占用内存、线程句柄和进程线程数配额;- 单次泄漏影响很小,但日积月累就会达到告警阈值。
3.2 为什么这类问题容易被忽略
- 症状隐蔽:线程处于等待状态,CPU使用率不高,早期不会引发明显业务异常,只有专门的线程数告警才能发现;
- SDK黑盒效应:很多开发只知道用客户端做上传下载,不知道底层会启动后台监控线程,更不知道需要手动关闭;
- 积累效应:单次调用只多一个线程,短期看不出问题,线上跑几天几周后才会触发告警,排查时很难直接关联到具体代码。
四、修复方案
4.1 紧急修复:用完即关闭
最直接的修复方式:每次使用完客户端后,主动调用 shutdown() 方法,释放连接池资源、停止监控线程。
COSClient cosClient = null;
try {
    cosClient = new COSClient(credentials, clientConfig);
    // 业务上传/下载逻辑
    cosClient.putObject(...);
} finally {
    if (cosClient != null) {
        cosClient.shutdown();
    }
}
注意:关闭逻辑必须放在
finally块中,确保异常场景下也能正常释放,避免异常路径发生泄漏。
4.2 根治方案:客户端单例复用
频繁创建销毁客户端本身也有不小的性能开销,生产环境更合理的做法是单例复用客户端实例。
- 整个服务只初始化1~2个客户端实例,所有业务方法共用;
- 连接池、监控线程全局只有一份,不会重复创建;
- 服务停止时统一调用 shutdown 关闭资源。
这种方案既彻底解决了线程泄漏问题,也提升了运行性能,是生产环境的标准最佳实践。
五、通用治理经验:不止是对象存储客户端
这类问题具备极强的普遍性,几乎所有带连接池的第三方客户端都有同样的陷阱:HTTP客户端、Redis客户端、MQ客户端、对象存储客户端……无一例外。
5.1 通用排查思路
遇到线程数持续上涨的问题,按以下步骤快速定位:
- jstack 抓 dump:统计线程名称和状态,定位重复出现的线程类;
- 追源码定位:确认该线程属于哪个SDK、哪个组件,生命周期由谁管理;
- 梳理调用链:从线程类向上反推,找到创建该组件的业务入口;
- 核查业务代码:确认是否存在频繁创建客户端、用完不关闭的逻辑。
5.2 开发规范建议
- 优先单例复用:带连接池的客户端,默认设计就是全局复用,不要每次业务调用都 new 新实例;
- 创建必关原则:如果一定要每次创建,必须配套 finally 块调用 shutdown/close 方法释放资源;
- 线程数纳入常规告警:设置合理阈值(比如单实例线程数>500告警),早期发现泄漏问题,避免积累到不可控。
六、总结
这次3400+线程数的故障,本质是对第三方SDK的生命周期认知不足导致的资源泄漏。客户端类看似只是一个工具,底层却附带了连接池、监控线程等一系列资源,创建容易销毁难,忽略关闭就会造成线程泄漏。
稳定性治理很多时候就是在抠这些细节:大的容错、限流框架搭好了,真正线上出问题的往往是某个不起眼的客户端实例,默默积累资源,直到触发告警。养成“创建即考虑销毁”的编码习惯,把客户端复用和资源关闭纳入开发规范,才能从根源上避免这类问题。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号